Llama Windows : votre première conversation IA locale, sans configuration du terminal
Installez Llama Windows en toute sécurité, choisissez un modèle GGUF adapté à votre PC, testez trois consignes pratiques et connectez-vous à son API locale sans exposer le serveur.
Votre première tâche d’IA locale devrait être modeste : transformer six notes de réunion fictives en trois actions. Pour savoir si votre ordinateur peut répondre, vous ne devriez pas avoir à compiler un moteur d’inférence, à deviner une dizaine d’options de lancement ni à envoyer un document privé.
Llama Windows, annoncé par Hugging Face le 13 octobre 2026, intègre le runtime llama.cpp dans une application Windows accessible depuis la zone de notification. L’application repère et télécharge les modèles, puis fournit une interface de conversation locale et une API destinée à d’autres applications. Son nom désigne l’application, qui ne se limite pas aux modèles Llama de Meta. Annonce de lancement
Ce guide vous accompagne dans l’installation sécurisée, le choix d’un premier modèle adapté et une conversation dont vous pourrez vérifier le résultat. Nous examinerons ensuite trois tâches utiles et une requête facultative à l’API locale. Commencez par du texte public ou inventé ; n’introduisez des données sensibles qu’une fois le workflow compris dans son ensemble.
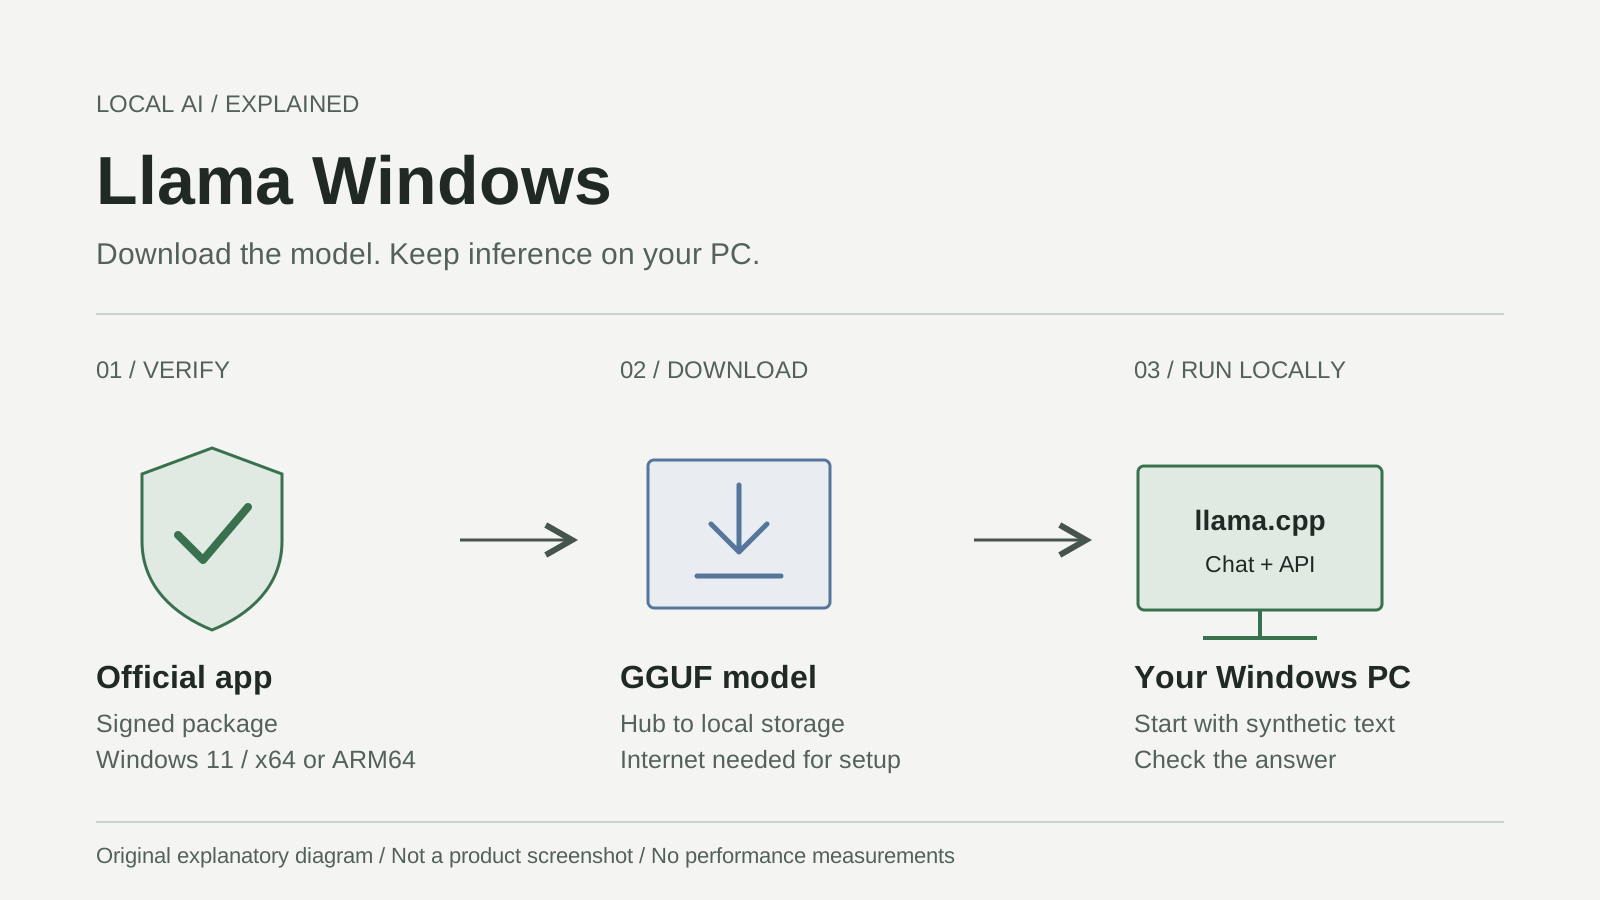
Visuel explicatif original, pas une capture d’écran du produit. Le téléchargement et l’inférence locale sont deux étapes différentes. D’après le guide officiel d’installation Windows.
Vérifiez votre version de Windows avant de choisir un modèle
Au 20 octobre, la dernière version publiée pour Windows est la v0.12.0. Son manifeste d’installation exige Windows.Desktop 10.0.26100.0 ou une version ultérieure. La build 26100 correspond à Windows 11, version 24H2 ; utilisez une version de Windows encore prise en charge, pas uniquement la plus ancienne qui accepte l’installation. Version, manifeste de la version, informations Microsoft sur les versions
Depuis la recherche Windows, lancez winver pour vérifier votre build. Dans les Paramètres, ouvrez Système > Informations système pour voir le type de système et la RAM installée. Le fichier .msixbundle officiel contient les versions x64 et ARM64 : x64 est le choix habituel sur les PC Windows Intel/AMD ; ARM64 correspond à Windows sur Arm. Le bundle sélectionne l’architecture. La version x86 32 bits ne figure pas parmi les fichiers de la version actuelle. Dépôt Windows, conditionnement du bundle
La documentation d’installation Windows ne fixe aucun minimum universel de RAM, de VRAM ou de GPU dédié. Les besoins dépendent du modèle et du contexte. llama.cpp prend en charge l’inférence sur CPU et plusieurs backends GPU, sans garantir les mêmes performances d’accélération sur tous les PC. Vous n’avez pas besoin d’un RTX Spark en particulier. Fonctionnalités de llama.cpp
Sur Mac, choisissez la voie distincte Télécharger pour Mac sur llama.app. N’installez pas le bundle Windows et ne reprenez pas ses instructions de pilotes. Les indications de taille de l’application Mac sur le site ne sont pas non plus des exigences pour l’installateur Windows.
Installez l’application signée sans affaiblir la sécurité de Windows
L’installation du paquet normal ne nécessite ni compilation ni installation du SDK .NET. Les prérequis d’une compilation depuis les sources concernent les développeurs, pas cette première conversation. Documentation officielle d’installation
- Ouvrez llama.app et choisissez Télécharger pour Windows 11, ou suivez le lien Releases du dépôt. Vérifiez qu’il s’agit bien de la version publiée par
ggml-org/Llama-Windows, et non d’un site de téléchargement au nom similaire. - Choisissez le fichier
.msixbundleactuel, pas l’archive du code source sur GitHub. Pour la version vérifiée, le fichier s’appelleLlamaApp-v0.12.0.msixbundle. Gardez sa page de publication ouverte pendant l’installation. - Ouvrez le bundle avec le programme d’installation d’applications Windows. Vérifiez l’éditeur et les informations de signature avant de cliquer sur Installer. L’identité de signature du manifeste v0.12.0 est Hugging Face, tandis que le nom d’éditeur affiché est Morgan Funtowicz. Un nom d’affichage familier ne suffit pas à vérifier la signature : Windows doit reconnaître celle du paquet. Identité du paquet
- Si Windows signale un éditeur inconnu, une signature invalide ou une restriction de l’organisation, arrêtez-vous. Vérifiez à nouveau le fichier officiel, mettez à jour Windows et le programme d’installation via les canaux Microsoft, ou demandez l’aide de votre administrateur. Ne désactivez ni Defender ni SmartScreen, ne contournez pas la stratégie d’exécution et n’importez pas un certificat inconnu pour forcer l’installation. Dépannage Microsoft du programme d’installation
- Lancez Llama et repérez son icône dans la zone de notification, près de l’horloge ; au besoin, cliquez sur la flèche des icônes masquées. Si le runtime llama.cpp géré par l’application est absent, celle-ci peut l’installer : le premier lancement peut donc nécessiter Internet. Guide de téléchargement Windows, configuration du runtime
Ne modifiez pas les paramètres de partage réseau. Dans la v0.12.0, Paramètres > Llama > Écouter sur détermine l’adresse du serveur ; la valeur par défaut est localhost. Votre première conversation ne nécessite ni règle entrante dans le pare-feu ni adresse joignable depuis un autre ordinateur. Notes de sécurité de la version
Un modèle qui tient sur le disque peut ne pas tenir en mémoire
GGUF est un format de fichier de modèle contenant les poids et les métadonnées destinés à des moteurs d’inférence comme llama.cpp. Ce n’est ni une marque de chatbot ni une note de qualité. Pour converser, commencez par un modèle ajusté pour les instructions ou le dialogue ; un modèle de base sert à autre chose. Lisez la fiche du modèle au lieu de choisir uniquement selon le nombre de téléchargements. Documentation GGUF de Hugging Face, guide des fiches de modèles
Le nombre de paramètres correspond aux valeurs numériques apprises par le modèle : 3B signifie environ trois milliards de paramètres, et non un téléchargement de 3 Go. La quantification stocke ces valeurs de manière plus compacte. Des noms comme Q4_K_M et Q8_0 désignent différentes méthodes de quantification, pas des versions de l’application. Une précision plus faible peut réduire l’espace disque et la mémoire nécessaires, au prix de compromis sur la qualité et la vitesse qui dépendent du modèle et du matériel. Ce n’est pas automatiquement le choix le plus rapide ou le meilleur. Guide de quantification llama.cpp
Distinguez quatre besoins :
| Ressource | Éléments à prendre en compte | Décision pour débuter |
|---|---|---|
| Espace disque | Fichiers du modèle téléchargés, runtime et espace temporaire de téléchargement | Vérifier le disque de destination avant le téléchargement |
| RAM système | Windows, autres applications, données du modèle et espace de travail du runtime | Garder de la marge pour les usages habituels du PC |
| VRAM du GPU | Travail pris en charge par un GPU dédié | Ne pas la confondre avec la RAM système |
| Contexte | Jetons conservés pour les instructions, la conversation et la réponse générée | Commencer avec un contexte court plutôt que choisir le maximum |
Le contexte est le bureau de travail de la conversation. Un bureau plus grand peut accueillir davantage de documents, mais il consomme aussi plus de mémoire. Les jetons sont des unités de texte, pas un nombre fixe de mots ; les langues et le code sont découpés différemment. Les poids du modèle ne sont qu’une partie de l’allocation : le cache clé-valeur et les tampons du runtime comptent aussi. Paramètres du serveur llama.cpp
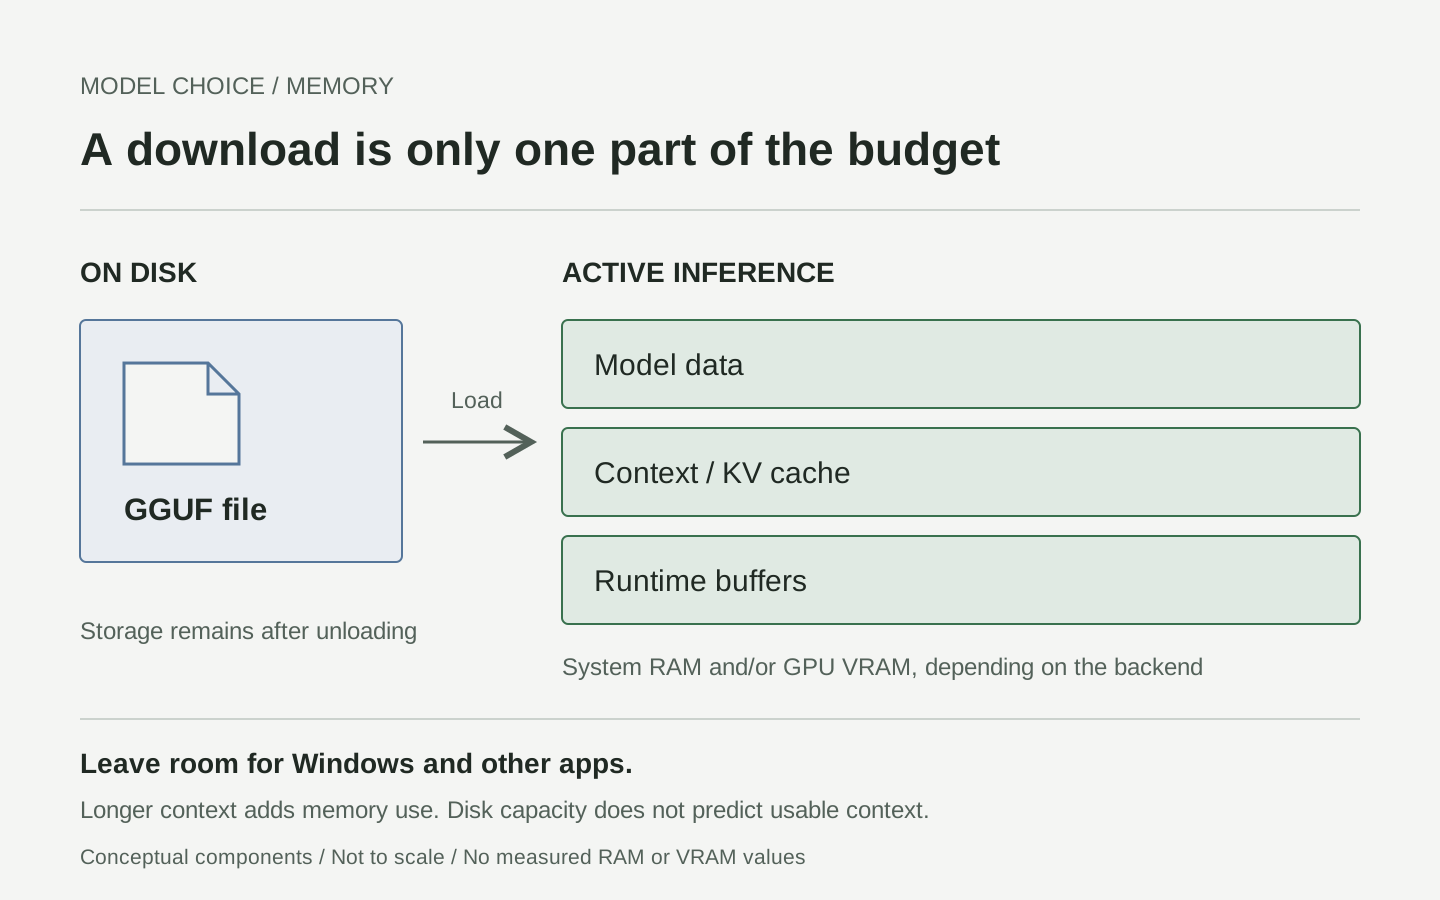
Schéma conceptuel original, pas une mesure de l’allocation. La source des détails du modèle estime la mémoire nécessaire au modèle et au contexte ; la consommation totale du PC comprend davantage.
Ouvrez les détails d’un modèle et examinez les estimations de mémoire correspondant à sa longueur de contexte. Choisissez un petit modèle de conversation recommandé et une option de contexte courte qui laisse de la marge. Un fichier hypothétique de 4 Go sur un PC de 16 Go ne prouve pas qu’une longue conversation tiendra en mémoire. Si vous comparez ensuite des quantifications, gardez le modèle, la consigne et le contexte identiques pour isoler la différence. Avant tout usage commercial, vérifiez la licence du modèle : la licence MIT de l’application ne couvre pas tous les modèles téléchargeables.
Rendez la première conversation facile à vérifier
L’article de lancement appelle ses panneaux Modèles recommandés et Disponibles. En revanche, les sources v0.12.0 vérifiées utilisent Modèles, un séparateur Parcourir davantage et des infobulles d’icônes comme Télécharger le modèle, Charger le modèle, Ouvrir WebUI et Arrêter le modèle. Fiez-vous aux commandes de la version installée au lieu de chercher indéfiniment un ancien nom de panneau. Code source versionné de l’interface Windows
- Ouvrez le volet de la zone de notification et examinez la taille et les détails d’un modèle recommandé. Pour ce premier essai, choisissez un modèle public qui ne nécessite pas d’accès restreint.
- Utilisez la commande de téléchargement et attendez la fin. Le téléchargement terminé signifie que le fichier est arrivé, pas que l’inférence est en cours.
- Choisissez un contexte court dans les détails du modèle, puis cliquez sur Charger le modèle. Une fois le chargement terminé, choisissez Ouvrir WebUI pour accéder à la conversation locale. Le guide de démarrage officiel recommande lui aussi de régler le contexte avant de lancer la conversation. Guide de démarrage rapide
- Collez la consigne fictive ci-dessous et envoyez-la. Comparez la réponse aux faits fournis ; le simple fait que du texte s’affiche ne suffit pas à juger le résultat.
Use only these fictional notes. Return three bullets: owner, task, due date.
If a due date is missing, write "not specified".
Mira will send the draft on October 23.
Leo will check the links on October 24.
Sam will choose a cover image. No deadline was agreed.
Une bonne réponse reprend les deux dates et indique que l’échéance de Sam n’est pas précisée. Inventer une date est une erreur de précision, même si l’installation fonctionne parfaitement. Enregistrez la consigne et l’identifiant du modèle à des fins de comparaison, puis utilisez Arrêter le modèle lorsque vous avez terminé. L’application documente aussi un volet de conversation superposé accessible par Alt+Espace ; il est facultatif et n’est pas nécessaire pour commencer. Fichier README de Windows
Trois petites tâches illustrent les points forts d’un modèle local
Ces exercices illustratifs utilisent des données inventées ; ils ne rapportent pas des résultats de modèle observés. Chacun propose une tâche, une relance et un critère d’acceptation concret.
Transformer des notes en passation sans inventer de décisions
Imaginons qu’une association prépare un événement de fin de semaine. Saisissez cette demande :
Make a handoff with Decisions, Actions, and Open questions.
Use only the notes. Quote the supporting phrase for every action.
Notes: We chose the library room. June will confirm capacity by Friday.
Omar offered to bring signs, but nobody accepted the offer yet.
The start time is still undecided.
La distinction utile est celle entre un engagement et une proposition. Posez ensuite la question : « Quelles actions ont été explicitement attribuées, et lesquelles ne sont que des propositions ? » N’acceptez le résultat que si la tâche de June lui est bien attribuée, si l’offre d’Omar reste hypothétique et si aucune heure de début n’est inventée. Conservez les notes d’origine avec la passation pour qu’une autre personne puisse examiner les éléments à l’appui.
Étudier un passage avec des questions limitées à la source
Utilisez un court passage du domaine public ou une explication fictive que vous avez rédigée. Voici un exercice autonome :
Passage: In this fictional greenhouse, a timer waters the plants at 07:00.
A moisture sensor can cancel watering when the soil is already wet.
The timer does not measure temperature.
Create three study questions with answers. Quote the sentence supporting
each answer. Then ask one question the passage cannot answer.
Vérifiez chaque citation, pas seulement la vraisemblance de la réponse. Une bonne question sans réponse pourrait porter sur les seuils de température, mais le modèle ne doit pas inventer de valeur. Pour une deuxième version, demandez une formulation plus simple sans altérer les faits. Vous pouvez ainsi vérifier chaque phrase une à une, au lieu d’ouvrir la porte à un cours général sur les serres.
Rédiger une réponse de service client sans faire de promesses
Avant d’utiliser le texte d’un vrai client, entraînez-vous sur un ticket fictif :
Write a polite reply under 90 words using only this policy and ticket.
Policy: Refunds require staff review. No approval deadline is promised.
Ticket: My duplicate charge appeared yesterday. Can you refund it today?
Acknowledge the issue and ask for an order reference, not card details.
Do not promise approval, timing, or a completed action.
Rejetez toute réponse qui prétend que le remboursement a été effectué ou garantit qu’il le sera le jour même. Demandez au modèle de souligner toutes ses promesses, puis examinez-les vous-même. Seule une personne ayant accès au véritable système de support peut confirmer une action sur un compte. L’exécution locale change l’endroit où le texte est rédigé ; elle ne donne pas au modèle le pouvoir d’émettre un remboursement.
L’API locale peut réutiliser le même modèle
Vous pouvez vous en tenir à la conversation. Pour un éditeur, un script ou un prototype, le serveur géré est documenté à l’adresse http://localhost:9931, avec des requêtes compatibles OpenAI sous /v1. Il s’agit d’une compatibilité locale, pas d’une requête envoyée au cloud d’OpenAI. Vérifiez dans les paramètres si le port a été modifié. Documentation de l’API Llama
Lorsque l’application fonctionne et que le modèle est chargé, ouvrez PowerShell. Commencez par répertorier les modèles disponibles dans le routeur : /models donne leur état de chargement, tandis que /v1/models est le point d’accès de métadonnées compatible avec OpenAI. Copiez l’identifiant exact du modèle que vous avez volontairement chargé. Ne choisissez pas arbitrairement le premier élément, car cela pourrait entraîner le chargement d’un autre modèle.
$base = 'http://localhost:9931'
$headers = @{}
# Only needed if your local server is configured to require a key.
if ($env:LLAMA_LOCAL_API_KEY) {
    $headers.Authorization = "Bearer $env:LLAMA_LOCAL_API_KEY"
}
Invoke-RestMethod -Uri "$base/models" -Headers $headers |
    ConvertTo-Json -Depth 10
Avant d’exécuter ce deuxième bloc, remplacez l’espace réservé par cet identifiant exact. Il n’envoie que du texte fictif et ne nécessite aucun SDK supplémentaire :
$modelId = 'PASTE-THE-LOADED-MODEL-ID'
if ($modelId -eq 'PASTE-THE-LOADED-MODEL-ID') {
    throw 'Choose the already-loaded model ID from /models first.'
}
$body = @{
    model = $modelId
    messages = @(@{
        role = 'user'
        content = 'Rewrite clearly: Our fictional workshop begins at noon.'
    })
    max_tokens = 96
    stream = $false
} | ConvertTo-Json -Depth 5
$reply = Invoke-RestMethod -Method Post `
    -Uri "$base/v1/chat/completions" -Headers $headers `
    -ContentType 'application/json' -Body $body -TimeoutSec 180
$reply.choices[0].message.content
La structure de la requête et le champ de sortie sont conformes à la référence officielle du serveur llama.cpp. Gardez Écouter sur réglé sur localhost ; ne collez jamais une clé API cloud dans cet exemple. Une erreur 401 signifie qu’il faut vérifier l’authentification locale, pas supprimer la protection. Dans la v0.12.0, la sélection d’une adresse non bouclée ajoute une clé générée par l’application et demande une confirmation. Comportement de sécurité sous Windows
L’inférence locale n’élimine pas toutes les opérations réseau
Le README Windows indique que les requêtes et l’inférence restent locales et que l’application n’envoie aucune télémétrie. Il documente aussi les connexions réseau utilisées pour télécharger les modèles et vérifier les mises à jour, avec un User-Agent contenant la version de l’application, la build Windows et l’architecture. Ce sont des activités différentes, qui ne contredisent pas le fonctionnement « hors ligne » de l’inférence. Déclaration de confidentialité
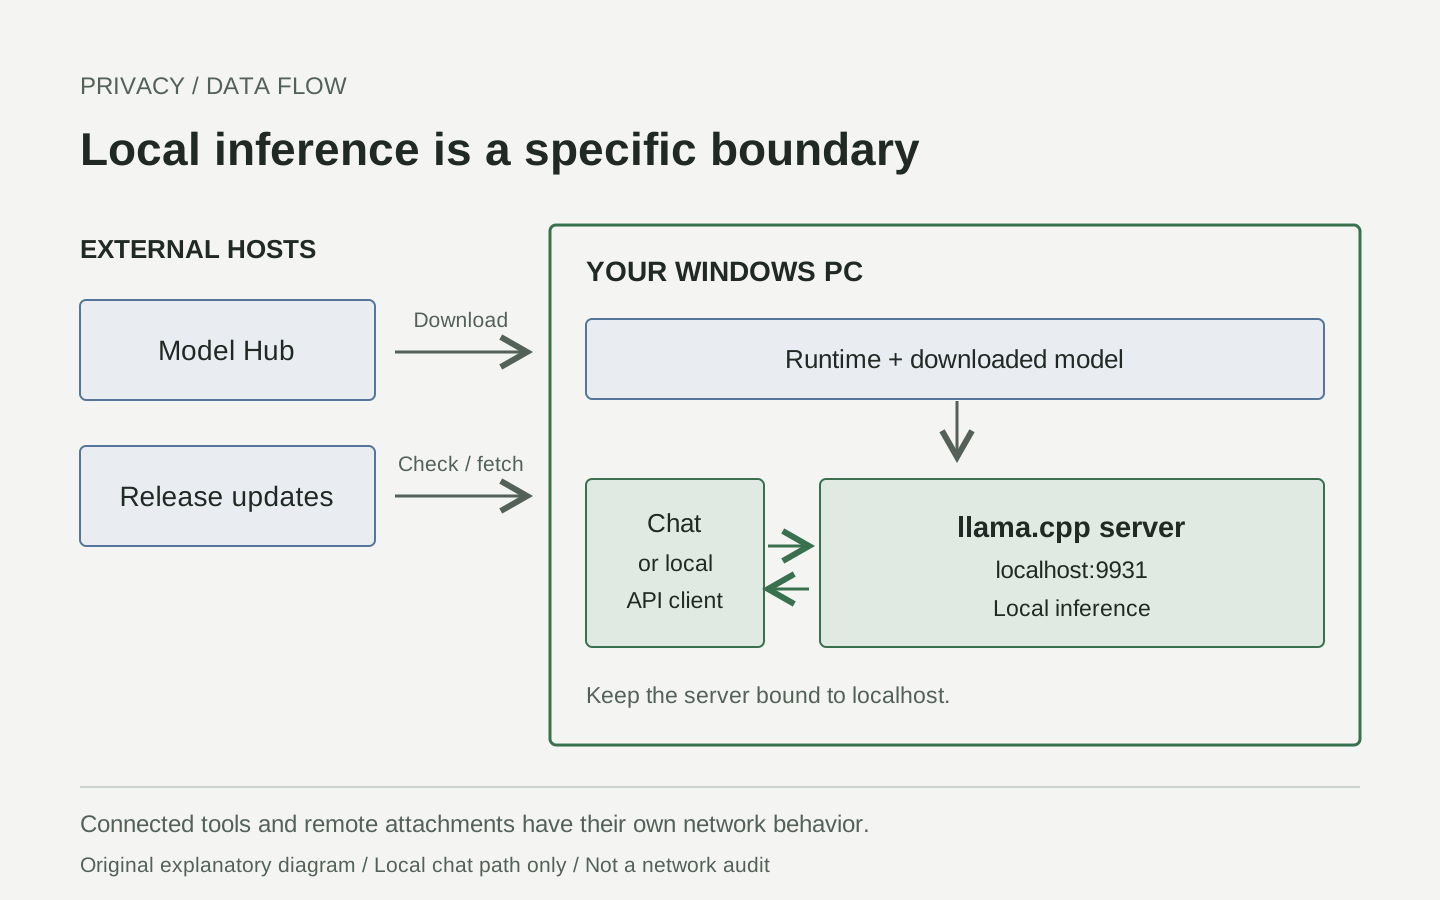
Schéma original des flux de données. Les hôtes de téléchargement sont externes ; le parcours de conversation illustré reste local. Sources : documentation de confidentialité Windows et référence de l’API.
Un modèle compatible déjà téléchargé peut effectuer l’inférence sans connexion Internet, mais il faut Internet pour télécharger un nouveau modèle. Un éditeur connecté, une extension de navigateur, une URL de pièce jointe distante ou un outil externe activé a son propre comportement réseau. Ne supposez pas qu’il hérite de la frontière locale du serveur.
Avant de traiter des informations confidentielles, vérifiez le stockage des conversations, les extensions du navigateur, les emplacements de sauvegarde et de synchronisation ainsi que les règles de votre organisation. Une conversation fictive hors ligne est un contrôle fonctionnel utile après l’installation, pas la preuve que chaque composant a fait l’objet d’un audit. N’incluez jamais de jetons d’accès ni de consignes privées dans des journaux de diagnostic publics.
Dépannez l’étape en échec, pas toute l’installation
| Symptôme | Première vérification | Étape suivante utile |
|---|---|---|
| Le bundle refuse de s’installer | Build 26100 minimale, architecture, signature, règles de l’appareil | Conserver le message exact du programme d’installation ; utiliser les mises à jour officielles ou demander l’aide de l’administrateur |
| Aucune fenêtre d’application n’apparaît | Zone de notification et icônes masquées | Ouvrir l’icône de la zone de notification ; une fenêtre permanente dans la barre des tâches n’est pas attendue |
| Le téléchargement du modèle échoue | Espace de destination, connexion, accès restreint, message d’erreur affiché | Corriger la cause avant de réessayer ; commencer par un modèle public |
| Le téléchargement réussit mais pas le chargement | Estimation du contexte, mémoire libre, erreur du runtime | Arrêter les autres modèles chargés et réduire le contexte ou la taille du modèle |
| Les réponses sont lentes | Taille du modèle, longueur du contexte, backend CPU/GPU réellement utilisé | Comparer avec une courte consigne ; ne pas considérer une recommandation du catalogue comme une garantie de vitesse |
| L’API ne se connecte pas | Application active, port configuré, adresse locale | Vérifier l’état du serveur avant d’en lancer un deuxième |
| Une réponse fluide contient des détails faux | Texte source et adéquation du modèle | Raccourcir la tâche et exiger des citations à l’appui |
Le README actuel situe les paramètres et les journaux sous %LOCALAPPDATA%\Llama ; l’article de lancement indiquait un autre emplacement pour les journaux. Utilisez la commande de l’application qui ouvre le dossier des journaux au lieu de deviner. Le point d’accès documenté /health permet de distinguer un serveur prêt d’un serveur dont le modèle charge encore, mais un routeur actif ne prouve pas que le modèle choisi est chargé. Documentation actuelle du stockage, état de santé du serveur
Considérez la configuration comme réussie uniquement si ces vérifications passent
- Le paquet signé officiel s’installe sans désactiver les contrôles de sécurité.
- Un modèle choisi délibérément termine son téléchargement et se charge.
- La conversation s’ouvre sur une adresse locale et répond à la tâche fictive.
- Les dates, les noms et les informations absentes correspondent au texte fourni.
- Vous pouvez arrêter le modèle puis le charger de nouveau.
- Si vous utilisez l’API, le modèle prévu répond et le serveur reste limité à localhost.
En bref : une IA locale, c’est un workflow que vous pouvez examiner
À notre avis, le progrès important ne consiste pas à éviter une commande dans le terminal. Il consiste à rendre le choix du modèle, l’usage mémoire, les sources et la réponse suffisamment compréhensibles pour pouvoir recommencer. Commencez par une petite tâche dont vous pouvez vérifier la réponse. Élargissez ensuite votre usage, quand vous savez à quoi ressemble la réussite.
Sources et visuels
Vérifié le 20 octobre 2026. Ce guide décrit des workflows documentés ; il ne prétend pas relater un essai d’installation, une exécution de modèle, une requête payante ou un benchmark. Les trois fichiers SVG sont des schémas explicatifs originaux, pas des reproductions de l’interface. Consultez la capture officielle de la zone de notification et la démonstration du volet superposé pour voir l’interface réelle de l’éditeur. Ces éléments sont liés, pas republiés.
- Hugging Face : annonce, 13 octobre
- Version Windows, paquet et modifications de sécurité
- Installation officielle et guide de démarrage
- Format GGUF et métadonnées
- API locale et documentation des points d’accès
- Référence du runtime et du serveur llama.cpp
Rendez vos essais réutilisables
Conservez les liens des sources, les consignes, les identifiants de modèles et les notes de vérification au lieu de ne garder que la réponse finale. Telli.sh peut organiser ces notes de recherche ; il ne s’intègre pas à Llama Windows et ne garantit pas que vos notes restent hors ligne. Créer un compte Telli.sh