Llama Windows: tu primer chat de IA local, sin configurar nada en la terminal
Instala Llama Windows de forma segura, elige un modelo GGUF adecuado para tu PC, prueba tres prompts prácticos y conéctate a su API local sin exponer el servidor.
Tu primera tarea con IA local debería ser pequeña: convertir seis notas ficticias de una reunión en tres tareas pendientes. No deberías tener que compilar un motor de inferencia, adivinar una docena de parámetros de inicio ni subir un documento privado solo para averiguar si tu ordenador puede responder.
Llama Windows, anunciado por Hugging Face el 13 de octubre de 2026, incorpora el entorno de ejecución llama.cpp en una aplicación para la bandeja del sistema de Windows. Se ocupa de buscar y descargar modelos y, después, ofrece una interfaz de chat local y una API para otras aplicaciones. El nombre describe la aplicación, no una limitación a los modelos Llama de Meta. Anuncio de lanzamiento
Esta guía te acompaña en una instalación segura, la elección de un primer modelo sensato y una primera conversación que puedas comprobar. Después veremos tres tareas útiles y una solicitud opcional a la API local. Empieza con texto público o inventado; incorpora material sensible solo cuando entiendas el flujo de principio a fin.
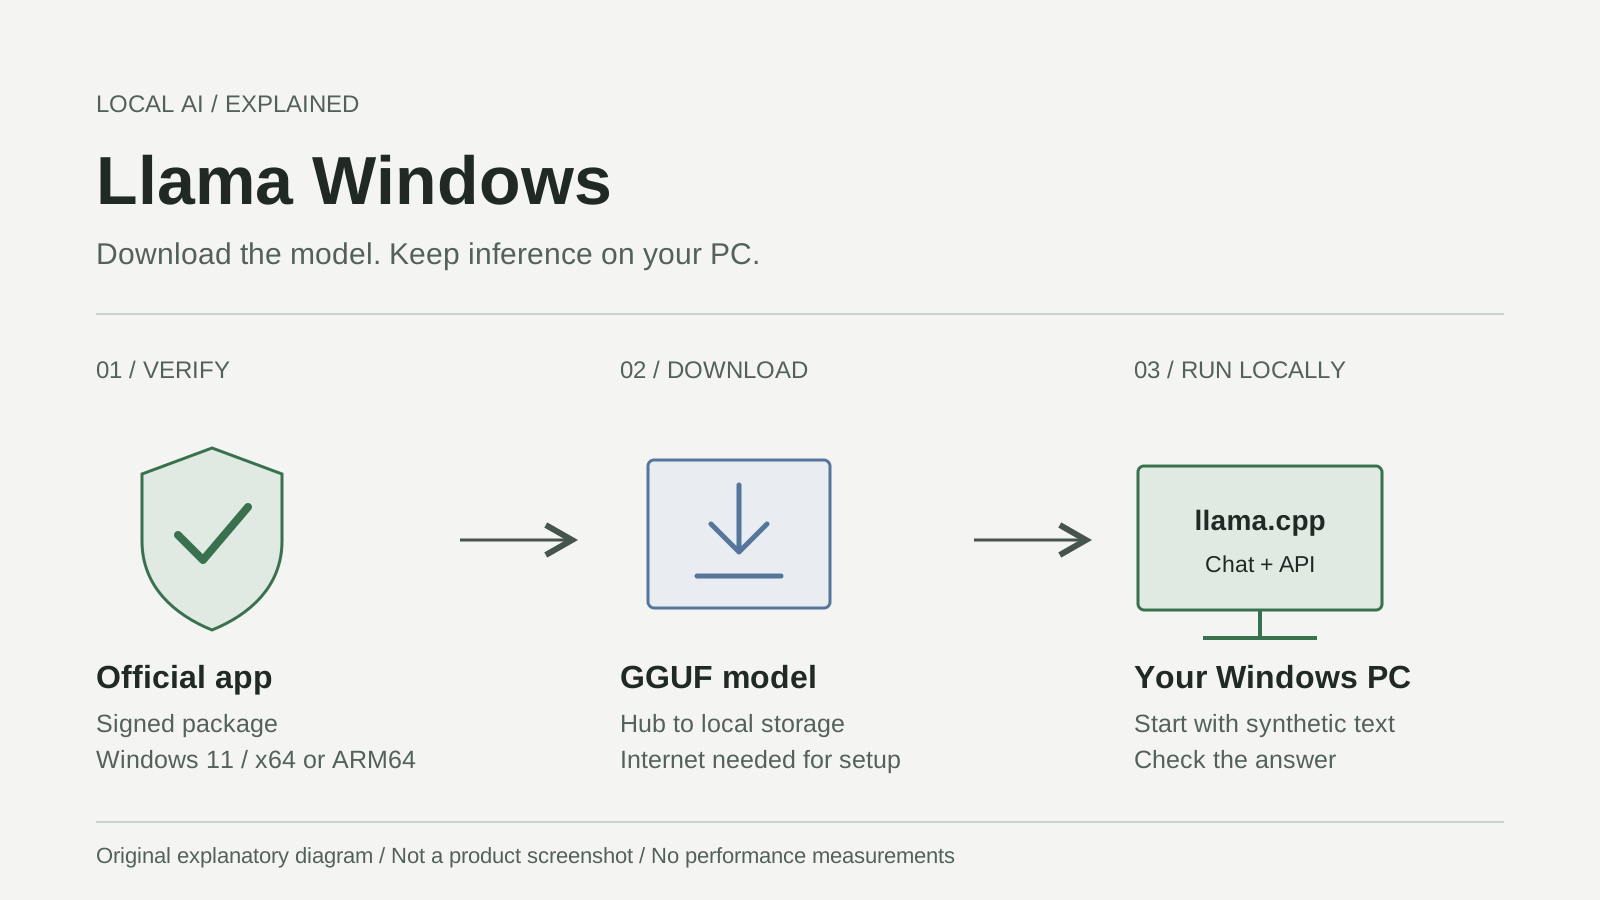
Ilustración explicativa original, no captura del producto. Las descargas de configuración y la inferencia local son etapas distintas. Basada en la guía oficial de instalación para Windows.
Comprueba la versión de Windows antes de elegir un modelo
Según la comprobación del 20 de octubre, la última versión publicada para Windows es la v0.12.0. Su manifiesto de paquete requiere Windows.Desktop 10.0.26100.0 o posterior. La compilación 26100 corresponde a Windows 11, versión 24H2; utiliza una versión de Windows que siga recibiendo mantenimiento, no solo la más antigua que permita instalarlo. Versión, manifiesto de la versión, información de versiones de Microsoft
Ejecuta winver desde la búsqueda de Windows para comprobar la compilación. En Configuración de Windows, abre Sistema > Acerca de para consultar el tipo de sistema y la RAM instalada. El archivo .msixbundle oficial contiene compilaciones x64 y ARM64: x64 es la opción habitual para PC con Windows de Intel/AMD; ARM64 es para Windows en Arm. El paquete selecciona la arquitectura. La versión x86 de 32 bits no figura entre los recursos de la versión actual. Repositorio de Windows, empaquetado del conjunto
La documentación de instalación para Windows no especifica una cantidad mínima universal de RAM, VRAM ni una GPU dedicada. Esos requisitos dependen del modelo y del contexto. llama.cpp admite inferencia en CPU y varios backends de GPU, pero eso no garantiza la misma aceleración en todos los PC. No necesitas específicamente una RTX Spark. Capacidades de llama.cpp
En un Mac, sigue la ruta independiente Descargar para Mac en llama.app. No instales el paquete de Windows ni reutilices instrucciones de controladores para Windows. Las cifras de tamaño de la aplicación para Mac del sitio tampoco son requisitos del instalador de Windows.
Instala la aplicación firmada sin debilitar la seguridad de Windows
La instalación normal mediante el paquete no requiere compilar nada ni instalar el SDK de .NET. Los requisitos previos para compilar desde el código fuente son para desarrolladores, no para este procedimiento de primer chat. Documentación oficial de instalación
- Abre llama.app y elige Descargar para Windows 11, o sigue el enlace Releases del repositorio. Confirma que la versión pertenece a
ggml-org/Llama-Windows, no a un sitio de descargas con un nombre parecido. - Elige el
.msixbundleactual, no el archivo del código fuente de GitHub. Para la versión comprobada, el recurso se llamaLlamaApp-v0.12.0.msixbundle. Mantén abierta la página de la versión durante la instalación. - Abre el paquete con el Instalador de aplicaciones de Windows. Comprueba la información del editor y de la firma antes de elegir Instalar. La identidad de firma del manifiesto v0.12.0 es Hugging Face, mientras que el nombre del editor que se muestra es Morgan Funtowicz. Que el nombre visible te resulte familiar no verifica la firma: Windows debe confiar en la firma del paquete. Identidad del paquete
- Si Windows indica que el editor es desconocido, que la firma no es válida o que hay una restricción de la organización, detente. Vuelve a comprobar el recurso oficial, actualiza Windows o el Instalador de aplicaciones desde los canales de Microsoft, o consulta con la persona administradora. No desactives Defender ni SmartScreen, no eludas la directiva de ejecución ni importes un certificado desconocido para forzar la instalación. Solución de problemas del Instalador de aplicaciones de Microsoft
- Inicia Llama y busca su icono en el área de notificación, junto al reloj; si hace falta, comprueba la flecha de iconos ocultos. Si no está, la aplicación puede instalar el entorno administrado de llama.cpp; por eso, el primer inicio puede necesitar conexión a Internet. Guía de descarga para Windows, configuración del entorno de ejecución
No modifiques los ajustes de acceso a la red. En v0.12.0, Configuración > Llama > Escuchar en controla la dirección del servidor; localhost es la opción predeterminada. Tu primer chat no necesita una excepción de entrada a la red ni una dirección accesible desde otro ordenador. Notas de seguridad de la versión
Un modelo que cabe en el disco quizá no quepa en la memoria
GGUF es un formato de archivo de modelo que contiene pesos y metadatos para motores de inferencia como llama.cpp. No es una marca de chatbot ni una clasificación de calidad. Para conversar, conviene empezar con un modelo ajustado para seguir instrucciones o chatear; un modelo base tiene otro propósito. Lee la ficha del modelo en vez de elegir solo por el número de descargas. Documentación de GGUF de Hugging Face, guía de fichas de modelos
El número de parámetros describe los valores numéricos aprendidos por el modelo: 3B significa aproximadamente tres mil millones de parámetros, no una descarga de 3 GB. La cuantización almacena esos valores de forma más compacta. Nombres como Q4_K_M y Q8_0 identifican distintas recetas de cuantización, no versiones de la aplicación. Una precisión menor puede reducir las necesidades de almacenamiento y memoria, con compensaciones de calidad y velocidad que dependen del modelo y del hardware. No es automáticamente la opción más rápida ni la mejor. Guía de cuantización de llama.cpp
Mantén separadas estas cuatro cantidades:
| Cantidad | Qué debes prever | Decisión para principiantes |
|---|---|---|
| Espacio en disco | Archivos del modelo descargados, entorno de ejecución y espacio temporal para la descarga | Comprueba la unidad de destino antes de descargar |
| RAM del sistema | Windows, otras aplicaciones, datos del modelo y trabajo del entorno de ejecución | Deja margen para el uso normal del PC |
| VRAM de la GPU | Trabajo asignado a una GPU dedicada | No la confundas con la RAM del sistema |
| Contexto | Tokens que ocupan las instrucciones, la conversación y el texto generado | Empieza con poco en vez de elegir el máximo |
El contexto es el escritorio de trabajo de la conversación. Un escritorio más grande admite más material, pero también ocupa más memoria. Los tokens son fragmentos de texto, no una cantidad fija de palabras; cada idioma y el código se tokenizan de forma distinta. Los pesos del modelo son solo una parte de la asignación: también importan la caché de clave/valor y los búferes del entorno de ejecución. Parámetros del servidor llama.cpp
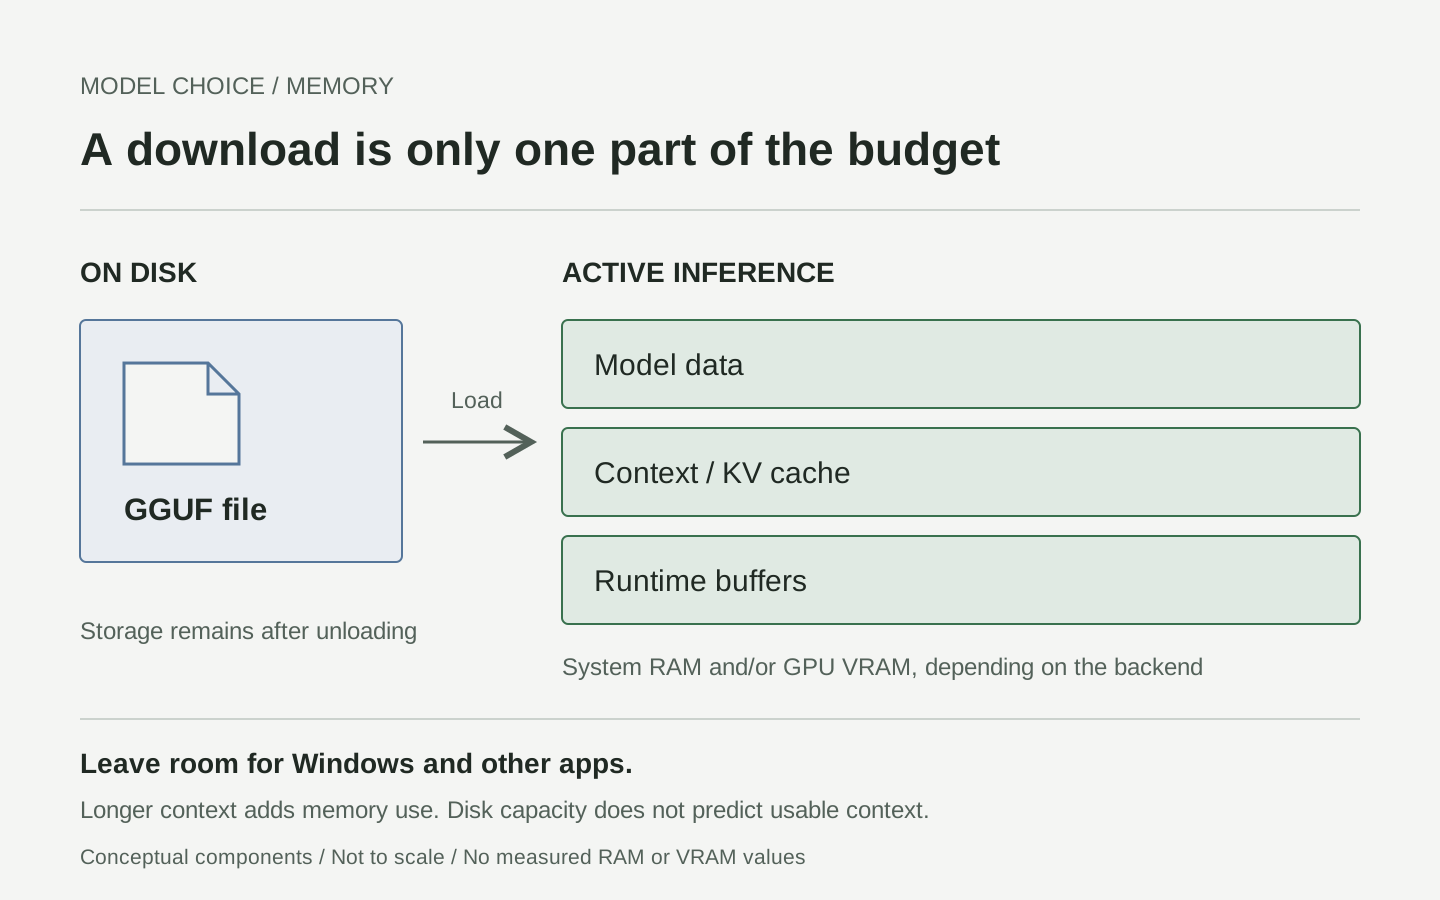
Diagrama conceptual original, no medición de una asignación real. La fuente de detalles del modelo estima la memoria del modelo más el contexto; el uso total del PC incluye más elementos.
Abre los detalles de un modelo y consulta las estimaciones de memoria según su longitud de contexto. Elige un modelo de chat pequeño recomendado y una opción de contexto breve que deje margen libre. Que un archivo hipotético de 4 GB quepa en un PC con 16 GB no demuestra que también quepa una conversación larga. Si más adelante comparas cuantizaciones, mantén constante el modelo, el prompt y el contexto para saber qué ha cambiado. Comprueba la licencia del propio modelo antes de usarlo con fines comerciales; la licencia MIT de la aplicación no cubre todos los modelos descargables.
Haz que la primera conversación sea fácil de comprobar
El artículo de lanzamiento llama a sus paneles Recommended Models y Available. En cambio, el código fuente comprobado de la v0.12.0 usa Models, un separador Browse more e información emergente para iconos como Download model, Load model, Open WebUI y Stop model. Sigue los controles que tenga tu versión en lugar de buscar indefinidamente un nombre antiguo de panel. Código de la interfaz de Windows versionado
- Abre el panel emergente de la bandeja y consulta el tamaño y los detalles de un modelo recomendado. Para esta primera ejecución, elige un modelo público que no requiera acceso restringido.
- Usa su control de descarga y espera a que termine. Que la descarga se complete significa que llegó el archivo, no que la inferencia esté en marcha.
- Elige un contexto breve en los detalles del modelo y usa Load model. Una vez cargado, selecciona Open WebUI para abrir el chat local. La guía oficial de inicio rápido también indica que se elija el contexto antes de iniciar el chat. Inicio rápido
- Pega el prompt sintético que aparece a continuación y envíalo. Compara la respuesta con los datos proporcionados; no juzgues el éxito solo porque aparezca texto.
Use only these fictional notes. Return three bullets: owner, task, due date.
If a due date is missing, write "not specified".
Mira will send the draft on October 23.
Leo will check the links on October 24.
Sam will choose a cover image. No deadline was agreed.
Una respuesta útil conserva ambas fechas y deja sin especificar el plazo de Sam. Inventar una fecha es un fallo de precisión, aunque la instalación funcione perfectamente. Guarda el prompt y el identificador del modelo para compararlos y, al terminar, usa Stop model. La aplicación también documenta una superposición de chat con Alt+Space; es opcional, no un requisito previo. README de Windows
Tres tareas pequeñas muestran para qué sirve un modelo local
Son ejercicios ilustrativos con datos inventados, no resultados registrados de modelos. Cada uno plantea una tarea, una pregunta de seguimiento y un criterio de aceptación concreto.
Convierte notas sin pulir en un traspaso sin inventar decisiones
Supongamos que un grupo de voluntariado prepara un evento de fin de semana. Pega esta solicitud:
Make a handoff with Decisions, Actions, and Open questions.
Use only the notes. Quote the supporting phrase for every action.
Notes: We chose the library room. June will confirm capacity by Friday.
Omar offered to bring signs, but nobody accepted the offer yet.
The start time is still undecided.
La distinción útil está entre un compromiso y una sugerencia. Haz una pregunta de seguimiento: «¿Qué tareas se asignaron expresamente y cuáles son solo propuestas?». Acepta el resultado solo si se asigna la tarea a June, la oferta de Omar sigue siendo tentativa y no aparece ninguna hora de inicio. Conserva las notas originales junto al traspaso para que otra persona pueda comprobar las pruebas.
Estudia un texto con preguntas que no salgan de la fuente
Usa un fragmento breve de dominio público o una explicación sintética que hayas escrito. Este es un ejercicio autónomo:
Passage: In this fictional greenhouse, a timer waters the plants at 07:00.
A moisture sensor can cancel watering when the soil is already wet.
The timer does not measure temperature.
Create three study questions with answers. Quote the sentence supporting
each answer. Then ask one question the passage cannot answer.
Comprueba todas las citas, no solo que las respuestas parezcan plausibles. Una buena pregunta sin respuesta podría referirse a los umbrales de temperatura, pero el modelo no debe inventar ninguno. En una segunda pasada, pide una redacción más sencilla que conserve todos los datos. Así conviertes la revisión en algo que puedes comprobar frase por frase, en vez de invitar al modelo a añadir una explicación general sobre invernaderos.
Redacta una respuesta de atención al cliente sin hacer promesas
Antes de usar texto real de un cliente, ensaya con un ticket ficticio:
Write a polite reply under 90 words using only this policy and ticket.
Policy: Refunds require staff review. No approval deadline is promised.
Ticket: My duplicate charge appeared yesterday. Can you refund it today?
Acknowledge the issue and ask for an order reference, not card details.
Do not promise approval, timing, or a completed action.
Rechaza cualquier borrador que diga que el reembolso se ha procesado o garantice un resultado en el mismo día. Pide al modelo que subraye todas las promesas que ha hecho y revísalas tú mismo. Solo una persona con acceso al sistema de soporte real puede confirmar una acción en una cuenta. La ejecución local cambia dónde se redacta el texto; no autoriza al modelo a emitir reembolsos.
La API local permite reutilizar el mismo modelo
Puedes quedarte en el chat. Para un editor, un script o un prototipo, la documentación indica que el servidor administrado está en http://localhost:9931, con solicitudes compatibles con OpenAI bajo /v1. Es compatibilidad local, no una solicitud a la nube de OpenAI. Comprueba en Configuración si se ha cambiado el puerto. Documentación de la API de Llama
Con la aplicación en ejecución y el modelo ya cargado, abre PowerShell. Primero enumera los modelos disponibles en el router: /models incluye el estado de carga, mientras que /v1/models es el endpoint de metadatos compatible con OpenAI. Copia el identificador exacto del modelo que has cargado a propósito. No elijas una entrada arbitraria, porque podría provocar que se cargue otro modelo.
$base = 'http://localhost:9931'
$headers = @{}
# Only needed if your local server is configured to require a key.
if ($env:LLAMA_LOCAL_API_KEY) {
    $headers.Authorization = "Bearer $env:LLAMA_LOCAL_API_KEY"
}
Invoke-RestMethod -Uri "$base/models" -Headers $headers |
    ConvertTo-Json -Depth 10
Antes de ejecutar el segundo bloque, sustituye el marcador de posición por ese identificador exacto. Solo envía texto sintético y no requiere un SDK adicional:
$modelId = 'PASTE-THE-LOADED-MODEL-ID'
if ($modelId -eq 'PASTE-THE-LOADED-MODEL-ID') {
    throw 'Choose the already-loaded model ID from /models first.'
}
$body = @{
    model = $modelId
    messages = @(@{
        role = 'user'
        content = 'Rewrite clearly: Our fictional workshop begins at noon.'
    })
    max_tokens = 96
    stream = $false
} | ConvertTo-Json -Depth 5
$reply = Invoke-RestMethod -Method Post `
    -Uri "$base/v1/chat/completions" -Headers $headers `
    -ContentType 'application/json' -Body $body -TimeoutSec 180
$reply.choices[0].message.content
La estructura de la solicitud y el campo de salida siguen la referencia oficial del servidor llama.cpp. Deja Escuchar en en localhost; nunca pegues una clave de API en la nube en este ejemplo. Un error 401 requiere revisar la autenticación local, no eliminar la protección. En v0.12.0, al elegir una dirección que no sea de bucle local, la aplicación genera una clave y pide confirmación. Comportamiento de seguridad en Windows
La inferencia local no elimina todas las operaciones de red
El README de Windows indica que los prompts y la inferencia se quedan en el equipo y que la aplicación no envía telemetría. También documenta solicitudes de red para descargar modelos y comprobar actualizaciones, con un User-Agent que incluye la versión de la aplicación, la compilación de Windows y la arquitectura. Son actividades distintas; no hay contradicción entre ellas y el término «sin conexión». Declaración de privacidad
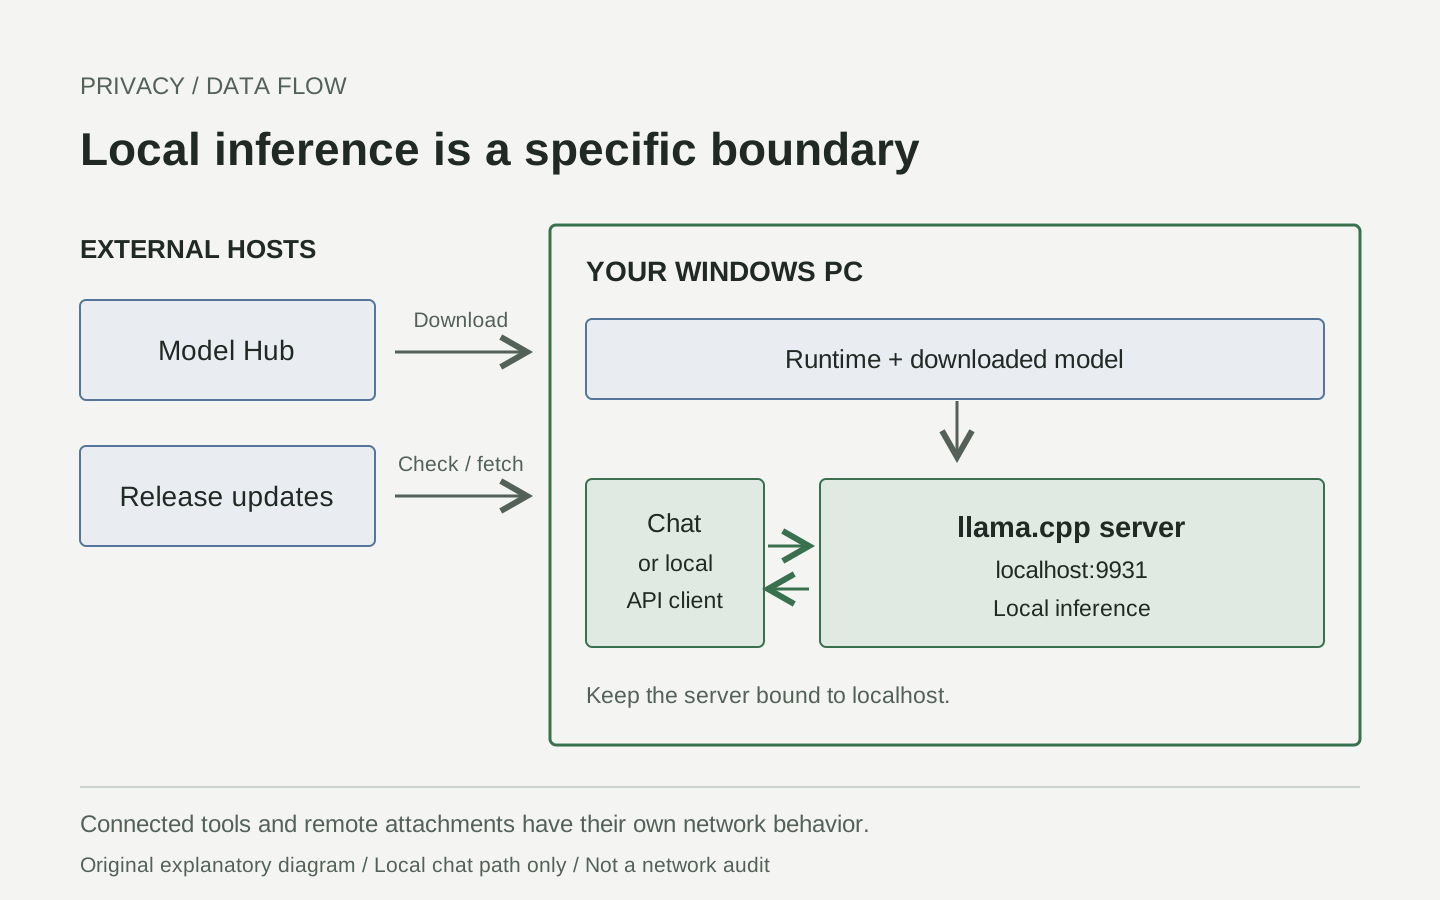
Explicación original del flujo de datos. Los servidores de descarga son externos; el recorrido de chat ilustrado es local. Fuentes: documentación de privacidad de Windows y referencia de la API.
Un modelo descargado y compatible puede ejecutar inferencias sin conexión a Internet, pero para descargar un modelo nuevo hace falta conexión. Un editor conectado, una extensión del navegador, una URL de archivo adjunto remoto o una herramienta externa habilitada tienen sus propios comportamientos de red. No des por hecho que heredan el límite local del servidor.
Antes de trabajar con información confidencial, comprueba dónde se guardan las conversaciones, las extensiones del navegador, las copias de seguridad y sincronización, y las normas de tu organización. Un chat sintético sin conexión es una comprobación funcional útil tras la configuración, no una auditoría de todos los componentes. No incluyas tokens ni prompts privados en registros de diagnóstico públicos.
Resuelve el problema de la etapa que falla, no de toda la instalación
| Síntoma | Qué comprobar primero | Siguiente medida útil |
|---|---|---|
| El paquete no se instala | Compilación mínima 26100, arquitectura, firma y política del dispositivo | Conserva el error exacto del Instalador de aplicaciones; usa actualizaciones oficiales o pide ayuda a la persona administradora |
| No aparece ninguna ventana | Área de notificación e iconos ocultos | Abre el icono de la bandeja; no se espera una ventana permanente en la barra de tareas |
| Falla la descarga del modelo | Espacio de destino, conectividad, acceso restringido y error mostrado | Resuelve esa causa antes de repetir el intento; empieza con un modelo público |
| Termina la descarga, pero falla la carga | Estimación de contexto, memoria libre y error del entorno de ejecución | Detén otros modelos cargados y reduce el contexto o el tamaño del modelo |
| Las respuestas son lentas | Tamaño del modelo, longitud del contexto y backend de CPU/GPU que se está usando realmente | Compara un prompt breve; no des por garantizada la velocidad por aparecer como recomendado en el catálogo |
| La API no se conecta | Aplicación en ejecución, puerto configurado y dirección local | Comprueba el estado del servidor antes de iniciar otro servidor |
| Una respuesta fluida contiene datos falsos | Texto de origen y adecuación del modelo | Acota la tarea y exige citas que la respalden |
El README actual sitúa los ajustes y registros en %LOCALAPPDATA%\Llama; la publicación de lanzamiento indicaba otra ruta para los registros. Usa el control de la aplicación para abrir la carpeta de registros, en vez de adivinarla. El endpoint documentado /health ayuda a diferenciar un servidor listo de otro que aún se está cargando, aunque la actividad del router no demuestra que se haya cargado el modelo elegido. Documentación de almacenamiento actual, comportamiento de salud del servidor
Da por buena la primera configuración solo cuando supere estas comprobaciones
- El paquete oficial firmado se instala sin desactivar controles de seguridad.
- Un modelo elegido deliberadamente termina de descargarse y se carga.
- El chat se abre en una dirección local y responde a la tarea sintética.
- Las fechas, los nombres y la información ausente coinciden con el texto proporcionado.
- Puedes detener el modelo y volver a cargarlo.
- Si usas la API, responde el modelo elegido y el servidor permanece limitado a localhost.
La conclusión: la IA local es un flujo que puedes inspeccionar
En nuestra opinión, la mejora importante no consiste en ahorrarse un comando de terminal. Consiste en que la selección del modelo, el uso de memoria, el material de origen y la respuesta obtenida sean lo bastante claros para poder repetir el proceso. Empieza con una tarea pequeña cuya respuesta puedas verificar. Amplía el uso solo cuando sepas cómo reconocer un resultado correcto.
Fuentes y material gráfico
Comprobado el 20 de octubre de 2026. Esta guía describe flujos documentados; no afirma haber realizado instalaciones, ejecutado modelos, hecho solicitudes de pago ni comparativas de rendimiento. Los tres SVG son ilustraciones explicativas originales, no reproducciones de la interfaz. Consulta la captura oficial de la bandeja y la demostración de la superposición del editor para ver la interfaz real. Esos recursos están enlazados, no republicados.
- Anuncio de Hugging Face, 13 de octubre
- Versión para Windows, paquete y cambios de seguridad
- Instalación e inicio rápido oficiales
- Formato GGUF y metadatos
- Documentación de la API local y sus endpoints
- Referencia del entorno de ejecución y servidor llama.cpp
Conserva tus experimentos para poder reutilizarlos
Guarda juntos los enlaces de las fuentes, los prompts, los identificadores de modelo y las notas de revisión, en lugar de conservar solo la respuesta final. Telli.sh puede ayudarte a organizar esas notas de investigación; no es una integración con Llama Windows ni una garantía de que tus notas permanezcan sin conexión. Crea una cuenta de Telli.sh