Czy Twoja lokalna aplikacja AI przejdzie na llama.cpp 1.0 bez zakłócania pracy?
W llama.cpp 1.0 zmiany łamiące zgodność publicznego interfejsu C widać w numerach wersji. Sprawdź bibliotekę, lokalny serwer i instalowaną aplikację przed wymianą działającej wersji.
Mały zespół inżynierów zabiera asystenta do pracy z dokumentami w miejsce, gdzie trudno o dostęp do internetu. Asystent analizuje akapit z instrukcji serwisowej, podaje krótką odpowiedź i wskazuje stronę. Na laptopie deweloperskim nowa kompilacja llama.cpp uruchamia się i zwraca tekst. Na laptopie używanym w terenie zapisany skrót nadal przekazuje starą opcję. Na kolejnym etapie aplikacja oczekuje pola odpowiedzi, którego podczas ręcznej próby nikt nie sprawdził. We wszystkich trzech sytuacjach zespół mówi o aktualizacji llama.cpp, choć za każdym razem korzysta z innego interfejsu.
13 listopada 2026 r. ggml-org wydało llama.cpp i ggml 1.0.0. Pierwszy projekt uruchamia modele językowe i udostępnia bibliotekę do inferencji o nazwie libllama. Drugi dostarcza operacje na tensorach oraz różne mechanizmy obsługi sprzętu, a jego biblioteka nosi nazwę libggml. Opiekunowie ogłosili, że przyszłe zmiany łamiące zgodność publicznych interfejsów C będą widoczne w głównych numerach wersji. Z llama.cpp 1.0.0 usunięto już przestarzałe wywołania oraz wycofaną opcję wiersza poleceń. Ogłoszenie opiekunów projektu z 13 listopada o zasadach wersjonowania · Wydanie llama.cpp 1.0.0 · Wydanie ggml 1.0.0
Przed zmianą środowiska wykonawczego ustal, do której z trzech grup należy Twoja integracja. Część aplikacji kompiluje się i łączy z biblioteką C. Inne uruchamiają lokalny serwer HTTP i wysyłają do niego żądania. Są też aplikacje, które rozprowadzają środowisko wykonawcze w gotowym instalatorze. Jedna aplikacja może należeć do kilku grup. Każda z nich ma własny zestaw krótkich kontroli, które dają lepsze podstawy do decyzji o aktualizacji niż udany pokaz na komputerze dewelopera.
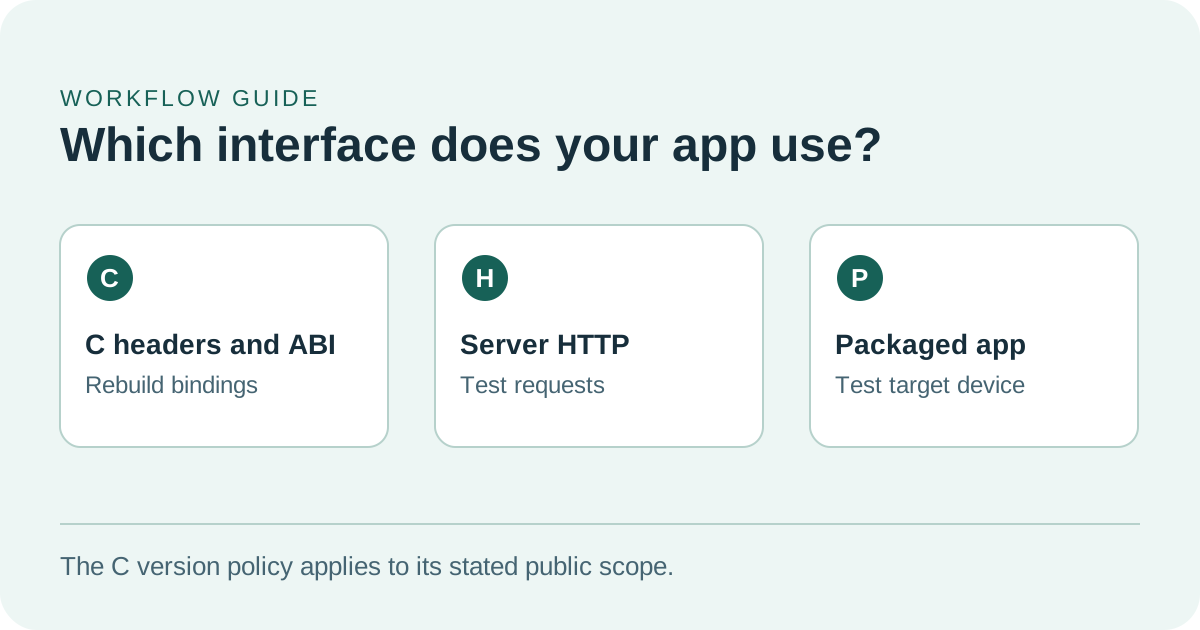
Zgodność interfejsu C, odpowiedzi HTTP i kompilacje dostarczane w instalatorze wymagają różnych kontroli.
Wersja 1.0 daje integracjom natywnym wyraźniejszy sygnał
Pliki nagłówkowe C opisują, jak kod źródłowy wywołuje bibliotekę. Informują kompilator o dostępnych funkcjach i typach danych. Interfejs binarny, oznaczany skrótem ABI, określa sposób współpracy między skompilowanym kodem a skompilowaną biblioteką. Ponowna kompilacja od podstaw może szybko ujawnić brak deklaracji usuniętej z nagłówka. Uruchomienie połączonej aplikacji pokazuje, co rzeczywiście dzieje się z biblioteką zainstalowaną na docelowym komputerze. Aplikacja, która ładuje własne zależności natywne, powinna przejść obie próby.
Zasady ogłoszone przez opiekunów 13 listopada przewidują zmianę numeru głównego przy zmianie łamiącej zgodność publicznego API języka C w katalogach nagłówków projektu. Zgodne wstecz rozszerzenia, aktualizacje obsługi sprzętu i obsługę modeli przypisano do wydań podrzędnych, a poprawki bez zmian w API do wydań poprawkowych. To użyteczna informacja dla dostawców natywnych wiązań. Przy dystrybucji programu uruchamianego z wiersza poleceń lub klienta HTTP nadal trzeba sprawdzić opcje i żądania, z których korzystają użytkownicy. Ogłoszenie opiekunów o zasadach wersjonowania
Zmiany opisane pod tagiem wydania dają konkretny przykład. Informacje o llama.cpp 1.0.0 wymieniają usunięcie 35 przestarzałych funkcji z llama.h, a osobno usunięcie llama_set_warmup i wycofanych elementów sterujących defragmentacją. Podają też, że interfejs NextN do dekodowania spekulatywnego przeniesiono do llama.h, oraz opisują zmianę nazwy związaną ze stanem. Zacznij od wywołań obecnych w swoim kodzie. Jeśli kompilator zgłosi brak funkcji, zapoznaj się z informacjami o wydaniu i aktualnym publicznym nagłówkiem, aby ustalić, jak odtworzyć potrzebne działanie. Zmiany w API 1.0.0 · Publiczne nagłówki pod tagiem 1.0.0
W przykładzie z asystentem do instrukcji prosty test natywny może załadować znany plik modelu, wysłać pytanie z krótkim fragmentem tekstu, odczytać odpowiedź i poprawnie zwolnić model. Powtórz ładowanie i zwalnianie w procesie aplikacji, z którego korzystają użytkownicy. Jeśli wiązania dla innego języka są kompilowane osobno, sprawdź, czy ich kompilacja używa właściwych nagłówków, a po instalacji środowisko wykonawcze ładuje właściwą bibliotekę. Zapisz użyty plik binarny przed oceną wyniku. Udana kompilacja z lokalną kopią niewiele mówi o innej kopii dołączonej do aplikacji na laptopie używanym w terenie.
Przetestuj część stosu, od której zależy praca użytkowników
Projekt udostępnia również llama-server, proces HTTP z własnymi argumentami wiersza poleceń i udokumentowanymi punktami końcowymi. Wydanie 1.0.0 dodaje zgodny z OpenAI punkt końcowy /v1/audio/speech. To przykład funkcji serwera rozwijanej równolegle z biblioteką C. W tym samym wydaniu usunięto --defrag-thold. Usługa dostarczana w instalatorze, która przekazuje tę opcję, wymaga migracji także wtedy, gdy bezpośrednio nie wywołuje funkcji C. Informacje o wydaniu 1.0.0 · Dokumentacja serwera pod tagiem 1.0.0
Dokumentacja serwera opisuje krótką kontrolę, którą można dodać do próby aplikacji. Żądanie pod adresem /health może zwrócić kod HTTP 503 podczas ładowania modelu. Po załadowaniu zwraca 200. Zespół korzystający z klienta HTTP może następnie wysłać własne żądanie czatu, osadzenia lub innej operacji i potwierdzić, że klient odczytuje otrzymaną odpowiedź. Przy strumieniowaniu uwzględnij krótką odpowiedź, która kończy się zwykłym trybem, oraz dłuższą odpowiedź, którą użytkownik anuluje w aplikacji. Żądanie do najprostszego punktu końcowego omija przycisk anulowania i parser tekstu. Dokumentacja kontroli stanu i punktów końcowych serwera w wersji 1.0.0
| Z czego korzysta aplikacja | Pierwsza kontrola po aktualizacji | Co dochodzi w rzeczywistym scenariuszu |
|---|---|---|
| Publiczne nagłówki C i biblioteka natywna | Skompiluj od podstaw i uruchom z docelową biblioteką | Załaduj model, wyślij krótkie żądanie i wielokrotnie zwolnij zasoby |
| Proces lokalnego serwera HTTP | Uruchom z zapisanymi ustawieniami i poczekaj na gotowość modelu | Sprawdź rzeczywiste żądanie, odbiór strumieniowy, anulowanie i stany błędów obsługiwane przez klienta |
| Instalator aplikacji biurkowej lub działającej offline | Zainstaluj na reprezentatywnym komputerze i zapisz dane o artefaktach kompilacji | Otwórz aplikację z dotychczasowymi ustawieniami użytkownika i użyj znanego modelu lokalnego w zainstalowanej wersji |
| Konkretny mechanizm obsługi sprzętu | Sprawdź, jaki mechanizm wybrano i czy model mieści się w pamięci | Porównaj pamięć i czasy w najwolniejszej konfiguracji objętej deklarowanym wsparciem |
Trzeci rodzaj integracji niesie skutki wykraczające poza listę funkcji serwera. Pakiet dla Windows może potrzebować biblioteki obsługi sprzętu w tym samym katalogu co plik wykonywalny. Musi również umieć znaleźć istniejący model użytkownika i wyświetlić czytelny komunikat, gdy pliku brakuje. Deweloper może mieć działającą bibliotekę zainstalowaną niezależnie od aplikacji. Próba na reprezentatywnej instalacji użytkownika ujawnia brak zależności, które środowisko deweloperskie już zapewnia. Ogłoszenie z 13 listopada wymienia kilka sposobów pakowania i platformy objęte wersjami przedpremierowymi. Użyj dokładnie tego tagu albo pakietu, który planujecie dostarczyć, i zapisz jego pochodzenie. Uwagi opiekunów na temat pakowania
Numer wersji nie powie, po jakim czasie asystent odpowie na pytanie o instrukcję
Użytkownik czekający na asystenta offline odczuwa kilka etapów jako jedno opóźnienie. Najpierw ładuje się model. Aplikacja dzieli pytanie i fragment dokumentu na tokeny. Środowisko wykonawcze przetwarza dane wejściowe, zaczyna generować tekst i wysyła go do interfejsu. Przy długim fragmencie instrukcji większość czasu może zająć przetworzenie tekstu wejściowego. Przy celowo obszernej odpowiedzi więcej czasu może pochłonąć generowanie tokenów. Zmierz osobno rozruch, czas do pierwszego widocznego tekstu i czas ukończenia, jeżeli każdy z nich ma znaczenie dla użytkownika.
Dokumentacja pod tagiem 1.0.0 rozróżnia trzy tryby llama-bench: przetwarzanie danych wejściowych, generowanie tekstu i tryb łączony. Podaje, że pomiary nie obejmują tokenizacji i próbkowania. Dzięki temu można porównać dwie kompilacje środowiska w tych samych ustawieniach. Otrzymany wynik będzie różnił się od czasu oczekiwania zmierzonego w aplikacji. Zapisz oba pomiary, jeśli chcesz ustalić, na którym etapie nastąpiła poprawa. Dokumentacja narzędzia pomiarowego pod tagiem 1.0.0
Zacznij od użycia tego samego pliku modelu GGUF w obu kompilacjach. Jeśli obie wersje to umożliwiają, zachowaj te same ustawienia kontekstu, zaplecze sprzętowe i ustawienia przenoszenia obliczeń między urządzeniami. Zapisz faktycznie użyte parametry wraz z sumą kontrolną modelu. Następnie sprawdź krótkie dane wejściowe i tekst o długości typowej dla dokumentu. Mierząc pamięć, zapisz stan ustalony po załadowaniu oraz najwyższe zaobserwowane zużycie podczas najdłuższego reprezentatywnego żądania. Model, który startuje na świeżo uruchomionym laptopie, może osiągnąć inny limit, gdy użytkownik ma już otwartą przeglądarkę i podgląd dokumentów.
W wydaniu 1.0.0 wymieniono opcje FP8 pamięci podręcznej kluczy i wartości używanej podczas inferencji, w tym f8_e4m3, oraz konfigurowalną pamięć podręczną ekspertów w pamięci hosta dla modeli typu mixture-of-experts. Można więc porównać więcej ustawień. Jeśli dany model i sposób obsługi sprzętu wspierają wybrane ustawienie, zmierz jego wpływ osobno od migracji do 1.0. Zastosuj je na jednym reprezentatywnym komputerze, powtórz zadania na tych samych danych i sprawdź, czy odpowiedzi nadal spełniają wymagania aplikacji. To ułatwia prześledzenie zmiany czasu lub braku odwołania do źródła. Najważniejsze zmiany w wydaniu 1.0.0
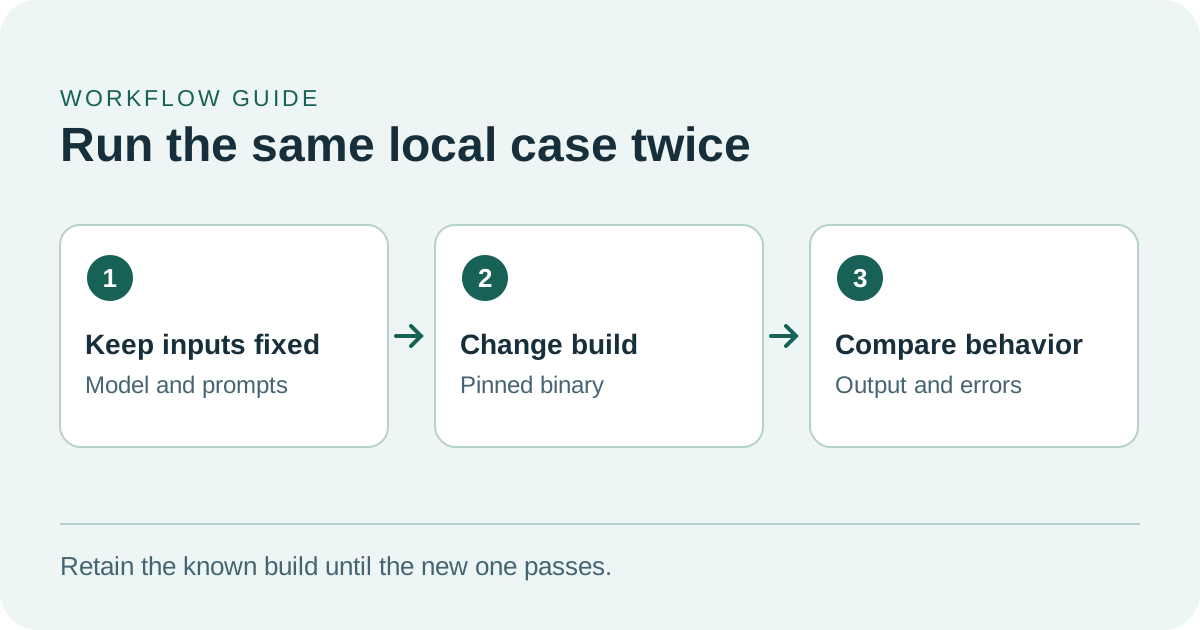
Zachowaj ten sam model i te same dane wejściowe, by móc przypisać różnice aktualizacji.
Krótka próba migracji daje podstawę do decyzji o wydaniu
- Wybierz dwie konkretne kompilacje. Przechowuj aktualnie dystrybuowaną wersję i kandydatkę 1.0.0 w różnych lokalizacjach. Zapisz wersję aplikacji, środowiska i modelu, tę samą sumę kontrolną GGUF dla każdego uruchomienia i sposób obsługi sprzętu. Przy przełączaniu wersji zachowaj dane oraz ustawienia.
- Uruchom aplikację w zwykły sposób. Do próby serwera ograniczonego do lokalnego interfejsu pętli zwrotnej posłuży
llama-server -m ./handbook-model.gguf --host 127.0.0.1 --port 9931. Zastąp przykład ścieżką do faktycznie zatwierdzonego pliku modelu. Uruchom również polecenie stosowane w dystrybuowanej wersji, by szybko wykryć wycofane opcje. Sprawdź stan gotowości i użyj klienta, który rzeczywiście otwierają użytkownicy. Konfiguracja i opcje serwera pod tagiem wydania - Przygotuj kilka trudnych pytań. Użyj krótkiego fragmentu z jedną jasną odpowiedzią, dłuższego tekstu z niejednoznaczną terminologią i pytania, na które fragment nie pozwala odpowiedzieć. Określ oczekiwany wynik w każdym przypadku. Asystent powinien wskazać właściwą stronę, gdy tekst zawiera odpowiedź, i poinformować o braku dowodów. Rejestruj błędy odczytu odpowiedzi i nieużyteczne wyniki osobno od jakości modelu.
- Porównuj po jednym ustawieniu wpływającym na wydajność. Na reprezentatywnym komputerze można zacząć od
llama-bench -m ./handbook-model.gguf -p 512 -n 128 -r 5dla obu kompilacji i tego samego sposobu obsługi sprzętu. Podane liczby tokenów i pięć powtórzeń to przykład. Przed decyzją dodaj pomiary rozruchu, pamięci i opóźnienia na poziomie aplikacji oraz dłuższy rzeczywisty materiał wejściowy. Opcje testu wydajności pod tagiem wydania - Przetestuj zainstalowaną wersję i przećwicz powrót. Wypróbuj kandydatkę na czystej, reprezentatywnej instalacji, uruchom ją ponownie i powtórz największy obsługiwany scenariusz. Sprawdź, czy po nieudanym uruchomieniu nadal można korzystać z dotychczasowych ustawień i plików oraz czy da się wrócić do poprzedniej wersji aplikacji. Zapisz wyniki, które pozwolą drugiej osobie ustalić, kiedy wstrzymać szersze wdrożenie.
W większości projektów wystarczy kilka dobrze dobranych przypadków testowych, aby znaleźć najbliższy problem. Gdy przetwarzanie długiego fragmentu zwalnia, najpierw ustal, czy różnica występuje przed pojawieniem się pierwszego tekstu, podczas generowania, czy w trakcie wyświetlania w aplikacji. Jeśli żądanie zaczyna się nie udawać po zmianie, przed zmianą polecenia lub modelu zapisz, który format żądania i który klient wywołują problem. Jeśli błąd występuje wyłącznie w wersji z instalatora, porównaj instalator i uruchomiony proces z działającą kopią deweloperską. Każda z tych prób daje osobie odpowiedzialnej za dany obszar konkretny przypadek do odtworzenia.
Aktualizacja powinna działać za każdym razem na docelowym komputerze
Wartością llama.cpp 1.0 jest przejrzystszy sposób zarządzania zmianami w środowisku wykonawczym, na którym polega wiele narzędzi lokalnych. Zespół aplikacji może odpowiedzieć na tę zmianę krótkim zapisem zgodności obejmującym kompilację, model, komputer, rzeczywiste żądanie w interfejsie i wynik. Następną aktualizację można wówczas zacząć od sprawdzenia sposobu pracy użytkowników, nawet po zmianie osób utrzymujących środowisko wykonawcze i aplikację.
Źródła
- Ogłoszenie ggml-org o zasadach wersjonowania i dystrybucji, 13 listopada 2026 r.
- Wydanie llama.cpp 1.0.0, 13 listopada 2026 r.
- Wydanie ggml 1.0.0
- Publiczne nagłówki C llama.cpp pod tagiem 1.0.0
- Dokumentacja llama-server pod tagiem 1.0.0
- Dokumentacja llama-bench pod tagiem 1.0.0
Aby móc łatwo odnaleźć decyzje o aktualizacji, uwagi z prób i konfiguracje modeli, załóż konto w Telli.sh.