로컬 AI 앱을 llama.cpp 1.0으로 올려도 기존 작업이 그대로 돌아갈까?
llama.cpp 1.0은 공개 C 인터페이스의 호환성 변경을 버전 번호로 드러냅니다. 정상 동작하는 빌드를 교체하기 전에 라이브러리, 로컬 서버, 설치 패키지를 어떻게 점검할지 살펴봅니다.
소규모 엔지니어링 팀이 인터넷 연결이 불안정한 현장에 오프라인 문서 도우미를 가져갑니다. 정비 매뉴얼에서 문단을 읽고 출처 페이지와 짧은 답을 내는 앱입니다. 개발 노트북에서는 새 llama.cpp 빌드가 실행되고 문장도 나옵니다. 현장 노트북에는 예전 옵션을 그대로 넘기는 실행 설정이 남아 있습니다. 그다음에는 앱이 기대하는 응답 필드가 있는데, 개발자가 수동으로 실행해 볼 때는 그 필드를 확인하지 않았습니다. 세 곳 모두 llama.cpp를 업그레이드하는 일이지만 저마다 의존하는 인터페이스가 다릅니다.
2026년 11월 13일 ggml-org가 llama.cpp와 ggml 1.0.0을 공개했습니다. llama.cpp는 언어 모델을 실행하고 추론 라이브러리를 libllama라는 이름으로 제공합니다. ggml은 텐서 연산과 하드웨어 백엔드를 제공하며 라이브러리 이름은 libggml입니다. 유지보수팀은 앞으로 공개 C 인터페이스에서 호환성이 깨지는 변경을 메이저 버전에 표시한다고 밝혔습니다. llama.cpp 1.0.0에서는 이미 폐기 예정이었던 호출과 퇴역한 명령줄 옵션을 제거했습니다. 11월 13일 유지보수팀의 버전 정책 발표 · llama.cpp 1.0.0 릴리스 · ggml 1.0.0 릴리스
런타임을 교체하기 전에 앱이 어디에 해당하는지 살펴보세요. 어떤 앱은 C 라이브러리를 빌드해 링크합니다. 어떤 앱은 로컬 HTTP 서버를 띄우고 요청을 보냅니다. 또 어떤 앱은 바로 설치할 수 있는 패키지에 런타임을 넣어 배포합니다. 한 앱이 여러 유형에 걸칠 수도 있습니다. 각 유형에 맞는 짧은 검사 몇 가지를 해 두면 개발자 컴퓨터에서 데모가 한 번 성공한 것보다 업그레이드를 판단할 근거가 분명해집니다.
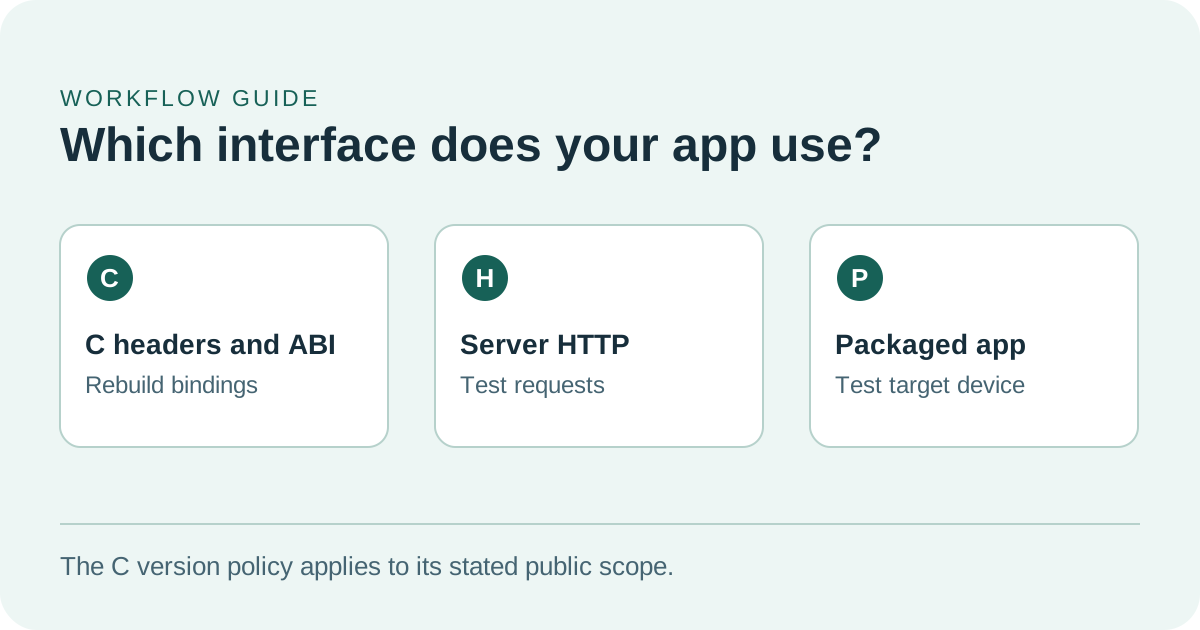
C 호환성, HTTP 응답, 배포 패키지는 서로 다른 검사가 필요합니다.
1.0은 네이티브 연동의 변경을 더 선명하게 알린다
C 헤더는 소스 코드가 라이브러리를 어떻게 호출하는지 보여 줍니다. 컴파일러는 헤더에서 사용할 수 있는 함수와 자료형을 파악합니다. ABI라고도 하는 바이너리 인터페이스는 컴파일된 코드와 라이브러리가 맞물리는 방식을 정합니다. 새로 빌드하면 소스에서 쓰던 선언이 사라졌을 때 일찍 알 수 있습니다. 링크한 앱을 실제로 실행하면 대상 기기에 설치된 라이브러리와 함께 어떤 일이 일어나는지 확인할 수 있습니다. 네이티브 의존성을 직접 로드하는 앱이라면 두 검사 모두 해 보세요.
유지보수팀이 11월 13일 발표한 정책에 따르면, 프로젝트의 include 디렉터리에 있는 공개 C API에서 호환성을 깨는 변경은 메이저 버전에 반영합니다. 호환되는 기능 추가, 백엔드 업데이트, 모델 지원은 마이너 버전에서 다루고, API가 바뀌지 않는 수정은 패치 버전으로 냅니다. 네이티브 바인딩을 배포하는 사람에게 유용한 기준입니다. 명령줄 실행기나 HTTP 클라이언트를 배포하는 팀이라면 사용자가 이미 쓰는 옵션과 요청도 여전히 확인해야 합니다. 유지보수팀의 버전 정책 발표
릴리스 태그에 적힌 변경이 구체적인 사례입니다. llama.cpp 1.0.0 릴리스 노트에는 llama.h에서 폐기 예정 함수 35개를 제거했다고 나옵니다. 여기에는 llama_set_warmup과 퇴역한 조각 모음 설정의 제거가 따로 기재돼 있습니다. 추측 디코딩에 쓰이는 NextN API는 llama.h로 옮겼고, 상태 관련 이름 변경도 문서화했습니다. 앱이 실제로 쓰는 호출부터 확인하세요. 컴파일러가 없어진 함수를 가리킨다면 기존 동작을 어떻게 대체할지 정하기 전에 릴리스 노트와 현재 공개 헤더를 봅니다. 1.0.0 API 변경 사항 · 1.0.0 태그의 공개 헤더
오프라인 매뉴얼 도우미라면 네이티브 점검에서 이미 알고 있는 모델 파일을 불러오고, 짧은 발췌문과 질문을 보내고, 나온 답을 읽고, 모델을 정상적으로 닫아 볼 수 있습니다. 사용자가 실행하는 앱 프로세스 안에서 로드와 종료를 반복합니다. 별도로 컴파일하는 언어 바인딩이 있다면 빌드 시 의도한 헤더를 참조하고, 설치 후 런타임이 의도한 라이브러리를 불러오는지 봅니다. 결과를 해석하기 전에 사용한 산출물을 기록하세요. 개발 기기에서 쓰는 라이브러리에 맞춰 컴파일됐다는 것만으로 현장 노트북에서 앱과 함께 배포한 복사본의 동작을 판단하기는 어렵습니다.
사용자가 의존하는 계층을 실제로 시험한다
프로젝트는 자체 명령줄 인수와 문서화된 엔드포인트를 갖춘 HTTP 프로세스 llama-server도 제공합니다. 1.0.0에서 OpenAI 호환 /v1/audio/speech 엔드포인트를 추가했습니다. C 라이브러리와 함께 서버 기능도 바뀔 수 있다는 사례입니다. 같은 버전에서 --defrag-thold를 제거했습니다. 패키지에 포함된 서비스가 그 옵션을 넘긴다면 C 함수를 직접 호출하지 않아도 마이그레이션해야 합니다. 1.0.0 릴리스 노트 · 1.0.0 태그의 서버 문서
서버 문서에는 앱 테스트와 함께 쓸 만한 짧은 점검이 있습니다. /health 요청은 모델을 로드하는 동안 HTTP 503을 반환할 수 있고 로드가 끝나면 200을 반환합니다. HTTP 클라이언트에 의존하는 팀이라면 이어서 실제 채팅, 임베딩 또는 다른 요청을 보내 응답을 파싱할 수 있는지 확인합니다. 스트리밍 기능에는 정상적으로 끝나는 짧은 응답과, 사용자가 앱에서 중간에 취소하는 긴 응답을 모두 포함합니다. 가장 간단한 엔드포인트를 한 번 호출하는 검사만으로는 취소 버튼이나 텍스트 파서까지 확인할 수 없습니다. v1.0.0 서버 상태와 엔드포인트 문서
| 앱에서 쓰는 구성 | 업그레이드 직후 첫 확인 | 실제 작업에서 추가로 볼 점 |
|---|---|---|
| 공개 C 헤더와 네이티브 라이브러리 | 처음부터 다시 빌드하고 의도한 라이브러리로 실행합니다 | 모델을 불러오고 짧은 요청을 보낸 뒤 리소스 해제를 반복합니다 |
| 로컬 HTTP 서버 프로세스 | 저장된 설정으로 시작하고 모델이 준비 상태가 될 때까지 기다립니다 | 클라이언트가 지원하는 실제 요청, 스트리밍 응답, 취소, 오류 상태를 확인합니다 |
| 번들형 데스크톱 앱 또는 오프라인 설치 프로그램 | 대표 기기에 설치하고 빌드 산출물을 기록합니다 | 기존 사용자 설정으로 앱을 열고 설치한 빌드에서 익숙한 로컬 모델을 사용합니다 |
| 특정 하드웨어 백엔드 | 선택된 백엔드와 모델이 메모리에 들어가는지 확인합니다 | 지원을 약속한 가장 느린 구성에서 메모리와 시간을 비교합니다 |
세 번째 연동 방식은 서버 기능 목록 밖에도 영향을 줍니다. 예를 들어 Windows 패키지는 실행 파일 옆에 백엔드 라이브러리가 필요할 수 있습니다. 사용자가 이미 받아 둔 모델을 찾는 방법과, 파일이 없을 때 알기 쉬운 오류 메시지도 필요합니다. 개발자 기기에는 정상 작동하는 백엔드가 따로 설치돼 있을 수 있죠. 일반 사용자를 대표하는 설치 환경에서 새 앱을 실행해 보면 개발 환경이 이미 제공하던 의존성의 누락을 찾을 수 있습니다. 11월 13일 발표에는 여러 패키징 경로와 사전 릴리스 플랫폼이 정리돼 있습니다. 실제로 배포할 태그나 패키지 빌드를 써서 출처와 버전을 남겨 두세요. 유지보수팀의 패키징 설명
버전 번호만으로 매뉴얼 답변이 얼마나 빨라질지 알 수 없다
오프라인 도우미를 기다리는 사람에게는 여러 단계가 하나의 대기 시간처럼 느껴집니다. 먼저 모델을 로드합니다. 앱이 질문과 문서 발췌문을 토큰화하면 런타임이 프롬프트를 처리하고 텍스트를 생성해 화면에 보냅니다. 긴 정비 문단이라면 프롬프트 처리에 시간이 많이 들 수 있고, 길게 답하도록 한 요청이라면 토큰 생성에 시간이 더 들 수 있습니다. 사용자에게 각각 의미가 있다면 시작 시간, 화면에 글자가 처음 뜨기까지 걸린 시간, 응답 완료 시간을 따로 측정합니다.
1.0.0 태그의 문서는 llama-bench를 프롬프트 처리, 텍스트 생성, 두 단계를 합한 모드로 구분합니다. 문서에 따르면 보고하는 시간에는 토큰화와 샘플링이 포함되지 않습니다. 같은 설정에서 두 런타임 빌드를 비교할 때 유용하고, 화면에서 잰 대기 시간과 수치가 왜 다른지도 설명해 줍니다. 어느 단계가 개선됐는지 보려면 두 값을 모두 기록하세요. 1.0.0 태그의 벤치마크 문서
두 빌드에서 같은 GGUF 모델 파일을 먼저 사용합니다. 두 빌드가 모두 지원하는 범위에서 하드웨어 백엔드, 컨텍스트 설정, 오프로딩 방식을 맞추고 실제 설정과 모델 해시를 함께 저장합니다. 짧은 입력과 문서 길이의 입력을 각각 시험합니다. 메모리는 로드 직후 안정된 값과, 대표 작업 중 가장 긴 요청에서 관찰할 수 있는 최고치를 함께 기록합니다. 다른 앱이 없는 노트북에서는 시작되던 모델도 사용자가 브라우저와 문서 뷰어를 이미 열어 둔 환경에선 다른 한계에 부딪힐 수 있습니다.
1.0.0 릴리스에는 추론 중 쓰는 키-값 캐시를 위한 f8_e4m3 등의 FP8 옵션과, 전문가 혼합 모델에서 호스트 메모리에 둘 전문가 캐시를 설정하는 기능이 포함됩니다. 비교할 구성이 그만큼 늘어납니다. 백엔드와 모델이 설정을 지원한다면 1.0 마이그레이션과 분리해 영향을 측정하세요. 대표 기기 한 대에 적용한 뒤 같은 입력을 다시 돌리고 답이 앱의 요구를 여전히 만족하는지 비교합니다. 그러면 응답 시간이 달라지거나 인용이 빠졌을 때 원인이 된 변경을 찾기 쉽습니다. 1.0.0 릴리스의 주요 변경 사항
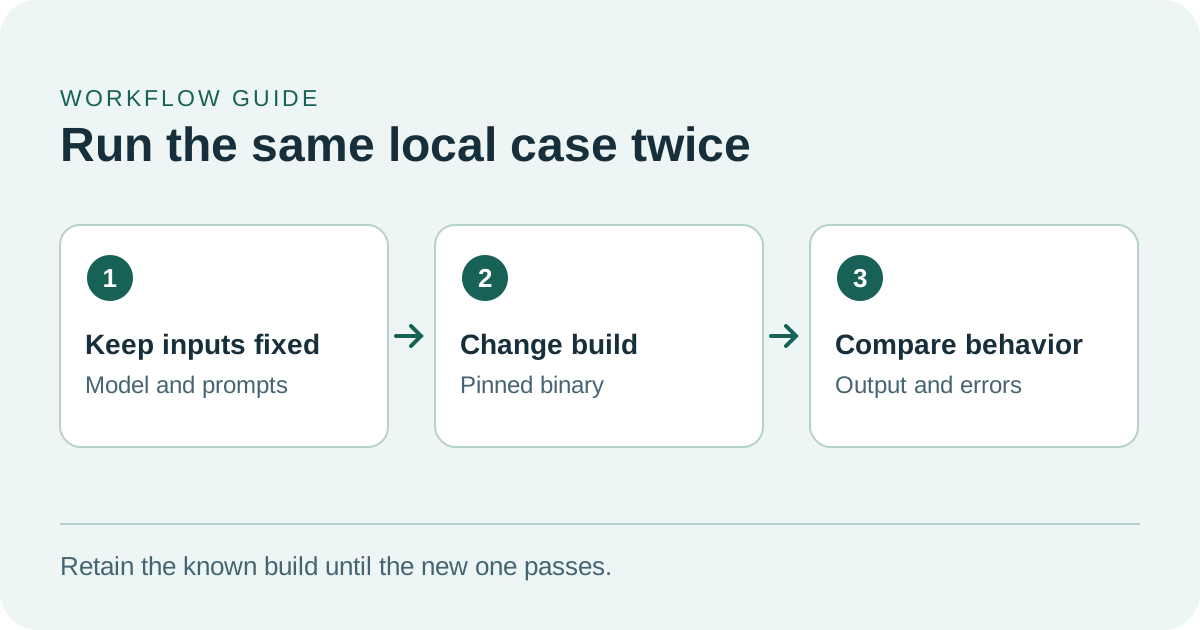
모델과 입력을 고정하면 차이가 업그레이드에서 왔는지 확인할 수 있습니다.
짧은 마이그레이션 예행연습으로 배포 기준을 정한다
- 두 빌드를 정확히 지정합니다. 배포 중인 빌드와 1.0.0 후보를 서로 다른 위치에 둡니다. 앱, 런타임, 모델 버전과 하드웨어 백엔드를 기록하고, 같은 GGUF 체크섬을 사용했는지 매번 확인합니다. 빌드를 바꿀 때 사용자 데이터와 앱 설정을 보존합니다.
- 일상적인 실행 경로를 사용합니다. 루프백으로만 서버를 시험하려면 실제 승인된 모델 파일로 교체한 뒤
llama-server -m ./handbook-model.gguf --host 127.0.0.1 --port 9931부터 시작할 수 있습니다. 배포 중인 명령도 돌려 없어진 옵션을 일찍 찾습니다. 준비 상태를 확인하고 사용자가 실제로 여는 클라이언트로 시험합니다. 태그에 고정된 서버 설정과 옵션 - 까다로운 질문을 몇 개 가져옵니다. 정답이 분명한 짧은 발췌문, 서로 비슷한 용어가 섞인 긴 발췌문, 발췌문만으로 답할 수 없는 질문을 사용합니다. 사례마다 무엇이 유용한 결과인지 정해 둡니다. 도우미는 본문에 답이 있으면 올바른 페이지를 인용하고 근거가 없을 때는 그렇게 알려야 합니다. 파싱 오류와 앱에서 쓸 수 없는 출력은 모델 품질과 따로 기록합니다.
- 성능 설정은 한 번에 하나를 비교합니다. 대표 기기에서 같은 백엔드로 두 빌드에
llama-bench -m ./handbook-model.gguf -p 512 -n 128 -r 5를 실행해 볼 수 있습니다. 토큰 수와 다섯 번 반복은 예시입니다. 사용자가 겪는 동작을 판단하려면 앱 시작 시간, 메모리, 지연과 더 긴 실제 입력도 검사합니다. 태그에 고정된 벤치마크 옵션 - 설치된 빌드를 실행하고 되돌리는 절차를 확인합니다. 대표적인 깨끗한 설치 환경에서 후보를 사용하고, 다시 시작한 뒤 지원하는 가장 큰 작업을 반복합니다. 실행이 실패해도 기존 설정과 파일을 사용할 수 있는지, 이전 앱 버전으로 돌아갈 수 있는지 확인합니다. 더 넓은 배포를 언제 멈춰야 하는지 동료에게 보여 줄 근거를 저장합니다.
대부분의 프로젝트는 사례 몇 개를 잘 고르면 다음에 살펴볼 실패를 찾을 수 있습니다. 긴 발췌문에 대한 응답이 느려졌다면 글자가 처음 표시되기 전인지, 생성 중인지, 앱이 표시하는 과정인지부터 찾습니다. 변경 후 요청이 실패하기 시작했다면 프롬프트나 모델을 바꾸기 전에 어떤 요청 형식과 클라이언트에서 재현되는지 기록합니다. 설치 패키지에서만 실패한다면 정상 동작하는 개발 버전과 설치 파일, 실행된 프로세스를 비교합니다. 각 계층의 담당자가 재현할 만한 구체적인 조건이 생깁니다.
필요한 기기에서 같은 업그레이드를 재현할 수 있어야 한다
llama.cpp 1.0의 가치는 많은 로컬 도구가 의존하는 런타임의 변경을 더 명확하게 관리할 수 있다는 데 있습니다. 앱 팀은 빌드, 모델, 기기, 실제 사용자가 보낸 요청과 결과를 짧게 기록해 대응할 수 있습니다. 그러면 런타임과 앱을 맡은 사람이 달라져도 다음 버전은 사용자가 의지하는 작업을 시험하는 데서 시작할 수 있습니다.
출처
- ggml-org 버전 정책 및 배포 발표, 2026년 11월 13일
- llama.cpp 1.0.0 릴리스, 2026년 11월 13일
- ggml 1.0.0 릴리스
- 1.0.0 태그의 llama.cpp 공개 C 헤더
- 1.0.0 태그의 llama-server 문서
- 1.0.0 태그의 llama-bench 문서
업그레이드 결정과 테스트 메모, 모델 설정을 나중에 함께 찾으려면 Telli.sh 계정을 만들어 보세요.