La tua app di IA locale può passare a llama.cpp 1.0 senza interrompere il lavoro?
La numerazione di llama.cpp 1.0 rende visibili le modifiche incompatibili alla sua interfaccia pubblica C. Ecco come verificare la libreria, il server locale e il pacchetto prima di sostituire una versione funzionante.
Un piccolo gruppo di ingegneri porta un assistente documentale offline in un impianto dove la connessione è instabile. L’assistente riceve un paragrafo di un manuale di manutenzione e restituisce la pagina citata e una risposta breve. Sul portatile di sviluppo, la nuova build di llama.cpp si avvia e produce testo. Sul portatile usato sul campo, il programma di avvio passa ancora una vecchia opzione. Più avanti, l’applicazione si aspetta un campo della risposta che nessuno ha controllato durante la prova manuale. In tutti e tre i casi il gruppo dice di aggiornare llama.cpp, ma ciascuno dipende da un’interfaccia diversa.
Il 13 novembre 2026 ggml-org ha rilasciato llama.cpp e ggml 1.0.0. Il primo esegue modelli linguistici e mette a disposizione la libreria di inferenza libllama. Il secondo fornisce operazioni sui tensori e backend per l’hardware, con una libreria chiamata libggml. I manutentori hanno annunciato che le future incompatibilità nelle interfacce pubbliche C si rifletteranno nel numero di versione principale. La stessa versione 1.0.0 di llama.cpp ha eliminato chiamate deprecate e un’opzione da riga di comando ritirata. Annuncio sulla politica delle versioni, 13 novembre · Versione 1.0.0 di llama.cpp · Versione 1.0.0 di ggml
Prima di cambiare l’ambiente di esecuzione, individua il tipo di integrazione. Alcune applicazioni compilano e si collegano alla libreria C. Altre avviano un server HTTP locale e gli inviano richieste. Altre ancora distribuiscono l’ambiente di esecuzione in un’applicazione pronta da installare. La stessa app può rientrare in più gruppi. Per ciascun gruppo, pochi controlli mirati danno una base più solida della sola demo sul computer di sviluppo.
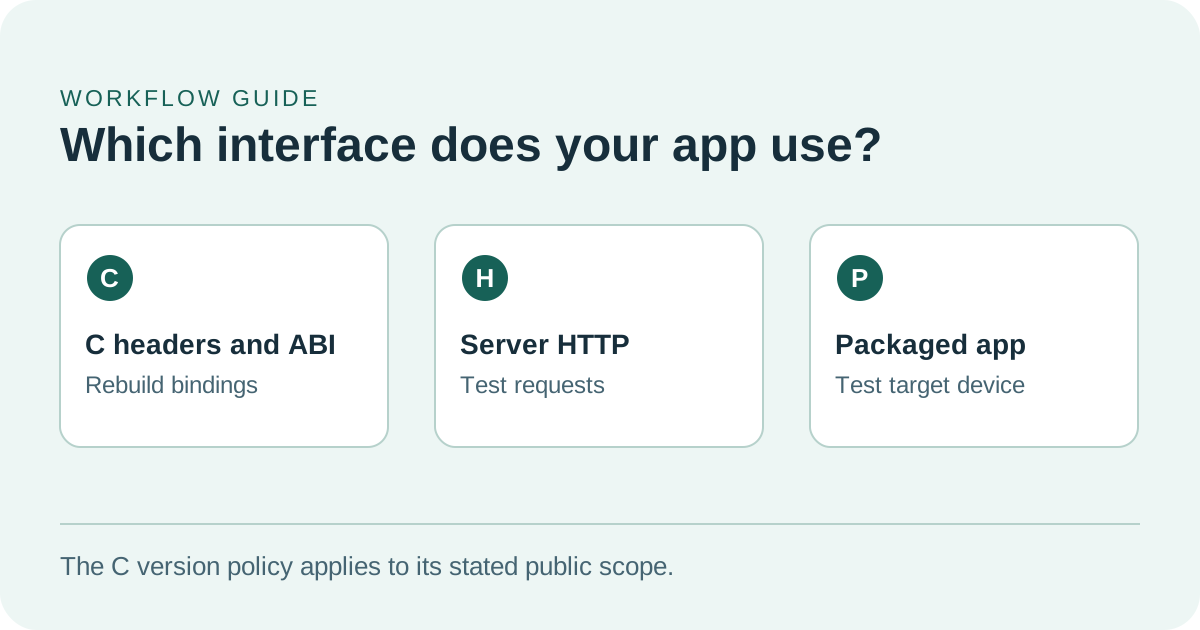
Compatibilità C, risposte HTTP e app distribuite in un pacchetto richiedono verifiche diverse.
La versione 1.0 dà un segnale più chiaro alle integrazioni native
Le intestazioni C descrivono come il codice sorgente chiama la libreria. Indicano al compilatore quali funzioni e tipi di dati sono disponibili. L’interfaccia binaria, spesso chiamata ABI, regola il modo in cui il codice e la libreria già compilati lavorano insieme. Una nuova compilazione può mettere subito in evidenza una dichiarazione rimossa. Avviare l’applicazione collegata permette di vedere che cosa succede con la libreria installata sulla macchina di destinazione. Un’app che carica le proprie dipendenze native dovrebbe fare entrambe le prove.
La politica del 13 novembre prevede un aumento della versione principale per le modifiche incompatibili all’API pubblica C nelle directory delle intestazioni. Le aggiunte compatibili, gli aggiornamenti dei backend e il supporto ai modelli rientrano nelle versioni minori. Le correzioni che lasciano invariata l’API arrivano come patch. È un segnale utile per chi distribuisce un binding nativo. Chi distribuisce un programma di avvio da riga di comando o un client HTTP deve comunque verificare le opzioni e le richieste usate dai clienti. Annuncio sulla politica delle versioni
Il tag mostra un caso concreto. Le note di llama.cpp 1.0.0 indicano la rimozione di 35 funzioni deprecate da llama.h, oltre a indicare separatamente l’eliminazione di llama_set_warmup e dei vecchi controlli di deframmentazione. Le note precisano che l’API NextN per la decodifica speculativa passa in llama.h e documentano una rinomina relativa allo stato. Parti dalle chiamate effettivamente usate. Se il compilatore segnala una funzione mancante, consulta le note di rilascio e l’intestazione pubblica corrente prima di sostituire il comportamento che dipendeva da quella chiamata. Modifiche all’API nella 1.0.0 · Intestazioni pubbliche nel tag 1.0.0
Per l’assistente dei manuali, un primo test nativo può caricare un file di modello noto, inviare una domanda con un breve estratto, leggere la risposta e chiudere correttamente il modello. Ripeti la sequenza di caricamento e chiusura nel processo dell’app che usano gli utenti. Se c’è un binding compilato a parte per un altro linguaggio, verifica che la build usi le intestazioni previste e che l’ambiente installato carichi la libreria giusta. Prima di leggere il risultato, annota l’artefatto realmente usato. Una compilazione riuscita con una copia locale dice poco sulla copia inclusa nell’app sul portatile di campo.
Metti alla prova la parte del sistema da cui dipendono gli utenti
Il progetto distribuisce anche llama-server, un processo HTTP con argomenti propri da riga di comando ed endpoint documentati. La versione 1.0.0 aggiunge l’endpoint compatibile con OpenAI /v1/audio/speech, un esempio di come il server possa evolvere insieme alla libreria C. La stessa versione ha rimosso --defrag-thold. Un servizio installato che passa quell’opzione deve migrare anche se non invoca direttamente funzioni C. Note di rilascio della 1.0.0 · Documentazione del server nel tag 1.0.0
La documentazione del server descrive un piccolo controllo da affiancare al test dell’app. Una richiesta a /health può restituire HTTP 503 durante il caricamento e restituisce 200 quando il modello è pronto. Se il gruppo usa già un client HTTP, può poi provare la propria richiesta di chat, embedding o altro tipo e verificare che interpreti la risposta. Per una funzione in streaming, includi una risposta breve che finisce regolarmente e una più lunga che l’utente interrompe dall’app. Una richiesta riuscita all’endpoint più semplice lascia ancora da verificare il pulsante di annullamento e l’analisi del testo. Controllo dello stato ed endpoint del server nella 1.0.0
| Che cosa usa l’app | Prima verifica dopo l’aggiornamento | Che cosa aggiunge il flusso reale |
|---|---|---|
| Intestazioni pubbliche C e libreria nativa | Ricompilare da zero ed eseguire con la libreria prevista | Caricare un modello, inviare una richiesta breve e liberare le risorse più volte |
| Processo server HTTP locale | Avviare con le impostazioni salvate e attendere che il modello sia pronto | Provare la richiesta effettiva, lo streaming, l’annullamento e gli stati di errore gestiti dal client |
| App desktop in un pacchetto o installer offline | Installare su una macchina rappresentativa e registrare gli artefatti | Aprire l’app con le impostazioni esistenti e usare un modello locale noto dalla versione installata |
| Uno specifico backend hardware | Controllare il backend selezionato e verificare se il modello entra in memoria | Confrontare memoria e tempi sulla configurazione più lenta che si intende supportare |
Il terzo tipo d’integrazione ha conseguenze che vanno oltre le funzioni del server. Un pacchetto Windows può richiedere una libreria vicino all’eseguibile, un modo affidabile per trovare il modello dell’utente e un messaggio comprensibile se il file manca. Sul computer di sviluppo, il backend potrebbe già essere installato a parte. Provare la nuova app in un’installazione rappresentativa fa emergere dipendenze mancanti che l’ambiente di sviluppo fornisce già. L’annuncio del 13 novembre elenca varie opzioni per la distribuzione e piattaforme con build preliminari. Usa il tag o il pacchetto esatto che intendi distribuire e registrane la provenienza. Note dei manutentori sulla distribuzione
Il numero di versione non dice quando arriverà la risposta dal manuale
Chi aspetta l’assistente offline percepisce più fasi come un’unica attesa. Il modello si carica. L’app suddivide in token la domanda e l’estratto del manuale. Il motore elabora l’input, comincia a generare testo e lo manda all’interfaccia. Con una sezione lunga del manuale, gran parte dell’attesa può dipendere dall’elaborazione dell’input. Una risposta intenzionalmente lunga può invece richiedere più tempo per generare i token. Misura separatamente l’avvio, il tempo fino al primo testo visibile e quello fino alla fine se tutti e tre contano per chi usa l’app.
La documentazione del tag 1.0.0 distingue tre modalità in llama-bench: elaborazione del prompt, generazione di testo e modalità combinata. I tempi misurati escludono la tokenizzazione e il campionamento. Per questo lo strumento aiuta a confrontare due build a parità di impostazioni e produce un valore diverso da quello vissuto nell’interfaccia. Raccogli entrambi per capire quale fase è migliorata. Documentazione del benchmark nel tag 1.0.0
Usa lo stesso file GGUF in entrambe le build. Mantieni identici il backend hardware, la configurazione del contesto e le scelte relative all’offload, quando supportate da entrambe le versioni. Salva le impostazioni effettive insieme all’hash del modello. Prova poi un input breve e uno della dimensione di un documento. Per la memoria, registra sia il picco osservabile durante la richiesta rappresentativa più lunga sia il consumo a regime dopo il caricamento. Un modello che si avvia su un portatile libero può trovare un limite diverso quando l’utente ha già aperto un browser e un lettore di documenti.
Tra i cambiamenti della versione 1.0.0 ci sono le opzioni FP8 per la cache chiave-valore usata nell’inferenza, tra cui f8_e4m3, e una cache degli esperti configurabile nella memoria del sistema per i modelli a miscela di esperti. Sono altre configurazioni da confrontare. Se backend e modello supportano un’impostazione, misurane l’effetto separatamente dalla migrazione alla 1.0. Applicala su una macchina rappresentativa, ripeti gli stessi input e verifica se le risposte soddisfano ancora i requisiti dell’app. Così sarà più semplice risalire alla causa di un cambiamento nei tempi o di una citazione mancante. Modifiche principali della versione 1.0.0
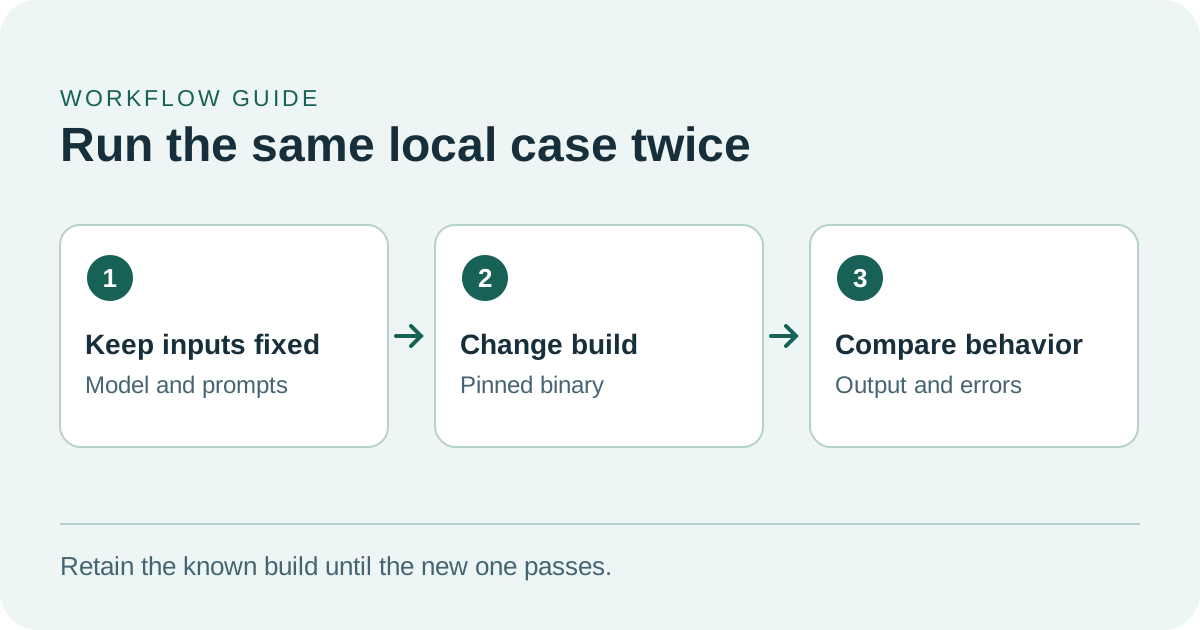
Mantieni fissi il modello e gli input per poter attribuire eventuali differenze all’aggiornamento.
Una prova di migrazione circoscritta aiuta a decidere se distribuire la nuova versione
- Scegli due build esatte. Conserva la versione distribuita e la candidata 1.0.0 in posizioni diverse. Registra le versioni di app, ambiente di esecuzione e modello, lo stesso checksum del file GGUF per ogni esecuzione e il backend hardware. Mantieni i dati e le impostazioni dell’utente quando cambi build.
- Usa il percorso di avvio abituale. Per una prova del server solo in loopback, puoi partire da
llama-server -m ./handbook-model.gguf --host 127.0.0.1 --port 9931, sostituendo il file con il modello approvato. Esegui anche il comando usato nella versione in distribuzione per trovare subito le opzioni rimosse. Verifica che il server sia pronto e usa il client che gli utenti aprono davvero. Configurazione e opzioni del server nel tag - Porta alcune domande difficili. Prova un estratto breve con una risposta chiara, uno più lungo con termini che possono confondere e una domanda a cui l’estratto non può rispondere. Per ogni caso, stabilisci che cosa rende utile il risultato. L’assistente dovrebbe citare la pagina corretta quando il testo contiene la risposta e segnalare quando mancano elementi. Registra gli errori di interpretazione della risposta e l’output inutilizzabile separatamente dalla qualità del modello.
- Confronta una sola impostazione di prestazioni per volta. Su una macchina rappresentativa, puoi iniziare con
llama-bench -m ./handbook-model.gguf -p 512 -n 128 -r 5su ciascuna build, a parità di backend. Il numero di token e le cinque ripetizioni sono esemplificativi. Per valutare l’esperienza dell’utente, aggiungi l’avvio dell’app, la memoria, la latenza e un input reale più lungo. Opzioni del benchmark nel tag - Esegui la build installata e prova il ritorno alla versione precedente. Usa la candidata in un’installazione pulita e rappresentativa, riavviala e ripeti il caso più grande supportato. Verifica che un avvio non riuscito lasci utilizzabili impostazioni e file esistenti e che sia possibile tornare alla versione precedente. Conserva le evidenze che aiuterebbero un collega a sospendere una distribuzione più ampia al momento giusto.
Alla maggior parte dei progetti bastano pochi casi ben scelti per individuare il prossimo guasto. Se un estratto lungo è diventato lento, scopri prima se la differenza compare prima del primo testo, durante la generazione o al momento di visualizzare il risultato. Se una richiesta comincia a fallire dopo la modifica, registra quale struttura e quale client causano il problema prima di cambiare il prompt o il modello. Se fallisce solo la copia distribuita, confronta l’installer e il processo avviato con quelli della copia di sviluppo funzionante. Questi primi confronti danno a chi si occupa di ciascun livello un problema concreto da riprodurre.
Un aggiornamento riuscito deve essere ripetibile sulla macchina che ne ha bisogno
Il valore di llama.cpp 1.0 sta nel rendere più chiara la gestione dei cambiamenti in un ambiente di esecuzione da cui dipendono molti strumenti locali. Chi sviluppa l’app può conservare una breve scheda di compatibilità con build, modello, macchina, richiesta effettiva dell’utente e risultato. Così, la versione successiva parte da una prova del flusso su cui contano gli utenti anche se sono cambiate le persone che mantengono l’applicazione e il motore.
Fonti
- Annuncio di ggml-org su versioni e distribuzione, 13 novembre 2026
- Versione 1.0.0 di llama.cpp, 13 novembre 2026
- Versione 1.0.0 di ggml
- Intestazioni pubbliche C di llama.cpp nel tag 1.0.0
- Documentazione di llama-server nel tag 1.0.0
- Documentazione di llama-bench nel tag 1.0.0
Per ritrovare facilmente decisioni sugli aggiornamenti, note di test e configurazioni dei modelli, crea un account su Telli.sh.