Votre application d’IA locale peut-elle passer à llama.cpp 1.0 sans perturber son fonctionnement ?
llama.cpp 1.0 rend les ruptures de compatibilité de son interface C publique visibles dans les numéros de version. Voici comment tester la bibliothèque, le serveur local et le programme d’installation avant de remplacer une version qui fonctionne.
Une petite équipe de développement déploie un assistant documentaire hors ligne sur un site mal connecté. L’assistant reçoit un paragraphe tiré d’un manuel de maintenance, puis fournit une réponse courte et le numéro de page. Sur le poste de développement, la nouvelle version de llama.cpp démarre et renvoie du texte. Sur le portable utilisé sur le terrain, une configuration de lancement enregistrée transmet encore une ancienne option. Ailleurs dans la chaîne, l’application attend un champ de réponse que le contrôle manuel n’a jamais examiné. Il s’agit bien de mettre à jour llama.cpp dans les trois cas. Chaque composant dépend toutefois d’une interface différente.
Le 13 novembre 2026, ggml-org a publié llama.cpp et ggml en version 1.0.0. Le premier exécute des modèles de langage et fournit sa bibliothèque d’inférence sous le nom de libllama. Le second fournit les opérations sur les tenseurs et les moteurs d’exécution matériels, avec une bibliothèque appelée libggml. Les responsables du projet ont annoncé que les futures incompatibilités de leurs interfaces C publiques se traduiraient par un changement de version majeure. La version 1.0.0 de llama.cpp a elle-même supprimé des appels obsolètes et une ancienne option de ligne de commande. Annonce du 13 novembre sur les règles de version · llama.cpp 1.0.0 · ggml 1.0.0
Avant de changer de moteur d’exécution, regardez à quel groupe appartient votre intégration. Certaines applications sont compilées et liées à la bibliothèque C. D’autres démarrent un serveur HTTP local et lui envoient des requêtes. D’autres encore distribuent le moteur dans une application prête à installer. Une application peut appartenir à plusieurs groupes. Pour chacun, quelques vérifications ciblées donnent de meilleurs éléments de décision qu’une démonstration réussie sur le poste de développement.
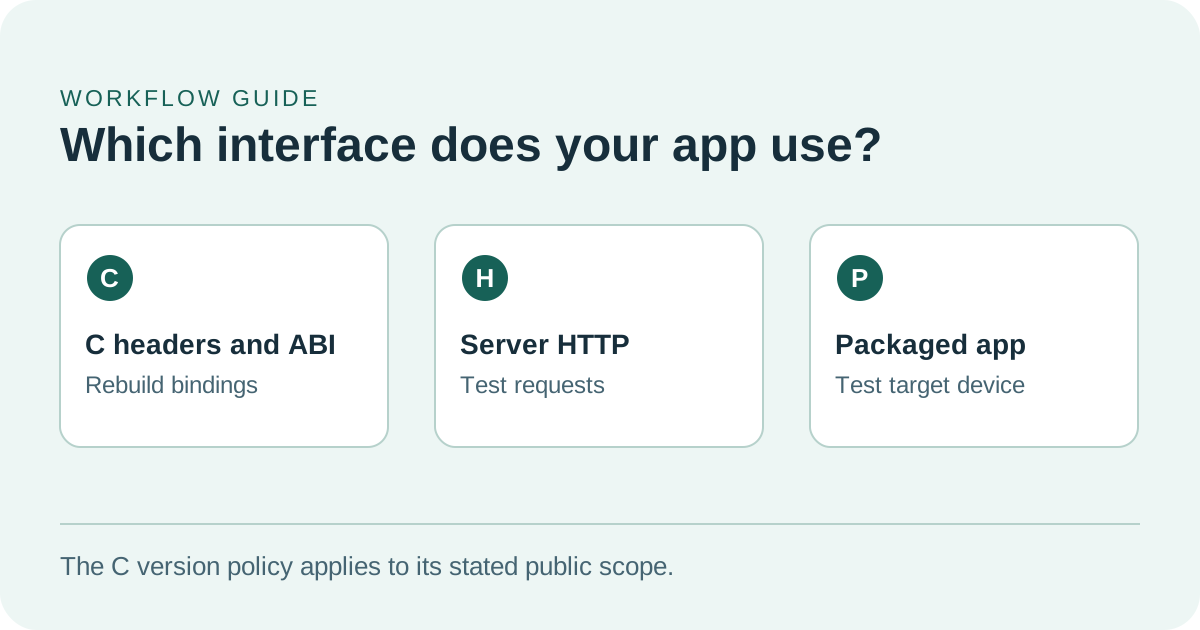
Interface C, réponses HTTP et applications installables nécessitent des vérifications différentes.
La version 1.0 donne un repère plus clair aux intégrations natives
Les fichiers d’en-tête C décrivent la manière dont le code source appelle la bibliothèque. Ils indiquent au compilateur les fonctions et les types disponibles. L’interface binaire, ou ABI, régit la façon dont le code et la bibliothèque déjà compilés fonctionnent ensemble. Une compilation complète peut révéler rapidement une déclaration supprimée. Lancer le programme après l’édition des liens permet de vérifier qu’il fonctionne avec la bibliothèque installée sur la machine cible. Si votre application charge ses propres dépendances natives, réalisez les deux vérifications.
La politique du 13 novembre prévoit une nouvelle version majeure en cas de rupture dans l’API C publique des répertoires d’inclusion du projet. Les ajouts compatibles, les mises à jour des moteurs d’exécution et la prise en charge de modèles relèvent des versions mineures. Les corrections qui ne modifient pas l’API relèvent des versions correctives. Ce repère intéresse notamment les personnes qui distribuent des liaisons natives. Celles qui livrent un lanceur en ligne de commande ou un client HTTP doivent continuer à vérifier les options et les requêtes dont dépendent leurs utilisateurs. Annonce sur les règles de version
Les changements de la version taguée en donnent un exemple. Les notes de llama.cpp 1.0.0 indiquent la suppression de 35 fonctions obsolètes dans llama.h. Elles mentionnent séparément la suppression de llama_set_warmup et des anciens réglages de défragmentation. Elles annoncent aussi le déplacement de l’API NextN de décodage spéculatif vers llama.h et le renommage d’une fonction liée à l’état. Commencez par les appels que vous utilisez. Si le compilateur signale une fonction manquante, consultez les notes et l’en-tête public actuel avant de décider comment remplacer le comportement qui faisait appel à cette fonction. Modifications de l’API en 1.0.0 · En-têtes publics au tag 1.0.0
Pour l’assistant hors ligne, un test de base de la couche native peut charger un fichier de modèle connu, envoyer une question et un court extrait, lire la réponse générée et fermer proprement le modèle. Répétez le chargement et la fermeture dans le processus de l’application tel qu’il s’exécute chez les utilisateurs. Si une liaison pour un autre langage est compilée séparément, vérifiez que sa compilation trouve les bons en-têtes et que l’application installée charge la bibliothèque attendue. Notez l’artefact utilisé avant d’examiner le résultat. Une compilation réussie avec une copie locale dit peu de chose sur la copie distribuée à côté de l’application sur le portable de terrain.
Testez la couche dont vos utilisateurs dépendent
Le projet distribue aussi llama-server, un processus HTTP doté de ses propres arguments de ligne de commande et de points d’accès documentés. La version 1.0.0 ajoute le point d’accès /v1/audio/speech, compatible avec OpenAI. C’est un exemple de fonction du serveur qui évolue en parallèle de la bibliothèque C. La même version supprime --defrag-thold. Un service intégré qui transmet cette option doit être adapté, même s’il n’appelle directement aucune fonction C. Notes de la version 1.0.0 · Documentation du serveur au tag 1.0.0
La documentation fournit une vérification simple à ajouter au test de l’application. Une requête à /health peut renvoyer le code HTTP 503 pendant le chargement du modèle et 200 une fois celui-ci chargé. Avec votre client HTTP, vérifiez ensuite la requête de chat, d’embedding ou autre que vous utilisez réellement et assurez-vous que le client interprète la réponse. Si votre application utilise des réponses en flux, essayez une réponse courte qui se termine normalement et une plus longue que vous annulez depuis l’interface. Une requête au point d’accès le plus simple ne vérifie ni le bouton d’annulation ni l’analyse du texte. Documentation sur l’état du serveur et les points d’accès de la version 1.0.0
| Ce qu’utilise l’application | Premier contrôle après la mise à jour | Ce qu’ajoute un scénario réel |
|---|---|---|
| En-têtes C publics et bibliothèque native | Recompiler proprement et exécuter avec la bibliothèque prévue | Charger le modèle à plusieurs reprises, envoyer une courte requête et libérer les ressources |
| Processus serveur HTTP local | Démarrer avec les réglages enregistrés et attendre que le modèle soit prêt | Vérifier les requêtes, les réponses en flux, l’annulation et les états d’erreur réellement pris en charge |
| Application de bureau ou programme d’installation hors ligne | Installer sur une machine représentative et noter les artefacts | Ouvrir l’application installée avec les réglages existants et utiliser un modèle local connu |
| Moteur d’exécution pour un matériel particulier | Contrôler le moteur sélectionné et vérifier si le modèle tient en mémoire | Comparer la mémoire et les temps d’exécution sur la configuration prise en charge la plus lente |
La troisième intégration a des conséquences qui dépassent la liste des fonctions du serveur. Un paquet Windows peut avoir besoin d’une bibliothèque à côté de l’exécutable et d’un moyen fiable de retrouver le modèle utilisé par l’application. Si ce fichier manque, le message doit être clair. Le poste de développement dispose peut-être déjà d’un moteur installé séparément. Un essai sur une installation représentative des utilisateurs révèle les dépendances que l’environnement de développement fournit déjà. L’annonce du 13 novembre cite plusieurs canaux de distribution et plateformes qui reçoivent des versions de prépublication. Utilisez exactement le tag ou le paquet que votre équipe prévoit de livrer et notez sa provenance. Informations sur la distribution fournies par les responsables du projet
Le numéro de version ne dit pas combien de temps prendra une réponse
Pour l’utilisateur d’un assistant hors ligne, plusieurs délais se succèdent. Le modèle se charge. L’application découpe la question et l’extrait en jetons. Le moteur traite le prompt, génère le texte et le transmet à l’interface. Un long passage de manuel peut entraîner une attente dominée par le traitement du prompt. Une réponse volontairement détaillée peut au contraire allonger surtout la génération. Mesurez séparément le démarrage, le temps avant le premier texte visible et le temps avant la réponse complète si ces étapes comptent pour vos utilisateurs.
La documentation du tag 1.0.0 distingue trois modes dans llama-bench: traitement du prompt, génération de texte et mode combiné. Les temps indiqués excluent la segmentation en jetons et l’échantillonnage. L’outil aide ainsi à comparer deux versions du moteur exécutées avec les mêmes réglages. Ce résultat diffère du temps d’attente mesuré dans l’interface. Notez les deux valeurs pour savoir quelle étape a progressé. Documentation des mesures au tag 1.0.0
Utilisez le même fichier de modèle GGUF pour les deux versions. Gardez le même moteur, les mêmes réglages de contexte et les mêmes choix de déport de calcul lorsqu’ils sont disponibles des deux côtés. Enregistrez la configuration réelle avec le hash du modèle. Essayez ensuite une entrée courte et une entrée de la taille d’un document. Lorsque vous mesurez la mémoire, relevez le pic observable pendant la requête représentative la plus longue et l’utilisation habituelle après chargement. Un modèle qui se lance sur un portable sans autre activité peut atteindre une limite différente lorsque l’utilisateur a déjà ouvert un navigateur et un lecteur de documents.
La version 1.0.0 répertorie des options FP8 pour le cache de clés et de valeurs utilisé à l’inférence, dont f8_e4m3, ainsi qu’un cache réglable en mémoire hôte pour les experts des modèles de type Mixture of Experts. Ces possibilités multiplient les comparaisons. Si le moteur et le modèle acceptent un réglage, mesurez son effet indépendamment du passage à 1.0. Appliquez-le sur une seule machine représentative, relancez les mêmes entrées et vérifiez que les réponses satisfont toujours aux exigences de l’application. Vous pourrez ainsi examiner un changement de durée ou une citation manquante sans avoir à deviner quelle modification l’a provoqué. Changements du moteur dans la version 1.0.0
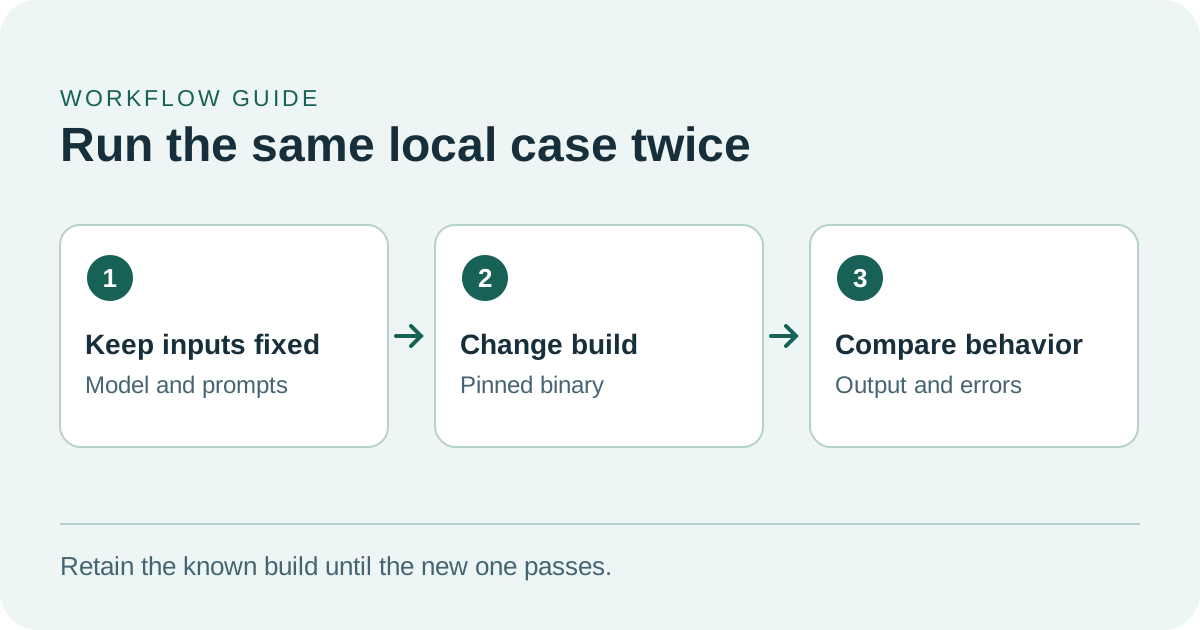
Gardez le modèle et les entrées fixes pour attribuer d’éventuelles différences à la mise à jour.
Une courte répétition facilite la décision de déploiement
- Choisissez deux versions précises. Conservez la version distribuée et la candidate 1.0.0 dans des emplacements distincts. Notez les versions de l’application, du moteur et du modèle, la même somme de contrôle GGUF pour chaque passage et le moteur matériel. Préservez les données et réglages des utilisateurs en changeant de version.
- Suivez le parcours de lancement habituel. Pour un essai du serveur limité à la boucle locale, partez de
llama-server -m ./handbook-model.gguf --host 127.0.0.1 --port 9931en indiquant votre fichier de modèle approuvé. Relancez aussi la commande de la version distribuée pour repérer rapidement les options retirées. Vérifiez l’état du modèle, puis ouvrez le client dont les utilisateurs se servent. Installation et options du serveur au tag 1.0.0 - Apportez quelques questions difficiles. Testez un extrait bref qui contient une réponse claire, un passage plus long comportant des termes proches et une question à laquelle le texte ne répond pas. Définissez ce qui constitue un résultat utile pour chaque cas. L’assistant doit citer la bonne page lorsque la réponse figure dans le texte et signaler l’absence de preuve le cas échéant. Notez les erreurs d’analyse et les réponses inutilisables séparément de la qualité du modèle.
- Comparez un seul réglage de performance à la fois. Sur une machine représentative, partez de
llama-bench -m ./handbook-model.gguf -p 512 -n 128 -r 5pour chacune des versions avec le même moteur. Les nombres de jetons et les cinq répétitions servent d’exemple. Ajoutez le démarrage, la mémoire et la latence de l’application ainsi qu’une entrée réelle plus longue pour juger l’expérience utilisateur. Options de mesure au tag 1.0.0 - Testez la version installée et le retour en arrière. Utilisez la candidate sur une installation propre et représentative, redémarrez-la et répétez le plus gros cas pris en charge. Vérifiez qu’un échec de lancement laisse les réglages et fichiers existants utilisables et que vous pouvez revenir à la version précédente. Conservez les éléments qui aideront un collègue à savoir quand suspendre un déploiement plus large.
Quelques cas bien choisis suffisent généralement à trouver la prochaine panne. Si un passage long est devenu lent, cherchez d’abord si le ralentissement survient avant le premier texte, pendant la génération ou dans l’affichage. Si une requête échoue après le changement, notez le format de requête et le client en cause avant de modifier le prompt ou le modèle. Si seul le paquet installé échoue, comparez son programme d’installation et le processus lancé avec la copie qui fonctionne en développement. Chaque responsable dispose alors d’un cas concret à reproduire.
Une mise à jour réussie doit pouvoir se répéter sur la machine qui en a besoin
llama.cpp 1.0 donne un cadre plus clair pour gérer les évolutions d’un moteur dont dépendent de nombreux outils locaux. Une équipe peut tenir une courte fiche de compatibilité mentionnant la version compilée, le modèle, la machine, la requête utilisée en pratique et son résultat. La prochaine version commence alors par un test du parcours attendu par les utilisateurs, même si les personnes qui maintiennent le moteur et l’application ont changé.
Sources
- Annonce de ggml-org sur les versions et la distribution, 13 novembre 2026
- llama.cpp 1.0.0, 13 novembre 2026
- ggml 1.0.0
- En-têtes C publics de llama.cpp au tag 1.0.0
- Documentation de llama-server au tag 1.0.0
- Documentation de llama-bench au tag 1.0.0
Pour retrouver facilement vos décisions de mise à jour, vos notes de test et les configurations des modèles, créez un compte Telli.sh.