¿Puedes actualizar tu app de IA local a llama.cpp 1.0 sin romper su flujo de trabajo?
La numeración de llama.cpp 1.0 hace visibles los cambios incompatibles en su interfaz pública de C. Así puedes probar la biblioteca, el servidor local y la aplicación empaquetada antes de sustituir una versión que funciona.
Un pequeño equipo de ingeniería lleva un asistente documental sin conexión a una instalación donde la conectividad es deficiente. El asistente recibe un párrafo de un manual de mantenimiento y devuelve la página citada y una respuesta breve. En el portátil de desarrollo, la nueva compilación de llama.cpp arranca y devuelve texto. En el portátil de campo, el lanzador guardado sigue pasando una opción antigua. Un poco más adelante, la aplicación espera un campo de respuesta que nadie revisó durante la prueba manual. En los tres casos el equipo habla de actualizar llama.cpp, pero cada uno depende de una interfaz distinta.
El 13 de noviembre de 2026, ggml-org publicó las versiones 1.0.0 de llama.cpp y ggml. El primero ejecuta modelos de lenguaje y expone su biblioteca de inferencia como libllama. El segundo proporciona operaciones con tensores y motores para distintos tipos de hardware, con una biblioteca llamada libggml. Los responsables anunciaron que las futuras incompatibilidades en sus interfaces públicas de C quedarán reflejadas en los números de versión mayor. La propia versión 1.0.0 de llama.cpp eliminó llamadas obsoletas y una opción retirada de la línea de comandos. Anuncio de los responsables sobre la política de versiones, 13 de noviembre · Versión 1.0.0 de llama.cpp · Versión 1.0.0 de ggml
Antes de cambiar el entorno de ejecución, identifica qué tipo de integración tienes. Algunas aplicaciones se compilan y enlazan con la biblioteca de C. Otras inician un servidor HTTP local y le envían peticiones. Un tercer grupo distribuye el entorno de ejecución como parte de una aplicación lista para instalar. Una misma app puede pertenecer a varios grupos. Cada grupo puede hacer unas cuantas comprobaciones que permitan decidir con más fundamento que una demostración en el ordenador de desarrollo.
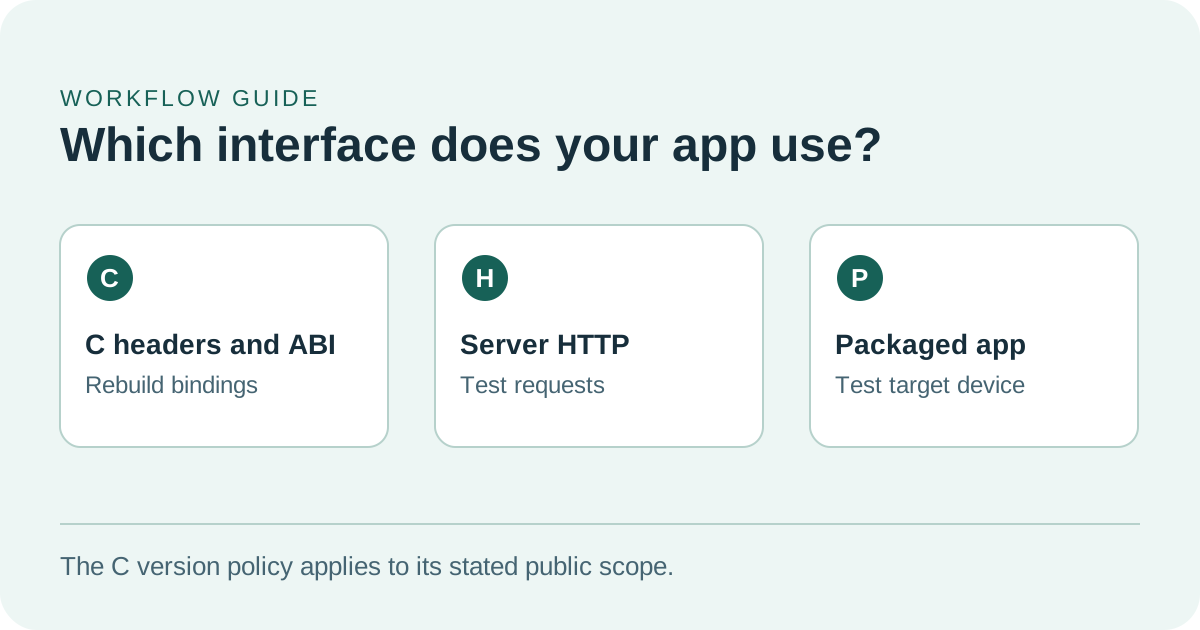
La compatibilidad en C, las respuestas HTTP y las aplicaciones empaquetadas requieren comprobaciones diferentes.
La versión 1.0 da una señal más clara a las integraciones nativas
Las cabeceras de C describen cómo llama el código fuente a la biblioteca. Indican al compilador qué funciones y tipos de datos tiene disponibles. La interfaz binaria, o ABI, determina cómo encajan el código compilado y la biblioteca compilada. Una compilación limpia puede detectar pronto una declaración eliminada. Arrancar la aplicación enlazada permite comprobar qué ocurre con la biblioteca instalada en la máquina de destino. Si la aplicación carga sus propias dependencias nativas, conviene hacer ambas pruebas.
En la política del 13 de noviembre, los responsables explican que los cambios incompatibles en la API pública de C de los directorios de cabeceras aumentan la versión mayor. Las ampliaciones compatibles, las actualizaciones de los motores de hardware y la compatibilidad con nuevos modelos se publican como versiones menores. Las correcciones que mantienen la API se publican como parches. Esta señal ayuda a quien mantiene un enlace nativo. Si distribuyes un lanzador de línea de comandos o un cliente HTTP, también conviene comprobar las opciones y peticiones que tus usuarios ya utilizan. Anuncio de la política de versiones
Los cambios de la etiqueta ofrecen un ejemplo concreto. Las notas de llama.cpp 1.0.0 enumeran 35 funciones obsoletas eliminadas de llama.h. También citan por separado la retirada de llama_set_warmup y de los controles de desfragmentación. Indican que la API NextN de decodificación especulativa pasa a llama.h y documentan un cambio de nombre relacionado con el estado. Empieza por las llamadas que utilizas. Si el compilador detecta que falta una función, consulta las notas y la cabecera pública actual antes de sustituir el comportamiento que dependía de ella. Cambios en la API 1.0.0 · Cabeceras públicas en la etiqueta 1.0.0
Para el asistente de manuales, una prueba nativa rápida puede cargar un modelo conocido, enviar una pregunta y un fragmento breve, leer la respuesta y cerrar el modelo correctamente. Repite la secuencia de carga y cierre en el proceso de la aplicación que ejecutan los usuarios. Si hay un enlace compilado por separado para otro lenguaje, comprueba que la compilación encuentre las cabeceras previstas y que el entorno instalado cargue la biblioteca esperada. Registra el artefacto utilizado antes de leer el resultado. Compilar bien con una copia local apenas aporta información sobre la otra copia incluida en el portátil de campo.
Prueba la parte del sistema de la que dependen tus usuarios
El proyecto también publica llama-server, un proceso HTTP con sus propios argumentos de línea de comandos y endpoints documentados. La versión 1.0.0 añade el endpoint compatible con OpenAI /v1/audio/speech. Es un ejemplo de función del servidor que puede evolucionar junto con la biblioteca de C. Esa misma versión retiró --defrag-thold. Un servicio instalado que pasa esa opción tiene que migrar incluso si nunca llama directamente a funciones de C. Notas de la versión 1.0.0 · Documentación del servidor en la etiqueta 1.0.0
La documentación del servidor propone una comprobación breve que puedes añadir a la prueba de la aplicación. Una petición a /health puede devolver HTTP 503 durante la carga y devuelve 200 cuando el modelo está cargado. Si el equipo ya trabaja con un cliente HTTP, puede probar entonces su propia petición de chat, embeddings u otro tipo y comprobar que interpreta correctamente la respuesta. Para una función de transmisión, prueba una respuesta corta que termine y otra más larga que el usuario cancele desde la app. Una petición al endpoint más sencillo deja sin comprobar el botón de cancelar y el analizador de texto. Estado y endpoints del servidor en v1.0.0
| Qué usa la aplicación | Primera comprobación tras actualizar | Qué añade un flujo real |
|---|---|---|
| Cabeceras públicas de C y biblioteca nativa | Compilar desde cero y ejecutar con la biblioteca prevista | Cargar un modelo, hacer una petición breve y liberar sus recursos varias veces |
| Un proceso de servidor HTTP local | Arrancar con la configuración guardada y esperar a que el modelo esté listo | Probar la petición real, la transmisión, la cancelación y los estados de error que admite el cliente |
| Una app de escritorio empaquetada o un instalador sin conexión | Instalar en una máquina representativa y registrar los artefactos | Abrir la app con la configuración existente y usar un modelo local conocido desde la versión instalada |
| Un motor para hardware concreto | Comprobar qué motor se eligió y si el modelo cabe en memoria | Comparar memoria y tiempos en la configuración más lenta que el equipo se compromete a admitir |
La tercera integración tiene consecuencias más allá de las funciones del servidor. Por ejemplo, un paquete para Windows puede necesitar una biblioteca junto al ejecutable, una forma fiable de localizar el modelo existente del usuario y un mensaje inteligible cuando falta el archivo. Es posible que el equipo de desarrollo ya tenga un motor instalado por separado. Probar la aplicación nueva en una instalación representativa detecta dependencias ausentes que el entorno de desarrollo ya aporta. El anuncio del 13 de noviembre enumera varias vías de distribución y plataformas de versiones preliminares. Usa la etiqueta o compilación exacta que piensas distribuir y registra su procedencia. Notas de distribución de los responsables
El número de versión no dice cuándo llegará la respuesta del manual
Quien espera a un asistente sin conexión percibe varias fases como una sola demora. Se carga el modelo. La aplicación tokeniza la pregunta y el fragmento. El entorno procesa la entrada, empieza a generar texto y lo envía a la interfaz. Con una sección larga del manual, buena parte de la espera puede corresponder al procesamiento de la entrada. Una respuesta deliberadamente larga puede dedicar más tiempo a generar tokens. Si las tres medidas importan, registra por separado el arranque, la espera hasta el primer texto visible y el tiempo total.
La documentación de la etiqueta 1.0.0 distingue tres modos en llama-bench: procesamiento de la entrada, generación de texto y un modo combinado. Los tiempos publicados por la herramienta excluyen la tokenización y el muestreo. Esto permite comparar dos compilaciones en condiciones iguales y explica por qué el resultado difiere del tiempo que muestra la interfaz. Registra las dos medidas para saber qué fase ha mejorado. Documentación de la prueba de rendimiento en la etiqueta 1.0.0
Empieza con el mismo archivo GGUF en las dos versiones. Mantén el mismo motor de hardware, los mismos ajustes de contexto y la misma distribución de trabajo entre procesadores siempre que ambas versiones lo permitan. Guarda los ajustes efectivos junto con el hash del modelo. Prueba una entrada corta y otra del tamaño del documento. Al medir memoria, anota el pico durante la petición representativa más larga y el consumo estable tras la carga. Un modelo que arranca en un portátil sin otras tareas puede encontrar un límite distinto cuando ya hay un navegador y un lector de documentos abiertos.
La versión 1.0.0 enumera opciones FP8 para la caché de claves y valores usada durante la inferencia, incluida f8_e4m3. También incorpora una caché de expertos configurable en memoria del sistema para modelos de mezcla de expertos. Hay más configuraciones que comparar. Cuando el motor y el modelo admitan un ajuste, mide su efecto por separado de la migración a 1.0. Aplícalo en una máquina representativa, repite las mismas entradas y comprueba si las respuestas siguen cumpliendo los requisitos. Así se puede investigar un cambio de tiempo o una cita ausente con una causa más fácil de aislar. Cambios del núcleo en la versión 1.0.0
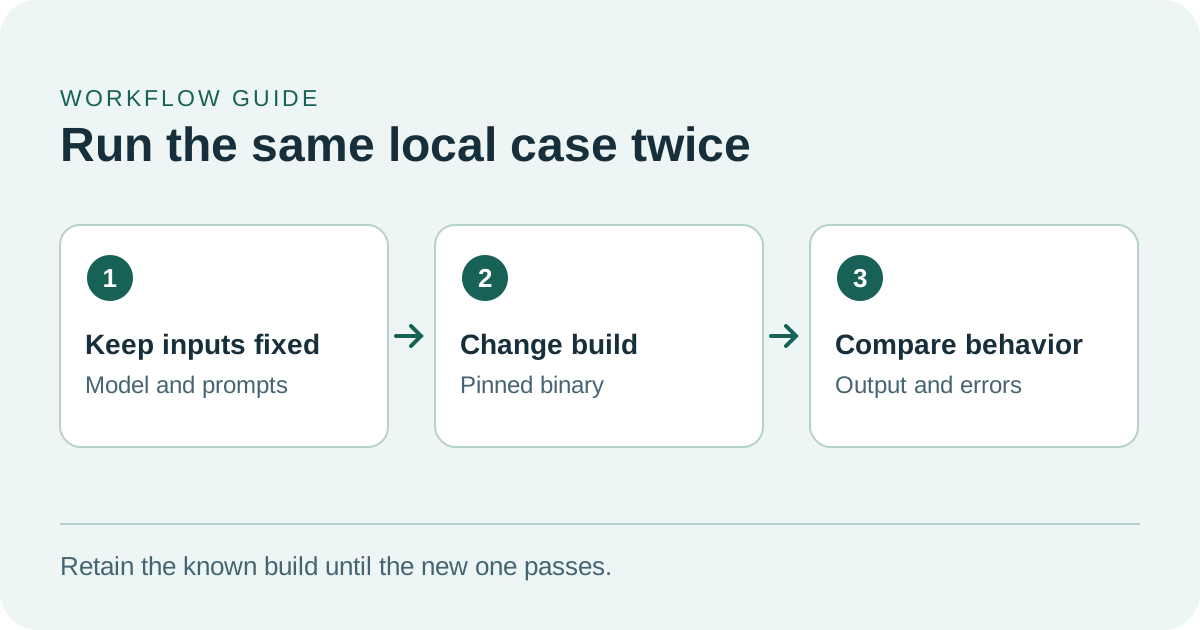
Mantén fijos el modelo y las entradas para poder atribuir cualquier diferencia a la actualización.
Un ensayo breve de la migración ayuda a decidir si distribuirla
- Elige dos compilaciones exactas. Conserva en ubicaciones distintas la versión que distribuyes y la candidata 1.0.0. Registra las versiones de la app, el entorno de ejecución y el modelo, la misma suma de comprobación GGUF en cada ejecución y el motor de hardware. Preserva los datos del usuario y la configuración al cambiar de versión.
- Usa el arranque habitual. Para probar el servidor solo en la interfaz local, puedes empezar con
llama-server -m ./handbook-model.gguf --host 127.0.0.1 --port 9931después de indicar el archivo del modelo aprobado. Ejecuta también el comando actual de distribución para detectar pronto opciones retiradas. Comprueba que el servidor está listo y usa el cliente que realmente abren los usuarios. Configuración y opciones del servidor en la etiqueta - Prepara algunas preguntas difíciles. Prueba un fragmento corto con una respuesta clara, otro más largo con términos que compiten y una pregunta que el fragmento no pueda resolver. Define de antemano un resultado útil para cada caso. El asistente debe citar la página correcta si el texto contiene la respuesta e indicar cuándo falta evidencia. Registra los errores de análisis y la salida inutilizable por separado de la calidad del modelo.
- Compara un ajuste de rendimiento cada vez. En una máquina representativa, un punto de partida es ejecutar
llama-bench -m ./handbook-model.gguf -p 512 -n 128 -r 5con cada compilación y motores equivalentes. Esas cantidades de tokens y las cinco repeticiones son un ejemplo. Incluye el arranque de la app, el consumo de memoria, la latencia y una entrada real más larga para estimar la experiencia de uso. Opciones de rendimiento en la etiqueta - Ejecuta la versión instalada y ensaya el regreso. Usa la candidata en una instalación limpia y representativa, reiníciala y repite el caso más grande que admite. Comprueba que un fallo de arranque deja utilizables la configuración y los archivos existentes, y que se puede recuperar la versión anterior. Guarda la evidencia que ayudaría a otra persona a decidir cuándo detener una distribución más amplia.
La mayoría de los proyectos solo necesitan unos pocos casos de prueba bien elegidos para encontrar el siguiente fallo. Si un fragmento largo se vuelve lento, identifica primero si la diferencia aparece antes del primer texto, durante la generación o al mostrarlo. Si una petición empieza a fallar después del cambio, registra qué forma de petición y qué cliente lo provocan antes de modificar la entrada o el modelo. Si falla únicamente la copia empaquetada, compara su instalador y proceso con los de la copia de desarrollo que sí funciona. Estas primeras comprobaciones dan a la persona responsable de cada capa un problema concreto que reproducir.
Una actualización que funciona se puede repetir en la máquina que la necesita
El valor de llama.cpp 1.0 es que aclara cómo gestionar los cambios en un entorno de ejecución del que dependen muchas herramientas locales. El equipo de una aplicación puede aprovecharlo y conservar un registro breve de compatibilidad con la compilación, el modelo, la máquina, la petición real del usuario y el resultado. Así, la siguiente actualización empieza por una prueba del flujo habitual aunque hayan cambiado quienes mantienen el motor y la aplicación.
Fuentes
- Anuncio de ggml-org sobre la política de versiones y la distribución, 13 de noviembre de 2026
- Versión 1.0.0 de llama.cpp, 13 de noviembre de 2026
- Versión 1.0.0 de ggml
- Cabeceras públicas de C de llama.cpp en la etiqueta 1.0.0
- Documentación de llama-server en la etiqueta 1.0.0
- Documentación de llama-bench en la etiqueta 1.0.0
Para consultar más adelante tus decisiones de actualización, notas de prueba y configuraciones de modelos, crea una cuenta en Telli.sh.