내 컴퓨터 한 대로 자막과 내레이션을 만들 수 있을까?
llama.cpp 0.9.0에 음성 기능 세 가지가 추가됐습니다. 지금 쓰는 컴퓨터에서 오프라인 전사, 화자 구분, 기본 음성 내레이션을 시험하는 방법을 살펴봅니다.
제품 시연 영상의 초벌 편집본, 영상 위로 동료 두 명이 나눈 대화 녹음, 다시 녹음할 내레이션 세 줄이 있습니다. 녹음은 전사 서비스에, 대본은 음성 합성 서비스에 보내는 방식이 익숙합니다. 편집용 컴퓨터에서 두 작업을 처리할 수 있으면 반복 수정이 쉬워질 수 있습니다. 원본을 그 컴퓨터에만 보관해야 할 때는 특히 유용합니다. 그만큼 작업 대기열과 모델 파일, 품질 검사는 편집자가 관리합니다.
오픈소스 추론 프로젝트 llama.cpp는 2026년 11월 4일 0.9.0을 출시했습니다. NVIDIA Nemotron 3.5 Transcribe를 이용한 오프라인 전사, Chatterbox를 이용한 음성 합성, 참조 녹음 없이 쓸 수 있는 Pocket TTS 기본 음성을 추가했습니다. 릴리스 노트는 40개 언어 전사와 프롬프트로 문맥을 제공하는 기능, 화자 구분을 설명합니다. 세 기능을 한 편집 과정에 써 볼 수 있고, 기능마다 컴퓨터와 검토자가 맡는 일이 다릅니다. llama.cpp v0.9.0 릴리스 노트
로컬 챗봇을 돌리다가 llama.cpp를 접했다면 이번 업데이트도 챗봇 도구로만 생각하기 쉽습니다. llama.cpp는 지원하는 모델 아키텍처를 실행하고, 호환 모델 파일을 불러오고, 요청을 처리하는 추론 런타임입니다. 이번 업데이트로 같은 도구에서 실행할 수 있는 작업이 늘어납니다. 오디오를 어디에 저장하고, 수정 내용을 어떻게 보여주고, 언제 파일을 공개할 수 있는지는 주변 애플리케이션이 결정합니다. llama.cpp 프로젝트
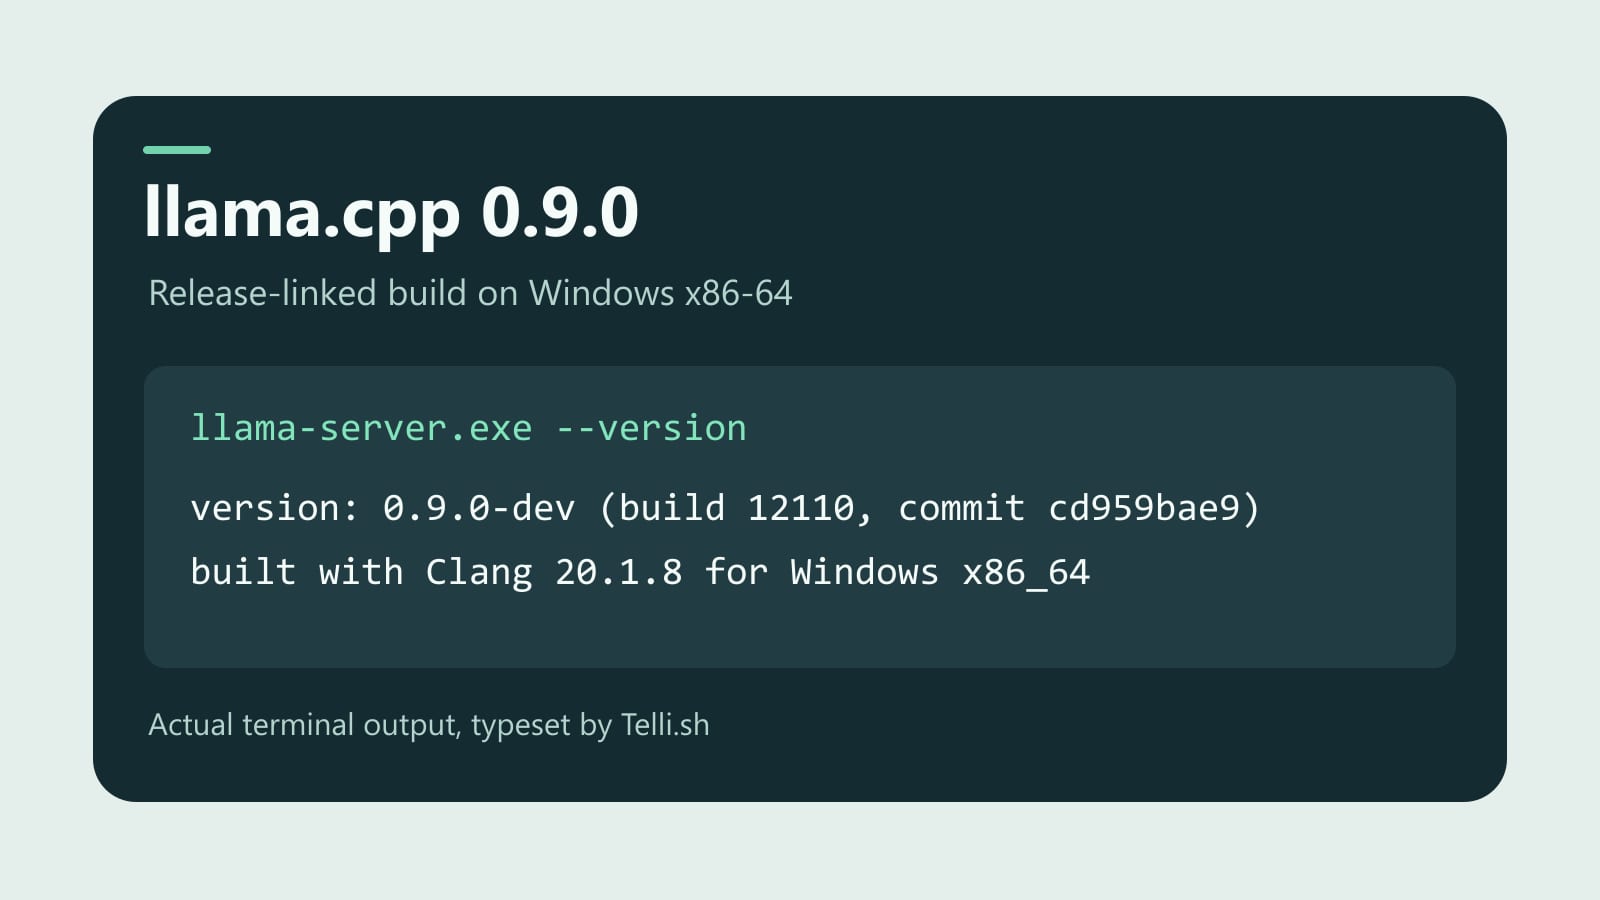
Telli.sh는 릴리스에 연결된 공식 Windows 빌드를 실행하고 실제 버전 출력을 이미지로 옮겼습니다. 빌드 식별자를 확인한 결과입니다. 릴리스에 연결된 b12110 빌드
자막은 수정 가능한 전사문에서 시작합니다
동료가 미출시 제품을 10분간 설명하는 영상을 찍었다고 합시다. 설명 도중 다른 동료가 기능 이름을 바로잡습니다. 나중에 검색할 수 있는 전사문, 누가 어떤 말을 했는지 대략 구분한 기록, 화면에 제때 나오는 자막이 필요합니다. 전사문은 텍스트 결과물이고, 화자 구분은 편집용 표시이며, 자막에는 시간 정보가 필요합니다.
Nemotron 통합은 앞의 두 결과물을 만드는 데 도움이 됩니다. 병합된 구현은 오프라인 전사와 선택적 문맥 제공, 화자 구분을 지원합니다. 한 녹음의 처리 구간이 바뀌어도 화자 정보를 이어갈 수 있습니다. 유지보수 담당자가 남긴 변경 노트에 따르면 단어별 타임스탬프와 스트리밍은 이번 통합 범위 밖입니다. 완성된 녹음을 전사하고 텍스트를 고친 뒤, 최종 결과물에 필요하면 별도 편집이나 자막 단계에서 시간을 맞추는 것이 실제 작업 순서입니다. Nemotron 3.5 Transcribe 통합
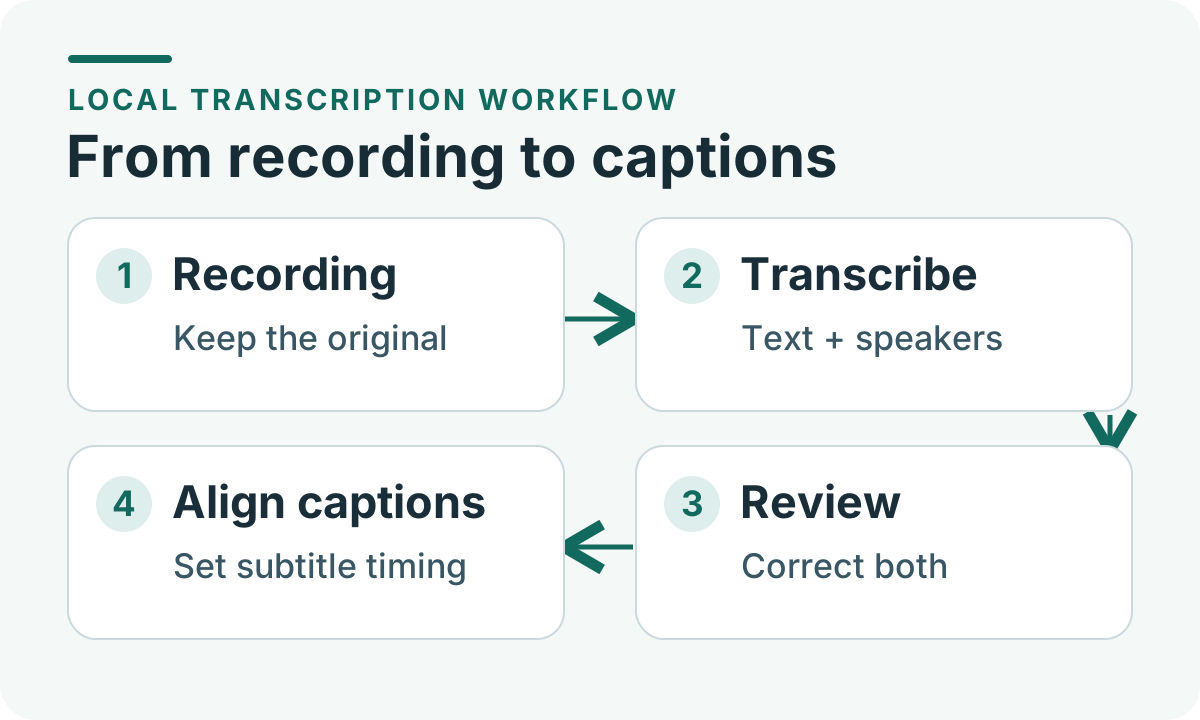
Telli.sh 자체 제작. 로컬 전사문을 수정하고 화자 표기까지 확인한 뒤 자막 시간을 맞춥니다.
프롬프트 문맥은 일상 대화에서 잘 나오지 않는 용어를 쓰는 팀에 특히 흥미롭습니다. 가상의 기능 Pine Relay가 나오는 녹음에 예상되는 이름과 약어 몇 개를 입력한 뒤, 같은 녹음을 목록 없이 다시 돌려 보세요. 문맥이 기능 이름을 바로잡았는지, 아무도 말하지 않은 곳에 그 이름을 끼워 넣었는지, 숫자나 관련 없는 단어를 바꿨는지 세어 봅니다. 어떤 항목이 결과에 영향을 줬는지 설명할 수 있을 만큼 목록을 좁힙니다. 좋은 전사 도구는 낯선 단어를 확인하기 쉽게 하면서도 용어 목록에 맞춰 녹음 내용을 바꾸지 않습니다.
화자 구분은 따로 확인할 가치가 있습니다. 소리가 깨끗한 인터뷰에서는 두 사람을 구분하기 쉬울 수 있습니다. 스피커폰으로 세 번째 사람이 참여하고 여러 문장이 겹치면 수정할 일이 달라집니다. 각 사람의 가장 긴 발언과 더불어 화자가 바뀌는 구간도 들으세요. 단어가 모두 정확해도 중요한 결정을 엉뚱한 사람이 한 것으로 남길 수 있습니다. 녹음을 아는 사람이 확인할 때까지 모델의 화자 표기와 사람이 붙인 이름을 구분합니다.
자막은 내보낸 파일을 영상과 함께 다시 읽으세요. 문서에서는 괜찮아 보이는 문장이 화면 밖으로 넘어가거나, 중요한 장면이 나오기 전에 표시되거나, 다음 사람이 말하기 시작해도 남을 수 있습니다. 영상 앞부분의 장면 전환과 짧게 말이 끊기는 구간을 시험하세요. 정확한 시간 정보가 있는 자막 파일이 필요하다면 시간 맞춤과 수정 단계를 작업 시간에 포함합니다. 최종 편집을 다른 곳에서 하더라도 정확한 첫 전사문은 쓸모가 있습니다.
처음에는 기본 음성으로 시험해 보기 좋습니다
이번에는 초벌 영상의 다른 쪽을 살펴봅시다. 기능 제목이 바뀌어 화면 녹화 여섯 편에서 내레이션 한 줄씩을 교체해야 합니다. 모델과 컴퓨터를 준비한 뒤에는 새 음성을 로컬에서 만들며 적은 비용으로 시험할 수 있습니다. 어려운 부분은 음성의 일관성과 발음입니다. 새 오디오가 앞뒤 영상과 자연스럽게 이어지고, 제품명을 정확히 읽고, 장면 길이에 맞아야 합니다.
0.9.0에서 llama.cpp가 지원하는 음성 합성 모델에 Chatterbox가 추가됐습니다. 프로젝트 검토 기록에는 Chatterbox Turbo와 Multilingual V3를 CUDA에서 실행한 결과가 있습니다. 검토자는 기본 음성과 참조 음성을 쓰는 생성을 시험하고 샘플을 첨부했습니다. 특정 환경에서 통합을 검증한 기록입니다. 실제 제작에서는 사용하려는 대본과 컴퓨터에서 목소리와 언어가 일관되게 유지되는지 확인해야 합니다. Chatterbox 지원과 유지보수 담당자의 오디오 예시
Pocket TTS는 다른 선택지를 제공합니다. 호환 모델은 기본 음성 이름을 voices 항목에 담아 제공할 수 있습니다. 이 항목은 서버의 GET /props 응답에 들어갑니다. 클라이언트는 목록의 이름을 음성 합성 경로에 전달할 수 있습니다. 스크립트나 작은 앱에서 로드한 모델을 바탕으로 음성 선택 목록을 만들 수 있습니다. 첫 시험에서 기본 음성을 쓰면 다른 사람의 음성을 흉내 내기 위한 녹음을 구하거나 보관할 필요도 줄어듭니다. 모델과 선택한 음성 이름을 내보내기 기록에 남겨 다음 수정 때 같은 설정으로 시작하세요. Pocket TTS 기본 음성 지원
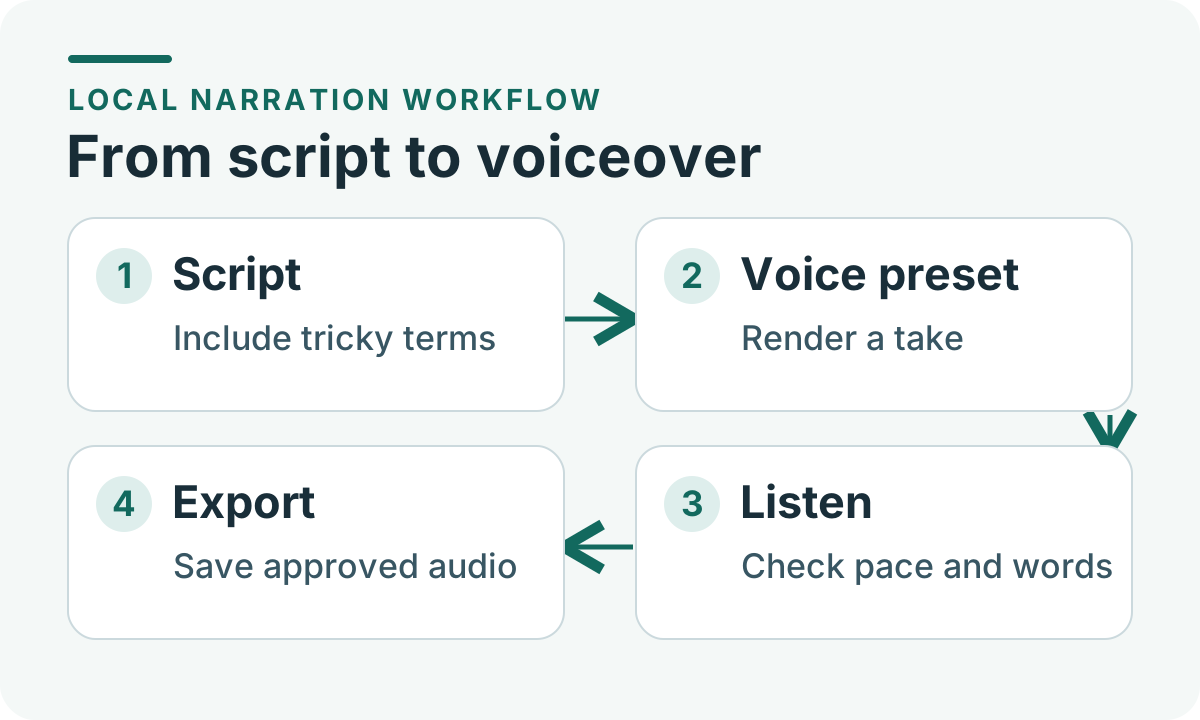
Telli.sh 자체 제작. 내보내기 전에 오디오를 직접 들어봅니다. 기본 음성의 이름은 무엇을 요청했는지 보여주고, 청취 결과는 실제로 무엇이 만들어졌는지 알려줍니다.
일반적인 시연에서 빠지는 표현을 짧은 대본에 넣어 보세요. 제품 코드, 주소 형식, 단위가 붙은 숫자, 말투가 중요한 문장을 넣습니다. 세 문장을 따로 시험한 뒤 문단 전체를 생성합니다. 한 문장씩 들으면 일관된 목소리가 긴 문단에서는 중요한 단어를 급하게 읽을 수 있습니다. 대상 언어를 아는 사람이 대본을 보지 않고 먼저 듣게 한 뒤, 들은 내용과 원문을 비교합니다.
최종 오디오는 입력 대본과 원본 녹음에서 분리해 저장합니다. 숫자를 잘못 읽은 사실을 나중에 발견해도 기존 편집본을 잃지 않고 특정 부분을 고칠 수 있습니다. 허가를 받은 성우가 이미 참여한 프로젝트라면 성우 녹음과 생성한 대안을 명확히 표시해 한쪽이 표시 없이 다른 쪽을 대체하는 일을 막습니다. 이해하기 쉽고 일관된 목소리만 필요한 프로젝트라면 기본 음성이 간단한 선택입니다.
런타임 버전은 전체 구성의 일부입니다
팀이 이미 llama.cpp를 쓴다면 이번 릴리스 덕분에 런타임을 바꿀 필요가 줄어듭니다. 사용할 컴퓨터에 맞는 빌드, 올바른 모델 파일, 모델에 따라 필요한 추가 파일은 준비해야 합니다. Nemotron 구현이 명시한 멀티모달 프로젝터가 한 예입니다. 모델 가중치는 별도로 내려받으며 자체 조건이 적용됩니다. 다른 팀이나 고객에게 일부를 묶어 배포하기 전에 런타임과 모델 문서를 모두 확인합니다. 릴리스 파일 및 Nemotron 통합 설정
메모리는 모델 로딩이 끝난 뒤 실제 작업 중에 측정할 가치가 있습니다. 모델 파일 크기는 디스크에서 차지하는 공간을 알려줍니다. 모델 실행과 처리 엔진의 버퍼, 중간 작업에도 공간이 필요합니다. 데스크톱에서 전사가 시작돼도 편집기와 GPU를 함께 쓰면 편집이 느려질 수 있습니다. 노트북에서 한 번 잘 돌아가도 발열과 백그라운드 작업 때문에 네 번째 실행에서 시간이 더 걸릴 수 있습니다. 실제 환경과 같은 설정에서 편집기를 열어 둔 채 시스템 RAM과 필요한 경우 GPU 메모리의 최고 사용량을 기록합니다.
유지보수 담당자는 Nemotron 변경 요청에 전사 검증을 공개했습니다. 깨끗한 음성과 회의 데이터 세트, 지정된 양자화 설정, 테스트 장비 RTX PRO 6000 Blackwell이 포함됩니다. 이 결과는 통합을 어떻게 확인했는지 보여줍니다. 구매하거나 배포할지 판단하려면 실제로 쓸 컴퓨터에서 자신의 녹음을 시험하세요. 같은 장비에서도 정밀도, 언어, 발언이 겹치는 정도가 달라지면 처리 시간과 수정 부담의 관계가 달라질 수 있습니다. Nemotron 검증과 설정
버전 비교는 단순하게 유지하세요. 11월 6일의 b12144는 CUDA의 전문가 혼합 모델 배치를 변경한 별도의 사전 릴리스입니다. 음성 기능을 판단하려면 11월 4일 정식 버전으로 시작하고 모델 파일과 설정을 고정하세요. 나중에 사전 릴리스를 평가한다면 별도 실행으로 기록합니다. 음성 모델, 추론 엔진, 주변 앱 가운데 어떤 변화가 결과에 영향을 줬는지 구분할 수 있습니다. 11월 6일 사전 릴리스 노트
로컬 처리를 할 때는 무엇이 컴퓨터 안에 남는지 명확히 할 필요가 있습니다. 편집 흐름이 로컬 서버를 호출하더라도 다른 앱이 로그를 전송하거나 출력 폴더를 동기화하거나 의존 파일을 내려받을 수 있습니다. 민감한 녹음을 넣기 전에 테스트 컴퓨터나 지정된 준비 단계에서 실행 파일과 모델 가중치를 확보합니다. 이후 민감하지 않은 파일로 오프라인 상태에서 어느 단계까지 완료되는지 확인합니다. 원본 파일, 임시 데이터, 최종 출력 파일의 저장 위치를 살펴보세요. 로컬 런타임이 추론을 장치 안에서 처리할 수 있고, 전체 데이터 경로는 주변 애플리케이션이 결정합니다.
실제 쓰는 컴퓨터에서 프로젝트 하나를 시험합니다
- 공유할 수 있는 짧은 입력 두 가지를 고릅니다. 발언이 조금 겹치고 가상의 기능 이름이 나오는 30~60초짜리 두 사람의 대화를 녹음합니다. 같은 이름과 발음하기 까다로운 숫자 하나를 넣어 짧은 내레이션을 씁니다. 설정 변경의 영향을 볼 수 있도록 매번 같은 입력을 사용합니다.
- 런타임과 모델을 고정합니다. 시스템에 맞는 v0.9.0 소스 또는 연결된 b12110 빌드를 고릅니다. 모델 출처, 파일 이름, 양자화 방식을 기록합니다.
llama-server로 Nemotron을 실행할 때 병합된 통합 문서는--reasoning off를 안내합니다. 기본 템플릿은 전사문 없이 추론 내용만 반환할 수 있기 때문입니다. 멀티모달 CLI에는 이 옵션이 필요 없다고 나옵니다. 실제 운영할 경로와 시험 경로를 일치시킵니다. Nemotron 통합 노트 - 처음 실행과 반복 실행을 측정합니다. 첫 실행에서 시작부터 결과까지 걸린 시간과 모델을 로드한 뒤의 처리 시간을 각각 기록합니다. 전사는 처리 시간을 오디오 길이로 나눠 긴 녹음도 감당할 수 있을지 살펴봅니다. 최고 메모리 사용량과 편집기가 계속 반응하는지도 기록합니다. 내레이션에서는 한 줄을 수정한 뒤 새 음성을 듣기까지의 시간이 더 중요할 수 있습니다.
- 오류를 수정하는 데 드는 시간까지 비교합니다. 놓친 용어, 틀린 숫자, 뒤바뀐 화자, 시간을 다시 맞출 문장을 표시합니다. 수정 시간을 완료 시간에 포함합니다. 내레이션에서는 이름과 숫자, 말 사이의 간격, 새 음성이 영상에 맞는지 확인합니다. 첫 출력 파일과 함께 수정한 결과물까지 비교합니다.
- 자동화하기 전에 인수인계를 정합니다. 누가 전사문을 확인하고, 어디에서 자막 시간을 맞추고, 승인된 내레이션을 어떻게 표시할지 결정합니다. 첫 파일이 통과하면 두 번째를 시도합니다. 실패하면 입력을 보존하고 편집 대기열에 실패를 표시해 사람이 전체 작업을 반복하지 않고 이어받게 합니다.
스프레드시트에 준비, 처리 시간, 수정 시간, 승인 여부 네 열을 두고 기록할 수 있습니다. 결과를 반려한 이유도 남깁니다. 몇 차례 시험한 뒤 로컬 환경이 반복되는 내레이션 수정에 좋지만 소음이 심한 그룹 인터뷰에는 다른 절차가 필요하다는 결과가 나올 수 있습니다. 시간을 절약하는 곳에 각 기능을 쓰고, 어디에서 다른 방법이 더 잘 동작하는지 기록합니다.
이미 잘 작동하는 전사 절차가 있다면 같은 녹음과 승인 기준으로 비교합니다. 작업용 컴퓨터에서 위험이 낮은 임시 내레이션을 만드는 등 더 쉬운 작업부터 옮겨도 됩니다. 안정적인 자막 절차도 모델 실행을 통합할 이유가 생기고 새 구현이 기존 편집 기준을 충족하는 것으로 확인되면 나중에 같은 로컬 통합의 이점을 얻을 수 있습니다.
이번 릴리스를 활용하기 좋은 곳
가장 좋은 첫 활용 사례는 이미 반복하는 일입니다. 교육 영상 제작팀은 초벌 녹음이 편집 컴퓨터를 떠나기 전에 전사하고 임시 내레이션을 만들어 템포를 확인할 수 있습니다. 연구자는 직접 관리하는 녹음을 수정 가능한 전사문으로 만들고 화자 표기를 고치고 원본 오디오를 보존할 수 있습니다. 소규모 개발팀은 선택한 모델, 결과 파일, 오류를 볼 수 있는 내부 화면에서 두 경로를 시험할 수 있습니다.
이번 릴리스는 각 작업의 품질 확인을 유지하면서 전문 도구 사이의 인수인계를 줄이는 데 의미가 있습니다. 전사 모델은 단어를 인식하고 화자를 구분해야 합니다. 합성 모델은 대본을 읽어야 합니다. 편집자는 결과가 언제 완성됐는지 판단해야 합니다. 달라진 점은 이런 작업을 같은 추론 도구에서, 경우에 따라 이미 쓰는 컴퓨터 한 대에서 실행할 수 있다는 것입니다.
완성한 녹음을 전사문과 메모 옆에서 다시 보고 싶다면 Telli.sh에서 업로드를 시작해 보세요.