Il tuo computer può occuparsi sia dei sottotitoli sia della voce fuori campo?
llama.cpp 0.9.0 aggiunge tre funzioni vocali. Prova trascrizione offline, etichette dei parlanti e narrazione con voci predefinite sul tuo computer.
Hai un premontaggio di una dimostrazione, la registrazione di due colleghi che ne parlano e tre battute della voce narrante da rifare. È normale inviare l'audio a un servizio di trascrizione e il copione a un servizio vocale. Svolgere entrambi i lavori sul computer di montaggio potrebbe rendere più rapide le revisioni, soprattutto se il materiale deve restare su quella macchina. In cambio, chi monta si prende carico della coda, dei file dei modelli e dei controlli di qualità.
Il 4 novembre 2026 il progetto di inferenza open source llama.cpp ha pubblicato la versione 0.9.0. La nuova versione aggiunge la trascrizione offline con NVIDIA Nemotron 3.5 Transcribe, la sintesi vocale con Chatterbox e le voci predefinite di Pocket TTS, utilizzabili senza una registrazione di riferimento. Le note di rilascio indicano la trascrizione in 40 lingue, il contesto nel prompt e l'attribuzione delle battute ai parlanti. Ogni aggiunta ha un ruolo nello stesso flusso di montaggio e chiede cose diverse alla macchina e a chi verifica l'output. Note di rilascio di llama.cpp v0.9.0
Se hai incontrato llama.cpp provando un chatbot locale, il nome può far sembrare questa versione più circoscritta di quanto sia. È un ambiente di inferenza che esegue architetture di modelli compatibili, con strumenti per caricare file e servire richieste. L'aggiornamento amplia le operazioni disponibili con quegli strumenti. L'applicazione che li integra continua a decidere dove salvare l'audio, come mostrare le correzioni e quando un file è pronto per la pubblicazione. Progetto llama.cpp
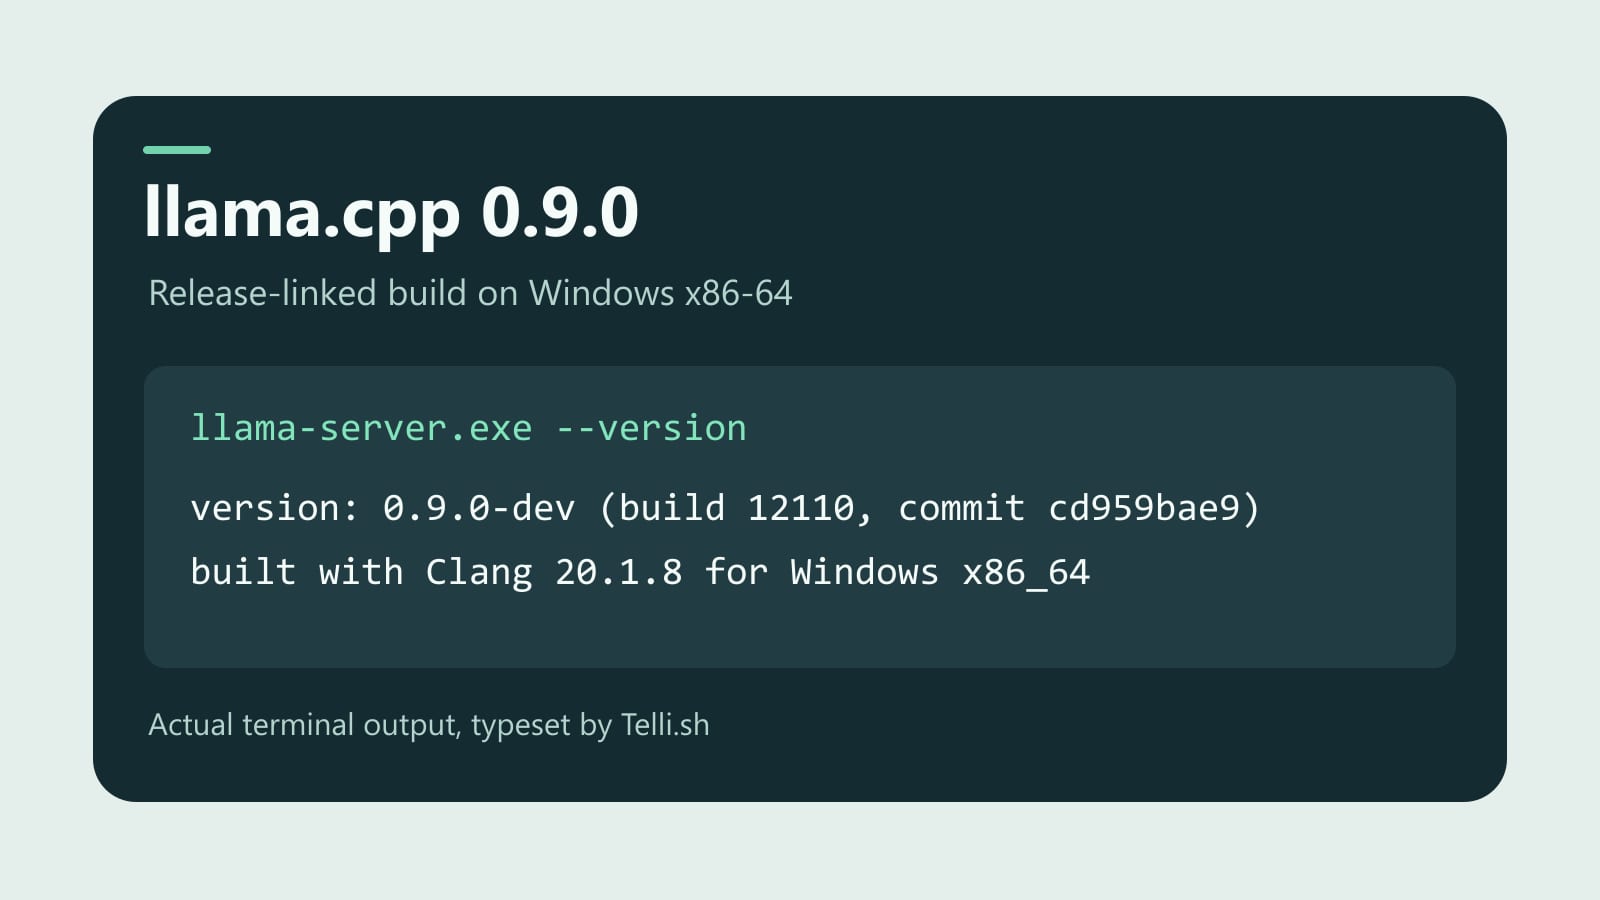
Telli.sh ha eseguito la build ufficiale di Windows collegata al rilascio e ha impaginato l'output effettivo del comando di versione. Il risultato identifica la build. Build b12110 collegata al rilascio
I sottotitoli partono da una trascrizione modificabile
Immagina che un collega registri dieci minuti di presentazione di un prodotto non ancora annunciato. Un'altra persona lo interrompe per correggere il nome di una funzione. Vuoi un testo ricercabile, un'indicazione di chi ha detto cosa e, alla fine, sottotitoli che compaiano nel fotogramma giusto. Sono tre risultati distinti. Il primo è un testo, il secondo un'annotazione editoriale e il terzo richiede una sincronizzazione.
L'integrazione di Nemotron permette di partire dai primi due. L'implementazione supporta la trascrizione offline con contesto facoltativo e attribuzione ai parlanti. Può mantenere le informazioni sui parlanti tra finestre di elaborazione della stessa registrazione. Le note specificano che i marcatori temporali a livello di parola e la trascrizione in streaming non rientrano in questa integrazione. In pratica, trascrivi la registrazione conclusa, correggi il testo e sincronizza i tempi in una fase separata di montaggio o sottotitolazione quando la consegna lo richiede. Integrazione di Nemotron 3.5 Transcribe
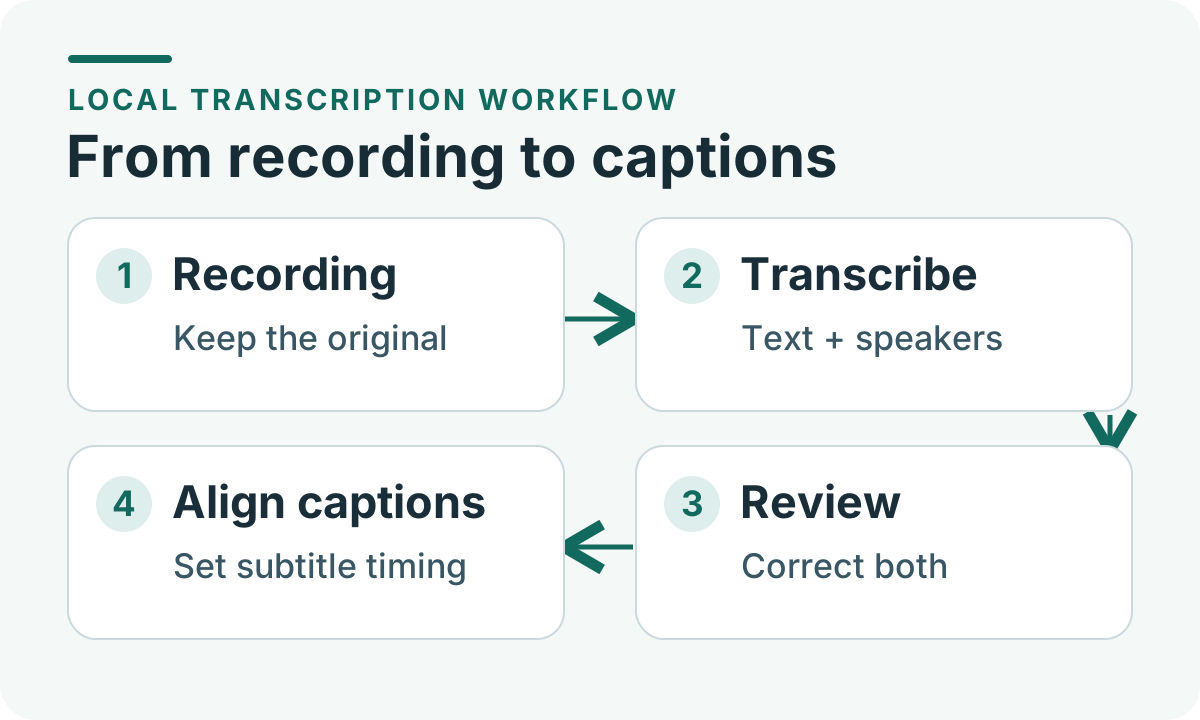
Illustrazione di Telli.sh. La trascrizione locale fornisce un testo da correggere. I sottotitoli si sincronizzano dopo aver controllato il testo e le etichette dei parlanti.
Il contesto è interessante per i team che usano parole poco comuni. In una registrazione su una funzione immaginaria chiamata Pine Relay, prova un breve elenco di nomi e sigle attesi. Esegui poi la stessa prova senza l'elenco. Verifica se il contesto corregge il nome, se lo introduce in punti in cui nessuno lo ha detto e se cambia numeri o altre parole. Tieni la lista abbastanza corta da spiegare quale voce abbia influito sul risultato. Un assistente di trascrizione deve facilitare la revisione dei termini insoliti senza dare al glossario il potere di riscrivere una registrazione.
Controlla a parte l'attribuzione ai parlanti. In un'intervista pulita può essere semplice distinguere due persone. Aggiungi una terza persona in vivavoce e qualche frase sovrapposta e il carico di correzione può cambiare. Ascolta sia i passaggi di voce sia gli interventi più lunghi. Una trascrizione può contenere tutte le parole giuste e attribuire comunque una decisione importante alla persona sbagliata. Tieni distinte le etichette prodotte dal modello dai nomi reali finché una persona che conosce la registrazione non li ha confermati.
Per i sottotitoli, riproduci il file esportato con il video. Una frase che si legge bene in un documento può uscire dallo schermo, apparire prima di una rivelazione importante o restare mentre parla già la persona successiva. Prova un taglio netto e una breve interruzione all'inizio della clip. Se ti servono file di sottotitoli con tempi affidabili, includi sincronizzazione e correzione nel tempo di lavoro. Una prima trascrizione pulita rimane utile anche quando il montaggio finale si fa altrove.
Una voce predefinita è un buon punto di partenza
Pensa all'altra metà del premontaggio. Cambia il nome di una funzione e devi sostituire una battuta in sei registrazioni dello schermo. Quando modello e hardware sono pronti, generare localmente una nuova versione è un esperimento poco costoso. Le parti difficili sono coerenza e pronuncia. L'audio nuovo deve integrarsi con le clip adiacenti, pronunciare correttamente il nome del prodotto e stare nei tempi dell'inquadratura.
La versione 0.9.0 include Chatterbox fra i modelli di sintesi vocale supportati da llama.cpp. La revisione del progetto riporta prove CUDA con Chatterbox Turbo e Multilingual V3. Chi ha verificato l'integrazione ha provato voci predefinite e generazione a partire da una voce di riferimento, allegando campioni. Sono prove dell'integrazione in una configurazione specifica. Per un uso in produzione, la domanda successiva è se la voce e la lingua rimangano coerenti con il testo e l'hardware che userai davvero. Supporto di Chatterbox ed esempi audio della revisione
Pocket TTS offre un'altra opzione. Un modello compatibile può esporre i nomi delle voci integrate nella voce voices della risposta del server a GET /props. Il client può passare uno dei nomi disponibili al percorso di sintesi vocale. Uno script o una piccola applicazione possono così riempire il selettore delle voci a partire dal modello caricato. Per la prima prova puoi usare una voce predefinita senza procurarti e conservare la registrazione di una persona da imitare. Salva il modello e il nome della voce con l'export per ripartire dalla stessa configurazione quando dovrai fare un'altra modifica. Voci predefinite di Pocket TTS
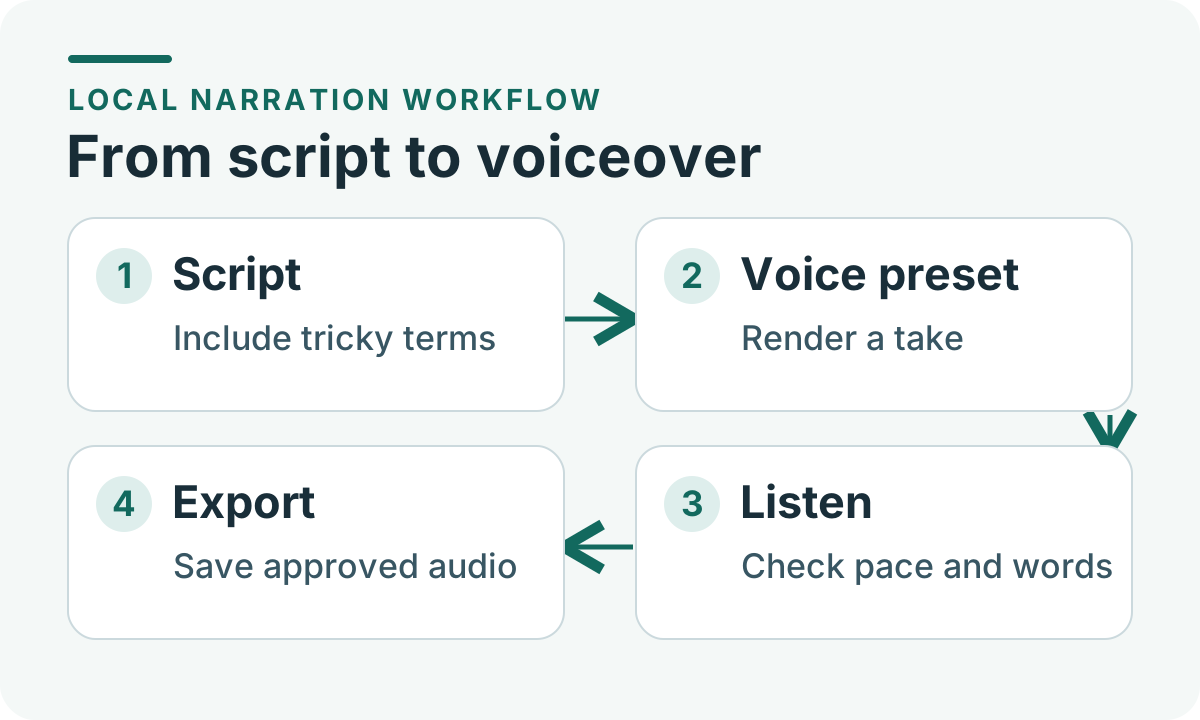
Illustrazione di Telli.sh. Ascolta l'audio prima di esportarlo. La voce selezionata indica che cosa hai chiesto. L'ascolto rivela che cosa hai ottenuto.
Parti da un breve copione con termini che le dimostrazioni di solito saltano. Aggiungi un codice prodotto, un formato di indirizzo o un numero con unità di misura, oltre a una frase in cui conta il tono. Prova tre frasi separate e poi genera tutto il paragrafo. Una voce può essere coerente nelle singole battute e accelerare proprio sulla parola importante in un passaggio lungo. Chiedi a una persona che conosce la lingua del pubblico di ascoltare senza copione e poi confrontare ciò che ha sentito con il testo previsto.
Salva l'audio finale separatamente dal copione e dalle registrazioni originali. Se in seguito scopri un numero pronunciato male, puoi rifare quella battuta senza perdere il montaggio originale. Se il lavoro prevede già una persona autorizzata a prestare la voce, etichetta chiaramente sia le sue registrazioni sia le alternative generate, così una non può sostituire l'altra senza che si noti. Una voce predefinita è una scelta semplice quando serve una narrazione comprensibile e uniforme.
La versione del motore è una parte della configurazione
Il rilascio può togliere un motivo per cambiare ambiente se il team usa già llama.cpp. Ti servono comunque una build compatibile con la macchina, i file del modello e gli eventuali file complementari specifici, come il proiettore multimodale indicato nell'integrazione di Nemotron. I pesi si scaricano a parte e hanno condizioni proprie. Controlla la documentazione dell'ambiente e del modello prima di preparare un pacchetto per un altro team o cliente. File del rilascio e note di configurazione di Nemotron
Misura la memoria durante il lavoro, quando il caricamento è terminato. La dimensione di un file dice quanto spazio occupa su disco. Per eseguire il modello servono anche memoria per i calcoli, i buffer del motore e i passaggi intermedi. Un computer fisso che riesce ad avviare la trascrizione può comunque rallentare il programma di montaggio se entrambi usano la GPU. Un portatile che funziona al primo tentativo può metterci di più al quarto, quando entrano in gioco temperatura e attività in background. Registra i picchi di RAM e, quando rilevante, di memoria video con il programma aperto nella configurazione d'uso reale.
Chi mantiene il progetto ha condiviso nella richiesta di integrazione di Nemotron prove di trascrizione su raccolte di parlato pulito e di riunioni, specificando la quantizzazione e la presenza di una RTX PRO 6000 Blackwell nell'ambiente di test. I risultati spiegano come è stata verificata l'integrazione. Per decidere cosa acquistare o installare, misura le tue registrazioni sulla macchina prevista. Anche a parità di hardware, cambiare precisione o lingua o elaborare più voci sovrapposte può spostare l'equilibrio fra tempo di calcolo e tempo di revisione. Validazione e configurazione di Nemotron
Confronta le versioni senza mescolare gli interventi. La b12144 del 6 novembre è una versione preliminare separata che modifica la disposizione dei dati della miscela di esperti in CUDA. Per valutare le novità audio, parti dalla versione numerata del 4 novembre e tieni fissi file e impostazioni del modello. Se provi poi la versione preliminare, registrala come prova separata. Potrai capire se il lavoro è cambiato per il modello audio, per il motore di inferenza o per l'applicazione che li usa. Note della versione preliminare del 6 novembre
Per il lavoro locale è utile anche precisare cosa rimanga sul computer. Il programma può chiamare un server locale mentre un'altra applicazione invia log, sincronizza una cartella di output o scarica una dipendenza. Prima di usare registrazioni sensibili, procurati binari e pesi su una macchina di prova o in un passaggio di preparazione dedicato. Poi usa un frammento innocuo senza connessione per vedere quali parti del flusso si completano. Controlla dove sono scritti l'originale, i temporanei e l'export. L'ambiente locale delimita l'inferenza. Il resto dell'applicazione determina il percorso completo dei dati.
Prova un progetto sul computer che usi davvero
- Scegli due input brevi e condivisibili. Registra da 30 a 60 secondi con due persone, qualche sovrapposizione e il nome di una funzione inventata. Scrivi una breve narrazione con lo stesso nome e un numero difficile. Mantieni gli input fissi per capire gli effetti di un'impostazione diversa.
- Fissa versione e modelli. Scegli il sorgente v0.9.0 o la build b12110 collegata per il tuo sistema. Registra provenienza, nomi dei file e quantizzazione. Per Nemotron con
llama-server, l'integrazione documenta--reasoning offperché il template predefinito può altrimenti restituire il ragionamento senza trascrizione. Le note indicano che lo strumento multimodale da riga di comando non richiede l'opzione. Prova il percorso che userai in pratica. Note sull'integrazione di Nemotron - Misura un'esecuzione a freddo e ripetila. Registra il tempo dall'avvio al risultato e quello dopo il caricamento del modello. Per la trascrizione, dividi il tempo di elaborazione per la durata dell'audio per capire se l'attesa resta accettabile con una registrazione più lunga. Registra i picchi di memoria e la reattività del programma di montaggio. Per la voce fuori campo può contare di più il tempo che passa fra la modifica di una battuta e l'ascolto della nuova versione.
- Confronta gli errori in base al costo della correzione. Segna un termine omesso, un numero sbagliato, un parlante scambiato e una frase da risincronizzare. Includi la correzione nel tempo totale. Per la narrazione, verifica nomi, numeri, pause e adattamento al montaggio. Il confronto include il file corretto oltre a quello generato per primo.
- Definisci il passaggio di consegne prima di automatizzare. Decidi chi verifica il testo, dove si sincronizzano i sottotitoli e come si indicano le narrazioni approvate. Prova una seconda clip dopo che la prima ha passato i controlli. Se un file fallisce, conserva l'input e segnala il problema nella coda di montaggio per permettere a una persona di riprenderlo senza rifare l'intero gruppo.
Puoi registrare i controlli in quattro colonne di un foglio di calcolo: configurazione, tempo di elaborazione, tempo di correzione e accettazione. Annota il motivo di ciascun rifiuto. Dopo alcune prove potresti scoprire che l'ambiente locale funziona molto bene per rifare le battute, mentre le interviste di gruppo rumorose richiedono ancora un altro processo. È un risultato utile. Usa ogni componente dove fa risparmiare tempo e annota dove funziona meglio la procedura alternativa.
Se hai già una procedura di trascrizione efficace, confrontala usando la stessa registrazione e gli stessi criteri. Puoi trasferire solo il lavoro più semplice, come la generazione di una voce provvisoria a basso rischio sul computer di montaggio. Un flusso di sottotitolazione affidabile può beneficiare in seguito di un'integrazione locale comune, quando ci sarà un motivo per unificare l'esecuzione dei modelli e la nuova implementazione avrà dimostrato di rispettare i criteri editoriali precedenti.
Dove il rilascio è più utile
Il miglior primo caso è un lavoro che ripeti già. Un team che crea tutorial può trascrivere una ripresa grezza prima che il video lasci la macchina di montaggio e generare una voce provvisoria per controllarne il ritmo. Un ricercatore può creare un testo modificabile da una registrazione che gestisce, correggere i parlanti e conservare l'audio come fonte. Un piccolo team di sviluppo può provare entrambi i percorsi dietro un'interfaccia interna, purché mostri il modello scelto, il risultato e gli eventuali errori.
Il rilascio potrebbe contare soprattutto per ridurre i passaggi fra strumenti specializzati mantenendo distinti i loro controlli di qualità. Il modello di trascrizione deve comunque riconoscere le parole e distinguere le voci. Il modello di sintesi deve pronunciare il copione. Chi monta deve decidere quando il lavoro è pronto. Ora queste attività possono condividere gli strumenti di inferenza e, forse, un computer che usi già.
Per ritrovare una registrazione finita insieme alla trascrizione e alle note, avvia un caricamento in Telli.sh.