Votre ordinateur peut-il produire à la fois les sous-titres et la voix off ?
llama.cpp 0.9.0 ajoute trois fonctions audio. Voici comment essayer la transcription hors ligne, l’attribution des voix et la narration prédéfinie avec votre matériel.
Vous avez un premier montage de démonstration, un enregistrement où deux collègues parlent et trois lignes de voix off à refaire. Il est courant d’envoyer l’enregistrement à un service de transcription et le texte à un service vocal. Exécuter les deux tâches sur la machine de montage peut faciliter les corrections successives, surtout si les sources doivent y rester. En contrepartie, le montage doit désormais gérer la file d’attente, les fichiers de modèle et les contrôles de qualité.
Le 4 novembre 2026, le projet libre d’inférence llama.cpp a publié sa version 0.9.0. Elle ajoute la transcription hors ligne avec NVIDIA Nemotron 3.5 Transcribe, la synthèse vocale avec Chatterbox et la prise en charge des voix prédéfinies de Pocket TTS sans enregistrement de référence. Les notes annoncent la transcription en 40 langues, le contexte fourni par la consigne et l’attribution des prises de parole. Ces changements peuvent servir au cours d’un même montage, mais chacun demande un travail différent à la machine et à la personne qui vérifie le résultat. Notes de version de llama.cpp v0.9.0
Si vous avez découvert llama.cpp en essayant un assistant local, son nom peut donner l’impression d’une mise à jour plus étroite. C’est un moteur d’inférence capable d’exécuter les architectures prises en charge. Il fournit des outils pour charger des fichiers compatibles et traiter les requêtes. La mise à jour étend ce qui peut passer par ces outils. L’application qui les utilise décide toujours où conserver l’audio, comment présenter les corrections et à quel moment publier le fichier. Projet llama.cpp
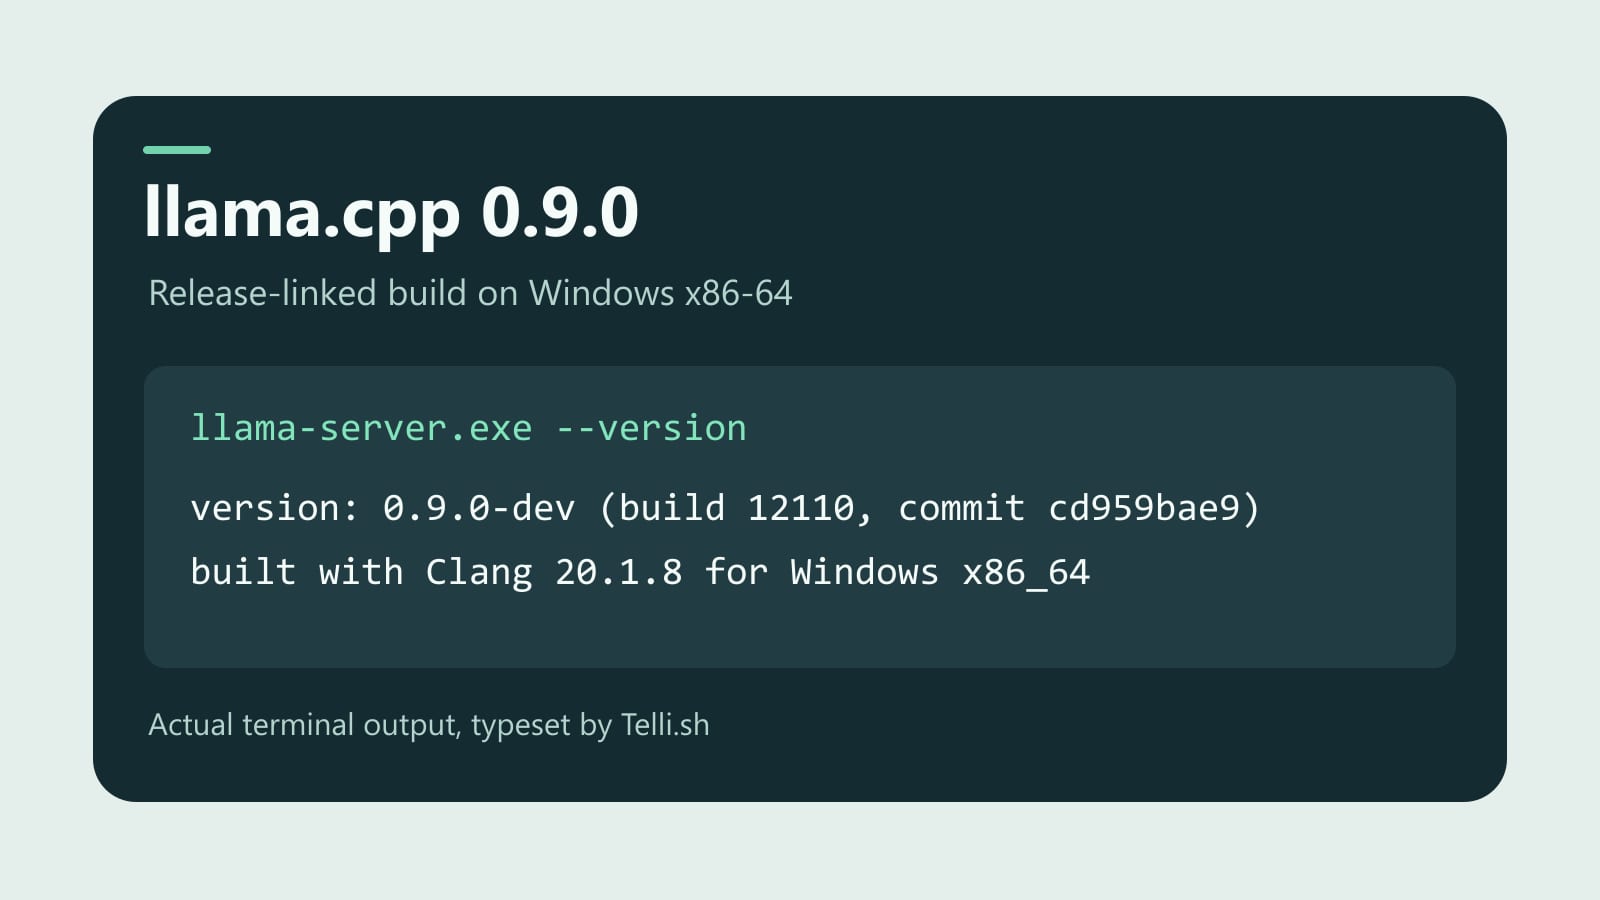
Telli.sh a exécuté la compilation Windows indiquée dans la publication et a mis en forme la véritable sortie de version. L’extrait confirme l’identité de la compilation. Compilation b12110 liée à la version
Les sous-titres commencent par une transcription modifiable
Une collègue enregistre une présentation de dix minutes sur un produit qui n’est pas encore sorti. Un collègue l’interrompt pour corriger le nom d’une fonction. Vous voulez une transcription consultable, une première attribution des prises de parole et enfin des sous-titres qui tombent au bon moment. Il s’agit de trois résultats différents. Le premier est un texte, le deuxième une annotation éditoriale et le troisième exige des repères temporels.
L’intégration de Nemotron permet de commencer par les deux premiers. Le code intégré prend en charge la transcription hors ligne avec du contexte facultatif et l’attribution des locuteurs. Il peut transporter cette information d’une fenêtre de traitement à la suivante dans un même enregistrement. Les notes du mainteneur précisent que les horodatages mot à mot et le traitement en flux sont hors du périmètre de cette intégration. Transcrivez donc l’enregistrement terminé, corrigez le texte et procédez ensuite au calage dans une étape distincte de montage ou de sous-titrage si le livrable l’exige. Intégration de Nemotron 3.5 Transcribe
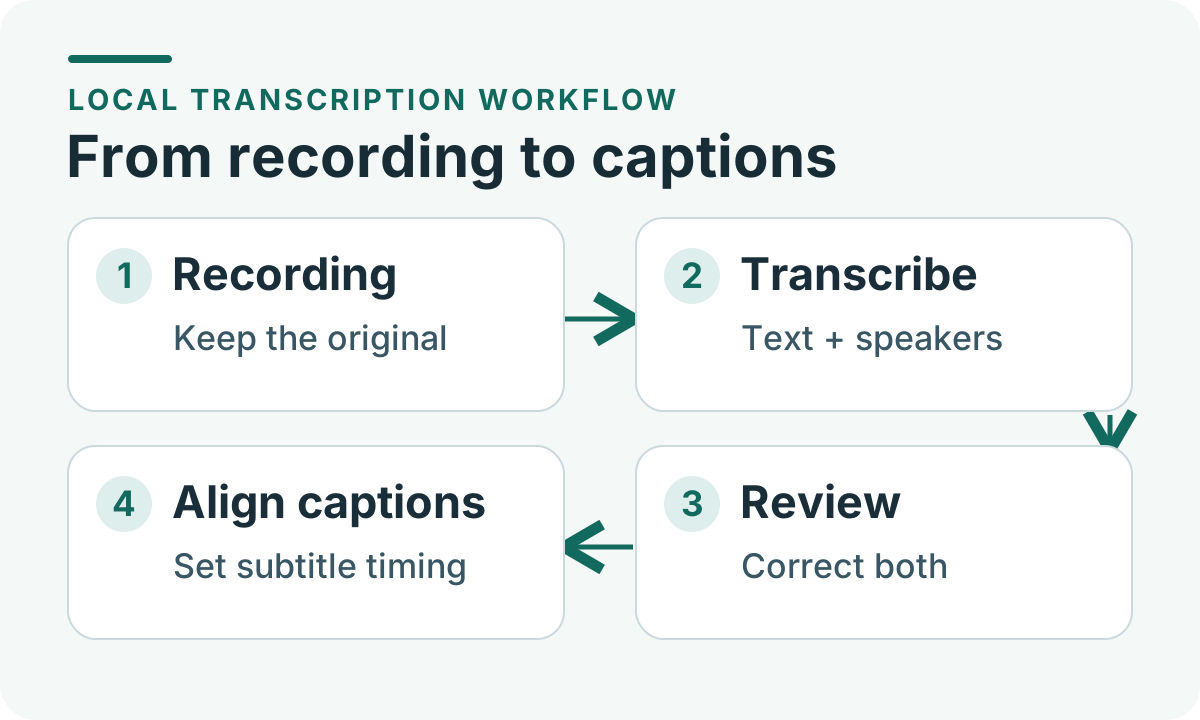
Illustration de Telli.sh. La transcription locale donne un texte à corriger. Le calage des sous-titres vient après la vérification du texte et des locuteurs.
Le contexte de la consigne est particulièrement intéressant pour les mots rares dans la conversation courante. Pour un enregistrement portant sur une fonction fictive nommée Pine Relay, essayez une courte liste de noms et sigles attendus, puis traitez le même extrait sans liste. Comptez les cas où le contexte rétablit le bon nom, l’insère alors que personne ne l’a dit ou modifie un nombre ou un mot sans rapport. Gardez une liste assez courte pour expliquer l’effet d’une entrée. Un outil de transcription devrait faciliter la vérification des termes inhabituels sans laisser le glossaire réécrire l’enregistrement.
L’attribution des locuteurs mérite un contrôle séparé. Deux voix dans un entretien bien enregistré peuvent être faciles à distinguer. Ajoutez une troisième personne en haut-parleur et quelques phrases qui se chevauchent, et le travail de correction peut changer. Écoutez les transitions et la plus longue intervention de chaque personne. Tous les mots peuvent être justes alors qu’une décision importante est attribuée à la mauvaise personne. Gardez les repères du modèle séparés des noms attribués par l’équipe jusqu’à confirmation par quelqu’un qui connaît l’enregistrement.
Pour les sous-titres, relisez le fichier exporté sur la vidéo. Une phrase qui passe bien dans un document peut déborder de l’écran, précéder un élément qui devait être révélé plus tard ou rester visible lorsque quelqu’un d’autre a déjà commencé à parler. Testez une coupe franche et une courte interruption dès le début. Si vous devez livrer des fichiers avec des repères fiables, incluez le calage et la correction dans le temps prévu. Une première transcription soignée est utile même lorsque le montage final est réalisé ailleurs.
Une voix prédéfinie convient au premier essai
Prenez l’autre partie du montage. Une fonction change de nom, et vous devez remplacer une phrase de voix off dans six captures vidéo. Quand le modèle et la machine sont prêts, produire une prise locale devient un essai peu coûteux. Les difficultés sont la cohérence et la prononciation. Le nouvel audio doit s’insérer entre les clips voisins, bien prononcer le produit et tenir dans le plan.
La version 0.9.0 ajoute Chatterbox aux modèles de synthèse vocale pris en charge. La revue du projet décrit des exécutions CUDA pour Chatterbox Turbo et Multilingual V3. La personne chargée de vérifier a testé les voix par défaut et la génération à partir d’une référence, et a joint des exemples audio. Ces éléments documentent la vérification de l’intégration sur une configuration donnée. Pour la production, reste à voir si la voix et la langue conservent le même rendu sur votre texte et votre matériel. Prise en charge de Chatterbox et exemples audio du projet
Pocket TTS offre une autre possibilité. Un modèle compatible peut exposer les noms de ses voix intégrées dans le champ voices de la réponse serveur à GET /props. Le client peut transmettre un nom de cette liste à la route de synthèse vocale. Un script ou une petite application peut ainsi remplir son sélecteur à partir du modèle chargé. Pour un premier pilote, la voix prédéfinie évite de chercher et de conserver l’enregistrement d’une personne à imiter. Notez le modèle et le nom de voix retenu dans le suivi de l’export pour reprendre les mêmes réglages lors d’une modification. Voix prédéfinies de Pocket TTS
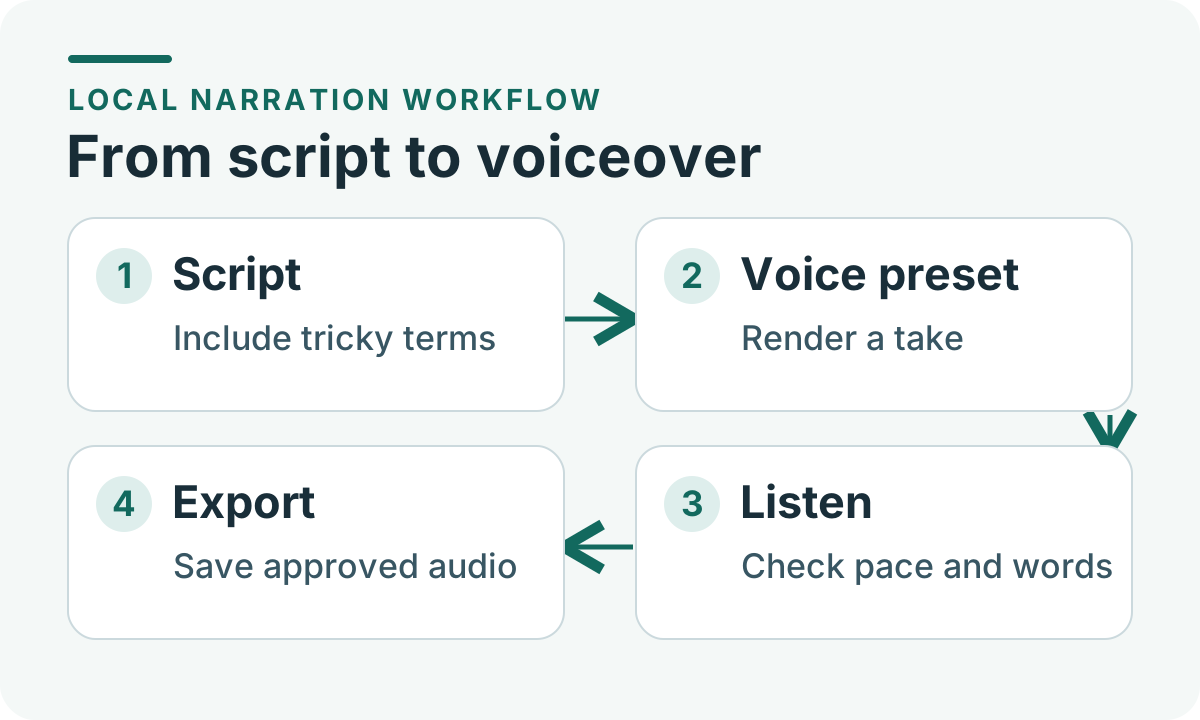
Illustration de Telli.sh. Écoutez le résultat avant de l’exporter. La voix sélectionnée indique la demande. L’écoute vous dit ce qui a été produit.
Commencez avec un texte court contenant les termes qu’une démonstration ordinaire évite. Ajoutez un code produit, une forme d’adresse ou un nombre avec une unité, ainsi qu’une phrase dont le ton compte. Faites produire trois phrases isolées, puis le paragraphe entier. Une voix peut rester stable sur les phrases seules et accélérer sur le mot important dans une prise plus longue. Demandez à quelqu’un qui connaît la langue du public d’écouter d’abord sans le texte, puis de comparer ce qu’il a entendu à la phrase attendue.
Conservez l’audio final à part du texte et des enregistrements d’origine. Si un nombre a été mal prononcé, vous pourrez corriger la prise concernée sans perdre le montage d’origine. Pour une narration qui emploie déjà une voix humaine autorisée, identifiez clairement ses enregistrements et les variantes générées afin qu’ils ne se remplacent pas à l’insu de l’équipe. Une voix prédéfinie est un point de départ simple si le projet exige seulement une voix intelligible et cohérente.
La version du moteur ne représente qu’une partie de la configuration
La version peut épargner un changement de moteur à une équipe qui utilise déjà llama.cpp. Il faut tout de même une compilation compatible avec la machine, les bons fichiers de modèle et d’éventuels fichiers annexes, comme le projecteur multimodal indiqué par l’intégration Nemotron. Les poids se téléchargent séparément et ont leurs propres conditions. Consultez la documentation du moteur et du modèle avant de transmettre une partie de la configuration à une équipe ou à un client. Fichiers de la publication et Notes de configuration de Nemotron
Mesurez la mémoire pendant le traitement, une fois le modèle chargé. La taille d’un fichier indique sa place sur le disque. L’exécution a également besoin d’espace pour le modèle, les tampons et les résultats intermédiaires. Un ordinateur peut lancer la transcription et ralentir le montage si les deux utilisent le GPU. Un portable peut mettre plus longtemps au quatrième essai lorsque la chaleur et les tâches de fond entrent en jeu. Relevez les pics de RAM et, le cas échéant, de mémoire graphique avec le logiciel de montage ouvert dans la configuration prévue.
Les mainteneurs ont documenté la validation de la transcription dans la demande d’intégration Nemotron, sur des jeux de parole claire et de réunions notamment. Ils indiquent les réglages de quantification et la présence d’une RTX PRO 6000 Blackwell dans l’environnement de test. Cela montre comment l’intégration a été contrôlée. Pour une décision d’achat ou de déploiement, mesurez vos enregistrements sur la machine visée. Même avec le même matériel, changer la précision ou la langue, ou ajouter plus de paroles superposées, peut modifier l’équilibre entre traitement et vérification. Validation et configuration de Nemotron
Gardez une comparaison simple. b12144, datée du 6 novembre, est une préversion distincte qui change l’organisation des données des mélanges d’experts sous CUDA. Pour juger les nouveautés audio, commencez avec la version numérotée du 4 novembre en conservant les fichiers et les réglages. Si vous évaluez la préversion, consignez-la comme essai distinct. Vous pourrez distinguer les effets du modèle audio, du moteur d’inférence et de l’application. Notes de la préversion du 6 novembre
Précisez aussi ce que signifie « local ». Même si le logiciel appelle un serveur local, une autre application peut envoyer des journaux, synchroniser le dossier de sortie ou récupérer une dépendance. Récupérez les programmes et les poids sur une machine de test ou pendant une préparation dédiée avant de traiter des enregistrements sensibles. Essayez ensuite un clip sans enjeu hors ligne et observez ce qui va au bout. Repérez où sont écrits le fichier original, les données temporaires et l’export. Le moteur local détermine où se fait l’inférence, tandis que le reste du logiciel détermine le parcours complet des données.
Essayez un projet sur la machine que vous utilisez vraiment
- Choisissez deux entrées courtes et partageables. Enregistrez deux personnes pendant 30 à 60 secondes avec un peu de chevauchement et un nom de fonction inventé. Écrivez une courte narration qui reprend ce nom et un nombre délicat. Gardez les mêmes entrées pour voir l’effet d’un réglage modifié.
- Fixez la version du moteur et des modèles. Choisissez une compilation v0.9.0 pour votre système. Notez la source des modèles, les noms de fichiers et la quantification. Pour Nemotron servi via
llama-server, l’intégration documente--reasoning off, car le modèle par défaut de dialogue peut produire son raisonnement sans transcription. La commande multimodale n’a pas besoin de ce réglage selon l’intégration. Essayez la voie que vous comptez exploiter. Notes d’intégration de Nemotron - Mesurez un démarrage à froid, puis répétez. Relevez le temps du lancement au résultat au premier essai, puis le temps de traitement une fois le modèle chargé. Divisez le temps de transcription par la durée audio pour voir comment l’attente évoluera sur un enregistrement plus long. Notez le pic de mémoire et la réactivité du montage. Pour une voix off, le délai entre la modification d’une phrase et l’écoute de la nouvelle prise peut compter davantage.
- Comparez les erreurs selon ce qu’elles coûtent. Marquez un terme oublié, un nombre faux, une voix inversée et une phrase à recaler. Comptez le temps de correction dans le délai de fin. Pour la voix off, vérifiez les noms, les nombres, les pauses et la place de l’audio au montage. Comparez le fichier corrigé aussi bien que le premier résultat.
- Définissez la transmission avant l’automatisation. Décidez qui vérifie le texte, où les sous-titres sont calés et comment les voix off validées sont identifiées. Essayez un second clip après la réussite du premier. Si un fichier échoue, gardez l’entrée et rendez l’échec visible dans la file pour qu’une personne reprenne le cas sans relancer tout le lot.
Vous pouvez noter la configuration, le temps de traitement, le temps de correction et la validation dans quatre colonnes. Ajoutez le motif du rejet quand un résultat est écarté. Après plusieurs essais, le système local peut se révéler excellent pour des retouches vocales répétées, tandis que les entretiens collectifs bruyants demandent une autre chaîne. C’est un résultat exploitable. Utilisez chaque composant là où il fait gagner du temps et gardez la trace des cas où le recours fonctionne mieux.
Si votre chaîne de transcription marche déjà bien, comparez-la à la nouvelle sur le même enregistrement avec les mêmes critères. Vous pouvez déplacer seulement la partie la plus simple, comme le rendu sur la station de travail d’une voix provisoire peu sensible. À l’inverse, une chaîne fiable de sous-titres pourrait bénéficier plus tard d’une intégration locale commune, si vous avez une raison de centraliser le service des modèles et si la nouvelle implémentation a démontré qu’elle respecte vos exigences éditoriales.
Là où la version est la plus utile
Commencez par une tâche répétitive. Une équipe de tutoriels peut transcrire une première prise avant que la vidéo quitte la machine de montage et produire une narration provisoire pour vérifier le rythme. Une personne qui mène une recherche peut tirer une transcription modifiable d’un enregistrement qu’elle contrôle, corriger les locuteurs et conserver l’audio comme source. Une petite équipe de développement peut tester les deux chemins derrière une interface interne qui montre le modèle choisi, le fichier produit et toute erreur.
Le principal intérêt pourrait être de réduire les passages entre outils spécialisés en conservant des contrôles distincts. Le modèle de transcription doit reconnaître les mots et distinguer les voix. Le modèle de synthèse doit prononcer le texte. La personne au montage décide quand le résultat est prêt. Ces tâches peuvent désormais partager une boîte à outils d’inférence et éventuellement une machine déjà disponible.
Pour retrouver un enregistrement terminé avec sa transcription et vos notes, lancez un import dans Telli.sh.