¿Puede tu propio ordenador encargarse de los subtítulos y la voz en off?
llama.cpp 0.9.0 incorpora tres funciones de voz. Prueba la transcripción sin conexión, las etiquetas de hablante y la narración con voces predefinidas en tu equipo.
Tienes el primer montaje de una demostración, una grabación de dos compañeros que hablan sobre el vídeo y tres frases de narración que hay que repetir. Enviar el audio a un servicio de transcripción y el guion a uno de voz es lo habitual. Hacer ambos trabajos en el ordenador de edición podría agilizar las revisiones, sobre todo si el material original debe quedarse en ese equipo. A cambio, quien edita se encarga de la cola, los archivos de los modelos y los controles de calidad.
El 4 de noviembre de 2026, el proyecto de inferencia de código abierto llama.cpp publicó la versión 0.9.0. Añade transcripción sin conexión con NVIDIA Nemotron 3.5 Transcribe, síntesis de voz con Chatterbox y voces predefinidas de Pocket TTS que se pueden usar sin una grabación de referencia. Las notas describen transcripción en 40 idiomas, contexto en la instrucción y atribución de hablantes. Cada incorporación tiene su sitio en un mismo proceso de edición y exige cosas distintas al ordenador y a quien revise el resultado. Notas de llama.cpp v0.9.0
Si conociste llama.cpp al probar un chatbot local, el nombre puede sugerir que este lanzamiento tiene un alcance más estrecho. Es un entorno de inferencia para arquitecturas de modelos compatibles, con herramientas para cargar archivos de modelos y atender peticiones. La actualización amplía lo que se puede ejecutar con esas herramientas. La aplicación que las integra sigue decidiendo dónde guarda el audio, cómo presenta las correcciones y cuándo se puede publicar un archivo. Proyecto llama.cpp
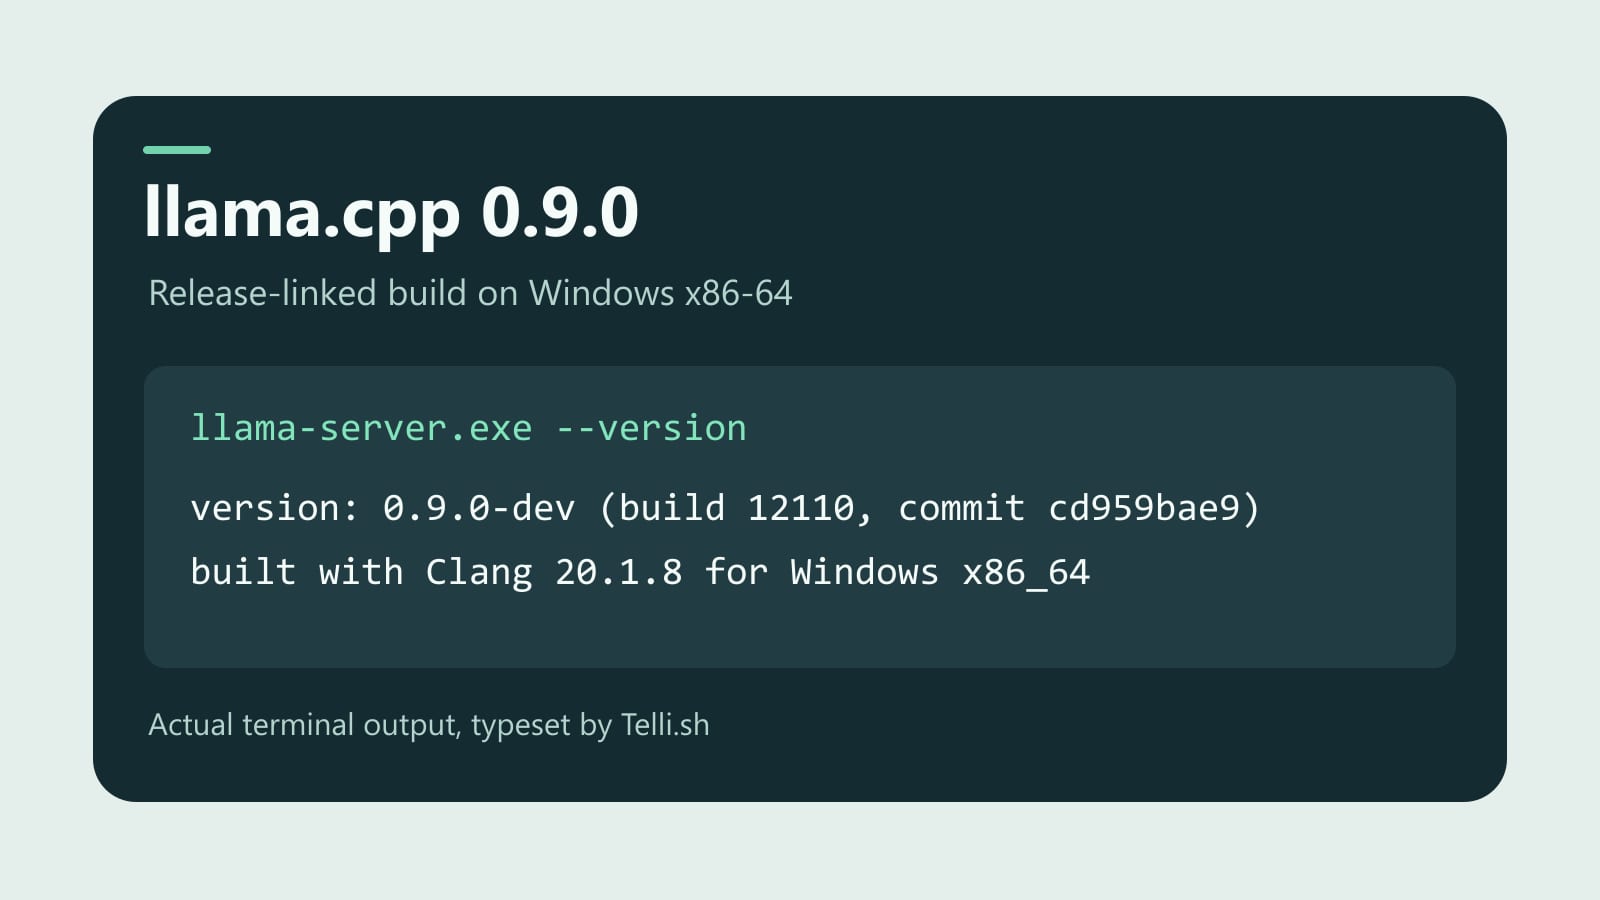
Telli.sh ejecutó la compilación oficial de Windows enlazada en el lanzamiento y maquetó la salida real del comando de versión. Así queda identificada la compilación. Compilación b12110 enlazada en el lanzamiento
Los subtítulos empiezan por una transcripción editable
Imagina que alguien graba un recorrido de diez minutos por un producto aún sin anunciar. Otro compañero le interrumpe para corregir el nombre de una función. Quieres una transcripción que puedas buscar, una separación aproximada de quién dijo cada cosa y, al final, subtítulos que aparezcan en el fotograma correcto. Son tres resultados distintos. El primero es un texto, el segundo es una anotación editorial y el tercero necesita tiempos.
La integración de Nemotron permite empezar con los dos primeros. La implementación incorporada admite transcripción sin conexión con contexto opcional y atribución de hablantes. Puede mantener información sobre los hablantes entre distintas ventanas de procesamiento de una misma grabación. Las notas indican que las marcas de tiempo por palabra y la transcripción en directo quedaron fuera de esta integración. En la práctica, transcribe la grabación terminada, corrige el texto y alinea los tiempos en una fase aparte de edición o subtitulado si la entrega lo exige. Integración de Nemotron 3.5 Transcribe
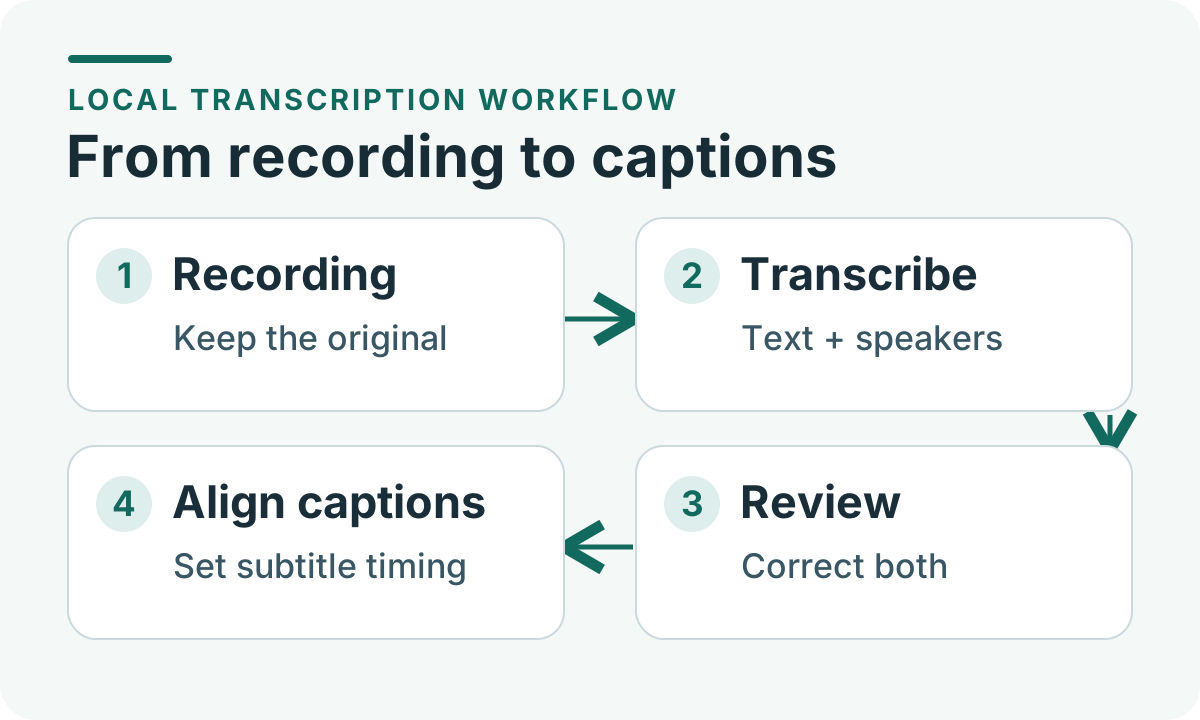
Ilustración de Telli.sh. La transcripción local te da un texto editable. Los subtítulos se sincronizan después de comprobar el texto y las etiquetas de hablante.
El contexto resulta interesante para equipos que usan palabras poco habituales. En una grabación sobre una función ficticia llamada Pine Relay, prueba una lista corta de nombres y siglas previstos. Procesa después el mismo fragmento sin la lista. Comprueba si el contexto corrige el nombre, si lo introduce donde nadie lo dijo y si altera números u otras palabras. Mantén una lista lo bastante breve para explicar qué término cambió el resultado. Un asistente de transcripción debe facilitar la revisión de palabras desconocidas sin dar al glosario capacidad para reescribir la grabación.
Comprueba por separado la atribución de hablantes. En una entrevista limpia puede resultar fácil distinguir dos voces. Añade una tercera persona por altavoz y varias frases solapadas y el esfuerzo de corrección puede cambiar. Escucha las transiciones y las intervenciones más largas. Una transcripción puede acertar todas las palabras y aun así atribuir una decisión importante a otra persona. Mantén separadas las etiquetas del modelo y los nombres reales hasta que alguien que conozca la grabación los confirme.
Para los subtítulos, reproduce el archivo exportado junto al vídeo. Una frase que se lee bien en un documento puede desbordar la pantalla, aparecer antes de una revelación importante o quedarse cuando ya habla la siguiente persona. Prueba un corte brusco y una interrupción breve al principio del clip. Si necesitas un archivo de subtítulos con tiempos fiables, incluye la alineación y la corrección en el cálculo del trabajo. Una primera transcripción limpia resulta útil aunque el montaje final tenga que hacerse en otra herramienta.
Una voz predefinida facilita la primera prueba
Piensa ahora en la otra parte del montaje. Cambia el título de una función y hay que sustituir una frase de voz en off en seis grabaciones de pantalla. Una vez preparados el equipo y el modelo, generar otra toma en local permite probar a bajo coste. Las partes difíciles son la coherencia y la pronunciación. El audio nuevo debe encajar con los fragmentos de alrededor, pronunciar bien el nombre del producto y ajustarse al plano.
La versión 0.9.0 incorpora Chatterbox a los modelos de síntesis de voz compatibles con llama.cpp. La revisión del proyecto recoge pruebas con CUDA de Chatterbox Turbo y Multilingual V3. La persona que revisó la integración probó voces predeterminadas y generación con referencia y adjuntó muestras. Son pruebas de la integración en una configuración concreta. Para usarla en producción, comprueba si la voz y el idioma elegidos se mantienen con el texto y el equipo que vas a utilizar. Compatibilidad de Chatterbox y ejemplos de audio de la revisión
Pocket TTS ofrece otra opción. Un modelo compatible puede exponer los nombres de las voces integradas en voices dentro de la respuesta del servidor a GET /props. El cliente puede pasar uno de los nombres disponibles a la ruta de síntesis. Así, un script o una aplicación pequeña pueden rellenar un selector a partir del modelo cargado. La primera prueba puede usar una voz predefinida sin conseguir y guardar una grabación de alguien para imitarle. Conserva el modelo y el nombre de la voz elegida junto a la exportación para partir de la misma configuración en una edición futura. Voces predefinidas de Pocket TTS
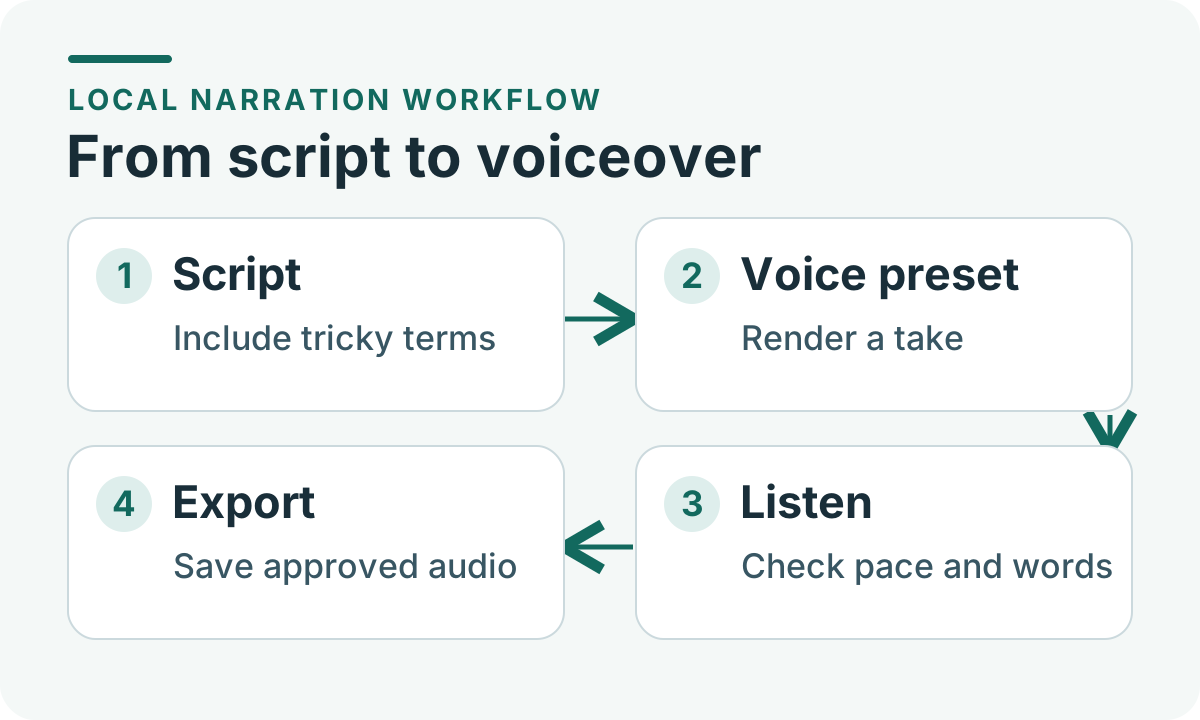
Ilustración de Telli.sh. Revisa el audio antes de exportarlo. La voz seleccionada indica qué se pidió. La escucha revela qué salió.
Empieza con un guion breve que incluya términos ausentes de una demostración típica. Añade un código de producto, un formato de dirección o un número con unidad, además de una frase cuyo tono importe. Prueba tres frases por separado y luego genera el párrafo completo. Una voz puede sonar coherente en frases aisladas y acelerar justo en la palabra importante de una toma larga. Pide a alguien que conozca el idioma del público que escuche primero sin el guion y compare luego lo que oyó con el texto previsto.
Guarda el audio final por separado del guion y de las grabaciones originales. Si descubres más tarde que se pronunció mal un número, podrás rehacer esa toma sin perder el montaje inicial. Si ya tienes a un locutor autorizado, etiqueta con claridad sus grabaciones y las alternativas generadas para que ninguna sustituya a la otra sin que se note. Una voz predefinida es una opción sencilla cuando el proyecto solo necesita una narración inteligible y coherente.
La versión del entorno es una parte de la configuración
El lanzamiento puede quitarte un motivo para cambiar de entorno si tu equipo ya usa llama.cpp. Sigues necesitando una compilación compatible con el ordenador de destino, los archivos del modelo y sus complementos, como el proyector multimodal que señala la implementación de Nemotron. Los pesos se descargan aparte y tienen sus propias condiciones. Consulta la documentación del entorno y del modelo antes de empaquetar cualquier parte para otro equipo o cliente. Archivos del lanzamiento y notas de configuración de Nemotron
Mide la memoria durante el trabajo, una vez cargado el modelo. El tamaño de archivo indica cuánto espacio ocupa en disco. La ejecución necesita también espacio para los cálculos, los búferes del motor y los resultados intermedios. Un sobremesa capaz de iniciar una transcripción puede ralentizar el editor si ambos usan la GPU. Un portátil que funciona una vez puede tardar más en la cuarta cuando influyen la temperatura y las tareas en segundo plano. Registra el pico de RAM y, si procede, de memoria gráfica, con el editor abierto tal como se usará de verdad.
Quienes mantienen el proyecto compartieron en la solicitud de cambios de Nemotron pruebas de transcripción con conjuntos de voz limpia y reuniones, una configuración de cuantización especificada y una RTX PRO 6000 Blackwell en el entorno de pruebas. Los resultados explican cómo se verificó la integración. Para decidir qué comprar o desplegar, mide tus grabaciones en el equipo previsto. Hasta en el mismo equipo, cambiar la precisión o el idioma o procesar más voz solapada puede alterar el equilibrio entre tiempo de ejecución y esfuerzo de revisión. Validación y configuración de Nemotron
Compara versiones sin mezclar cambios. La b12144 del 6 de noviembre es una versión preliminar aparte, con un cambio de disposición de datos de mezcla de expertos en CUDA. Para valorar las incorporaciones de audio, empieza con el lanzamiento numerado del 4 de noviembre y mantén los archivos y ajustes del modelo. Si luego evalúas la versión preliminar, regístrala como una prueba separada. Así podrás saber si el trabajo cambió por el modelo de audio, el motor de inferencia o la aplicación que los utiliza. Notas de la versión preliminar del 6 de noviembre
En un proceso local también conviene precisar qué se queda en el ordenador. Aunque el editor use un servidor local, otra aplicación puede enviar registros, sincronizar una carpeta de salida o descargar una dependencia. Antes de usar grabaciones sensibles, consigue los binarios y los pesos en un equipo de pruebas o en una fase de preparación prevista. Después usa un fragmento inocuo sin conexión para ver qué partes se completan de verdad. Comprueba dónde se escriben el original, los temporales y la exportación. El entorno local delimita la inferencia. El resto de la aplicación determina el recorrido completo de los datos.
Prueba un proyecto en el ordenador que usas de verdad
- Elige dos entradas breves que se puedan compartir. Graba de 30 a 60 segundos con dos personas, algo de solapamiento y un nombre ficticio de función. Escribe una narración corta con el mismo nombre y un número difícil. Mantén las entradas fijas para ver qué efecto tiene cambiar un ajuste.
- Fija el entorno y los modelos. Elige el código fuente de v0.9.0 o la compilación b12110 enlazada para tu equipo. Registra la fuente, los nombres de archivo y la cuantización. Para Nemotron con
llama-server, la integración documenta--reasoning offporque la plantilla predeterminada puede devolver razonamiento sin transcripción. Según las notas, la herramienta multimodal de línea de comandos no requiere ese ajuste. Prueba la misma vía que piensas usar. Notas de integración de Nemotron - Mide una ejecución en frío y repítela. Registra el tiempo desde el inicio hasta el resultado y el tiempo una vez cargado el modelo. En transcripción, divide el tiempo de procesamiento entre la duración del audio para ver si la espera será razonable con grabaciones más largas. Apunta el pico de memoria y si el editor sigue respondiendo. Para la voz en off puede importar más cuánto tardas desde cambiar una frase hasta escuchar la nueva toma.
- Compara los errores según lo que cuestan. Marca un término omitido, un número incorrecto, un cambio de hablante y una frase que necesite resincronizarse. Incluye la corrección en el tiempo total. Para la voz en off, comprueba los nombres, números, pausas y encaje con el montaje. La comparación incluye el archivo corregido además del primero que salió.
- Define el traspaso antes de automatizar. Decide quién revisa la transcripción, dónde se sincronizan los subtítulos y cómo se marcan las narraciones aprobadas. Prueba un segundo clip después de que pase el primero. Si falla un archivo, conserva el original y muestra el error en la cola para que alguien pueda retomarlo sin repetir el lote.
Puedes registrar estas comprobaciones en una hoja con cuatro columnas: configuración, tiempo de procesamiento, tiempo de corrección y aceptación. Anota por qué se rechazó un archivo. Tras varias pruebas, quizá el entorno local sea excelente para repetir frases de narración, pero las entrevistas ruidosas en grupo sigan necesitando otro proceso. Es un resultado útil. Usa cada componente donde ahorre tiempo y documenta dónde funciona mejor la vía alternativa.
Si ya tienes una transcripción que funciona bien, compárala con la misma grabación y los mismos criterios de aceptación. Puedes migrar solo la parte sencilla, como generar narraciones provisionales de bajo riesgo en el ordenador de trabajo. Un flujo de subtitulado fiable puede beneficiarse después de una integración local común, cuando haya motivo para unificar el servicio de modelos y la implementación nueva haya demostrado que cumple los criterios editoriales anteriores.
Dónde aporta más el lanzamiento
El mejor primer caso es un trabajo que ya repites. Un equipo de tutoriales puede transcribir una primera toma antes de que el vídeo salga del ordenador de edición y generar narración provisional para comprobar el ritmo. Un investigador puede hacer una transcripción editable de una grabación propia, corregir las etiquetas de hablante y conservar el audio como fuente. Un equipo pequeño de desarrollo puede probar ambas vías con una interfaz interna si muestra el modelo, el archivo resultante y cualquier error.
El lanzamiento podría importar sobre todo porque reduce los traspasos entre herramientas especializadas y conserva sus controles de calidad por separado. El modelo de transcripción sigue teniendo que reconocer palabras y distinguir voces. El de síntesis tiene que pronunciar el guion. Quien edita decide cuándo está listo. Ahora esos trabajos pueden compartir un entorno de inferencia y, quizá, un ordenador que ya utilizas.
Si quieres volver a una grabación terminada junto a su transcripción y sus notas, empieza a subirla a Telli.sh.