Liquid LFM3 stawia lepsze pytanie o lokalną AI: który mały model wykona zadanie?
LFM3 rozwija wspólną podstawę w modele tekstowe, wizyjne, audio, omni i decyzyjne. Jak wybrać specjalistę, oszacować rzeczywistą pamięć i przygotować użyteczną lokalną ocenę.
Lokalny asystent odczytujący paragon niekoniecznie potrzebuje tego samego modelu co asystent odpowiadający na pytanie głosowe. Program wybierający spośród trzech dozwolonych działań ma jeszcze inne zadanie. Traktowanie ich jako jednego problemu może niepotrzebnie skomplikować małą aplikację.
Liquid AI zapowiedziało LFM3 27 października 2026 r.: sześć modeli klasy około 2B, rozwijających wspólną podstawę 1.7B i obejmujących tekst, obraz, dźwięk, omni oraz dwa warianty decyzyjne. Firma udostępnia otwarte wagi, Playground i dostęp przez API. Ogłoszenie LFM3.
Interesująca decyzja dotyczy tego, która rola jest potrzebna w twojej aplikacji. Ten przewodnik wyjaśnia rodzinę przez praktyczne wybory, oddziela niewielki plik wag od budżetu pamięci działającego programu i proponuje pierwszą ocenę pokazującą, czy specjalista sprawdza się na twoim sprzęcie.
 Raspberry Pi 5 jako ilustracja przetwarzania na brzegu sieci, a nie naszego testu LFM3. Obraz: RetroEditor, CC BY 4.0; zmniejszony z dodanymi marginesami. Źródło obrazu · Licencja i informacje o obrazie. Oficjalna informacja o produkcie.

Wybór rodziny specjalistów zaczyna się od potrzebnego wyniku
Najszybsza droga do złego wyboru prowadzi przez najdłuższą listę obsługiwanych wejść. Zacznij od wyniku, który aplikacja musi wytworzyć. Akapit, transkrypcja, ustrukturyzowane pole i wybór spośród dozwolonych działań to różne kontrakty, nawet jeśli ten sam materiał źródłowy może pomóc uzyskać wszystkie cztery.
Ogłoszenie Liquid z 27 października wyróżnia cztery gałęzie modalności i dwie decyzyjne: LFM3-1.7B, LFM3-VL-2B, LFM3-Audio-2B, LFM3-Omni-2B, d1-2B i d1-Omni-2B. Poniższa tabela przekłada te role na pytania o dobór do aplikacji. To wskazówki dopasowania, nie niezależny ranking jakości. Opis rodziny.
| Rola modelu | Kandydat z rodziny LFM3 | Pytanie o twoją aplikację |
|---|---|---|
| Interakcja tekstowa | LFM3-1.7B | Czy zadanie wymaga odpowiedzi językowej na podstawie tekstu? |
| Rozumienie obrazu i tekstu | LFM3-VL-2B | Czy odpowiedź zależy od czegoś widocznego? |
| Interakcja z mową i dźwiękiem | LFM3-Audio-2B | Czy aplikacja musi słuchać lub mówić? |
| Łączna interakcja audiowizualna | LFM3-Omni-2B | Czy musi wspólnie interpretować obraz i dźwięk? |
| Ustrukturyzowane decyzje na podstawie tekstu i obrazów | d1-2B | Czy wynik da się wyrazić jako decyzje o określonym typie? |
| Ustrukturyzowane decyzje uwzględniające audio | d1-Omni-2B | Czy ograniczona decyzja musi też korzystać z dźwięku? |
Naszym zdaniem użyteczną jednostką lokalnej AI jest najmniejsze kompletne zadanie. Model powinien mieć możliwości wystarczające do spełnienia jasnego kontraktu aplikacji oraz sposób obsługi niepewności. Wszystko ponad to wiąże się z kosztem wykonania, testowania i integracji, który musi się uzasadnić.
Wyobraź sobie rodzinę jako zwijany zestaw narzędzi. Do niektórych prac warto zabrać wszystkie, ale przy powtarzalnej regulacji łatwiej wybrać właściwe. Analogia dotyczy projektowania aplikacji, nie twierdzenia, że jeden model zawsze przewyższa drugi.
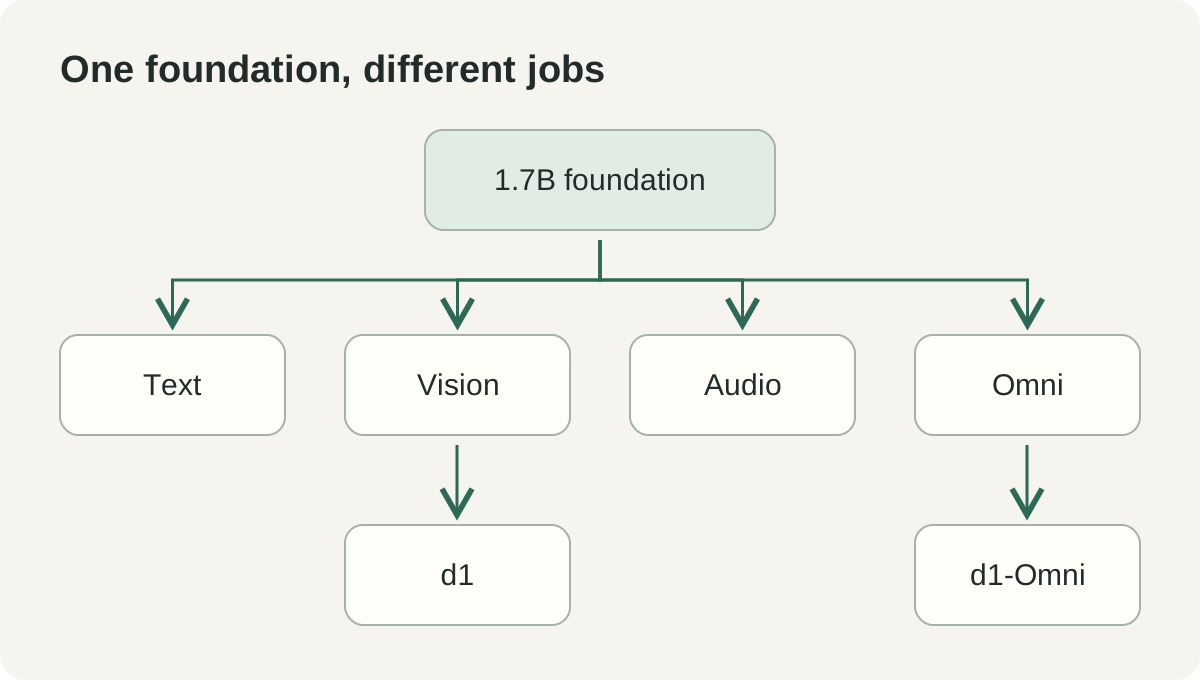 Autorski schemat ról wymienionych w ogłoszeniu LFM3 firmy Liquid AI. Grupuje wybory aplikacyjne i pomija szczegóły implementacji wewnętrznej.
Otwarte wagi dają wybór wdrożenia, ale wymagają przeczytania licencji
Pobranie wag daje deweloperowi konkretny materiał do pakowania, oceny i dostosowania. Może umożliwić lokalne wdrożenie, w którym droga danych aplikacji pozostaje pod jego kontrolą. To przydatne, ale sam dostępny plik nie rozstrzyga warunków komercyjnych.
Katalog modeli Liquid, sprawdzony 2 listopada, opisuje bezpłatne wykorzystanie komercyjne, dopóki firma nie przekroczy 10 milionów USD rocznego przychodu. Karta LFM3-1.7B wskazuje LFM Open License v1.0. Przeczytaj licencję konkretnego punktu kontrolnego i aktualną stronę licencjonowania w odniesieniu do planowanego wdrożenia, dystrybucji i sytuacji przychodowej.
To praktyczny etap zakupowy. Mały prototyp wewnętrzny, pobierana aplikacja konsumencka i usługa dla innych firm mogą rodzić różne pytania o dystrybucję oraz obowiązki. Zapisz identyfikator, rewizję i licencję modelu razem z aplikacją, aby dało się odtworzyć decyzję, gdy projekt urośnie.
Oprogramowanie wykonawcze i wagi modelu mają też oddzielne wersje. Model może być dostępny, podczas gdy środowisko na urządzeniu nie ma jeszcze zgodnej obsługi. Sprawdź udokumentowane połączenie, zamiast zakładać, że każda aplikacja ładująca wcześniejszą rodzinę poprawnie załaduje nową.
W zespole taki zapis powinien zawierać również polecenie lub szablon oczekiwany przez dany punkt kontrolny. Nawet zgodny program ładujący może dawać słabe wyniki, gdy wejście ma niewłaściwy format. Powtarzalność zaczyna się od wiedzy, co faktycznie załadowano i jak aplikacja się z tym komunikowała.
Około 1 GB wag to początek budżetu pamięci
W materiałach premierowych z 27 października Liquid określa rozmiar 4-bitowej wersji tekstowej na około 1 GB. Karta modelu tekstowego podaje 1,73 miliarda parametrów i kontekst 256K tokenów łącznie dla wejścia i wyjścia. To specyfikacje modelu; szczytowe zużycie pamięci aplikacji zależy też od obciążenia i środowiska wykonawczego.
Plik wag to tylko część działającego procesu. Środowisko potrzebuje pamięci roboczej, przetwarzanie kontekstu wymaga stanu, a wejścia multimedialne mogą potrzebować dodatkowych buforów i enkoderów. Inne programy na urządzeniu konkurują o te same zasoby. Nagłówek o rozmiarze wag nie mówi, czy cała aplikacja będzie działać sprawnie pod obciążeniem.
Przykładowy budżet powinien więc zaczynać się od pomiaru pamięci procesu. Zapisz stan bezczynności, szczyt podczas reprezentatywnego żądania oraz stan po wielu żądaniach. Testuj długość kontekstu i rozmiary wejść rzeczywiście dostarczanych przez użytkowników, a nie maleńkie polecenie wybrane dlatego, że łatwo się mieści.
Ta sama dyscyplina dotyczy czasu. Uruchomienie, przetworzenie polecenia i generowanie odpowiedzi to osobne okresy oczekiwania. Model szybko generujący tokeny po długim opóźnieniu może wydawać się wolny w aplikacji interaktywnej; zadanie wsadowe może bardziej interesować liczba ukończonych elementów na godzinę. Dobierz miarę do interakcji.
W funkcji audio uwzględnij całą drogę od wejścia do użytecznego wyniku. W funkcji obrazowej uwzględnij obsługę obrazu, a w decyzyjnej walidację i przekazanie działania. To wymagania oceny ustalane przez ciebie, a nie wyniki wydajności podane przy premierze.
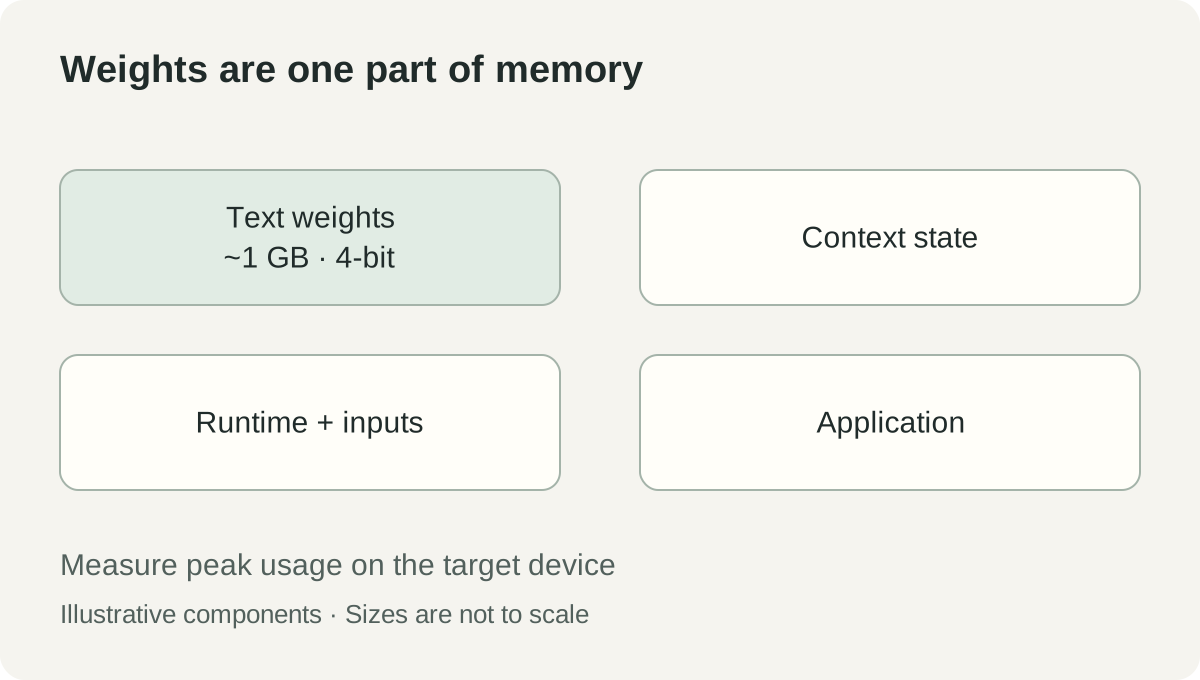 Autorski schemat budżetu pamięci. Szerokości segmentów są ilustracyjne i nie przedstawiają zmierzonych proporcji; około 1 GB dotyczy opublikowanego przez Liquid rozmiaru 4-bitowego modelu tekstowego, a nie całej pamięci aplikacji. Źródło.
Trzy przykładowe aplikacje ujawniają różne kompromisy
Pomocnik dokumentowy może oddzielić odczyt od decyzji
Wyobraźmy sobie małą aplikację biznesową otrzymującą zdjęcia paragonów. Jednym zadaniem jest odczyt widocznego sprzedawcy, daty i kwoty. Innym jest decyzja, czy dokument jest wystarczająco kompletny do oceny przez człowieka. Wyniki wymagają oddzielnej walidacji, nawet gdy jeden model uczestniczy w obu.
Ścieżka wizyjno-językowa mogłaby wspierać pytania o obraz, a ścieżka decyzyjna — ograniczoną kontrolę kompletności. Aplikacja powinna zachować obraz źródłowy i odróżniać wydobyte pola od zaakceptowanych danych księgowych. Brakująca data powinna pozostać brakująca, dopóki ktoś tego nie rozstrzygnie.
Zbuduj przykładowy zestaw oceny z wyraźnymi i rozmazanymi obrazami, nietypowymi układami oraz paragonami w rzeczywistych językach pracy. Mierz błędy pól i nakład kontroli. Wysoki ogólny wskaźnik sukcesu może ukrywać powtarzalny błąd w polu najważniejszym dla firmy.
Użytecznym wynikiem produktu jest krótsza, jaśniejsza kolejka do sprawdzenia. Eleganckie wyjaśnienie modelu ma mniejsze znaczenie niż możliwość obejrzenia źródła i poprawienia pól. Ten priorytet pomaga wybrać między swobodną odpowiedzią językową a bardziej ograniczonym interfejsem decyzyjnym.
Interfejs głosowy może zacząć od wąskiego zbioru dozwolonych działań
Rozważmy przykładowego bezdotykowego asystenta lokalnej aplikacji. Użytkownik może poprosić o znalezienie elementu, odczytanie jego statusu lub przygotowanie propozycji działania. Audio pomaga, gdy mówienie jest łatwiejsze od pisania, ale aplikacja nadal musi wiedzieć, co wolno zmienić na podstawie żądania.
Zacznij od niewielkiego słownika działań i widocznej ścieżki potwierdzenia. Żądanie znalezienia rekordu może na przykład wykonać się od razu w dozwolonych danych, a żądanie zmiany rekordu może przedstawiać propozycję do oceny. Polityka należy do aplikacji, nie do przypadkowego sformułowania wygenerowanego przez model.
Testuj rzeczywiste warunki akustyczne. Rozmowy w tle, krótkie wypowiedzi i podobne nazwy mogą wywołać inne błędy niż czyste nagranie zdania. Uwzględnij przypadki, w których poprawne jest ponowne zapytanie użytkownika. Płynna odpowiedź głosowa jest mniej cenna niż poprawna interakcja, którą da się naprawić po błędzie.
Model omni staje się istotny, gdy żądanie zależy zarówno od obrazu, jak i wypowiedzianych słów. Jeśli każde zadanie korzysta tylko z mowy, dodanie obrazu wymaga uzasadnienia. Właśnie tu rodzina modeli może pomóc zachować proporcje funkcji do zadania.
Lokalne narzędzie wsparcia może kierować pracę, zachowując wyjście awaryjne
Przykładowa aplikacja wsparcia mogłaby wybierać jedną z trzech kolejek na podstawie zgłoszenia i zrzutu ekranu. Ograniczony wynik decyzyjny może lepiej pasować do tego zadania niż długa odpowiedź wymagająca interpretacji przez aplikację. Warto pytać, czy kierowanie jest wystarczająco niezawodne przy akceptowalnym poziomie ręcznej oceny.
Zachowaj jawny wynik „wymaga sprawdzenia”. Testuj zgłoszenia niepasujące do żadnej kolejki, sprzeczne zrzuty ekranu i przypadki bez wystarczającego kontekstu. Aplikacja nie powinna zmuszać modelu do wymyślenia poprawnej trasy tylko dlatego, że wymaga jej schemat.
Porównaj model z prostym punktem odniesienia, np. obecnymi regułami i kierowaniem przez ludzi. Jeśli punkt odniesienia już niezawodnie obsługuje kategorię, model musi poprawić inną część procesu. Nowość nie jest kryterium odbioru.
Dla każdego błędu zachowaj dość dozwolonego kontekstu, by zrozumieć przyczynę. Oddziel problemy wejścia, niejednoznaczne kategorie i błędy modelu. Wtedy wiadomo, czy ulepszyć model, zmienić definicje kolejek, czy poprosić o lepszy materiał źródłowy.
Tabele benchmarków to punkt wyjścia dla własnego obciążenia
Oficjalna karta LFM3-1.7B, sprawdzona 2 listopada, zaleca wyszukiwanie lub pobieranie informacji przy zadaniach wymagających dużej wiedzy i przestrzega przed agentowym programowaniem oraz złożonym rozumowaniem wieloetapowym przy tym rozmiarze. To przydatne wskazówki umiejscowienia modelu w większym systemie, nawet gdy benchmarki dostawcy pokazują postęp.
Benchmark odpowiada na konkretne pytanie w określonej konfiguracji. Aplikacja dodaje własne dane, narzędzia, rozkład języków i koszty błędów. Model może poprawić publiczną średnią, nadal wymagając starannej pracy nad kilkoma kategoriami spotykanymi przez twoich użytkowników każdego dnia.
W pilotażu rozdziel trzy porównania. Najpierw porównaj jakość zadania z obecnym procesem. Potem pełny koszt zasobów na docelowym urządzeniu. Wreszcie nakład potrzebny do odzyskania sprawności po błędzie. Każde porównanie może wskazać innego zwycięzcę.
Przykładowo model ogólny w chmurze może być ścieżką eskalacji, gdy lokalny specjalista odmówi odpowiedzi. Taki układ wymaga jawnej polityki danych i doświadczenia użytkownika. Lokalność to wybór wdrożenia, który weryfikuje się w całej aplikacji, włącznie z logowaniem i żądaniami awaryjnymi.
Dostrajanie powinno wynikać z wykazanej luki. Jeśli błędy wynikają z brakujących źródeł lub niejasnych definicji wyników, dodatkowy trening może utrwalić niewłaściwe zadanie. Zdefiniuj kontrakt i zbadaj błędy, zanim uznasz dostosowanie za kolejny przydatny krok.
Pierwszy pilotaż powinien mieścić się na jednej stronie decyzji
Oficjalna karta modelu tekstowego odsyła do formatów punktów kontrolnych i instrukcji środowiska wykonawczego. Zacznij tam, dobierając dokładne połączenie modelu i środowiska; do wstępnego sprawdzenia interakcji możesz użyć oficjalnego Playground, jeśli pozwala na to polityka danych. Żadna droga nie zastępuje testu wdrożenia, które zamierzasz dostarczyć.
- Zapisz kontrakt wejścia i wyjścia. Określ dozwolony materiał, oczekiwany wynik i jawną ścieżkę oceny. Wybierz jedno zadanie zamiast ogólnej osobowości asystenta.
- Wybierz model i rewizję. Dopasuj modalność i rolę wyniku, a potem zapisz punkt kontrolny, licencję i zgodne środowisko. Przeczytaj ograniczenia danego modelu.
- Stwórz reprezentatywny zestaw oceny. Uwzględnij zwykłe i trudne przypadki, nieobsługiwane żądania oraz rzeczywiste języki użytkowników. Materiał kontrolny oddziel od danych do dostosowania.
- Uruchom udokumentowany szybki start w izolowanym środowisku. Postępuj według aktualnych instrukcji zależności i formatowania z karty modelu. Przed porównaniem wyników potwierdź zwróconą tożsamość modelu.
- Zmierz całą drogę w aplikacji. Zapisuj poprawność, udział ręcznej oceny, opóźnienie i szczyt pamięci dla realistycznych rozmiarów wejścia. Obok liczb zapisz sprzęt i konfigurację wykonania.
- Przećwicz ścieżkę niepewności. Potwierdź, że brak informacji, nieprawidłowy wynik i awaria wykonania prowadzą do zrozumiałego stanu kontroli lub ponowienia.
- Zdecyduj, co specjalizować dalej. Na podstawie powracających kategorii błędów wybierz lepsze wejście, jaśniejsze reguły, wyszukiwanie, dostrajanie lub inny model.
Po pierwszym podejściu wniosek może być prosty: ten kandydat pomaga w tym zadaniu na tym urządzeniu, przy tych warunkach kontroli. Wąski, powtarzalny wniosek jest cenniejszy od ogólnego twierdzenia, że lokalna AI nadaje się już do wszystkiego.
Mały model zasługuje na miejsce, gdy wykonuje określone zadanie
LFM3 poszerza wybór dla programistów chcących umieścić tekst, wzrok, dźwięk lub ograniczone decyzje blisko aplikacji. Praktyczne znaczenie polega na możliwości wyboru ról i oceny ich jako elementów produktu.
Następny krok to doprecyzowanie jednego zadania tak, by dało się mierzyć jakość, pamięć i odzyskiwanie po błędach. Specjalista staje się przydatny, gdy cała aplikacja może polegać na jego kontrakcie i wie, co zrobić, kiedy nie potrafi odpowiedzieć.
Źródła
- Liquid AI: przedstawiamy LFM3, 27 października 2026 r.; sprawdzono 2 listopada 2026 r.
- Katalog modeli Liquid AI oraz ceny i licencjonowanie, sprawdzono 2 listopada 2026 r.
- Oficjalna karta modelu LFM3-1.7B, sprawdzono 2 listopada 2026 r.
- Oficjalna karta modelu d1-2B, sprawdzono 2 listopada 2026 r.
Zachowaj materiały stojące za decyzją
Telli.sh to jedna z możliwości przechowywania materiałów źródłowych, do których masz uprawnienia, wraz z przejrzanymi notatkami. Utwórz przestrzeń na notatki.