Liquid LFM3 pone una domanda migliore sull'IA locale: quale piccolo modello svolge il compito?
LFM3 dirama una base comune in modelli per testo, visione, audio, interazione omni e decisioni. Come scegliere uno specialista, stimare la memoria effettiva e costruire una valutazione locale utile.
Un assistente locale che legge uno scontrino non ha necessariamente bisogno dello stesso modello di uno che risponde a una domanda pronunciata a voce. Un programma che sceglie fra tre azioni consentite svolge ancora un altro compito. Trattarli come un unico problema può complicare inutilmente una piccola applicazione.
Liquid AI ha annunciato LFM3 il 27 ottobre 2026: sei modelli della classe di circa 2B, derivati da una base comune da 1,7B, per testo, visione, audio, interazione omni e due varianti decisionali. L'azienda offre pesi aperti, un Playground e accesso tramite API. Annuncio di LFM3.
La decisione interessante riguarda il ruolo da assegnare al modello nell'applicazione. Questa guida spiega la famiglia attraverso scelte pratiche, distingue un file di pesi compatto da un bilancio di memoria operativo e propone una prima valutazione per capire se uno specialista sia utile sul proprio hardware.
 Hardware Raspberry Pi 5; contesto illustrativo di elaborazione periferica, non un nostro test di LFM3. Immagine: RetroEditor, CC BY 4.0; ridimensionata con margini. Fonte dell'immagine · Licenza e note sull'immagine. Riferimento ufficiale del prodotto.

Una famiglia di specialisti parte dal risultato necessario
Il modo più rapido per scegliere male è partire dall'elenco più lungo di input supportati. Comincia dal risultato che l'applicazione deve produrre. Un paragrafo, una trascrizione, un campo strutturato e una scelta fra azioni ammesse sono contratti diversi, anche quando lo stesso materiale di partenza potrebbe contribuire a tutti e quattro.
L'annuncio di Liquid del 27 ottobre identifica quattro rami per modalità e due rami decisionali: LFM3-1.7B, LFM3-VL-2B, LFM3-Audio-2B, LFM3-Omni-2B, d1-2B e d1-Omni-2B. La tabella seguente traduce questi ruoli in domande per selezionare il modello adatto. È una guida all'idoneità, non una classifica indipendente della qualità. Descrizione della famiglia.
| Ruolo del modello | Candidato nella famiglia LFM3 | Domanda per l'applicazione |
|---|---|---|
| Interazione testuale | LFM3-1.7B | Il compito richiede un risultato linguistico a partire dal testo? |
| Comprensione di immagini e testo | LFM3-VL-2B | La risposta dipende da qualcosa di visibile? |
| Interazione vocale e audio | LFM3-Audio-2B | L'applicazione deve ascoltare o parlare? |
| Interazione audiovisiva combinata | LFM3-Omni-2B | Deve interpretare insieme vista e suono? |
| Decisioni strutturate da testo e immagini | d1-2B | Il risultato può essere espresso come decisioni tipizzate? |
| Decisioni strutturate che includono audio | d1-Omni-2B | Una decisione delimitata deve usare anche il suono? |
La nostra lettura: l'unità utile dell'IA locale è il più piccolo compito completo. Un modello dovrebbe avere capacità sufficienti a rispettare un contratto applicativo chiaro, insieme a un modo per gestire l'incertezza. Ogni capacità aggiuntiva comporta costi di esecuzione, verifica e integrazione che devono giustificarsi.
Pensa alla famiglia come a una borsa degli attrezzi. Portare ogni utensile è sensato per alcuni lavori; per una regolazione ripetuta, scegliere quello giusto può semplificare le cose. L'analogia riguarda il progetto dell'applicazione, non afferma che un modello sia sempre migliore di un altro.
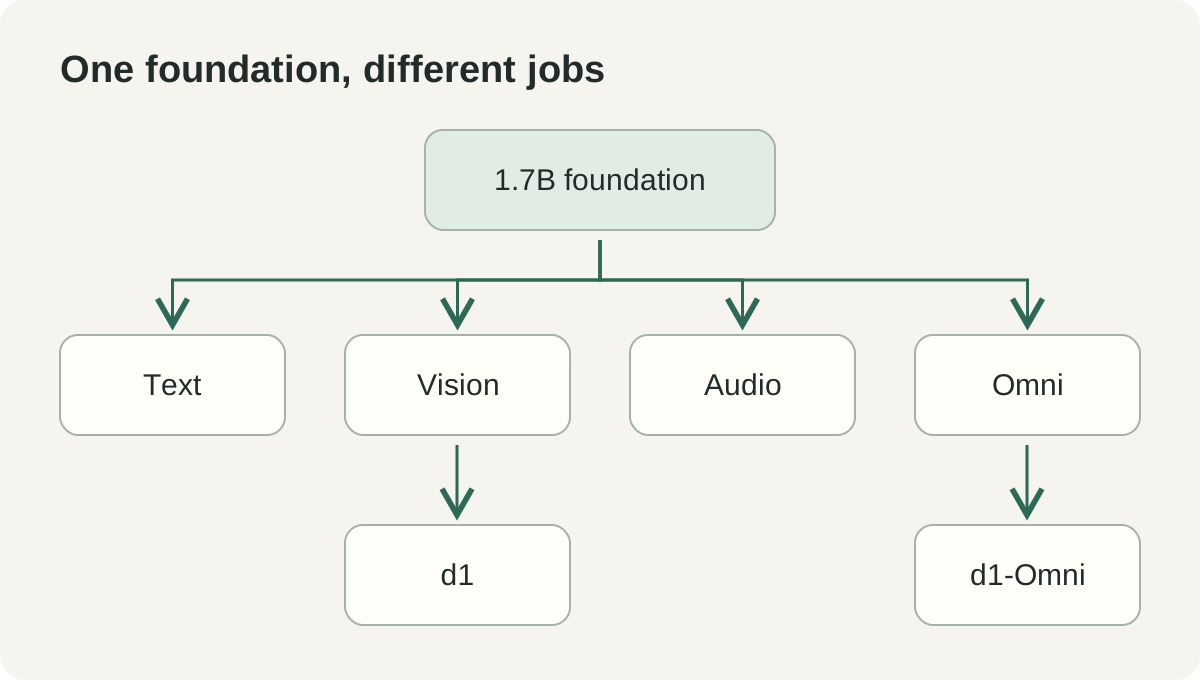 Diagramma esplicativo originale dei ruoli indicati nell'annuncio di LFM3 di Liquid AI. Raggruppa le scelte applicative e omette i dettagli interni di implementazione.
I pesi aperti offrono scelte di distribuzione, con una licenza da leggere
Scaricare i pesi offre allo sviluppatore qualcosa di concreto da impacchettare, valutare e adattare. Può consentire una distribuzione locale in cui il percorso dei dati dell'applicazione rimane sotto il suo controllo. È utile, ma la disponibilità di un file scaricabile non ne chiarisce da sola le condizioni commerciali.
Il catalogo dei modelli di Liquid, consultato il 2 novembre, descrive l'uso commerciale gratuito finché un'azienda non supera 10 milioni di dollari di fatturato annuo. La scheda di LFM3-1.7B indica la LFM Open License v1.0. Leggi la licenza associata all'esatto checkpoint e la pagina attuale sulle licenze in relazione alla distribuzione, alla fornitura e alla situazione di fatturato previste.
È un passaggio pratico di approvvigionamento. Un piccolo prototipo interno, un'applicazione consumer scaricabile e un servizio fornito ad altre aziende possono sollevare domande diverse su distribuzione e obblighi. Registra identificatore, revisione e licenza del modello insieme all'applicazione, così che la scelta resti rintracciabile quando il progetto cresce.
Anche il software di esecuzione e i pesi del modello hanno versioni distinte. Un modello può essere disponibile mentre l'ambiente sul dispositivo non offre ancora un supporto compatibile. Verifica la combinazione documentata invece di presumere che ogni applicazione capace di caricare una famiglia precedente possa caricare correttamente quella nuova.
Per un team, questa registrazione dovrebbe includere il prompt o il modello di input previsto dal checkpoint. Un caricatore compatibile può comunque produrre risultati scadenti se l'input è formattato male. La riproducibilità inizia sapendo che cosa è stato effettivamente caricato e come l'applicazione gli ha parlato.
Circa 1 GB di pesi è l'inizio del bilancio di memoria
Nel materiale di lancio del 27 ottobre, Liquid descrive l'ingombro a 4 bit del modello testuale come pari a circa 1 GB. La scheda del modello testuale specifica 1,73 miliardi di parametri e un contesto di 256K token complessivi fra input e output. Sono specifiche del modello; il picco di memoria dell'applicazione dipende anche dal carico di lavoro e dall'ambiente di esecuzione.
Un file di pesi è solo una parte di un processo in funzione. L'ambiente richiede memoria di lavoro; l'elaborazione del contesto deve mantenere uno stato; gli input multimediali possono richiedere buffer e codificatori aggiuntivi. Altri programmi sul dispositivo competono per le stesse risorse. Un titolo sulle dimensioni dei pesi non dice se l'intera applicazione rimarrà agevole sotto carico.
Un bilancio illustrativo dovrebbe quindi partire dall'ingombro misurato del processo. Registra lo stato dell'applicazione a riposo, il picco durante una richiesta rappresentativa e lo stato dopo richieste ripetute. Prova la lunghezza del contesto e le dimensioni degli input che gli utenti forniranno davvero, anziché un piccolo prompt scelto perché entra facilmente in memoria.
La stessa disciplina vale per i tempi. Avvio, elaborazione del prompt e generazione della risposta sono attese distinte. Un modello che produce rapidamente token dopo una lunga pausa può sembrare lento in un'applicazione interattiva; per un'elaborazione in serie possono contare di più gli elementi completati ogni ora. Scegli la misura corrispondente all'interazione.
Per una funzione audio, includi l'intero percorso dall'input al risultato utilizzabile. Per una funzione visiva, includi la gestione delle immagini. Per una funzione decisionale, includi la convalida e il passaggio all'azione. Sono requisiti di valutazione che definisci tu, non dati prestazionali forniti dal lancio.
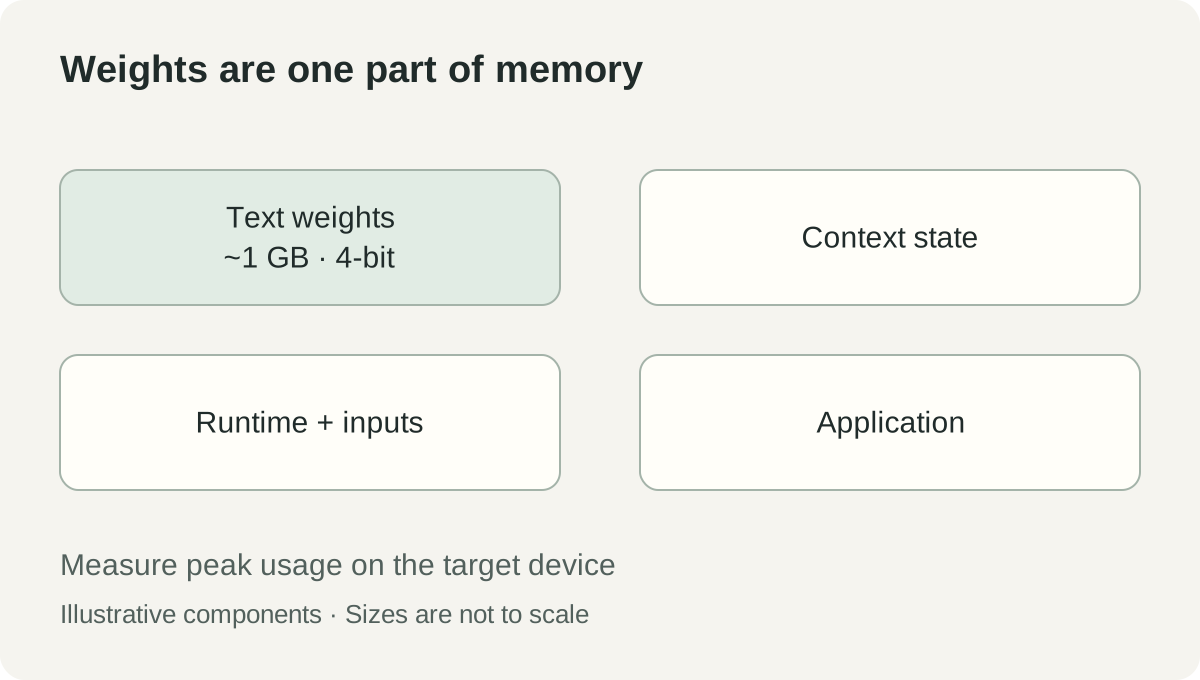 Diagramma originale del bilancio di memoria. Le larghezze dei segmenti sono illustrative e non rappresentano proporzioni misurate; circa 1 GB si riferisce all'ingombro pubblicato da Liquid per il modello testuale a 4 bit, non alla memoria totale dell'applicazione. Fonte.
Tre applicazioni illustrative mostrano compromessi diversi
Un assistente documentale può separare la lettura dalla decisione
Immagina un'applicazione per una piccola impresa che riceve fotografie di scontrini. Un compito consiste nel leggere esercente, data e importo visibili. Un altro consiste nel decidere se il documento è abbastanza completo per una verifica umana. Questi risultati meritano convalide separate, anche se un unico modello contribuisce a entrambi.
Un percorso visivo e linguistico potrebbe supportare domande sull'immagine; un percorso decisionale potrebbe essere valutato per un controllo circoscritto di completezza. L'applicazione dovrebbe conservare l'immagine originale e distinguere i campi estratti dai dati contabili accettati. Una data mancante dovrebbe rimanere tale finché qualcuno non risolve il problema.
Costruisci un insieme illustrativo di valutazione con immagini nitide, immagini sfocate, impaginazioni insolite e scontrini nelle lingue effettivamente utilizzate. Misura gli errori a livello di campo e il carico di revisione. Un alto tasso di successo complessivo può nascondere un errore ricorrente nel campo più importante per l'impresa.
Il risultato utile per il prodotto è una coda di revisione più breve e chiara. L'eleganza della spiegazione del modello conta meno della possibilità, per chi verifica, di esaminare la fonte e correggere i campi. Questa priorità aiuta a scegliere fra un risultato linguistico aperto e un'interfaccia decisionale più vincolata.
Un'interfaccia vocale può partire da poche azioni consentite
Considera un assistente illustrativo a mani libere per un'applicazione locale. L'utente può chiedere di trovare un elemento, leggerne lo stato o preparare una bozza di azione. L'audio diventa utile quando parlare è più facile che digitare, ma l'applicazione deve comunque sapere che cosa una richiesta può modificare.
Inizia con un piccolo vocabolario di azioni e un percorso di conferma visibile. Per esempio, una richiesta di trovare un record può essere eseguita subito all'interno dei dati autorizzati, mentre una richiesta che lo modificherebbe può presentare una proposta da verificare. La politica appartiene all'applicazione, non alla formulazione che il modello produce casualmente.
Prova le condizioni acustiche reali. Conversazioni di sottofondo, enunciati brevi e nomi simili possono creare errori diversi da quelli di una frase registrata in modo pulito. Includi casi in cui l'esito corretto è chiedere di nuovo all'utente. Una risposta vocale fluida è meno utile di un'interazione corretta e recuperabile.
Un candidato omni diventa pertinente quando la richiesta dipende da ciò che è visibile oltre che da ciò che viene detto. Se ogni compito usa soltanto la voce, aggiungere l'elaborazione visiva richiede una motivazione. È qui che l'approccio per famiglie può aiutare a mantenere la funzione proporzionata al compito.
Uno strumento di assistenza locale può instradare il lavoro conservando una via d'uscita
Un'applicazione illustrativa di assistenza potrebbe scegliere fra tre code usando una segnalazione e una schermata allegata. Un risultato decisionale circoscritto può adattarsi al compito più direttamente di una lunga risposta che l'applicazione deve interpretare. La domanda utile è se l'instradamento scelto sia abbastanza affidabile con un tasso di revisione accettabile.
Mantieni un esito esplicito «richiede revisione». Prova segnalazioni che non corrispondono ad alcuna coda ammessa, schermate contraddittorie e casi con contesto insufficiente. L'applicazione non dovrebbe costringere il modello a inventare un percorso valido solo perché lo schema ne richiede uno.
Confronta il modello con una base semplice, come le regole esistenti e l'instradamento umano. Se questa base gestisce già una categoria in modo affidabile, il modello deve migliorare un'altra parte del flusso. La novità non è un criterio di accettazione.
Per ogni errore, conserva abbastanza contesto autorizzato da capirne la causa. Distingui problemi dell'input, categorie ambigue ed errori del modello. Questa distinzione indica se migliorare il modello, cambiare le definizioni delle code o chiedere materiale di partenza migliore.
Le tabelle dei benchmark sono un punto di partenza per il proprio carico di lavoro
La scheda ufficiale di LFM3-1.7B, consultata il 2 novembre, raccomanda recupero di informazioni o ricerca per i compiti ad alta intensità di conoscenza e invita alla cautela verso la programmazione con agenti e il ragionamento complesso in più passaggi a queste dimensioni. È un'indicazione utile per collocare il modello in un sistema più ampio, anche quando le tabelle del fornitore mostrano progressi.
Un risultato di benchmark risponde a una domanda specifica con una particolare configurazione. La tua applicazione aggiunge dati, strumenti, distribuzione delle lingue e costi degli errori propri. Un modello può migliorare su un aggregato pubblico e richiedere comunque un lavoro attento sulle poche categorie che gli utenti incontrano ogni giorno.
In una prova pilota, separa tre confronti. Primo, confronta la qualità del compito con il flusso attuale. Secondo, confronta il costo completo in risorse sul dispositivo previsto. Terzo, confronta il lavoro necessario per riprendersi da un errore. I tre confronti possono produrre vincitori diversi.
Un modello generalista nel cloud, per esempio, può essere utile come destinazione di escalation quando uno specialista locale si astiene. Questa configurazione richiede una politica dei dati e un'esperienza utente esplicite. Il funzionamento locale è una scelta di distribuzione da verificare nell'intera applicazione, comprese registrazioni e richieste di ripiego.
Il perfezionamento tramite addestramento dovrebbe seguire una lacuna dimostrata. Se gli errori derivano da materiale di partenza mancante o da definizioni poco chiare del risultato, altro addestramento può rafforzare il compito sbagliato. Definisci il contratto ed esamina gli errori prima di decidere che la personalizzazione sia il passo successivo utile.
Una prima prova pilota dovrebbe entrare in una pagina di decisioni
La scheda ufficiale del modello testuale collega formati dei checkpoint e istruzioni di esecuzione. Parti da lì per la combinazione esatta di modello e ambiente; usa il Playground ufficiale per una prima verifica dell'interazione se è compatibile con la tua politica dei dati. Nessuna delle due strade sostituisce la verifica della distribuzione che intendi fornire.
- Scrivi il contratto di input e output. Specifica materiale consentito, risultato atteso ed esito esplicito di revisione. Scegli un compito invece di una personalità generica da assistente.
- Scegli candidato e revisione. Abbina modalità e ruolo del risultato, poi registra checkpoint, licenza e ambiente compatibile. Leggi i limiti specifici del modello.
- Crea un insieme di valutazione rappresentativo. Includi casi ordinari, casi difficili, richieste non supportate ed esempi nelle lingue reali degli utenti. Tieni separato il materiale di verifica dai dati di personalizzazione.
- Esegui l'avvio rapido documentato in un ambiente isolato. Segui le istruzioni attuali della scheda su dipendenze e formattazione. Conferma l'identità del modello restituita prima di confrontare i risultati.
- Misura l'intero percorso applicativo. Rileva correttezza, tasso di revisione, latenza e picco di memoria per dimensioni realistiche degli input. Registra hardware e impostazioni insieme ai numeri.
- Esercita il percorso dell'incertezza. Conferma che informazioni mancanti, risultati non validi ed errori di esecuzione portino a uno stato comprensibile di revisione o nuovo tentativo.
- Decidi che cosa specializzare dopo. Usa le categorie di errore ricorrenti per scegliere fra input migliori, regole più chiare, recupero di informazioni, perfezionamento o un modello diverso.
Per il primo passaggio, la decisione scritta può essere semplice: questo candidato è utile per questo compito su questo dispositivo, con queste condizioni di revisione. Una conclusione circoscritta e riproducibile vale più di un'affermazione generale secondo cui l'IA locale sarebbe pronta a tutto.
Un piccolo modello si guadagna il posto completando un compito definito
LFM3 amplia le possibilità per gli sviluppatori che vogliono testo, vista, suono o decisioni delimitate vicino all'applicazione. La sua importanza pratica deriva dalla possibilità di scegliere fra questi ruoli e valutarli come parti di un prodotto.
Il passo successivo consiste nel precisare un compito abbastanza da poterne misurare qualità, memoria e recupero. Uno specialista diventa utile quando l'intera applicazione può fare affidamento sul suo contratto e sa come comportarsi quando non può rispondere.
Fonti
- Liquid AI: presentazione di LFM3, 27 ottobre 2026; consultato il 2 novembre 2026.
- Catalogo dei modelli Liquid AI e prezzi e licenze, consultati il 2 novembre 2026.
- Scheda ufficiale di LFM3-1.7B, consultata il 2 novembre 2026.
- Scheda ufficiale di d1-2B, consultata il 2 novembre 2026.
Conserva il materiale alla base di una decisione
Telli.sh è un'opzione per conservare il materiale di partenza autorizzato insieme agli appunti che hai verificato. Crea uno spazio per gli appunti.