Liquid LFM3 pose une meilleure question pour l’IA locale : quel petit modèle remplit la tâche ?
LFM3 décline une base commune en modèles texte, vision, audio, omni et décision. Comment choisir un spécialiste, prévoir la mémoire réelle et construire une évaluation locale utile.
Un assistant local qui lit un reçu n’a pas nécessairement besoin du même modèle qu’un assistant répondant à une question orale. Un programme qui choisit entre trois actions autorisées accomplit encore une autre tâche. Les traiter comme un problème unique peut compliquer inutilement une petite application.
Liquid AI a annoncé LFM3 le 27 octobre 2026 : six modèles de la classe des 2B environ, issus d’une base commune de 1.7B, couvrant le texte, la vision, l’audio, l’omni et deux variantes de décision. L’entreprise fournit des poids ouverts, un Playground et un accès API. Annonce de LFM3.
La décision intéressante concerne le rôle à intégrer dans votre application. Ce guide explique la famille à travers des choix concrets, distingue un fichier de poids compact d’un budget mémoire opérationnel et propose une première évaluation pour déterminer si un spécialiste est utile sur votre matériel.
 Matériel Raspberry Pi 5 ; illustration du contexte de l’informatique en périphérie, et non d’un essai de LFM3 réalisé par nos soins. Image : RetroEditor, CC BY 4.0 ; redimensionnée avec des marges. Source de l’image · Licence et précisions sur l’image. Référence officielle du produit.

Le choix d’une famille de spécialistes commence par la sortie attendue
Le moyen le plus rapide de mal choisir consiste à partir de la plus longue liste d’entrées prises en charge. Commencez par la sortie que votre application doit produire. Un paragraphe, une transcription, un champ structuré et un choix parmi des actions autorisées correspondent à des contrats différents, même si les mêmes sources peuvent contribuer aux quatre.
L’annonce de Liquid du 27 octobre distingue quatre branches de modalités et deux branches de décision : LFM3-1.7B, LFM3-VL-2B, LFM3-Audio-2B, LFM3-Omni-2B, d1-2B et d1-Omni-2B. Le tableau suivant traduit ces rôles en questions de sélection pour une application. Il aide à juger l’adéquation, sans constituer un classement indépendant de qualité. Description de la famille.
| Rôle du modèle | Candidat dans la famille LFM3 | Question pour votre application |
|---|---|---|
| Interaction textuelle | LFM3-1.7B | La tâche nécessite-t-elle une sortie linguistique à partir de texte ? |
| Compréhension d’images et de texte | LFM3-VL-2B | La réponse dépend-elle d’un élément visible ? |
| Interaction vocale et audio | LFM3-Audio-2B | L’application doit-elle entendre ou parler ? |
| Interaction audiovisuelle combinée | LFM3-Omni-2B | Doit-elle interpréter conjointement l’image et le son ? |
| Décisions structurées à partir de texte et d’images | d1-2B | Le résultat peut-il s’exprimer sous forme de décisions typées ? |
| Décisions structurées incluant l’audio | d1-Omni-2B | Une décision délimitée doit-elle aussi exploiter le son ? |
Notre avis : l’unité utile de l’IA locale est la plus petite tâche complète. Un modèle doit posséder les capacités nécessaires pour respecter un contrat applicatif clair, ainsi qu’un mécanisme de gestion de l’incertitude. Tout ce qui s’y ajoute entraîne des coûts d’exécution, de test et d’intégration qu’il faut justifier.
Considérez cette famille comme une trousse à outils. Tout emporter est pertinent pour certains travaux ; pour un réglage répété, choisir le bon outil peut être plus simple. L’analogie concerne la conception de l’application, sans affirmer qu’un modèle en surpasse toujours un autre.
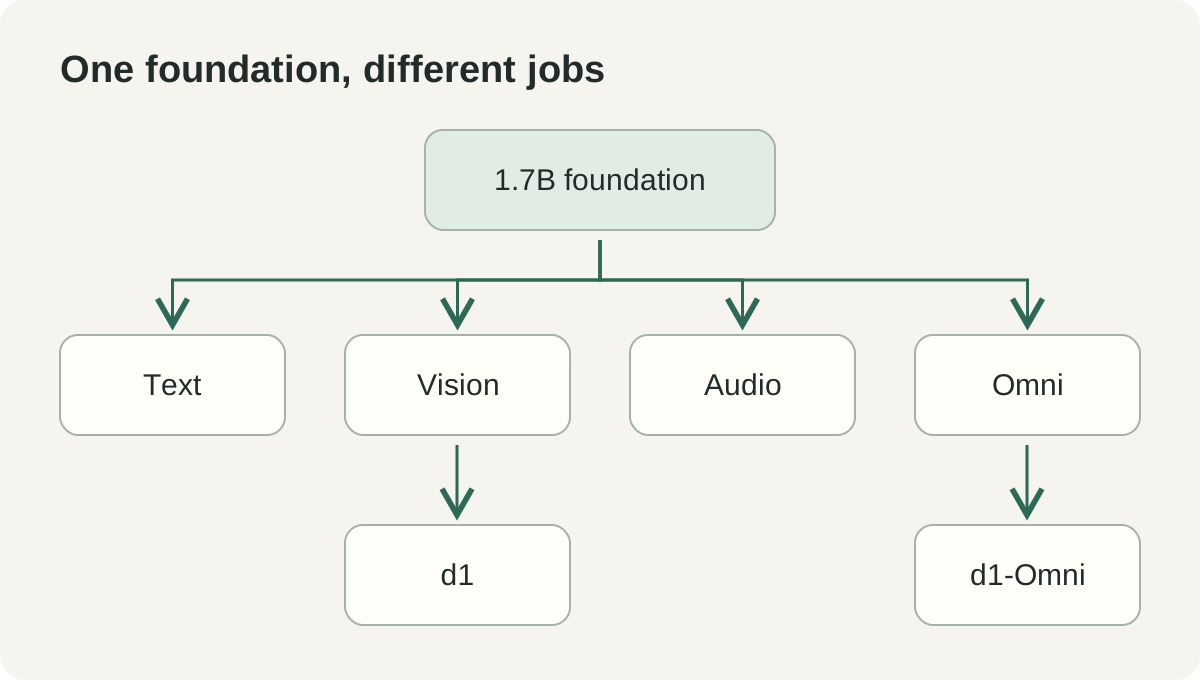 Schéma explicatif original des rôles cités dans l’annonce LFM3 de Liquid AI. Il regroupe les choix applicatifs et laisse de côté les détails internes d’implémentation.
Les poids ouverts offrent plusieurs choix de déploiement, avec une licence à lire
Télécharger des poids donne au développeur un élément concret à empaqueter, évaluer et adapter. Cela peut permettre un déploiement local dans lequel il garde la maîtrise du parcours des données de l’application. C’est utile, mais l’existence d’un fichier téléchargeable ne règle pas la question de ses conditions commerciales.
Le catalogue de modèles de Liquid, consulté le 2 novembre, décrit une utilisation commerciale gratuite jusqu’au dépassement de 10 millions de dollars de chiffre d’affaires annuel. La fiche du modèle LFM3-1.7B indique la LFM Open License v1.0. Lisez la licence jointe au checkpoint exact et la page actuelle sur les licences en fonction du déploiement, de la distribution et du chiffre d’affaires envisagés.
C’est une étape concrète de sélection et d’achat. Un petit prototype interne, une application grand public téléchargeable et un service fourni à d’autres entreprises peuvent soulever des questions différentes de distribution et d’obligations. Conservez l’identifiant du modèle, sa révision et sa licence avec l’application afin que la décision reste traçable lorsque le projet se développe.
Le logiciel d’exécution et les poids du modèle ont également des versions distinctes. Un modèle peut être disponible alors que l’environnement d’exécution de votre appareil ne le prend pas encore en charge. Vérifiez la combinaison documentée plutôt que de supposer qu’une application chargeant une famille antérieure chargera correctement la nouvelle.
Pour une équipe, cette documentation doit inclure la consigne ou le gabarit attendu par le checkpoint. Un chargeur compatible peut encore produire un mauvais comportement si l’entrée est mal formatée. La reproductibilité commence par la connaissance de ce qui a été effectivement chargé et de la façon dont l’application lui a parlé.
Environ 1 GB de poids n’est que le début d’un budget mémoire
Dans ses documents de lancement du 27 octobre, Liquid annonce une empreinte d’environ 1 GB pour le modèle texte en 4 bits. La fiche du modèle texte précise 1.73 milliard de paramètres et un contexte entrée plus sortie de 256K tokens. Ce sont des caractéristiques du modèle ; la mémoire maximale de votre application dépend aussi de la charge et de l’environnement d’exécution.
Un fichier de poids n’est qu’une partie d’un processus en cours d’exécution. Le moteur a besoin de mémoire de travail ; le traitement du contexte requiert un état ; les entrées multimédias peuvent exiger des tampons et des encodeurs supplémentaires. Les autres programmes présents sur l’appareil utilisent les mêmes ressources. Un chiffre mis en avant sur la taille des poids ne permet pas de savoir si l’application entière restera à l’aise en charge.
Un budget illustratif devrait donc commencer par une mesure de l’empreinte du processus. Relevez l’état au repos, le pic pendant le traitement d’une requête représentative et l’état après plusieurs requêtes. Testez les longueurs de contexte et les tailles d’entrée que les utilisateurs fourniront réellement, plutôt qu’une petite consigne choisie parce qu’elle passe facilement.
La même rigueur s’applique au temps. Démarrage, traitement de la consigne et génération de la réponse correspondent à des attentes distinctes. Un modèle qui produit rapidement des tokens après une longue attente peut sembler lent dans une application interactive ; un traitement par lots peut privilégier le nombre d’éléments terminés par heure. Choisissez la mesure adaptée à l’interaction.
Pour une fonction audio, incluez tout le parcours entre l’entrée et le résultat utilisable. Pour une fonction image, incluez le traitement des images. Pour une fonction de décision, incluez la validation et la transmission à l’action. Vous définissez ainsi des exigences d’évaluation, sans les confondre avec les chiffres de performance annoncés au lancement.
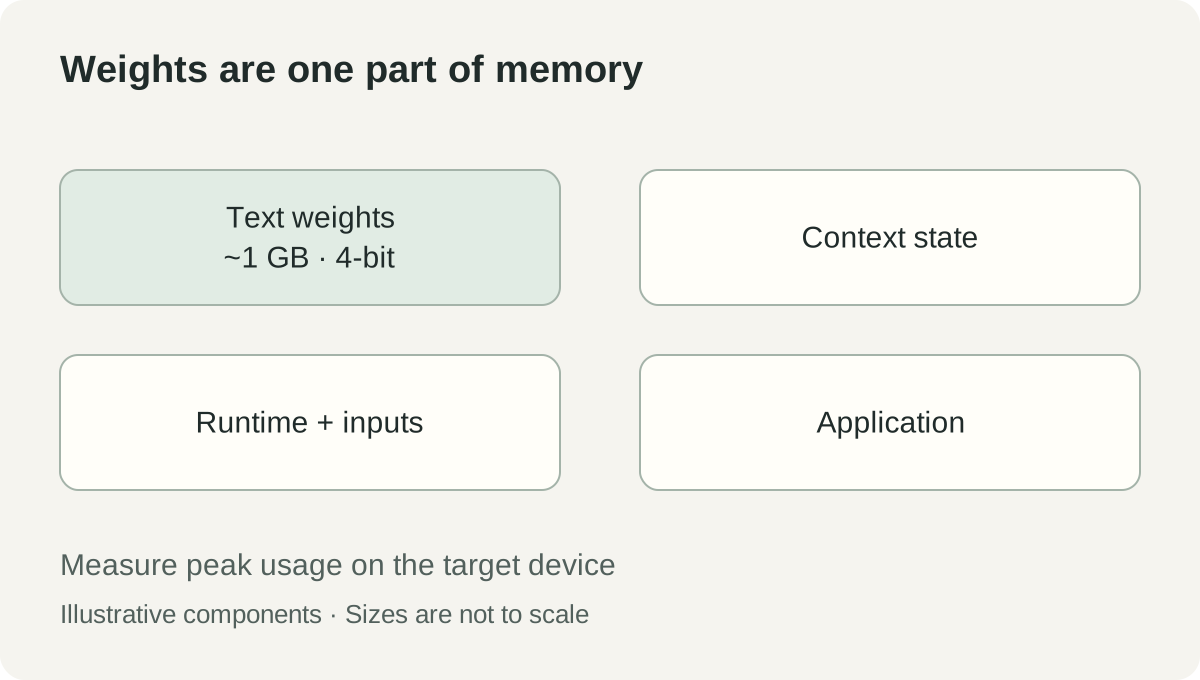 Schéma original de budget mémoire. Les largeurs des segments sont illustratives et ne représentent aucune proportion mesurée ; le chiffre d’environ 1 GB désigne l’empreinte publiée du modèle texte Liquid en 4 bits, pas la mémoire totale de l’application. Source.
Trois applications illustratives révèlent des compromis différents
Un assistant documentaire peut séparer la lecture de la décision
Imaginons une application pour petite entreprise qui reçoit des reçus photographiés. Lire le commerçant, la date et le montant visibles constitue une tâche. Décider si le document est suffisamment complet pour être vérifié par une personne en constitue une autre. Ces sorties méritent des validations séparées, même si un seul modèle contribue aux deux.
Un parcours vision-langage pourrait répondre à des questions sur l’image ; un parcours de décision pourrait être évalué pour un contrôle de complétude délimité. L’application doit conserver l’image source et distinguer les champs extraits des données comptables acceptées. Une date manquante doit rester manquante jusqu’à sa résolution.
Constituez un jeu d’évaluation illustratif avec des images nettes, des images floues, des mises en page inhabituelles et des reçus dans les langues de travail réelles. Mesurez les erreurs par champ et la charge de vérification. Un taux global de réussite élevé peut masquer une erreur récurrente dans le champ le plus important pour l’entreprise.
Le résultat produit utile est une file de vérification plus courte et plus claire. L’élégance d’une explication compte moins que la possibilité, pour la personne chargée du contrôle, d’examiner la source et de corriger les champs. Cette priorité aide à choisir entre une sortie linguistique ouverte et une interface de décision plus contrainte.
Une interface vocale peut commencer avec un ensemble restreint d’actions autorisées
Prenons un assistant mains libres illustratif pour une application locale. L’utilisateur peut demander de retrouver un élément, d’en lire l’état ou de préparer une action. L’audio devient utile lorsque parler est plus facile qu’écrire, mais l’application doit toujours savoir ce qu’une demande est autorisée à modifier.
Commencez par un petit vocabulaire d’actions et un parcours de confirmation visible. Une demande de recherche peut, par exemple, être exécutée immédiatement dans les données autorisées, tandis qu’une demande de modification peut présenter une proposition à vérifier. La politique appartient à l’application, pas à la formulation que le modèle produit par hasard.
Testez les conditions acoustiques réelles. Conversations de fond, énoncés courts et noms proches peuvent provoquer des erreurs différentes de celles d’une phrase enregistrée proprement. Incluez des cas où la bonne réponse consiste à redemander à l’utilisateur. Une réponse orale fluide est moins utile qu’une interaction correcte dont on peut récupérer les erreurs.
Un candidat omni devient pertinent lorsque la demande dépend à la fois de ce qui est visible et de ce qui est dit. Si toutes les tâches utilisent uniquement la parole, l’ajout de la vision doit être justifié. C’est là que l’approche par famille peut maintenir la fonction à la juste mesure de la tâche.
Un outil local d’assistance peut orienter le travail en conservant une issue de secours
Une application d’assistance illustrative pourrait choisir entre trois files à partir d’un ticket et d’une capture jointe. Une sortie de décision délimitée peut correspondre plus directement à cette tâche qu’une longue réponse que l’application devra interpréter. La question utile est de savoir si l’orientation choisie est assez fiable pour un taux de vérification acceptable.
Conservez une issue explicite « à vérifier ». Testez des tickets ne correspondant à aucune file autorisée, des captures contradictoires et des cas au contexte insuffisant. L’application ne doit pas forcer le modèle à inventer une destination valide simplement parce que le schéma l’exige.
Comparez le modèle à une référence simple, par exemple les règles existantes et l’orientation humaine. Si la référence traite déjà une catégorie de manière fiable, le modèle doit améliorer une autre partie du processus. La nouveauté n’est pas un critère d’acceptation.
Pour chaque erreur, conservez suffisamment de contexte autorisé pour en comprendre la cause. Distinguez les problèmes d’entrée, les catégories ambiguës et les erreurs du modèle. Cela indique s’il faut améliorer le modèle, modifier les définitions des files ou demander de meilleures sources.
Les tableaux de benchmarks sont un point de départ pour votre propre charge
La fiche officielle de LFM3-1.7B, consultée le 2 novembre, recommande la recherche ou la récupération documentaire pour les tâches riches en connaissances et déconseille, à cette taille, le codage agentique et les raisonnements complexes en plusieurs étapes. Ces indications aident à situer le modèle dans un système plus large, même lorsque les tableaux de benchmarks du fournisseur affichent des progrès.
Un résultat de benchmark répond à une question précise dans une configuration particulière. Votre application ajoute ses données, ses outils, sa répartition linguistique et ses coûts d’échec. Un modèle peut progresser sur un agrégat public tout en exigeant un travail attentif sur les quelques catégories rencontrées quotidiennement par vos utilisateurs.
Séparez trois comparaisons dans un pilote. Comparez d’abord la qualité sur la tâche au processus actuel. Comparez ensuite le coût total en ressources sur l’appareil prévu. Enfin, comparez le travail nécessaire pour récupérer un échec. Ces comparaisons peuvent désigner des gagnants différents.
Un généraliste dans le cloud peut, par exemple, servir de recours lorsqu’un spécialiste local refuse de répondre. Cette organisation exige une politique de données et une expérience utilisateur explicites. Le fonctionnement local est un choix de déploiement à vérifier sur toute l’application, y compris la journalisation et les requêtes de repli.
L’ajustement fin doit répondre à une lacune démontrée. Si les erreurs viennent de sources manquantes ou de définitions de sortie floues, davantage d’entraînement peut renforcer la mauvaise tâche. Définissez le contrat et examinez les erreurs avant de décider que la personnalisation est l’étape utile suivante.
Un premier pilote devrait tenir sur une page de décisions
La fiche officielle du modèle texte donne accès aux formats de checkpoint et aux instructions d’exécution. Partez de là pour la combinaison exacte modèle/moteur ; utilisez le Playground officiel pour un premier contrôle d’interaction si votre politique de données le permet. Aucune des deux voies ne remplace l’essai du déploiement que vous comptez livrer.
- Rédigez le contrat d’entrée et de sortie. Précisez les éléments autorisés, le résultat attendu et l’issue explicite de vérification. Choisissez une tâche, plutôt qu’une personnalité d’assistant généraliste.
- Choisissez le candidat et sa révision. Faites correspondre la modalité et le rôle de sortie, puis consignez le checkpoint, la licence et le moteur compatible. Lisez les limites propres au modèle.
- Créez un jeu d’évaluation représentatif. Incluez des cas ordinaires, difficiles, des demandes non prises en charge et des exemples dans les langues réelles des utilisateurs. Séparez les données réservées à l’évaluation des données de personnalisation.
- Exécutez le démarrage rapide documenté dans un environnement isolé. Respectez les instructions actuelles de dépendances et de formatage de la fiche. Confirmez l’identité du modèle renvoyée avant de comparer les sorties.
- Mesurez le parcours applicatif complet. Relevez l’exactitude, le taux de vérification, la latence et le pic mémoire avec des entrées de taille réaliste. Consignez le matériel et les réglages d’exécution avec les chiffres.
- Exercez le parcours d’incertitude. Confirmez que les informations manquantes, sorties invalides et échecs d’exécution conduisent à un état compréhensible de vérification ou de nouvelle tentative.
- Décidez de la prochaine spécialisation. Utilisez les catégories d’erreurs récurrentes pour choisir entre de meilleures entrées, des règles plus claires, la recherche documentaire, l’ajustement fin ou un autre modèle.
Pour le premier passage, la décision écrite peut rester simple : ce candidat est utile pour cette tâche sur cet appareil, sous ces conditions de vérification. Une conclusion précise et reproductible vaut davantage qu’une affirmation générale selon laquelle l’IA locale serait prête à tout faire.
Un petit modèle mérite sa place lorsqu’il accomplit une tâche définie
LFM3 élargit le choix des développeurs qui veulent du texte, de la vision, du son ou des décisions délimitées près de l’application. Son intérêt pratique vient de la possibilité de choisir entre ces rôles et de les évaluer comme des composants d’un produit.
L’étape suivante consiste à préciser une tâche suffisamment pour mesurer ensemble la qualité, la mémoire et la récupération des erreurs. Un spécialiste devient utile lorsque l’application entière peut compter sur son contrat et sait quoi faire lorsqu’il ne peut pas répondre.
Sources
- Liquid AI : présentation de LFM3, 27 octobre 2026 ; consulté le 2 novembre 2026.
- Catalogue des modèles Liquid AI et tarifs et licences, consultés le 2 novembre 2026.
- Fiche officielle du modèle LFM3-1.7B, consultée le 2 novembre 2026.
- Fiche officielle du modèle d1-2B, consultée le 2 novembre 2026.
Conserver les éléments qui fondent une décision
Telli.sh est une option pour conserver des sources dont l’utilisation est autorisée aux côtés des notes que vous avez révisées. Créer un espace de notes.