Liquid LFM3 plantea una mejor pregunta sobre IA local: ¿qué modelo pequeño hace el trabajo?
LFM3 divide una base compartida en modelos de texto, visión, audio, omni y decisiones. Cómo elegir un especialista, calcular la memoria real y diseñar una evaluación local útil.
Un asistente local que lee un recibo no necesita necesariamente el mismo modelo que otro que responde a una pregunta hablada. Un programa que elige entre tres acciones permitidas tiene una tarea distinta. Tratarlas como una sola puede complicar innecesariamente una aplicación pequeña.
Liquid AI anunció LFM3 el 27 de octubre de 2026: seis modelos de aproximadamente la categoría 2B, derivados de una base compartida de 1.7B, que abarcan texto, visión, audio, omni y dos variantes de decisión. La empresa ofrece pesos abiertos, un Playground y acceso mediante API. Anuncio de LFM3.
La decisión interesante es qué función corresponde a tu aplicación. Esta guía explica la familia mediante elecciones prácticas, distingue un archivo compacto de pesos de un presupuesto de memoria operativa y propone una primera evaluación para descubrir si un especialista resulta útil en tu propio hardware.
 Una Raspberry Pi 5 como contexto ilustrativo de computación en el dispositivo, no como prueba nuestra de LFM3. Imagen: RetroEditor, CC BY 4.0; redimensionada con márgenes. Fuente de la imagen · Licencia y notas de la imagen. Referencia oficial del producto.

Una familia de especialistas empieza por el resultado que necesitas
La forma más rápida de elegir mal es empezar por la lista más larga de entradas admitidas. Comienza por lo que debe producir la aplicación. Un párrafo, una transcripción, un campo estructurado y una elección entre acciones permitidas son contratos diferentes, aunque el mismo material pueda contribuir a los cuatro.
El anuncio de Liquid del 27 de octubre identifica cuatro ramas por modalidad y dos de decisión: LFM3-1.7B, LFM3-VL-2B, LFM3-Audio-2B, LFM3-Omni-2B, d1-2B y d1-Omni-2B. La tabla traduce esas funciones en preguntas para seleccionar una aplicación. Orienta sobre su adecuación, no ofrece una clasificación independiente de calidad. Descripción de la familia.
| Función del modelo | Candidato de la familia LFM3 | Pregunta para tu aplicación |
|---|---|---|
| Interacción textual | LFM3-1.7B | ¿La tarea necesita generar lenguaje a partir de texto? |
| Comprensión de imágenes y texto | LFM3-VL-2B | ¿La respuesta depende de algo visible? |
| Interacción mediante voz y audio | LFM3-Audio-2B | ¿La aplicación necesita escuchar o hablar? |
| Interacción audiovisual combinada | LFM3-Omni-2B | ¿Debe interpretar conjuntamente imagen y sonido? |
| Decisiones estructuradas a partir de texto e imágenes | d1-2B | ¿Puede expresarse el resultado como decisiones tipadas? |
| Decisiones estructuradas que incluyen audio | d1-Omni-2B | ¿Una decisión acotada necesita también sonido? |
Nuestra opinión: la unidad útil de la IA local es el trabajo completo más pequeño. Un modelo debería tener capacidad suficiente para cumplir un contrato claro de aplicación, junto con una forma de gestionar la incertidumbre. Todo lo demás implica costes de ejecución, pruebas e integración que deben justificar su presencia.
Imagina la familia como un juego de herramientas. Llevarlas todas tiene sentido para algunos trabajos; para un ajuste repetido, elegir la adecuada puede ser más sencillo. La analogía trata del diseño de aplicaciones, no afirma que un modelo siempre supere a otro.
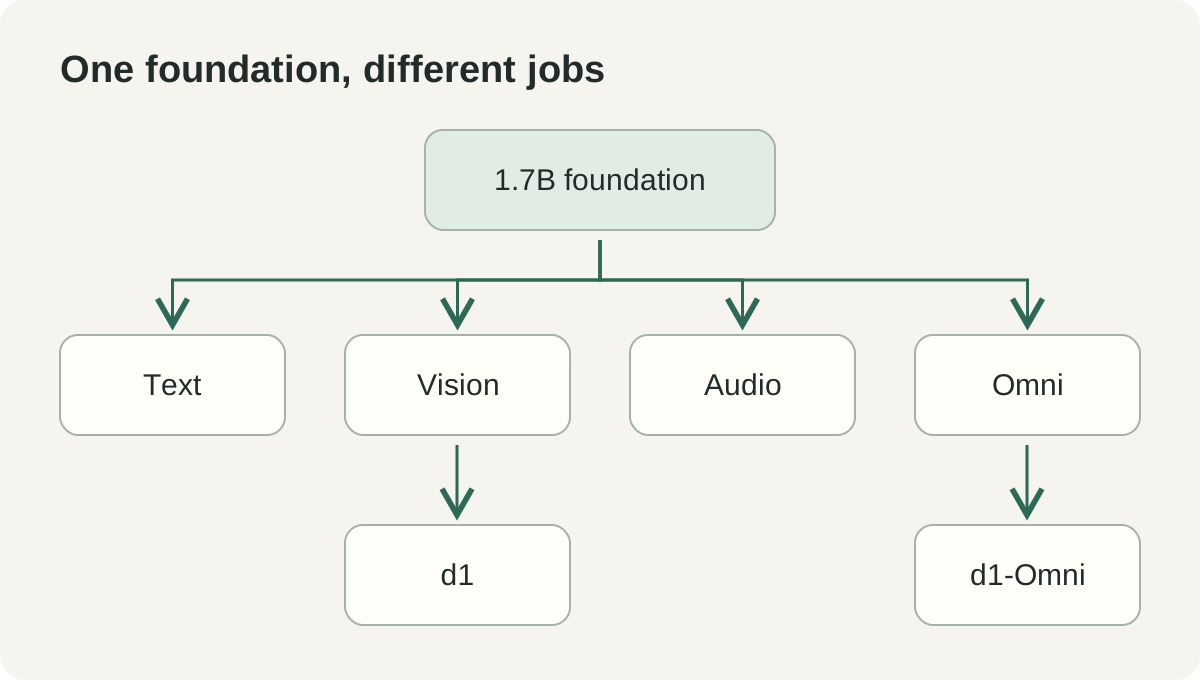 Diagrama explicativo original de las funciones citadas en el anuncio de LFM3 de Liquid AI. Agrupa elecciones para aplicaciones y omite los detalles internos de implementación.
Los pesos abiertos ofrecen opciones de despliegue y una licencia que leer
Descargar los pesos proporciona algo concreto que un desarrollador puede empaquetar, evaluar y adaptar. Puede permitir un despliegue local cuyo recorrido de datos siga bajo su control. Es útil, pero disponer de un archivo descargable no resuelve las condiciones comerciales.
El catálogo de modelos de Liquid, consultado el 2 de noviembre, describe el uso comercial gratuito hasta que una empresa supere $10 millones de ingresos anuales. La ficha de LFM3-1.7B identifica la LFM Open License v1.0. Lee la licencia adjunta al punto de control exacto y la página vigente de licencias según el despliegue, la distribución y los ingresos previstos.
Es un paso práctico de adquisición. Un pequeño prototipo interno, una aplicación de consumo descargable y un servicio para otras empresas pueden plantear cuestiones diferentes sobre distribución y obligaciones. Registra el identificador, la revisión y la licencia junto a la aplicación para que la decisión siga siendo trazable cuando crezca el proyecto.
El software de ejecución y los pesos también tienen versiones distintas. Un modelo puede estar disponible mientras que el entorno de tu dispositivo aún carece de compatibilidad. Comprueba la combinación documentada, en vez de suponer que cualquier aplicación que carga una familia anterior cargará correctamente la nueva.
En un equipo, ese registro debería incluir la instrucción o plantilla esperada por el modelo. Un cargador compatible puede producir malos resultados si la entrada tiene un formato incorrecto. La reproducibilidad empieza por saber qué se cargó realmente y cómo se comunicó la aplicación con ello.
Aproximadamente 1 GB de pesos es solo el comienzo del presupuesto de memoria
Liquid describe el tamaño a 4 bits del modelo de texto como aproximadamente 1 GB en el lanzamiento del 27 de octubre. La ficha del modelo de texto especifica 1.73 mil millones de parámetros y un contexto de entrada más salida de 256K tokens. Son especificaciones del modelo; la memoria máxima de la aplicación depende también de la carga y del entorno de ejecución.
El archivo de pesos es solo una parte de un proceso en funcionamiento. El entorno necesita memoria de trabajo; procesar contexto requiere estado; las entradas multimedia pueden exigir búferes y codificadores adicionales. Otros programas compiten por los mismos recursos. Un titular sobre el tamaño de los pesos no indica si toda la aplicación funcionará con comodidad bajo carga.
Por eso, un presupuesto ilustrativo debería empezar midiendo la memoria del proceso. Registra el estado en reposo, el máximo durante una petición representativa y el estado tras varias peticiones. Prueba las longitudes de contexto y los tamaños que realmente aportarán los usuarios, no una instrucción diminuta elegida porque cabe fácilmente.
La misma disciplina se aplica al tiempo. El arranque, el procesamiento de la instrucción y la generación son esperas distintas. Un modelo que genera tokens rápidamente tras una demora larga puede parecer lento en una aplicación interactiva; una tarea por lotes puede priorizar los elementos completados por hora. Elige la medida adecuada a la interacción.
Para una función de audio, incluye todo el recorrido hasta obtener un resultado utilizable. Para una función visual, incluye la gestión de imágenes. Para una función de decisión, incluye la validación y la entrega a la acción. Son requisitos de evaluación que tú defines, no cifras de rendimiento aportadas por el lanzamiento.
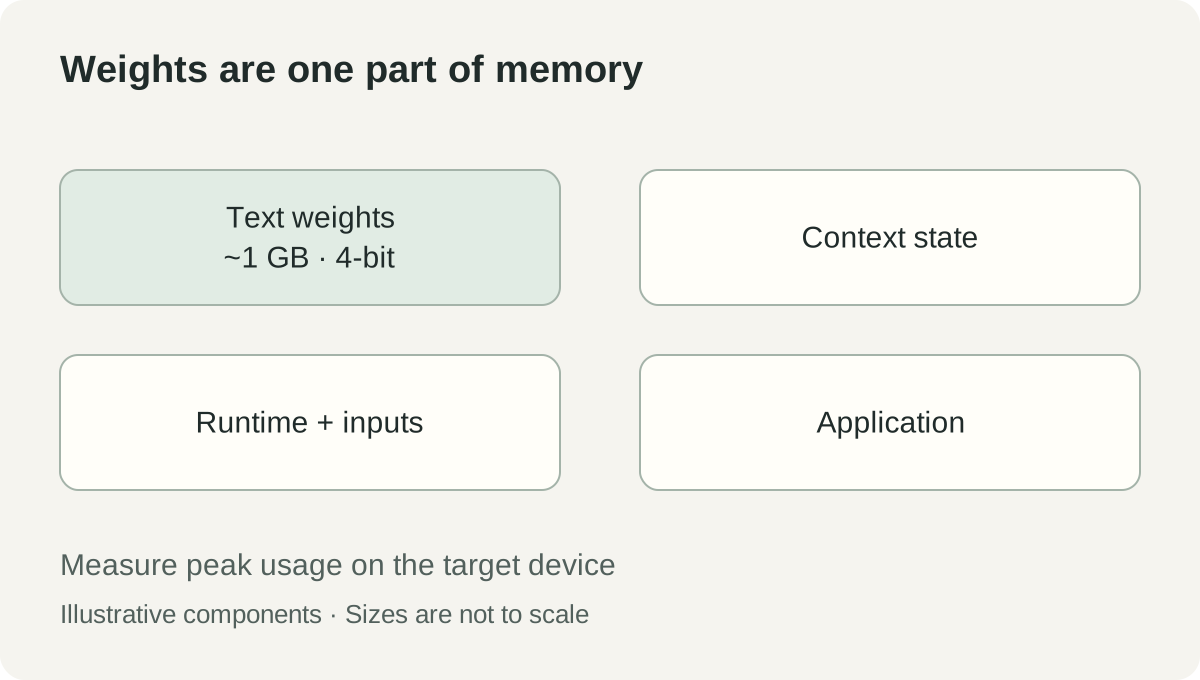 Diagrama original de presupuesto de memoria. Las anchuras son ilustrativas y no representan proporciones medidas; la cifra aproximada de 1 GB corresponde al tamaño publicado por Liquid para el modelo de texto a 4 bits, no a la memoria total de la aplicación. Fuente.
Tres aplicaciones ilustrativas exponen compromisos diferentes
Un asistente documental puede separar la lectura de la decisión
Imagina una aplicación para una pequeña empresa que recibe fotografías de recibos. Una tarea consiste en leer el comercio, la fecha y el importe visibles. Otra es decidir si el documento está lo bastante completo para que lo revise una persona. Esos resultados merecen validaciones separadas, aunque un modelo contribuya a ambos.
Una vía de visión y lenguaje podría responder preguntas sobre la imagen; una vía de decisión podría evaluarse para una comprobación acotada de integridad. La aplicación debería conservar la imagen y distinguir los campos extraídos de los datos contables aceptados. Una fecha ausente debe seguir ausente hasta que alguien la resuelva.
Prepara un conjunto de evaluación ilustrativo con imágenes claras y borrosas, diseños poco habituales y recibos en los idiomas reales de trabajo. Mide errores por campo y carga de revisión. Una tasa global alta puede ocultar un error recurrente en el campo más importante para el negocio.
El resultado útil del producto es una cola de revisión más breve y clara. Importa menos que el modelo produzca una explicación elegante que permitir al revisor inspeccionar la fuente y corregir los campos. Esa prioridad ayuda a elegir entre lenguaje abierto y una interfaz de decisión más restringida.
Una interfaz hablada puede empezar con pocas acciones permitidas
Considera un asistente manos libres ilustrativo para una aplicación local. El usuario puede pedir buscar un elemento, leer su estado o preparar el borrador de una acción. El audio resulta útil cuando hablar es más fácil que escribir, pero la aplicación sigue necesitando saber qué puede modificar una petición.
Empieza con un vocabulario pequeño de acciones y una confirmación visible. Por ejemplo, localizar un registro puede ejecutarse inmediatamente sobre datos autorizados, mientras que modificarlo puede mostrar una propuesta para revisar. La política corresponde a la aplicación, no a las palabras que casualmente produzca el modelo.
Prueba las condiciones acústicas reales. Las conversaciones de fondo, las intervenciones breves y los nombres parecidos pueden generar fallos distintos de una frase grabada limpiamente. Incluye casos cuya respuesta correcta sea volver a preguntar. Una respuesta hablada fluida vale menos que una interacción correcta y recuperable.
Un candidato omni cobra relevancia cuando la petición depende de lo visible y de lo dicho. Si todas las tareas usan únicamente voz, añadir procesamiento visual necesita una razón. Aquí la familia de modelos puede ayudar a mantener la función proporcionada al trabajo.
Una herramienta local de soporte puede distribuir trabajo conservando una salida
Una aplicación ilustrativa de soporte podría elegir entre tres colas a partir de una incidencia y una captura adjunta. Una decisión acotada puede encajar más directamente que una respuesta larga que después deba interpretar la aplicación. La pregunta útil es si la ruta elegida resulta suficientemente fiable con una tasa aceptable de revisión.
Conserva un resultado explícito de «necesita revisión». Prueba incidencias que no encajen en ninguna cola, capturas contradictorias y casos con contexto insuficiente. La aplicación no debería obligar al modelo a inventar una ruta válida porque el esquema exija una.
Compara el modelo con una referencia sencilla, como las reglas existentes y la asignación humana. Si esa referencia ya resuelve una categoría con fiabilidad, el modelo debe mejorar otra parte del proceso. La novedad no es un criterio de aceptación.
Para cada error, conserva suficiente contexto autorizado para entender su causa. Separa problemas de entrada, categorías ambiguas y errores del modelo. Esa distinción indica si conviene mejorar el modelo, cambiar las definiciones de las colas o pedir mejores fuentes.
Las tablas comparativas son un punto de partida para tu propia carga
La ficha oficial de LFM3-1.7B, consultada el 2 de noviembre, recomienda recuperación de información o búsqueda para trabajos intensivos en conocimientos y advierte sobre la programación con agentes y el razonamiento complejo de varios pasos a este tamaño. Orienta sobre cómo situarlo en un sistema mayor, aunque las tablas del proveedor muestren avances.
Un resultado comparativo responde a una pregunta concreta bajo una configuración determinada. Tu aplicación añade datos, herramientas, distribución de idiomas y costes de fallo propios. Un modelo puede mejorar en un agregado público y seguir necesitando trabajo cuidadoso en las pocas categorías que tus usuarios encuentran a diario.
Separa tres comparaciones en el piloto. Primero, la calidad de la tarea frente al proceso actual. Segundo, el coste completo de recursos en el dispositivo previsto. Tercero, el trabajo necesario para recuperarse de un fallo. Pueden producir ganadores distintos.
Un modelo generalista en la nube, por ejemplo, puede servir de escalado cuando el especialista local no responde. Esa combinación exige una política de datos y una experiencia de usuario explícitas. La operación local es una elección de despliegue que debes verificar en toda la aplicación, incluidos registros y peticiones de respaldo.
El ajuste fino debería responder a una carencia demostrada. Si los fallos proceden de fuentes ausentes o definiciones de salida poco claras, más entrenamiento puede reforzar la tarea equivocada. Define el contrato e inspecciona los errores antes de decidir que personalizar es el siguiente paso útil.
El primer piloto debería caber en una página de decisiones
La ficha oficial del modelo de texto enlaza formatos e instrucciones de ejecución. Empieza ahí para la combinación exacta de modelo y entorno; utiliza el Playground oficial para una comprobación inicial si encaja con tu política de datos. Ninguna vía sustituye a probar el despliegue que piensas entregar.
- Escribe el contrato de entrada y salida. Define el material permitido, el resultado esperado y la opción explícita de revisión. Elige una tarea en vez de una personalidad de asistente general.
- Elige candidato y revisión. Ajusta modalidad y función de salida; después registra modelo, licencia y entorno compatible. Lee sus limitaciones específicas.
- Crea un conjunto representativo. Incluye casos normales, difíciles, peticiones no admitidas y ejemplos en los idiomas reales. Separa el material de evaluación reservado de los datos de personalización.
- Ejecuta el inicio rápido documentado en un entorno aislado. Sigue las instrucciones vigentes de dependencias y formato. Confirma la identidad del modelo devuelta antes de comparar resultados.
- Mide todo el recorrido de la aplicación. Registra corrección, tasa de revisión, latencia y memoria máxima con entradas realistas. Anota hardware y configuración junto a las cifras.
- Prueba la vía de incertidumbre. Confirma que información ausente, salida inválida y fallo de ejecución conducen a un estado comprensible de revisión o reintento.
- Decide qué especializar después. Usa las categorías recurrentes de error para elegir mejores entradas, reglas más claras, recuperación de información, ajuste fino u otro modelo.
En la primera pasada basta una decisión sencilla: este candidato sirve para esta tarea en este dispositivo, con estas condiciones de revisión. Una conclusión acotada y reproducible vale más que afirmar en general que la IA local ya sirve para todo.
Un modelo pequeño se gana su lugar completando un trabajo definido
LFM3 amplía las opciones para desarrolladores que quieren texto, visión, sonido o decisiones acotadas cerca de la aplicación. Su importancia práctica consiste en poder elegir entre esas funciones y evaluarlas como partes de un producto.
El siguiente paso es precisar un trabajo lo suficiente para medir calidad, memoria y recuperación. Un especialista resulta útil cuando toda la aplicación puede confiar en su contrato y sabe qué hacer si no puede responder.
Fuentes
- Liquid AI: presentación de LFM3, 27 de octubre de 2026; consultado el 2 de noviembre de 2026.
- Catálogo de modelos de Liquid AI y precios y licencias, consultados el 2 de noviembre de 2026.
- Ficha oficial de LFM3-1.7B, consultada el 2 de noviembre de 2026.
- Ficha oficial de d1-2B, consultada el 2 de noviembre de 2026.
Conserva el material que sustenta una decisión
Telli.sh es una opción para conservar material autorizado de las fuentes junto a las notas que has revisado. Crea un espacio de notas.