Czy 30 GPU w jednym serwerze skróci kolejki do AI w laboratorium?
W LIQID UltraStack osobne modele dostają własne karty AMD Instinct MI350P. Porównujemy test na 20 GPU z prognozą dla 30 i pokazujemy, jak zmierzyć rzeczywisty czas oczekiwania badaczy.
O dziewiątej rano jeden zespół badawczy zaczyna wydobywać tekst z wczorajszych skanów. Drugi wysyła notatki do tłumaczenia, a trzeci chce szybko uzyskać odpowiedzi na pytania o instrukcję przyrządu. Jeśli te zadania korzystają z jednej kolejki wnioskowania, krótkie pytanie może utknąć za dużą partią dokumentów. Gdy odpowiedź się pojawi, osoba, która jej potrzebowała, może już znowu przeglądać PDF.
12 listopada 2026 r. dostawca infrastruktury LIQID opisał konfigurację UltraStack, która łączy od 4 do 30 akceleratorów AMD Instinct MI350P z jednym dwugniazdowym serwerem na AMD EPYC 9005. W opublikowanej architekturze na każdej karcie działa jedna instancja modelu. Jedna karta może wciąż rozpoznawać tekst, gdy osobne GPU tłumaczą lub odpowiadają na pytania. LIQID zapowiedział pokaz na SC26 w Chicago podczas wystawy zaplanowanej na 17–19 listopada. Komunikat LIQID z 12 listopada i oficjalne zdjęcia systemu · Daty SC26
Taki układ ma sens, gdy laboratorium potrzebuje kilku wyników na czas, a każdy model mieści się na jednej karcie. Zacznij od czasu, który odczuwa użytkownik. Potem sprawdź, jaką część oczekiwania wyeliminowałyby osobne GPU, jakie ograniczenie pojawiłoby się w następnej kolejności i czy poprawa uzasadnia zużycie energii i koszt systemu. Większość tego można sprawdzić na znacznie mniejszym zestawie niż konfiguracja z pełną obsadą kart.
Każde GPU ma własne 144 GB pamięci
W opublikowanym układzie LIQID serwer AMD EPYC łączy się z kartami MI350P przez sieć połączeń PCIe Gen 5. Karty mogą znajdować się w oddzielnych obudowach podłączonych do serwera. Dla każdej MI350P AMD podaje 144 GB dedykowanej pamięci HBM3E i interfejs PCIe 5.0 x16. Przy jednej instancji na kartę model korzysta z pamięci przydzielonego GPU. Każda instancja obsłuży wiele żądań w granicach oprogramowania do obsługi modeli i dostępnej pamięci. Karta katalogowa LIQID UltraStack · Specyfikacja AMD MI350P
Dwadzieścia kart ma łącznie 2,88 TB HBM3E w jednostkach dziesiętnych. Ta wartość pomaga policzyć, ile oddzielnych instancji modeli może obsłużyć system. Dla zadania na siódmej karcie punktem wyjścia nadal jest 144 GB. Jeśli model mieści się dopiero po rozdzieleniu parametrów i stanu roboczego między kilka GPU, wybierz strategię podziału i osobno zmierz jej działanie. Opublikowane skalowanie LIQID dotyczy niezależnych instancji na osobnych kartach. Konfiguracja testowa i dane pamięciowe LIQID
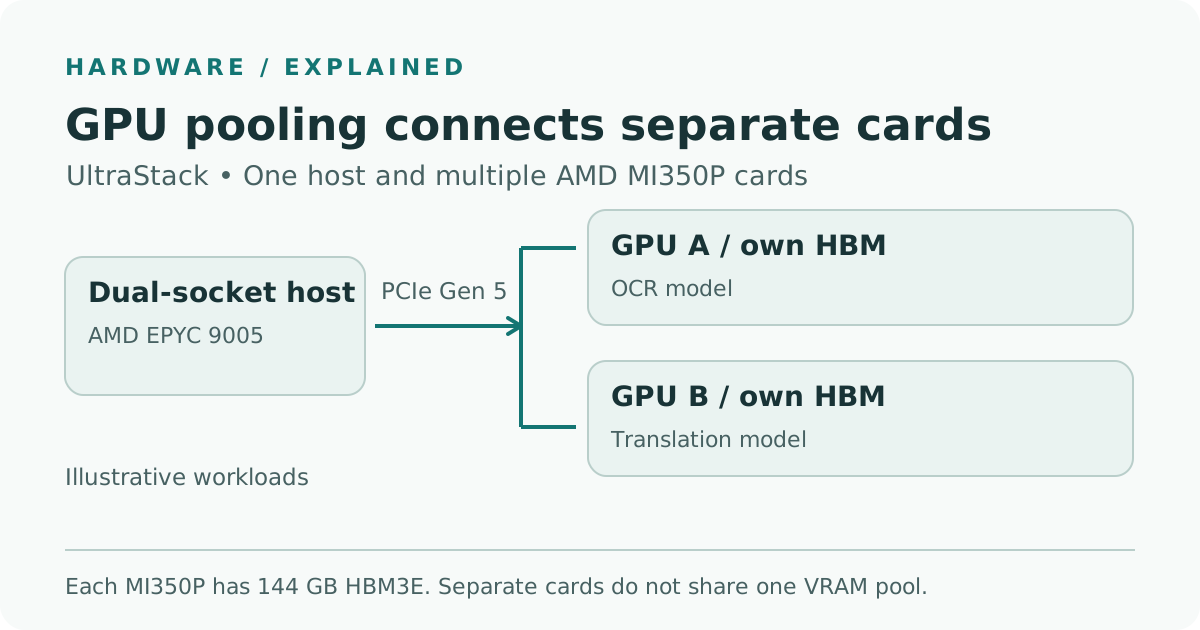
Ilustracja Telli.sh na podstawie opisu sprzętu LIQID i specyfikacji kart AMD. Schemat pokazuje przykład niezależnej obsługi zadań i pomija obudowy oraz urządzenia peryferyjne serwera.
Liczba parametrów pomaga zawęzić wybór, ale dwa modele o tej samej liczbie parametrów mogą mieć różne wymagania pamięciowe. Zacznij od konkretnych wag i ich precyzji. Następnie uwzględnij środowisko wykonawcze i pamięć podręczną, w której model może przechowywać wcześniejsze tokeny w trakcie generowania. Jeżeli usługa przyjmuje równolegle wiele długich żądań, uruchom wybrany model i zmierz zużycie pamięci przy takiej mieszance. Krótkie polecenie na bezczynnej karcie pokaże, czy usługa się uruchamia. Dłuższa próba z najdłuższymi akceptowanymi wejściami pokaże, czy nadal przyjmuje obciążenie.
Niezależne kolejki pomagają, gdy zadania napływają w różnym tempie
Weźmy archiwum uniwersyteckie, które cyfryzuje wywiady i dokumentację papierową. W próbie jeden GPU może obsługiwać model OCR, drugi transkrybować wywiady, a trzeci wykonywać krótkie tłumaczenia. Czwartą kartę można po tygodniu obserwacji przeznaczyć na drugą instancję najbardziej obciążonej usługi. Przydziel każdej usłudze własną kolejkę i określ, ile zadań może przyjąć naraz. Zaległe skany rzadziej opóźnią wtedy krótkie tłumaczenie w walce o ten sam akcelerator.
Załóżmy, że archiwum ma przetłumaczyć tekst po OCR. Poszczególne etapy mogą zachodzić na siebie dla różnych dokumentów. Pierwszy dokument trafia do tłumaczenia, gdy drugi przechodzi przez OCR. Tłumaczenie konkretnego dokumentu nadal wymaga wyniku rozpoznania jego tekstu. Zmierz czas od przesłania tego dokumentu do użytecznego wyniku i policz dokumenty ukończone w całym procesie. Nawet gdy w ciągu godziny uda się przetworzyć więcej dokumentów, pojedynczy tłumacz nadal może długo czekać na daną stronę.
Wyobraźmy sobie inną mieszankę. Laboratorium inżynieryjne korzysta za dnia z asystenta do dokumentacji, a nocą przetwarza stare logi z przyrządów. Asystent w dzień musi przewidywalnie szybko odpowiadać na pytania badaczy. Zadanie nocne ma termin ukończenia i często znosi przerwy. Przed stałym przypisaniem kart do usług zmierz, jaką część czasu każdy GPU poświęca na te zadania. Jeśli asystent jest zwykle bezczynny, a po zebraniu laboratorium dostaje falę pytań, stałe utrzymywanie zapasowej instancji kosztuje także wtedy, gdy ruch jest mały. Punktem odniesienia może być wdrożenie, które już obsługuje taki szczyt za pomocą harmonogramu lub odrębnych kolejek.
Rozmieszczenie modeli wpływa również na odzyskiwanie po awarii. Jeden serwer upraszcza część konfiguracji, a wszystkie jego usługi pozostają od niego zależne. Ustal, które zadania mogą poczekać po konserwacji, które muszą wrócić pierwsze i które potrzebują drugiej lokalizacji. W procesie obsługi dokumentów zapisuj wyniki pośrednie, żeby po restarcie wznowić pracę od zakończonego wydobywania tekstu. Dla pracy interaktywnej uzgodnij dopuszczalną przerwę lub zapewnij zastępczy punkt dostępu. Liczba kart na głównym serwerze określa możliwości wnioskowania podczas normalnej pracy. Czas przywrócenia działania wymaga osobnego testu.
LIQID zmierzył 89 000 tokenów wyjściowych na sekundę przy 20 GPU
Materiał LIQID o przepustowości opisuje model klasy 7B przy precyzji FP4 i deklarowanej współbieżności 128. Każdy GPU obsługiwał własną instancję. Dla 20 GPU LIQID podał około 89 000 tokenów wyjściowych na sekundę łącznie. Szacunek na poziomie około 133 000 tokenów wyjściowych na sekundę dla 30 GPU wynika z ekstrapolacji skalowania zaobserwowanego w pomiarze na 20 kartach. Obie liczby opisują łączny wynik konfiguracji zmierzonej lub prognozowanej. W przypadku jednego żądania badacza liczą się jego własny czas w kolejce, przetwarzanie wejścia i tempo generowania. Materiał LIQID o przepustowości i metodyce
| Test LIQID | Liczba GPU | Łączne tokeny wyjściowe/s | Podstawa |
|---|---|---|---|
| Klasa 7B, FP4 | 1 | 4 653 | Pomiar LIQID |
| Klasa 7B, FP4 | 10 | 44 383 | Pomiar LIQID |
| Klasa 7B, FP4 | 20 | Około 89 000 | Pomiar LIQID |
| Klasa 7B, FP4 | 30 | Około 133 000 | Prognoza LIQID na podstawie 20 GPU |
| Klasa 72B, FP8, limity opóźnienia interaktywnego | 8 | 1 256 | Odrębny pomiar LIQID |
W odrębnym teście 72B FP8 celem były najwyżej dwie sekundy do pierwszego tokena w 99. percentylu oraz co najmniej 30 tokenów wyjściowych na sekundę na użytkownika. Dla tego eksperymentu LIQID podaje pomiary na 2, 4 i 8 kartach. Wielkość modelu, precyzja i warunki obsługi różnią się od próby przepustowości 7B. Potraktuj wynik interaktywny jako odniesienie dla tej klasy testu, a następnie zastosuj własne oczekiwania dotyczące opóźnienia do spodziewanych zapytań i współbieżności. Metodyka LIQID i wyniki interaktywne
Wyniki 7B przemawiają za powtórzeniem tego samego testu przy dodawaniu identycznych instancji. Dla zespołów planujących obciążenia mieszane pozostaje odrębne pytanie. Co się stanie, gdy część czasu zajmie odczyt wielu małych plików, tworzenie kontekstu z danych w pamięci masowej albo oczekiwanie, aż CPU przygotuje obrazy? Dwukrotnie odtwórz ten sam przebieg ruchu przy tych samych modelach i liczbie kart. Najpierw sprawdź każdą usługę osobno, a potem uruchom pełną mieszankę. Jeśli po połączeniu kolejek rośnie czas oczekiwania, choć wykorzystanie GPU pozostaje niskie, sprawdź CPU serwera, aktywność systemu plików i trasowanie żądań przed dodaniem akceleratorów.
Zmierz użyteczną pracę przy ustalonym limicie opóźnienia
Zacznij od testu, który wykona obecne wdrożenie. Weź na przykład reprezentatywny zestaw 200 zatwierdzonych dokumentów o znanych językach i liczbie zeskanowanych stron. Równolegle z przetwarzaniem partii odtwórz zanonimizowany log czasu napływu żądań interaktywnych. Zachowaj tę samą mieszankę danych w obu systemach. Jeśli zmiana sprzętu lub oprogramowania wymaga innej precyzji, ponownie sprawdź jakość na tej samej próbce. Policz tylko wyniki ukończone i zaakceptowane według zwykłych kryteriów zespołu.
- Określ, jak wygląda dobry wynik. Dla asystenta ustal cele pierwszej odpowiedzi i pełnej obsługi. Na przykład pierwszy token powinien pojawić się w ciągu dwóch sekund na 95. percentylu dla wybranej próbki interaktywnej. Dla przetwarzania wsadowego wybierz dobowy termin i minimalną liczbę stron, które przejdą weryfikację. Są to przykładowe cele proponowanej próby. W osobnym eksperymencie 72B LIQID użył limitu czasu do pierwszego tokena opartego na 99. percentylu.
- Zapisz, na co idzie czas każdego żądania. Rejestruj moment pojawienia się żądania, rozpoczęcia przetwarzania, pierwszego wyniku i zakończenia. Oznacz rodzaj zadania i zapisuj ponowienia. Znaczniki czasu pozwalają porównać odrębnie oczekiwanie w kolejce i czas obsługi. Szybkie wnioskowanie może ukryć długą kolejkę w pojedynczej wartości czasu całkowitego.
- Zmień jeden parametr i odtwórz ruch. Porównaj wspólną kolejkę z oddzielnymi kolejkami przy tych samych instancjach modeli na tych samych kartach. Zmianę przypisania kart zbadaj następnie w oddzielnym eksperymencie. Zachowaj limity zapytań i odpowiedzi, kolejność wejść i kryteria jakości. Każdy test uruchom po takiej samej rozgrzewce. Sprawdź zarówno szczyt, jak i przeciętny ruch. Moment nadejścia dużej partii w niewłaściwej chwili powinien ujawnić działanie oddzielnych kolejek.
- Zestaw wynik z pomiarami serwera i energii. W tym samym oknie zapisuj użycie i pamięć akceleratorów, CPU i RAM serwera, odczyty i zapisy oraz moc na wejściu systemu. Raportuj 95. percentyl czasu ukończenia każdego typu zadania, liczbę poprawnych stron lub żądań na godzinę oraz energię na zaakceptowany wynik. Obok percentyli sprawdź odrzucone żądania i przekroczenia czasu, żeby odrzucona praca pozostała widoczna.
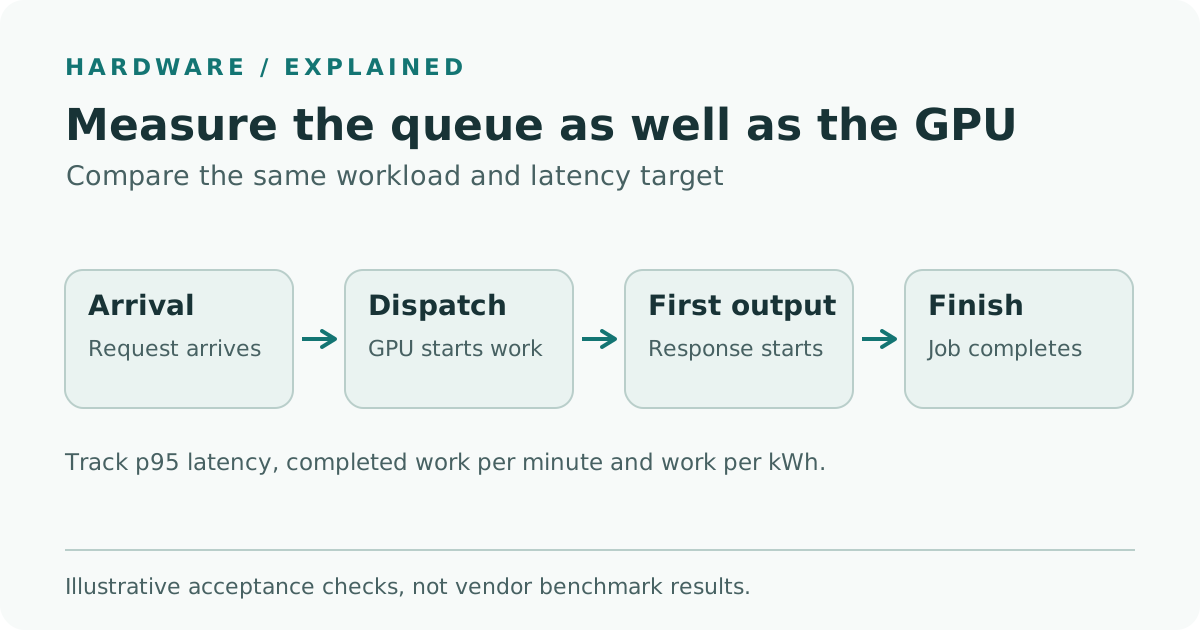
Ilustracja Telli.sh przedstawiająca proponowany test odbiorczy. Zmiana czasu oczekiwania, pierwszej odpowiedzi lub zakończenia może wskazywać odmienne ograniczenia.
Narysuj osobny rozkład opóźnień dla każdej usługi. P95 to czas, w którym kończy się 95 procent zmierzonych zdarzeń. Może się zmieniać także przy stałej medianie, co ma znaczenie, jeśli analityk regularnie trafia na godziny największego ruchu. Zapisz liczebność każdej próby. Percentyl z pięciu nocnych zadań mówi o czymś innym niż percentyl z kilkuset żądań interaktywnych. Trwały spadek czasu oczekiwania obciążonej usługi przy porównywalnej jakości i mniejszej liczbie przekroczeń czasu jest mocniejszym argumentem za osobną kartą niż maksymalna przepustowość.
Porównanie wymaga też spójnego zakresu pomiaru. Oceniając efektywność energetyczną, licz użyteczne wyniki w ustalonym oknie i mierz to samo wyposażenie w obu konfiguracjach. Gdy miernik obejmuje tylko serwer i obudowy GPU, opisz wynik jako energię zużywaną przez system informatyczny. Jeśli do porównania włączasz współdzieloną pamięć masową lub chłodzenie, uwzględnij je tak samo w obu rozwiązaniach. Przy usłudze całodobowej mierz także moc w spoczynku. Szybki system potrzebuje mniej minut aktywnej pracy na zadanie, lecz instalacja, która przez noc czeka przy większym poborze jałowym, może zużywać więcej energii w skali doby.
Szacunek 22 kW uwzględnij w ocenie miejsca instalacji
LIQID podaje około 22 kW dla pełnego, chłodzonego powietrzem systemu z 30 GPU. AMD określa maksymalny typowy pobór mocy karty MI350P na 600 W i przewiduje ustawienie 450 W. Iloczyn 30 i 600 W daje 18 kW dla samych kart przy podanej mocy. Deklarowane 22 kW dotyczy większego zakresu całego systemu. Zasilanie obiektu, wyposażenie szafy i wydajność chłodzenia zależą od instalacji. Praca przy 450 W również może zmieniać użyteczną przepustowość. Jeśli dostawca obsługuje oba ustawienia w wycenianej konfiguracji, porównaj je przy tym samym obciążeniu i kryteriach jakości. Informacje LIQID o mocy systemu · Specyfikacja karty AMD MI350P
Przed wyborem większej konfiguracji włącz do rozmowy zespół obsługi obiektu. Sprawdź dokładną liczbę obudów, obciążalność obwodów w trybie normalnym i redundantnym, odprowadzanie ciepła w warunkach panujących na wlocie i możliwość nagłego powrotu do pełnego obciążenia po restarcie. Z oferty ustal, kto odpowiada za serwis, wsparcie i regulację mocy. Zestaw to z kosztem długiego oczekiwania na przetworzenie dokumentów. Jeden host może ograniczyć liczbę zarządzanych serwerów, ale wymagana gęstość mocy może zawęzić wybór pomieszczeń.
LIQID oferuje systemy od 4 do 30 GPU w ramach zamówień u partnerów, pod warunkiem dostępności magazynowej. Strona produktu opisuje realizację w ciągu 4–6 tygodni i wiąże reklamowany czterotygodniowy termin z potwierdzeniem zamówienia zakupu. Poproś o datowaną wycenę konfiguracji i gwarantowany termin dostawy do miejsca instalacji. LIQID podał 17 listopada jako początek swojej wystawy na SC26 w McCormick Place. Informacje LIQID o zamówieniach przez partnerów i dostawach · Zapowiedź LIQID na SC26
Za jakie skrócenie oczekiwania warto zapłacić?
Wydzielony akcelerator do tłumaczeń może się opłacać, jeśli kolejny zespół potrzebuje przetłumaczonych fragmentów od razu. Ta sama karta mogłaby stać bezczynna przez większość tygodnia, gdy wszystkie tłumaczenia mogą poczekać do jutra. Zacznij od najmniejszej konfiguracji, na której można odtworzyć jednoczesne zadania w laboratorium, i powtórz najbardziej obciążony okres kilka razy. Dodawaj zasoby tam, gdzie krótsze oczekiwanie wciąż przekłada się na lepszy wynik. Dla archiwum kryterium odbioru może być konkretne. Technik dostaje odpowiedzi na czas, a pełna dzienna partia ze skanera jest gotowa do przekazania.
Źródła
- Zapowiedź LIQID na SC26 i oficjalne zdjęcia UltraStack z 12 listopada 2026 r.
- Strona LIQID UltraStack z AMD Instinct MI350P, zamówienia i zasilanie, sprawdzona 15 listopada 2026 r.
- Karta katalogowa LIQID UltraStack, sprawdzona 15 listopada 2026 r.
- Metody i wyniki trzeciej fazy testów LIQID, sprawdzone 15 listopada 2026 r.
- Specyfikacja karty AMD Instinct MI350P, sprawdzona 15 listopada 2026 r.
- Oficjalne daty konferencji i wystawy SC26 w 2026 r.
Aby zachować notatki z prób, wykresy i decyzje wdrożeniowe w jednym miejscu z wyszukiwarką, załóż konto Telli.sh.