서버 한 대에 GPU 30장을 연결하면 연구실의 AI 대기가 줄어들까?
LIQID UltraStack은 모델마다 AMD Instinct MI350P 카드를 따로 배정합니다. 제조사의 GPU 20장 실측과 30장 추정치를 비교하고, 연구자가 실제로 얼마나 기다리는지 측정하는 방법을 알아봅니다.
오전 9시, 한 연구팀이 어제 스캔한 자료에서 텍스트를 추출합니다. 다른 팀은 메모를 번역하려고 제출하고, 또 다른 팀은 장비 매뉴얼에 관해 짧게 묻고 싶어 합니다. 이 작업들이 추론 대기열 하나를 공유하면 짧은 질문도 대량 문서 처리 뒤에서 기다릴 수 있습니다. 답이 나올 때쯤 질문을 던진 사람은 이미 PDF를 직접 펼쳤을지도 모르죠.
인프라 업체 LIQID는 2026년 11월 12일, 듀얼 소켓 AMD EPYC 9005 호스트 한 대에 AMD Instinct MI350P 가속기 430장을 연결하는 UltraStack 구성을 소개했습니다. 공개된 서빙 구성은 카드마다 모델 인스턴스 하나를 배치합니다. 한 GPU가 OCR을 처리하는 동안 별도 GPU가 번역이나 질의응답을 맡을 수 있습니다. LIQID는 11월 1719일 시카고에서 열리는 SC26 전시 기간에 시연한다고 발표했습니다. LIQID 11월 12일 발표와 공식 시스템 이미지 · SC26 일정
연구실에서 여러 작업을 제시간에 끝내야 하고 각 모델이 카드 한 장에 들어간다면 이 구성을 검토할 만합니다. 먼저 사용자가 실제로 기다리는 시간을 재세요. 별도 GPU를 쓰면 다른 작업 탓에 생긴 대기가 얼마나 줄는지, 다음에는 어디가 병목이 되는지, 개선 폭이 전력과 비용을 정당화하는지 확인합니다. 대부분은 카드를 최대한 채운 구성보다 훨씬 작은 시험으로도 확인할 수 있습니다.
GPU마다 144GB 전용 메모리가 있다
LIQID가 공개한 구성에서 AMD EPYC 호스트는 PCIe Gen 5 패브릭을 통해 MI350P 카드와 연결됩니다. 카드는 호스트에 연결된 별도 GPU 섀시에 들어갈 수 있습니다. AMD가 명시한 MI350P 카드당 사양은 전용 HBM3E 144GB와 PCIe 5.0 x16 인터페이스입니다. 카드당 모델 하나를 배치하면 개별 모델은 자신에게 배정된 GPU의 메모리를 씁니다. 각 모델 인스턴스는 서빙 소프트웨어와 메모리 한도가 허용하는 범위에서 여러 요청을 처리할 수 있습니다. LIQID UltraStack 데이터시트 · AMD MI350P 사양
십진 단위로 계산하면 카드 20장에 있는 HBM3E는 모두 2.88TB입니다. 이 수치로 시스템에서 별도 모델 인스턴스를 몇 개까지 실행할지 가늠할 수 있습니다. 일곱 번째 카드에 배정된 개별 작업의 출발점은 여전히 144GB입니다. 매개변수와 작업 상태를 여러 GPU에 나눠야만 모델이 들어간다면 분산 방식을 따로 평가하고 직접 벤치마크하세요. LIQID가 발표한 확장 성능은 여러 카드에서 독립 인스턴스를 돌린 경우입니다. LIQID 시험 설정과 메모리 수치
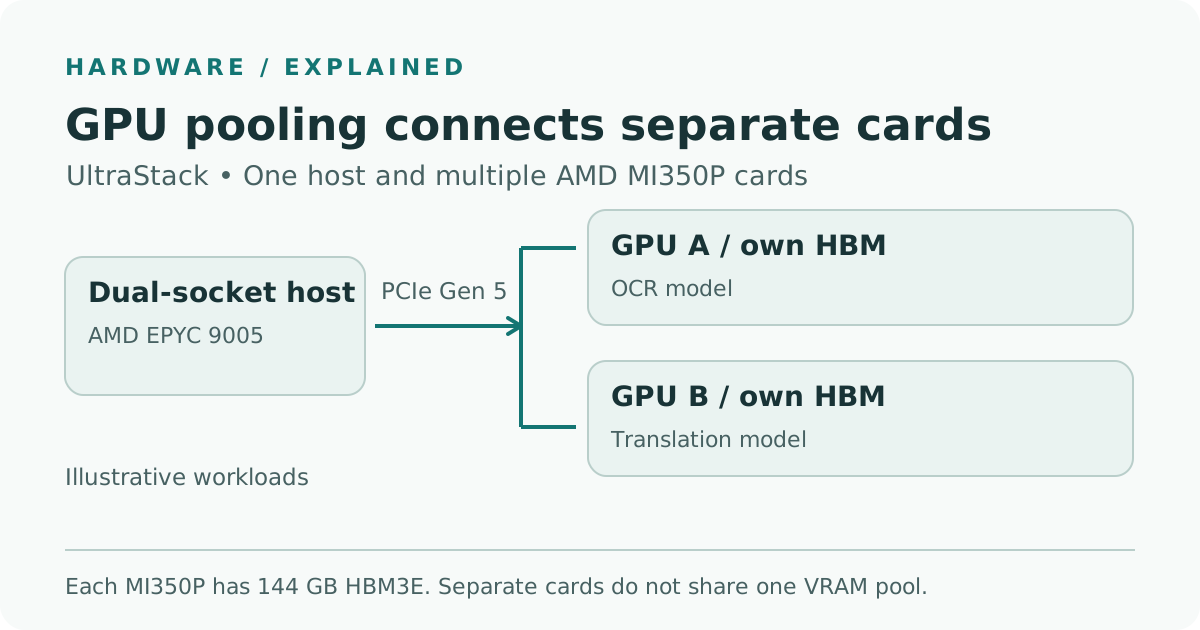
LIQID의 하드웨어 설명과 AMD의 카드 사양을 바탕으로 그린 Telli.sh 도식입니다. 모델을 독립적으로 서빙하는 예시에서 섀시와 호스트 주변 장치는 생략했습니다.
모델의 매개변수 수로 후보를 추릴 수 있지만, 매개변수 수가 같아도 필요한 메모리는 다를 수 있습니다. 먼저 실제로 사용할 가중치와 정밀도를 확인하세요. 런타임과 모델이 다음 토큰을 생성하며 앞선 토큰을 기억하는 데 쓰는 캐시 용량도 잡아 둡니다. 긴 요청을 여러 건 동시에 받는 서비스라면 후보 모델을 실제로 구동해 그 요청 조합에서 메모리를 관찰하세요. 다른 작업이 없는 카드에서 짧은 프롬프트로 시험하면 서비스가 시작되는지 알 수 있습니다. 허용하는 입력 중 가장 긴 것을 계속 넣어 봐야 요청을 꾸준히 받을 수 있는지 판단할 수 있습니다.
작업이 각기 다른 속도로 들어올 때 독립 대기열이 도움이 된다
인터뷰 음성과 종이 기록을 함께 디지털화하는 대학 기록관을 생각해 보세요. 시험에서 GPU 한 장은 문서 OCR 모델, 한 장은 인터뷰 전사, 세 번째는 짧은 번역에 쓸 수 있습니다. 일주일 정도 사용량을 본 뒤 네 번째 카드를 가장 바쁜 서비스의 두 번째 인스턴스에 배정할 수도 있죠. 서비스마다 자체 대기열을 두고 한 번에 받아들일 작업량을 정합니다. 그러면 스캔 문서가 밀릴 때 같은 가속기를 점유해 짧은 번역을 늦출 가능성이 줄어듭니다.
기록관에 OCR을 마친 텍스트를 번역해 달라는 요청이 들어왔다고 해 보세요. 문서가 서로 다르면 여러 단계를 겹쳐 실행할 수 있습니다. 첫 번째 문서가 번역으로 넘어가는 동안 두 번째 문서의 OCR을 시작하는 식입니다. 그 문서의 번역은 여전히 해당 문서의 OCR 출력이 나와야 시작됩니다. 문서 하나가 업로드된 때부터 쓸 만한 결과가 나올 때까지의 시간과 전체 처리 단계에서 완료한 문서 수를 함께 측정하세요. 시간당 완료 문서가 늘어도 번역을 기다리는 개인은 여전히 한 페이지를 오래 기다릴 수 있습니다.
다른 예로, 공학 연구실이 낮에는 문서 도우미를 쓰고 밤에는 오래된 계측 로그를 처리한다고 가정해 보세요. 낮에 사용하는 도우미는 연구자가 질문한 뒤 첫 응답을 예측 가능한 시간 안에 제공해야 합니다. 야간 작업은 완료 마감이 있고, 중간에 멈췄다가 계속해도 되는 경우가 많습니다. 카드마다 영구 배정하기 전에 각 GPU가 서비스별로 사용하는 시간의 비율을 측정하세요. 도우미가 대부분의 시간에는 유휴 상태이고 연구 회의 직후만 요청이 몰린다면, 두 번째 복제본을 상시 유지하는 데 한산한 시간에도 비용이 듭니다. 예약 작업이나 별도 대기열로 이미 이런 집중 요청을 처리하는 구성은 좋은 비교 대상입니다.
모델 배치는 복구에도 영향을 줍니다. 호스트 한 대를 사용하면 일부 설정이 단순해지고, 동시에 모든 서비스가 그 호스트에 의존합니다. 점검이 끝난 뒤 어느 작업은 기다려도 되는지, 어느 작업을 먼저 복구해야 하는지, 어디에 보조 서빙 위치가 필요한지 적어 두세요. 문서 처리라면 중간 결과를 저장해 다시 시작했을 때 이미 끝난 추출 단계 다음부터 진행할 수 있게 하세요. 대화형 작업에는 허용 중단 시간을 합의하거나 다른 엔드포인트를 준비합니다. 주 호스트의 카드 수는 정상 운영 중 추론 용량을 보여 줍니다. 복구 시간은 별도 시험으로 확인해야 합니다.
LIQID는 GPU 20장에서 초당 출력 토큰 약 89,000개를 측정했다
LIQID 처리량 자료의 조건은 7B급 모델, FP4 정밀도, 동시성 128입니다. GPU마다 별도의 모델 인스턴스를 서빙했습니다. 20장 전체에서 LIQID가 보고한 값은 초당 출력 토큰 약 89,000개입니다. GPU 30장에서 초당 약 133,000개라는 수치는 20장 시험에서 관측한 확장 추세를 외삽한 추정입니다. 두 수치 모두 시험이나 추정 구성의 전체 출력량을 나타냅니다. 연구자가 요청을 한 건 보냈을 때 겪는 것은 그 요청의 대기 시간, 입력 처리 시간, 생성 속도입니다. LIQID 처리량 자료와 측정 방법
| LIQID 시험 | GPU 수 | 전체 초당 출력 토큰 | 근거 |
|---|---|---|---|
| 7B급, FP4 | 1 | 4,653 | LIQID 실측 |
| 7B급, FP4 | 10 | 44,383 | LIQID 실측 |
| 7B급, FP4 | 20 | 약 89,000 | LIQID 실측 |
| 7B급, FP4 | 30 | 약 133,000 | LIQID가 20장 시험에서 추정 |
| 72B급, FP8, 대화형 지연 제한 적용 | 8 | 1,256 | 별도의 LIQID 실측 |
별도의 72B FP8 시험에서는 99번째 백분위수에서 첫 토큰까지 최대 2초, 사용자 한 명당 초당 출력 토큰 30개 이상을 목표로 삼았습니다. LIQID는 이 시험에서 카드 2장, 4장, 8장의 측정값을 보고했습니다. 모델 크기, 정밀도, 서빙 조건이 7B 처리량 시험과 다릅니다. 대화형 시험 결과는 같은 유형의 시험을 설계할 때 참고하고, 실제로 예상하는 프롬프트와 동시성에는 팀의 지연 목표를 적용하세요. LIQID 벤치마크 방법과 대화형 측정 결과
7B 결과는 동일한 모델 인스턴스를 추가하면서 같은 벤치마크를 다시 돌려 볼 근거가 됩니다. 실제로 여러 작업을 혼합하려는 팀에는 별도로 볼 부분이 있습니다. 요청 처리 시간의 일부를 작은 파일 여러 개를 읽거나 저장소에서 문맥을 모으거나 CPU가 이미지를 준비하는 데 쓰면 어떻게 될까요? 모델과 GPU 수를 고정하고 같은 요청 기록을 두 번 재현하세요. 한 번은 각 서비스를 따로, 한 번은 전체 서비스를 함께 시험합니다. 같이 운영할 때 GPU 사용률은 낮은데 대기 시간만 늘면 가속기를 더하기 전에 호스트 CPU, 파일시스템 활동, 요청 라우팅을 살펴보세요.
지연 한도 안에서 쓸 수 있는 결과를 측정한다
현재 구성에서도 실행할 수 있는 시험을 먼저 고르세요. 예를 들어 사용이 승인됐고 언어와 스캔 페이지 수를 아는 대표 문서 200개를 정한 뒤, 일괄 처리와 함께 대화형 요청이 도착한 시각을 익명화한 기록을 재생할 수 있습니다. 두 시스템에 같은 입력 조합을 넣으세요. 하드웨어나 소프트웨어 변경으로 정밀도를 바꿔야 한다면 같은 샘플에서 결과 품질을 다시 확인합니다. 작업을 마치고 팀의 평소 검증을 통과한 결과만 셉니다.
- 좋은 결과의 기준을 정합니다. 도우미에서는 대화형 표본의 95번째 백분위수에서 첫 토큰이 2초 이내에 나오는 등, 첫 응답 시간과 전체 처리 시간 목표를 설정하세요. 일괄 추출은 일일 마감과 검증을 통과해야 할 최소 페이지 수를 정합니다. 이는 제안하는 시험의 예시입니다. LIQID는 별도의 72B 시험에서 첫 토큰 시간에 99번째 백분위수 기준을 적용했습니다.
- 요청이 각 단계에서 보낸 시간을 기록합니다. 요청이 들어온 때, 작업자가 처리를 시작한 때, 첫 출력이 나온 때, 완료된 때를 남기세요. 작업 종류를 표시하고 재시도도 기록합니다. 이 시각들로 대기 시간과 실제 처리 시간을 따로 비교할 수 있습니다. 추론이 빨리 끝나면 전체 소요 시간 하나만으로는 긴 대기가 가려질 수 있습니다.
- 한 가지 조건만 바꾸고 트래픽을 재현합니다. 같은 카드에 같은 모델 인스턴스를 유지한 채 공유 대기열과 독립 대기열을 비교하세요. 카드 배치 변경 제안은 그다음에 별도 시험으로 확인합니다. 프롬프트와 출력 한도, 입력 순서, 품질 검사를 고정하고 매번 같은 준비 작업을 거친 뒤 실행하세요. 평균 트래픽뿐 아니라 바쁜 시간대도 봅니다. 큰 작업 한 건이 좋지 않은 시점에 도착했을 때 별도 대기열의 효과가 나타나야 합니다.
- 결과와 함께 호스트와 전력계를 살핍니다. 같은 시간에 가속기 사용률과 메모리, 호스트 CPU와 RAM, 읽기·쓰기 활동, 시스템 입력 전력을 기록하세요. 작업별 완료 시간의 95번째 백분위수, 시간당 성공한 페이지 또는 요청 수, 성공 결과당 에너지를 보고합니다. 거부된 작업도 보이도록 백분위수와 함께 누락과 시간 초과를 확인하세요.
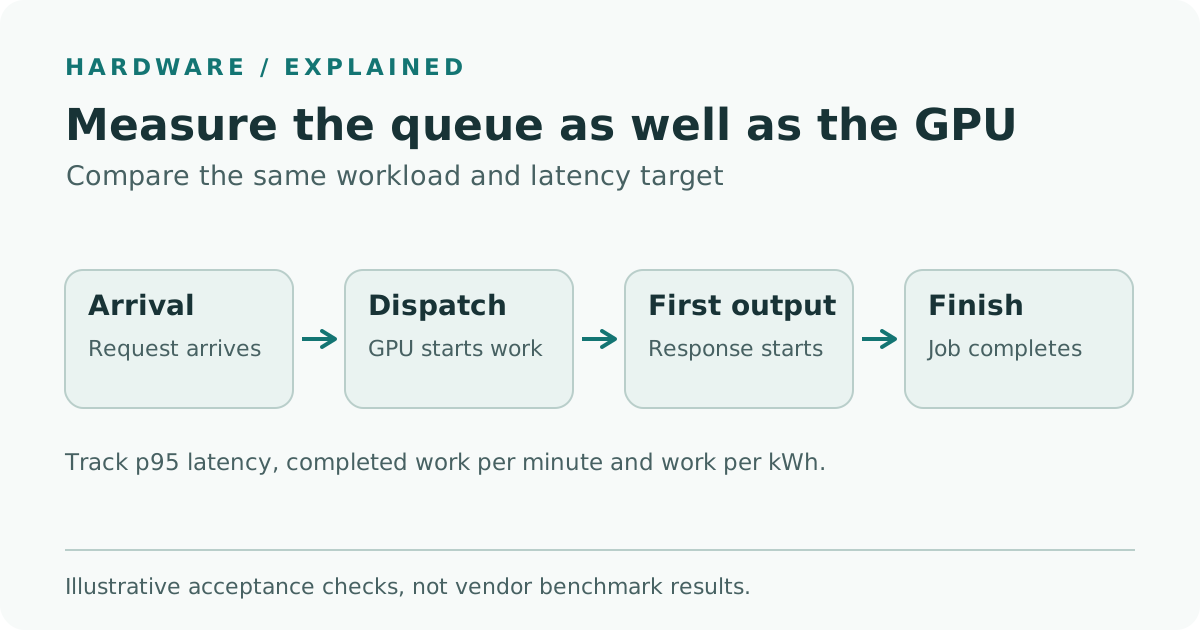
도입 기준을 확인할 시험을 Telli.sh가 그린 그림입니다. 대기, 첫 응답, 완료 시간 중 어디에서 변화가 생겼는지 보면 제약 조건을 좁힐 수 있습니다.
서비스마다 지연 분포를 따로 그리세요. p95는 측정한 사건의 95%가 그 시간 안에 완료되는 값입니다. 중앙값이 같아도 p95는 움직일 수 있습니다. 분석가가 늘 바쁜 시간대에 접속한다면 이 차이가 중요합니다. 분포마다 표본 수도 기록하세요. 야간 작업 5건의 백분위수와 대화형 요청 수백 건의 백분위수는 다른 정보를 줍니다. 바쁜 서비스의 대기가 계속 줄고 품질이 비슷하며 시간 초과도 감소했다면, 최고 처리량만 확인했을 때보다 전용 카드를 배정할 근거가 분명해집니다.
두 구성의 측정 범위도 같아야 합니다. 전력 효율을 비교할 때는 고정된 시간 동안 쓸 수 있는 출력의 양을 세고 같은 장비를 대상으로 전력을 재세요. 서버와 GPU 섀시만 계측했다면 IT 시스템 에너지라고 표시합니다. 공유 저장소나 냉각도 비교에 넣을 경우 두 구성에 같은 기준으로 포함하세요. 24시간 가동하는 서비스라면 유휴 전력도 기록합니다. 빠른 시스템은 작업 한 건을 처리하는 데 걸리는 시간이 짧지만, 더 높은 유휴 전력을 밤새 사용하면 하루 소비량은 더 많을 수 있습니다.
22kW는 설치 환경을 검토할 때 확인할 수치다
LIQID는 GPU 30장을 갖춘 공랭 시스템의 전력을 약 22kW로 안내합니다. AMD는 MI350P 한 장의 최대 일반 보드 전력으로 600W를, 설정할 수 있는 전력으로 450W를 명시합니다. 30장에 600W를 곱하면 해당 보드 전력 기준에서 카드 합계는 18kW입니다. LIQID가 발표한 약 22kW는 카드 외 장비도 포함한 시스템에 해당합니다. 시설 전력, 랙 전원 공급, 냉각 용량은 설치 환경에 따라 달라집니다. 450W에서 실행하면 실제 처리량도 달라질 수 있습니다. 견적 구성에서 제조사가 두 설정을 지원한다면 작업과 품질 판정 기준을 일치시켜 비교하세요. LIQID 시스템 전력 안내 · AMD MI350P 보드 사양
큰 구성을 선택하기 전에 시설 담당자와 함께 확인하세요. 정확한 섀시 수, 평상시와 이중화 운용 시의 회로 용량, 흡기 조건에서 가능한 열 제거량, 재시작 직후 갑자기 최대 부하로 돌아갈 때의 대응을 검토합니다. 견적을 토대로 정비와 지원, 전력 조정을 누가 맡는지도 확인하세요. 이 조건들을 문서 대기열이 길어질 때 드는 비용과 함께 관리합니다. 호스트 한 대로 관리할 서버 수가 줄더라도 필요한 전력 밀도 때문에 장비를 둘 수 있는 공간이 달라질 수 있습니다.
LIQID는 파트너 주문 절차를 통해 GPU 430장 시스템을 제공한다고 안내하며, 공급은 재고에 따릅니다. 제품 페이지에는 46주 납품 절차가 설명돼 있고, 별도로 안내하는 4주 리드타임은 구매 주문이 확정된 때부터입니다. 날짜가 찍힌 구성 견적서와 설치 장소에 대한 확정 납기를 요청하세요. LIQID는 11월 17일부터 McCormick Place에서 SC26 전시를 진행한다고 안내했습니다. LIQID 파트너 주문과 납품 안내 · LIQID SC26 발표
대기 시간을 얼마나 줄여야 비용을 들일 가치가 있을까?
다음 팀이 번역한 문단을 바로 받아야 한다면 가속기 한 장을 번역에 전용으로 쓰는 편이 나을 수 있습니다. 번역을 모두 다음 날까지 받아도 되는 곳이라면 같은 카드는 한 주 대부분을 쉬게 됩니다. 연구실의 동시 작업을 재현할 수 있는 가장 작은 구성부터 시작해 가장 바쁜 구간을 여러 번 반복하세요. 대기를 줄였을 때 실제 결과가 개선되는 곳에 용량을 추가합니다. 기록관의 도입 기준은 기술자가 필요한 답을 제때 받으면서도 스캔한 하루치 자료 전체가 인계 전까지 처리되는지처럼 구체적으로 정할 수 있습니다.
출처
- LIQID SC26 발표와 공식 UltraStack 이미지, 2026년 11월 12일
- LIQID UltraStack AMD Instinct MI350P 제품 페이지, 주문과 전력 안내, 2026년 11월 15일 확인
- LIQID UltraStack 데이터시트, 2026년 11월 15일 확인
- LIQID 3단계 벤치마크 방법과 결과, 2026년 11월 15일 확인
- AMD Instinct MI350P 카드 사양, 2026년 11월 15일 확인
- SC26 2026년 행사와 전시 공식 일정
시험 메모와 차트, 배포 결정을 한 곳에서 검색하려면 Telli.sh 계정을 만들어 보세요.