Trenta GPU su un server possono accorciare le code IA di un laboratorio?
LIQID UltraStack assegna ai modelli schede AMD Instinct MI350P separate. Confronta la prova del produttore con 20 GPU e la stima con 30, poi misura l’attesa effettiva dei ricercatori.
Alle nove del mattino, un gruppo di ricerca inizia a estrarre il testo dalle scansioni di ieri. Un secondo gruppo invia appunti da tradurre e un terzo cerca risposte rapide nel manuale di uno strumento. Se le richieste finiscono nella stessa coda di inferenza, una domanda breve può restare dietro un grande lotto di documenti. Quando compare la risposta, chi l’aveva chiesta potrebbe essere già tornato al PDF.
Il 12 novembre 2026, il fornitore di infrastrutture LIQID ha descritto una configurazione UltraStack che collega da 4 a 30 acceleratori AMD Instinct MI350P a un solo host AMD EPYC 9005 a doppio socket. Nello schema pubblicato, ogni scheda ospita un’istanza di un modello, così il riconoscimento ottico dei caratteri (OCR) può proseguire mentre altre GPU gestiscono traduzioni o domande. LIQID ha annunciato una dimostrazione a SC26 a Chicago durante l’esposizione prevista dal 17 al 19 novembre. Annuncio LIQID del 12 novembre e immagini ufficiali del sistema · Date di SC26
L’architettura ha senso quando un laboratorio deve concludere più lavori in tempo e ciascun modello entra in una scheda. Parti dal tempo d’attesa percepito. Chiediti quanta attesa dipende dagli altri lavori, se GPU separate possono ridurla, quale limite potrebbe emergere dopo e se il beneficio giustifica consumi e costi. Per provare gran parte di queste ipotesi basta una configurazione molto più piccola di quella completa.
Ogni GPU dispone di 144 GB di memoria propria
Nello schema pubblicato da LIQID, l’host AMD EPYC si collega alle schede MI350P tramite una rete di interconnessione PCIe Gen 5. Le schede possono occupare chassis GPU separati collegati allo stesso host. AMD specifica 144 GB di HBM3E dedicata per MI350P e un’interfaccia PCIe 5.0 x16 per la scheda. Nella configurazione con un modello per scheda, il singolo modello usa la memoria della GPU assegnata. Ogni istanza può gestire più richieste entro i limiti del software di inferenza e del budget di memoria. Scheda tecnica LIQID UltraStack · Specifiche AMD MI350P
Venti schede contengono in totale 2,88 TB di HBM3E, calcolati in unità decimali. Il dato serve a stimare quante istanze separate di modelli può ospitare il sistema. Per il lavoro assegnato alla scheda numero sette, il punto di partenza resta 144 GB. Se il modello entra solo distribuendo parametri e stato di lavoro tra più GPU, valuta una strategia di distribuzione e misurala direttamente. Il ridimensionamento riportato da LIQID riguarda istanze indipendenti su schede separate. Configurazione di prova e valori di memoria LIQID
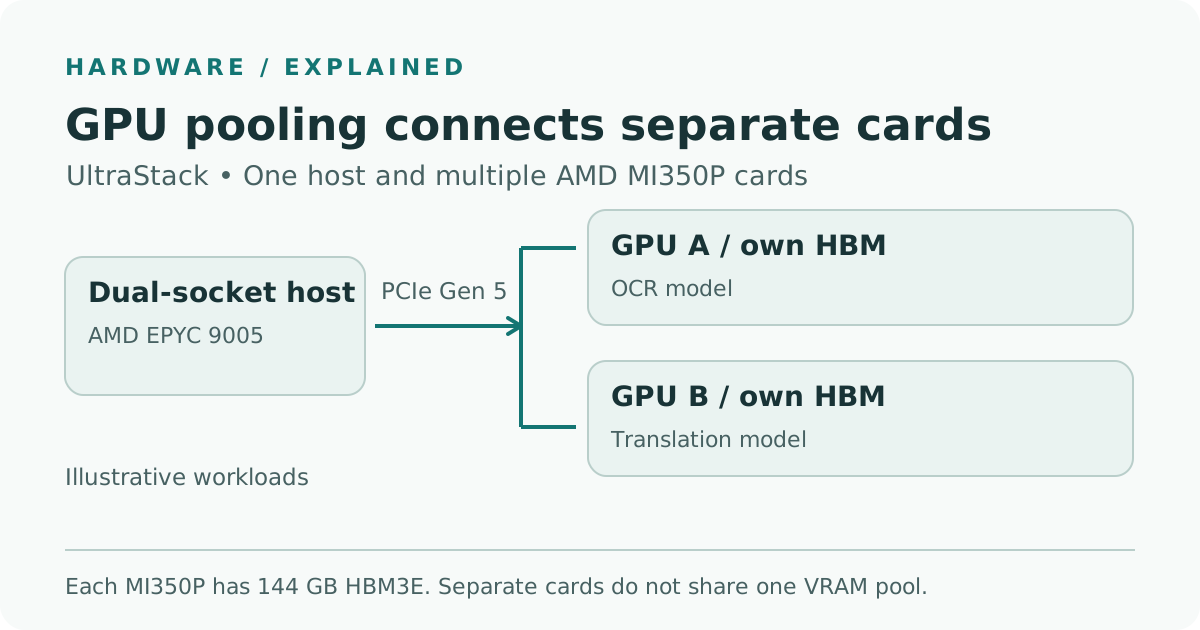
Illustrazione di Telli.sh basata sulla descrizione hardware di LIQID e sulle specifiche AMD. Mostra un esempio di inferenza indipendente e omette chassis e periferiche dell’host.
Il numero di parametri aiuta a restringere la scelta, ma due modelli con lo stesso numero possono richiedere quantità di memoria diverse. Parti dai pesi esatti e dalla loro precisione. Riserva memoria per il runtime e per l’eventuale cache con cui il modello tiene conto dei token precedenti mentre ne genera di nuovi. Se il servizio accetta più richieste lunghe in contemporanea, avvia il modello previsto e osserva la memoria con quel carico effettivo. Una richiesta breve su una scheda libera ti dice se il servizio parte. Una prova prolungata con gli input più lunghi ammessi ti dice se riesce a continuare ad accettare lavoro.
Le code indipendenti aiutano quando i lavori arrivano a ritmi diversi
Pensa a un archivio universitario che digitalizza interviste e documenti cartacei. Durante una prova, una GPU può eseguire un modello OCR per documenti, un’altra trascrivere le interviste e una terza gestire traduzioni brevi. Dopo una settimana di dati sull’utilizzo, una quarta scheda potrebbe ospitare un’altra istanza del servizio più richiesto. Assegna a ciascun servizio una coda e definisci quanto lavoro può accettare contemporaneamente. L’accumulo di pagine scansionate avrà così meno occasioni di rallentare una breve traduzione per la contesa dello stesso acceleratore.
Supponiamo che l’archivio debba tradurre il testo dopo l’OCR. Le fasi possono sovrapporsi su documenti diversi. Il primo può passare alla traduzione mentre il secondo entra nell’OCR. Per ogni documento, la traduzione continua a dipendere dall’esito del relativo OCR. Misura il tempo trascorso dal caricamento di quel documento a un risultato utilizzabile, insieme al numero di documenti completati dall’intera pipeline. Un sistema che elabora più documenti all’ora può comunque lasciare un traduttore in attesa di una singola pagina.
Per un carico diverso, immagina un laboratorio di ingegneria che di giorno usa un assistente per i documenti e di notte elabora vecchi log strumentali. Di giorno serve un tempo prevedibile per la prima risposta quando un ricercatore fa una domanda. Il lavoro notturno ha una scadenza e spesso può tollerare pause. Misura quanto tempo ciascuna GPU dedica ai servizi prima di assegnare loro una scheda in modo permanente. Se l’assistente resta inattivo per gran parte della giornata ma riceve molte richieste dopo una riunione, una seconda istanza riservata ha un costo anche quando il traffico è scarso. Un sistema già in grado di gestire il picco con attività pianificate o code separate è un buon termine di confronto.
Anche la collocazione dei modelli incide sul ripristino. Un solo host semplifica parte della configurazione, e tutti i servizi che vi girano dipendono da quell’host. Annota quali lavori possono attendere dopo la manutenzione, quali devono ripartire prima e quali richiedono un secondo punto di erogazione. In una pipeline documentale salva i risultati intermedi per riprendere dalle estrazioni completate dopo un riavvio. Per le attività interattive, concorda un limite di interruzione o predisponi un altro endpoint. Il numero di schede sull’host principale esprime la capacità di inferenza nel funzionamento normale. Il tempo di ripristino va provato separatamente.
LIQID ha misurato 89.000 token di output al secondo con 20 GPU
Nel rapporto sul throughput, LIQID descrive un modello della classe da 7 miliardi di parametri a precisione FP4, con un livello di concorrenza dichiarato di 128. Ogni GPU gestiva la propria istanza. Con 20 schede, LIQID ha riportato circa 89.000 token di output al secondo complessivi. La stima di circa 133.000 token al secondo con 30 GPU estende l’andamento osservato nella prova con 20. Entrambe le cifre descrivono l’output aggregato della configurazione provata o stimata. Un ricercatore che invia una singola richiesta sperimenta invece i tempi specifici della sua coda e dell’elaborazione dell’input, e la velocità di generazione della risposta. Rapporto e metodo LIQID sul throughput
| Prova LIQID | Numero di GPU | Token di output aggregati/s | Evidenza |
|---|---|---|---|
| Classe 7B, FP4 | 1 | 4.653 | Misurazione LIQID |
| Classe 7B, FP4 | 10 | 44.383 | Misurazione LIQID |
| Classe 7B, FP4 | 20 | Circa 89.000 | Misurazione LIQID |
| Classe 7B, FP4 | 30 | Circa 133.000 | Proiezione LIQID da 20 GPU |
| Classe 72B, FP8, limiti di latenza interattiva | 8 | 1.256 | Misurazione LIQID separata |
La prova distinta con il modello 72B FP8 prevedeva un massimo di due secondi al primo token al 99° percentile e almeno 30 token di output al secondo per utente. Per questa prova LIQID riporta misure con 2, 4 e 8 schede. Dimensioni del modello, precisione e condizioni di servizio differiscono da quelle del test di throughput con il modello 7B. Usa il risultato interattivo come riferimento per quel tipo di prova, poi applica i tuoi obiettivi di latenza alle richieste e al livello di concorrenza previsti. Metodologia del benchmark e risultati interattivi LIQID
Le cifre del 7B motivano la ripetizione dello stesso benchmark man mano che si aggiungono istanze identiche. Per chi pianifica carichi misti resta una domanda più interessante. Che cosa succede se le richieste passano parte del tempo a leggere molti file piccoli, a ricavare il contesto dall’archiviazione o ad aspettare che la CPU prepari le immagini? Riproduci lo stesso traffico due volte con gli stessi modelli e lo stesso numero di GPU, prima verso ciascun servizio separatamente e poi con tutti insieme. Se in parallelo crescono le attese mentre l’utilizzo delle GPU resta basso, controlla CPU dell’host, attività del file system e instradamento delle richieste prima di aggiungere acceleratori.
Misura il lavoro utile entro un limite di latenza
Parti da una prova che il sistema attuale possa eseguire. Usa, per esempio, un insieme rappresentativo di 200 documenti autorizzati con lingue e numeri di pagine scansionate noti. Riproduci insieme al lotto un log anonimizzato degli orari di arrivo delle richieste interattive. Mantieni lo stesso insieme di input su entrambi i sistemi. Se una modifica di hardware o software impone un cambio di precisione, ricontrolla la qualità dei risultati sullo stesso campione. Conta solo i risultati completati che superano i normali controlli del gruppo.
- Definisci che cosa rende valido un risultato. Per l’assistente, fissa un obiettivo per la prima risposta e uno per il tempo complessivo. Potresti richiedere il primo token entro due secondi al 95° percentile del tuo campione interattivo. Per l’estrazione in batch scegli una scadenza giornaliera e un numero minimo di pagine convalidate. Sono valori di esempio per la prova proposta. Nell’esperimento separato da 72B, LIQID ha usato il 99° percentile come limite per il primo token.
- Registra dove ogni richiesta trascorre il tempo. Annota quando arriva, quando un worker la prende in carico, quando produce il primo output e quando termina. Aggiungi il tipo di lavoro e registra i tentativi ripetuti. Con questi orari puoi confrontare l’attesa in coda separatamente dal tempo di servizio. Il solo tempo complessivo può nascondere una lunga attesa quando l’inferenza vera e propria è breve.
- Cambia una cosa e riproduci il traffico. Confronta la coda condivisa con code separate mantenendo le stesse istanze sulle stesse schede. Prova poi separatamente eventuali modifiche nell’assegnazione delle schede. Tieni fissi i limiti delle richieste e dell’output, l’ordine degli input e i controlli di qualità. Esegui ogni test dopo un riscaldamento omogeneo. Misura sia il periodo di punta sia il traffico medio. È quando un singolo grande lavoro arriva nel momento peggiore che la separazione delle code dovrebbe mostrare il suo effetto.
- Leggi le misure dell’host e dei contatori accanto al risultato. Nello stesso intervallo registra utilizzo e memoria degli acceleratori, CPU e RAM dell’host, attività di lettura e scrittura e potenza assorbita dal sistema. Riporta il 95° percentile del tempo di completamento per lavoro, le pagine o richieste riuscite all’ora e l’energia per risultato riuscito. Esamina scarti e timeout insieme ai percentili per rendere visibile anche il lavoro rifiutato.
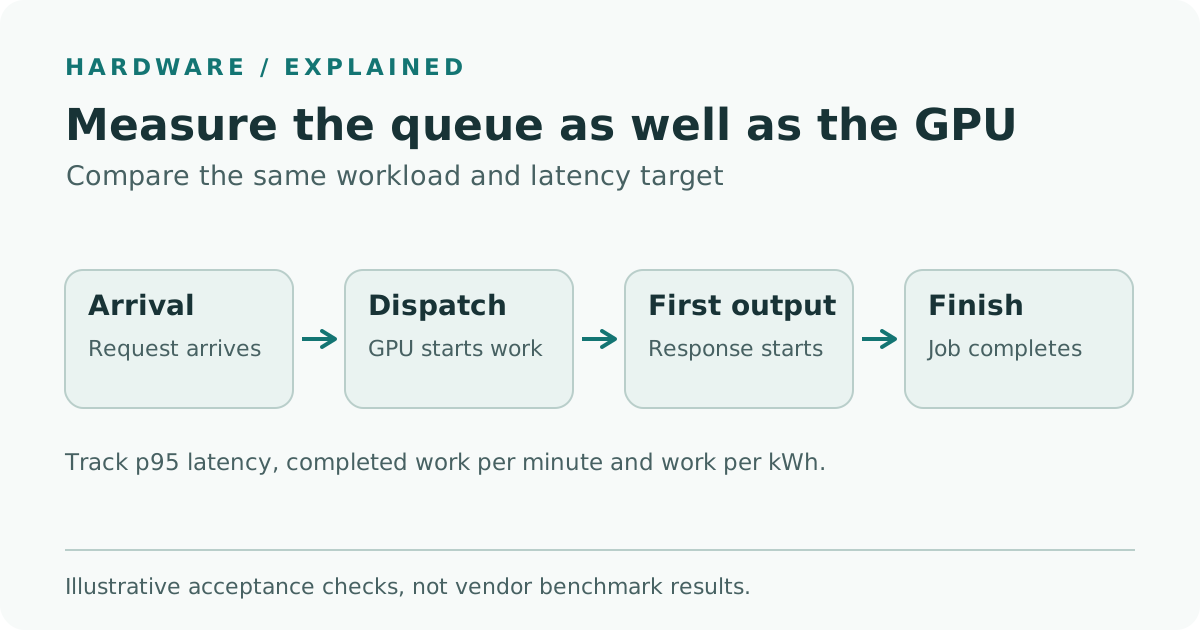
Illustrazione Telli.sh di una prova di accettazione proposta. Variazioni nell’attesa in coda, nella prima risposta o nel completamento possono indicare vincoli diversi.
Traccia una distribuzione delle latenze per ogni servizio. Il p95 è il tempo entro cui si conclude il 95 per cento degli eventi misurati. Può cambiare mentre la mediana resta stabile, un dettaglio importante se chi analizza i dati arriva spesso nelle ore di punta. Registra il numero di elementi di ogni distribuzione. Un percentile basato su cinque lavori notturni è diverso da uno basato su centinaia di richieste interattive. Un calo duraturo dell’attesa per il servizio più carico, a qualità comparabile e con meno timeout, dà un motivo più solido per spendere su una scheda dedicata rispetto al solo picco di throughput.
Il confronto deve mantenere anche lo stesso perimetro di misura. Per l’efficienza energetica, conta i risultati utili in un intervallo fisso e misura le stesse apparecchiature nelle due configurazioni. Se misuri solo server e chassis GPU, indica il risultato come consumo del sistema IT. Se includi l’archiviazione condivisa o il raffreddamento, usa lo stesso criterio per entrambe. Registra il consumo a riposo per un servizio attivo 24 ore su 24. Un sistema rapido lavora meno minuti per ogni richiesta, ma se resta acceso tutta la notte con un assorbimento a riposo più alto può consumare di più nell’intera giornata.
Il valore di 22 kW va valutato nel luogo di installazione
LIQID indica circa 22 kW per il sistema completo da 30 GPU raffreddato ad aria. AMD specifica una potenza tipica massima della scheda di 600 W per MI350P e un’impostazione configurabile da 450 W. Moltiplicando 30 per 600 W si ottengono 18 kW per le schede secondo quel valore nominale. I 22 kW dichiarati si riferiscono al sistema nel suo complesso. Alimentazione dell’edificio, dotazione elettrica dei rack e capacità di raffreddamento dipendono dal sito. L’uso del profilo da 450 W può anche cambiare il throughput utile. Se il fornitore supporta entrambi i profili per la configurazione del preventivo, confrontali con lo stesso carico e gli stessi criteri di qualità. Indicazioni LIQID sulla potenza del sistema · Specifiche AMD MI350P
Coinvolgi chi gestisce l’impianto prima di scegliere una configurazione più grande. Verifica il numero esatto di chassis, la capacità dei circuiti in condizioni normali e ridondanti, la rimozione del calore alle condizioni d’ingresso e la tolleranza dell’impianto a un ritorno improvviso al pieno carico dopo un riavvio. Usa il preventivo per chiarire chi gestisce assistenza, supporto e impostazioni di potenza. Valuta questi elementi insieme al costo di una lunga coda documentale. Un solo host può ridurre il numero di server da gestire, ma la densità di potenza richiesta può limitare i locali adatti all’installazione.
LIQID pubblicizza sistemi da 4 a 30 GPU ordinabili tramite i partner, con disponibilità legata alle scorte. Nella pagina indica un iter di consegna di 4–6 settimane e collega il termine pubblicizzato di quattro settimane alla conferma dell’ordine d’acquisto. Chiedi un preventivo datato con la configurazione e un impegno di consegna per il luogo di installazione. LIQID ha indicato il 17 novembre come inizio della sua esposizione a SC26 presso McCormick Place. Condizioni di acquisto e indicazioni di consegna LIQID · Annuncio LIQID per SC26
Quanta attesa vale la pena eliminare?
Un acceleratore dedicato alla traduzione può essere un buon investimento se il gruppo successivo ha bisogno subito dei brani tradotti. La stessa scheda può restare inattiva quasi tutta la settimana quando tutte le traduzioni possono aspettare fino a domani. Parti dalla configurazione più piccola che rappresenti le attività simultanee del laboratorio e ripeti più volte il periodo di punta. Aggiungi capacità dove accorciare le attese migliora ancora il risultato. In un archivio, un criterio concreto può essere che il tecnico riceva risposte tempestive e che la scansione del lotto giornaliero si concluda comunque prima del passaggio di consegne.
Fonti
- Annuncio LIQID per SC26 e immagini ufficiali di UltraStack, 12 novembre 2026
- Pagina prodotto LIQID UltraStack con AMD Instinct MI350P, ordini e potenza, consultata il 15 novembre 2026
- Scheda tecnica LIQID UltraStack, consultata il 15 novembre 2026
- Metodi e risultati del benchmark LIQID Phase 3, consultati il 15 novembre 2026
- Specifiche della scheda AMD Instinct MI350P, consultate il 15 novembre 2026
- Calendario ufficiale di SC26 2026, evento ed esposizioni
Per raccogliere note dei test, grafici e decisioni di installazione in un unico spazio consultabile, crea un account Telli.sh.