Un serveur équipé de 30 GPU peut-il réduire l’attente des chercheurs qui utilisent l’IA ?
LIQID UltraStack attribue une carte AMD Instinct MI350P à chaque modèle. Comparez l’essai du fabricant sur 20 GPU à sa projection sur 30, puis mesurez l’attente réelle de votre équipe.
À neuf heures, une équipe de recherche lance l’extraction du texte des documents numérisés la veille. Une autre envoie des notes à traduire et une troisième cherche une réponse rapide dans le manuel d’un instrument. Si tous ces travaux passent par la même file d’inférence, une question courte peut rester bloquée derrière un gros lot de documents. Quand la réponse arrive, la personne qui en avait besoin est peut-être déjà retournée à son PDF.
Le 12 novembre 2026, le fournisseur d’infrastructure LIQID a présenté une configuration UltraStack qui relie 4 à 30 accélérateurs AMD Instinct MI350P à un seul hôte AMD EPYC 9005 à deux sockets. Son architecture attribue une instance de modèle à chaque carte. Une tâche de reconnaissance optique de caractères, ou OCR, peut ainsi se poursuivre pendant que d’autres GPU traduisent ou répondent à des questions. LIQID a annoncé une démonstration au SC26 à Chicago, pendant l’exposition prévue du 17 au 19 novembre. Annonce de LIQID du 12 novembre et images officielles · Dates du SC26
Cette approche a du sens quand un laboratoire doit terminer plusieurs travaux à temps et que chaque modèle tient sur une carte. Partez de l’attente constatée par les utilisateurs. Demandez-vous quelle part vient d’une autre tâche, si des GPU séparés la supprimeraient, quelle serait la prochaine limite et si le gain justifierait la puissance et le coût de l’ensemble. La plupart de ces questions se testent avec bien moins de cartes qu’en configuration complète.
Chaque GPU dispose de ses propres 144 Go de mémoire
Dans l’architecture présentée par LIQID, un réseau d’interconnexion PCIe Gen 5 relie l’hôte AMD EPYC aux cartes MI350P. Les cartes peuvent se trouver dans des châssis GPU distincts raccordés à l’hôte. AMD indique 144 Go de HBM3E dédiée par MI350P et une interface PCIe 5.0 x16. Avec un modèle par carte, chaque modèle utilise la mémoire du GPU qui lui est attribué. Une instance peut traiter plusieurs requêtes dans les limites de son logiciel de service et de son budget mémoire. Fiche technique LIQID UltraStack · Spécifications AMD MI350P
Vingt cartes totalisent 2,88 To de HBM3E en unités décimales. Ce chiffre sert à évaluer combien d’instances distinctes le système peut héberger. Pour le travail qui tourne sur la carte numéro sept, la capacité de départ reste de 144 Go. Si votre modèle tient uniquement en répartissant ses paramètres et son état de travail sur plusieurs GPU, choisissez une stratégie de distribution et mesurez-la explicitement. Les résultats de LIQID portent sur des instances indépendantes, réparties sur des cartes distinctes. Configuration de l’essai et chiffres mémoire de LIQID
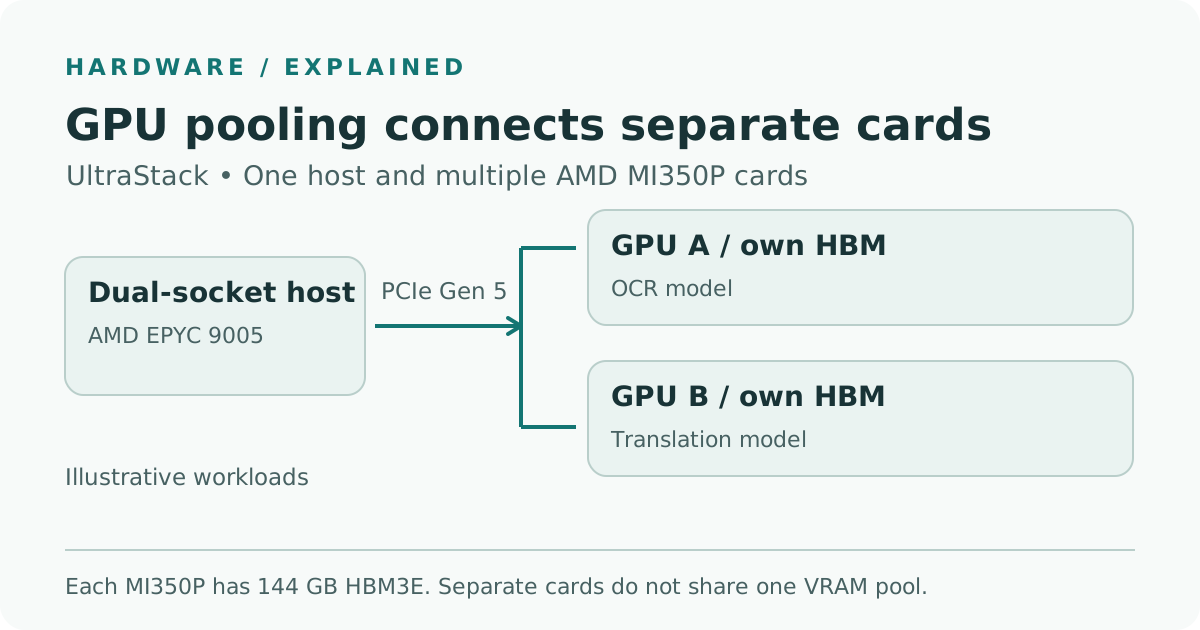
Illustration de Telli.sh à partir de la description matérielle de LIQID et des spécifications des cartes AMD. Ce schéma montre un exemple de services indépendants et laisse de côté les châssis et les périphériques de l’hôte.
Le nombre de paramètres aide à faire un premier tri, mais deux modèles à nombre de paramètres égal peuvent avoir des besoins différents. Commencez par les poids exacts et leur précision. Comptez ensuite le moteur d’exécution et le cache éventuel que le modèle utilise pour conserver les jetons précédents pendant la génération. Si un service accepte plusieurs longues requêtes à la fois, lancez le modèle retenu et observez son usage mémoire sous cette charge réelle. Une requête courte sur une carte au repos indique si le service démarre. Un essai prolongé avec les entrées les plus longues autorisées indique si le service peut continuer à accepter du travail.
Des files distinctes aident quand les tâches n’arrivent pas au même rythme
Prenons des archives universitaires qui numérisent à la fois des entretiens et des documents papier. Pour un essai, un GPU peut exécuter un modèle documentaire pour l’OCR, un autre transcrire les entretiens et un troisième traiter les traductions courtes. Après une semaine d’observation, une quatrième carte pourrait accueillir une deuxième instance du service le plus sollicité. Donnez à chaque service sa propre file et fixez le volume qu’il peut accepter en parallèle. Un arriéré de pages scannées risque alors moins de faire attendre une traduction courte à cause d’un accélérateur partagé.
Imaginons que le service d’archives reçoive une demande de traduction après OCR. Des étapes peuvent se chevaucher sur des documents différents. Le premier document peut passer à la traduction pendant que le deuxième entre en OCR. La traduction d’un document dépend toujours du résultat OCR de ce document. Mesurez, pour chaque document, le temps entre le téléversement et un résultat exploitable ainsi que le nombre total de documents terminés dans la chaîne. Un système qui traite plus de documents par heure peut quand même faire attendre une page à un traducteur.
Autre exemple. Un laboratoire d’ingénierie utilise un assistant de recherche documentaire le jour et traite d’anciens journaux d’instruments la nuit. L’assistant doit commencer à répondre dans un délai prévisible à la question d’un chercheur. Le traitement nocturne doit finir à une heure donnée et tolère souvent des pauses. Mesurez quelle part du temps des GPU chaque service occupe avant d’attribuer une carte en permanence à chacun. Si l’assistant tourne peu dans la journée mais subit un pic après une réunion, lui réserver une deuxième instance coûte même quand la demande est faible. Comparez avec une configuration qui absorbe déjà le pic grâce à des tâches programmées ou à des files distinctes.
Le placement des modèles a aussi un effet sur la reprise après incident. Un seul hôte simplifie une partie de la configuration et tous ses services dépendent de lui. Définissez quels travaux peuvent attendre après une maintenance, lesquels doivent reprendre en premier et lesquels doivent pouvoir tourner ailleurs. Pour une chaîne documentaire, conservez les résultats intermédiaires afin de reprendre à partir des extractions terminées. Pour les usages interactifs, convenez d’une durée d’interruption acceptable ou prévoyez un autre point d’accès. Le nombre de cartes de l’hôte principal détermine la capacité d’inférence en régime normal. Le temps de reprise se mesure à part.
LIQID a mesuré 89 000 jetons de sortie par seconde avec 20 GPU
Le document de LIQID sur le débit décrit un modèle de la classe des 7 milliards de paramètres en précision FP4, avec un niveau de concurrence annoncé de 128. Chaque GPU exécutait sa propre instance. Sur 20 GPU, LIQID a relevé environ 89 000 jetons de sortie par seconde sur l’ensemble des cartes. Son estimation d’environ 133 000 jetons par seconde sur 30 GPU prolonge la progression observée jusqu’à 20. Ces chiffres représentent le débit global de la configuration mesurée ou projetée. Pour un chercheur qui envoie une seule requête, comptent son propre temps d’attente, le traitement de l’entrée et la vitesse de génération. Document de LIQID sur le débit et sa méthode
| Essai LIQID | Nombre de GPU | Jetons de sortie par seconde, au total | Méthode |
|---|---|---|---|
| Classe 7 milliards, FP4 | 1 | 4 653 | Mesure LIQID |
| Classe 7 milliards, FP4 | 10 | 44 383 | Mesure LIQID |
| Classe 7 milliards, FP4 | 20 | Environ 89 000 | Mesure LIQID |
| Classe 7 milliards, FP4 | 30 | Environ 133 000 | Projection LIQID à partir de 20 GPU |
| Classe 72 milliards, FP8, contraintes de latence interactive | 8 | 1 256 | Mesure LIQID distincte |
L’essai séparé en FP8 avec un modèle de 72 milliards visait au plus deux secondes jusqu’au premier jeton au 99e percentile et au moins 30 jetons de sortie par seconde et par utilisateur. LIQID présente des mesures sur 2, 4 et 8 cartes pour cette expérience. La taille du modèle, la précision et les conditions de service diffèrent de l’essai de débit à 7 milliards de paramètres. Ce résultat sert de référence pour ce type d’essai interactif. Appliquez ensuite vos propres objectifs de latence aux requêtes et au niveau de concurrence attendus. Méthode des essais LIQID et résultats interactifs
Les chiffres du modèle à 7 milliards incitent à répéter exactement le même essai à mesure que vous ajoutez des instances identiques. Il reste une autre question si l’équipe prévoit des charges mixtes. Que se passe-t-il si une partie du délai sert à lire de nombreux petits fichiers, à assembler un contexte depuis le stockage ou à attendre la préparation d’images par le processeur ? Rejouez deux fois la même trace avec les mêmes modèles et le même nombre de GPU, en faisant tourner les services séparément puis ensemble. Si l’attente augmente en fonctionnement simultané alors que les GPU restent peu sollicités, examinez le processeur de l’hôte, le système de fichiers et le routage des requêtes avant d’ajouter des accélérateurs.
Mesurez le travail utile dans un délai donné
Commencez par un essai réalisable sur votre déploiement actuel. Prenez par exemple un ensemble représentatif de 200 documents approuvés, avec des langues et un nombre de pages numérisées connus, puis rejouez en parallèle un journal anonymisé des heures d’arrivée des requêtes interactives. Gardez la même répartition des entrées sur les deux systèmes. Si un changement de matériel ou de logiciel vous impose une autre précision, contrôlez de nouveau la qualité sur le même échantillon. Comptez uniquement les résultats terminés qui passent les vérifications usuelles de votre équipe.
- Définissez un bon résultat. Pour l’assistant, fixez un objectif de première réponse et de délai total, par exemple un premier jeton en deux secondes au 95e percentile de votre échantillon interactif. Pour l’extraction par lots, fixez une échéance quotidienne et un nombre minimal de pages validées. Ces seuils servent d’exemples pour votre essai. LIQID a utilisé le 99e percentile pour le premier jeton dans son expérience distincte à 72 milliards de paramètres.
- Notez où chaque requête passe du temps. Consignez son arrivée, le début du traitement, la première sortie et la fin. Marquez le type de travail et les nouvelles tentatives. Ces horodatages permettent de comparer l’attente et le traitement actif séparément. Un seul délai total peut masquer une longue file quand le calcul lui-même se termine vite.
- Modifiez un élément et rejouez le trafic. Comparez une file commune à des files distinctes en gardant les mêmes instances sur les mêmes cartes. Testez ensuite toute modification de l’attribution des cartes dans un essai séparé. Gardez les mêmes limites d’entrée et de sortie, le même ordre d’arrivée et les mêmes contrôles de qualité. Faites chaque essai après une phase identique de mise en régime. Vérifiez les pointes en plus du trafic moyen. Les files distinctes devraient faire la différence quand une tâche volumineuse arrive au mauvais moment.
- Examinez les métriques de l’hôte et les compteurs en même temps que les résultats. Relevez l’utilisation et la mémoire des accélérateurs, le processeur et la RAM de l’hôte, les lectures et écritures et la puissance absorbée sur la même période. Indiquez le 95e percentile du temps d’achèvement par tâche, le nombre de pages ou de requêtes réussies par heure et l’énergie par résultat réussi. Regardez les requêtes abandonnées et les expirations avec les percentiles pour garder les rejets visibles.
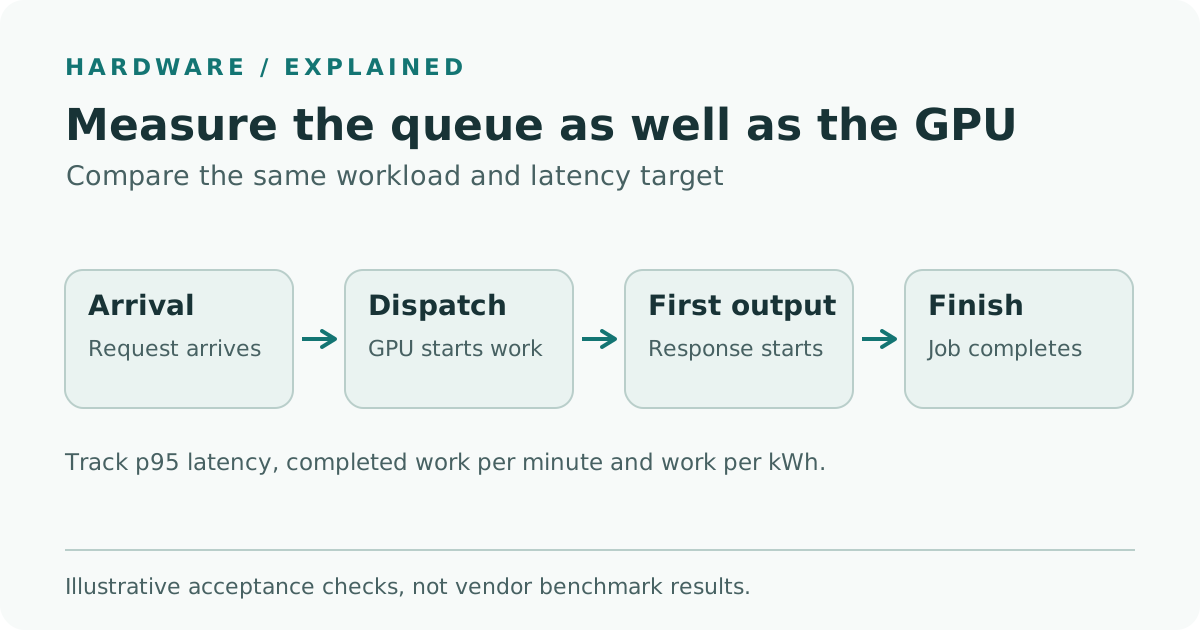
Illustration par Telli.sh d’un essai de validation proposé. Une variation dans l’attente, la première réponse ou le temps d’achèvement peut révéler des limites différentes.
Tracez une distribution de latence pour chaque service. Le p95 est le délai dans lequel s’achèvent 95 % des événements mesurés. Il peut évoluer alors que la médiane reste stable, ce qui compte pour une personne qui adresse régulièrement une requête pendant la pointe. Notez les effectifs de chaque distribution. Un percentile établi sur cinq tâches nocturnes ne raconte pas la même chose qu’un percentile portant sur des centaines de requêtes interactives. Une baisse durable de la file d’attente pour le service le plus sollicité, à qualité comparable et avec moins d’expirations, justifie mieux l’attribution d’une carte qu’un débit de pointe.
Gardez aussi le même périmètre de mesure. Pour l’efficacité énergétique, comptez les résultats utiles sur une durée fixe et appliquez les relevés aux mêmes équipements dans les deux configurations. Si vous mesurez uniquement le serveur et les châssis GPU, indiquez qu’il s’agit de l’énergie du système informatique. Si le stockage partagé ou le refroidissement entrent dans le comparatif, comptez-les de manière identique. Relevez la puissance au repos pour un service qui tourne 24 heures sur 24. Un système rapide passe moins de minutes à traiter chaque tâche, mais une installation qui reste en attente toute la nuit à une puissance de repos plus élevée peut consommer davantage sur la journée.
Les 22 kW sont un chiffre à vérifier avec l’équipe du site
LIQID annonce environ 22 kW pour le système complet à 30 GPU refroidi par air. AMD spécifie une puissance typique maximale de 600 W par carte MI350P et un réglage configurable à 450 W. À raison de 600 W par carte, les 30 cartes totalisent 18 kW. Les 22 kW annoncés concernent l’ensemble du système. La consommation du bâtiment, les besoins de l’armoire et la capacité de refroidissement dépendent de l’installation. Un réglage à 450 W peut modifier le débit utile. Si le fournisseur prend en charge les deux réglages pour votre configuration, comparez-les à charge et critères de qualité identiques. Indications de LIQID sur la puissance système · Spécifications de la carte AMD MI350P
Associez l’équipe du site avant de retenir une configuration plus grande. Examinez le nombre exact de châssis, la capacité des circuits en fonctionnement normal et redondant, l’évacuation de la chaleur dans vos conditions d’admission d’air et la tolérance à un retour soudain à pleine charge après un redémarrage. Servez-vous du devis pour identifier les modalités de maintenance, d’assistance et de réglage de la puissance. Comparez ces contraintes au coût d’une longue file de documents. Un hôte unique peut réduire le nombre de serveurs à administrer tout en imposant une densité électrique qui limite les locaux disponibles.
LIQID annonce des systèmes de 4 à 30 GPU disponibles à la commande par ses partenaires, selon le stock. Sa page produit décrit une livraison en quatre à six semaines et fait partir le délai annoncé de quatre semaines de la confirmation du bon de commande. Demandez un devis daté pour la configuration exacte et un engagement de livraison sur le site d’installation. LIQID a annoncé sa présence au SC26 au McCormick Place à partir du 17 novembre. Informations LIQID pour la commande et la livraison via les partenaires · Annonce LIQID du SC26
Quelle part de l’attente mérite d’être financée ?
Réserver un accélérateur aux traductions peut être judicieux si l’équipe suivante a besoin tout de suite du texte traduit. La même carte risque de rester inactive la majeure partie de la semaine si les traductions peuvent attendre le lendemain. Commencez par la plus petite configuration capable de reproduire les travaux simultanés du laboratoire et rejouez plusieurs fois la période la plus chargée. Ajoutez de la capacité là où l’attente réduite améliore encore le résultat. Dans les archives, le critère peut être très concret. Le technicien reçoit ses réponses à temps et le lot quotidien complet du scanner est prêt avant de passer le relais.
Sources
- Annonce LIQID du SC26 et images officielles d’UltraStack, 12 novembre 2026
- Page produit LIQID UltraStack avec AMD Instinct MI350P, commande et puissance, consultée le 15 novembre 2026
- Fiche technique LIQID UltraStack, consultée le 15 novembre 2026
- Méthode et résultats des essais LIQID de phase 3, consultés le 15 novembre 2026
- Spécifications de la carte AMD Instinct MI350P, consultées le 15 novembre 2026
- Dates officielles du SC26 et de ses expositions en 2026
Pour retrouver au même endroit les notes d’essai, les graphiques et les décisions de déploiement, créez un compte Telli.sh.