¿Pueden 30 GPU en un solo servidor reducir las colas de IA de un laboratorio?
LIQID UltraStack asigna tarjetas AMD Instinct MI350P a modelos separados. Compara la prueba del fabricante con 20 GPU y su proyección con 30, y mide la espera real de tu equipo.
A las nueve de la mañana, un equipo de investigación empieza a extraer texto de los documentos escaneados el día anterior. Otro envía unas notas para traducirlas y un tercero quiere respuestas rápidas de un manual de instrumentación. Si esos trabajos comparten una cola de inferencia, una pregunta corta puede quedar detrás de un lote grande de documentos. Para cuando aparece la respuesta, es posible que quien la necesitaba ya haya vuelto al PDF.
El 12 de noviembre de 2026, el proveedor de infraestructura LIQID describió una configuración UltraStack que conecta entre 4 y 30 aceleradores AMD Instinct MI350P a un único equipo anfitrión AMD EPYC 9005 de dos zócalos. El diseño publicado asigna una instancia de modelo a cada tarjeta. Un trabajo de reconocimiento óptico de caracteres, u OCR, puede seguir en marcha mientras otras GPU traducen o responden preguntas. LIQID anunció una demostración en SC26, en Chicago, durante la exposición prevista del 17 al 19 de noviembre. Anuncio de LIQID del 12 de noviembre e imágenes oficiales del sistema · Fechas de SC26
Este diseño encaja cuando un laboratorio necesita terminar varios trabajos a tiempo y cada modelo cabe en una tarjeta. Parte de la espera que experimenta una persona. Pregunta cuánto se debe a otra tarea, si las GPU separadas podrían eliminar esa parte, qué límite aparecería después y si la mejora justificaría la potencia y el coste del sistema. Casi todo puede probarse con muchas menos tarjetas que la configuración completa.
Cada GPU dispone de sus propios 144 GB de memoria
En el diseño que publica LIQID, el anfitrión AMD EPYC se conecta a las tarjetas MI350P mediante una red de interconexión PCIe Gen 5. Las tarjetas pueden instalarse en chasis de GPU separados y conectados al anfitrión. AMD especifica 144 GB de HBM3E dedicada por MI350P y una interfaz PCIe 5.0 x16. En la configuración de un modelo por tarjeta, cada modelo usa la memoria de la GPU que se le asigna. Una instancia puede atender varias solicitudes dentro de los límites del software de servicio y del presupuesto de memoria. Ficha técnica de LIQID UltraStack · Especificaciones de AMD MI350P
Veinte tarjetas suman 2,88 TB de HBM3E en unidades decimales. La cifra sirve para estimar cuántas instancias distintas puede alojar el sistema. Para el trabajo asignado a la tarjeta número siete, el punto de partida sigue siendo 144 GB. Si tu modelo solo cabe repartiendo sus parámetros y su estado de trabajo entre varias GPU, evalúa una estrategia de distribución y mídela expresamente. Los datos de escalado de LIQID corresponden a instancias independientes instaladas en tarjetas distintas. Configuración de la prueba de LIQID y cifras de memoria
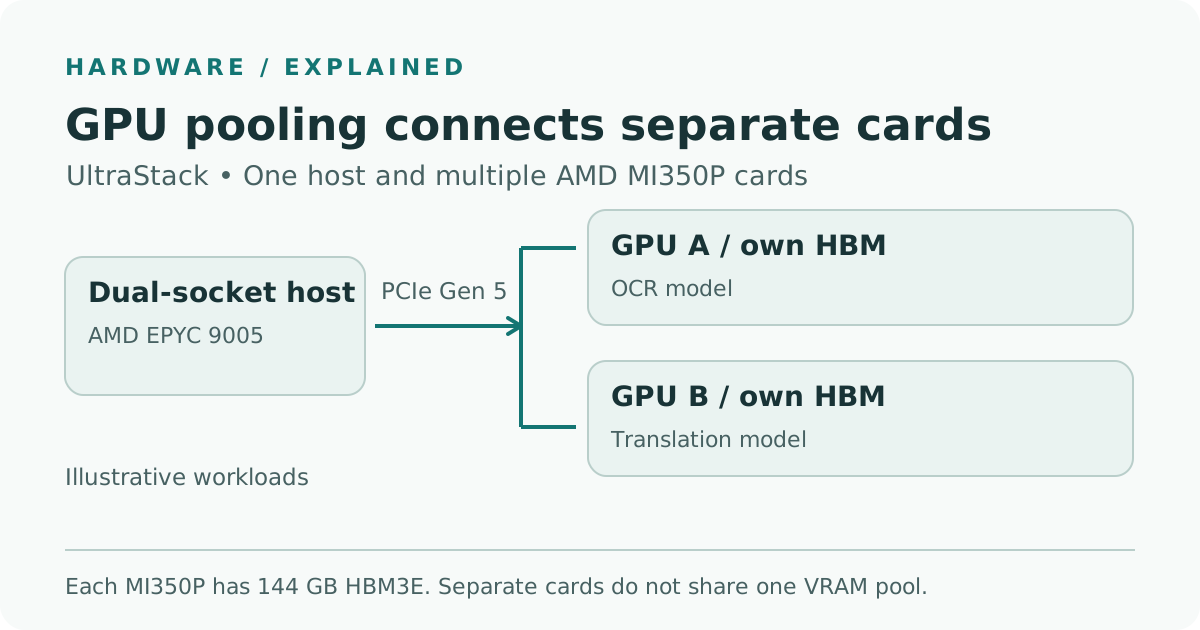
Ilustración de Telli.sh a partir de la descripción de LIQID y las especificaciones de AMD. El esquema muestra servicios independientes y deja fuera los chasis y los periféricos del equipo anfitrión.
El número de parámetros ayuda a acotar opciones, pero dos modelos con el mismo número pueden necesitar distinta memoria. Empieza por los pesos exactos y su precisión. Cuenta después el entorno de ejecución y la caché que el modelo pueda utilizar para conservar los tokens anteriores mientras genera más. Si el servicio acepta varias solicitudes largas a la vez, ejecuta el modelo propuesto y observa el consumo de memoria con esa mezcla real. Una consulta corta en una tarjeta en reposo indica si arranca el servicio. Una prueba sostenida con las entradas más largas que aceptará indica si puede seguir admitiendo trabajo.
Las colas independientes ayudan cuando los trabajos llegan a ritmos distintos
Imagina un archivo universitario que digitaliza entrevistas y documentos en papel. En una prueba, una GPU puede ejecutar un modelo documental para OCR, otra puede transcribir entrevistas y una tercera atender traducciones breves. Después de una semana midiendo el uso, una cuarta tarjeta podría alojar una segunda instancia del servicio más ocupado. Da a cada servicio su propia cola y define cuántos trabajos puede admitir a la vez. Así, una acumulación de páginas escaneadas tiene menos posibilidades de retrasar una traducción corta por competir por el mismo acelerador.
Supongamos que el archivo recibe una solicitud para traducir un texto tras el OCR. Se pueden solapar etapas de documentos distintos. El primero puede pasar a traducción mientras el segundo entra en OCR. Traducir un documento concreto sigue dependiendo de la salida OCR de ese mismo documento. Mide el tiempo desde la subida hasta un resultado utilizable para cada documento y el número de documentos terminados en toda la cadena. Un diseño que procese más documentos en una hora puede seguir dejando a un traductor esperando una página.
En otro caso, un laboratorio de ingeniería usa un asistente documental de día y procesa registros antiguos de instrumentos por la noche. El asistente debe empezar a responder en un plazo predecible cuando alguien le hace una pregunta. El proceso nocturno tiene una hora límite y normalmente tolera pausas. Mide qué parte del tiempo de cada GPU ocupa cada servicio antes de dedicarle una tarjeta de forma permanente. Si el asistente está inactivo casi todo el día pero tiene un pico tras una reunión, reservarle una segunda instancia tiene un coste incluso con poco tráfico. Compáralo con un despliegue que ya absorba el pico mediante trabajos programados o colas separadas.
La asignación de los modelos también influye en la recuperación. Un único anfitrión simplifica parte de la configuración y todos sus servicios dependen de él. Anota qué trabajos pueden esperar tras una intervención, cuáles deben volver primero y cuáles necesitan una segunda ubicación. Guarda resultados intermedios en los procesos documentales para poder reanudar desde las extracciones terminadas. Para el uso interactivo, acuerda cuánto tiempo de interrupción es aceptable o habilita otro punto de acceso. El número de tarjetas del servidor principal representa la capacidad de inferencia durante el funcionamiento normal. El tiempo de recuperación requiere su propia prueba.
LIQID midió 89.000 tokens de salida por segundo con 20 GPU
El informe de rendimiento de LIQID describe un modelo de la clase de 7.000 millones de parámetros en precisión FP4, con un nivel de concurrencia declarado de 128. Cada GPU ejecutaba su propia instancia. Al sumar las tarjetas, LIQID indica unos 89.000 tokens de salida por segundo con 20 GPU. Su estimación de unos 133.000 tokens de salida por segundo con 30 GPU prolonga el escalado observado en la prueba de 20. Ambas cifras representan la salida agregada de la configuración medida o proyectada. Una persona que lanza una solicitud experimenta la espera, el procesamiento de la entrada y la velocidad de generación de esa solicitud. Informe de rendimiento de LIQID y método de prueba
| Prueba de LIQID | Número de GPU | Tokens de salida por segundo en total | Evidencia |
|---|---|---|---|
| Clase de 7.000 millones, FP4 | 1 | 4.653 | Medición de LIQID |
| Clase de 7.000 millones, FP4 | 10 | 44.383 | Medición de LIQID |
| Clase de 7.000 millones, FP4 | 20 | Unos 89.000 | Medición de LIQID |
| Clase de 7.000 millones, FP4 | 30 | Unos 133.000 | Proyección de LIQID a partir de 20 GPU |
| Clase de 72.000 millones, FP8, límites de latencia interactiva | 8 | 1.256 | Medición aparte de LIQID |
La prueba aparte en FP8 con un modelo de 72.000 millones tenía como objetivo llegar al primer token en un máximo de dos segundos en el percentil 99 y generar como mínimo 30 tokens de salida por segundo por usuario. LIQID informa de mediciones con 2, 4 y 8 tarjetas. El tamaño, la precisión y las condiciones del servicio difieren de la prueba de rendimiento de 7.000 millones. Usa el resultado interactivo como referencia para ese tipo de ensayo y aplica tus propios objetivos de latencia a las consultas y la concurrencia que esperas. Método del ensayo de LIQID y resultados interactivos
Las cifras del modelo de 7.000 millones invitan a repetir el mismo ensayo a medida que añades instancias idénticas. Queda abierta otra pregunta para los equipos que combinan cargas. ¿Qué ocurre si las solicitudes pasan parte del tiempo leyendo muchos archivos pequeños, reuniendo contexto desde el almacenamiento o esperando a que la CPU prepare imágenes? Reproduce la misma traza dos veces con los mismos modelos y número de GPU. Ejecuta primero cada servicio por separado y luego todos a la vez. Si la ejecución conjunta aumenta las colas mientras el uso de GPU sigue bajo, examina la CPU del anfitrión, la actividad del sistema de archivos y el enrutamiento de solicitudes antes de añadir aceleradores.
Mide el trabajo útil con un límite de latencia
Empieza con una prueba que el despliegue actual pueda ejecutar. Por ejemplo, usa un conjunto representativo de 200 documentos autorizados cuyas lenguas y número de páginas escaneadas se conozcan, y reproduce junto al lote un registro anonimizado de horas de llegada de solicitudes interactivas. Mantén la composición de las entradas en los dos sistemas. Si un cambio de software o de equipo obliga a cambiar la precisión, vuelve a comprobar la calidad en la misma muestra. Cuenta solo los resultados terminados que superen las comprobaciones habituales del equipo.
- Define qué resultado consideras bueno. Para el asistente, fija un objetivo hasta la primera respuesta y otro de principio a fin, por ejemplo, un primer token en dos segundos en el percentil 95 de tu muestra interactiva. Para la extracción por lotes, fija un plazo diario y un mínimo de páginas que superen la validación. Esos objetivos son ejemplos para tu prueba. LIQID usó el percentil 99 para el primer token en su ensayo aparte de 72.000 millones.
- Registra dónde pasa el tiempo de cada solicitud. Anota cuándo llega, cuándo la recoge un proceso, cuándo produce su primera salida y cuándo termina. Etiqueta el tipo de trabajo y registra los reintentos. Con esas marcas puedes comparar la espera en cola y el tiempo activo por separado. Una sola cifra de principio a fin puede ocultar una cola larga cuando la inferencia dura poco.
- Cambia una sola cosa y reproduce el tráfico. Compara una cola compartida con colas separadas manteniendo las mismas instancias en las mismas tarjetas. Prueba después cualquier cambio en la asignación de tarjetas en un ensayo aparte. Conserva los límites de entrada y salida, el orden de llegada y las comprobaciones de calidad. Haz cada prueba después de una fase de calentamiento equivalente. Revisa el tramo de mayor actividad además del tráfico medio. Si llega un trabajo grande en mal momento, es cuando las colas separadas deberían mostrar su efecto.
- Mira el anfitrión y los medidores junto a los resultados. Registra el uso y la memoria de los aceleradores, la CPU y la RAM del anfitrión, las lecturas y escrituras y la potencia de entrada en el mismo intervalo. Indica el percentil 95 del tiempo de finalización por trabajo, las páginas o solicitudes completadas correctamente por hora y la energía por resultado válido. Revisa las pérdidas y los tiempos de espera agotados junto a los percentiles para contar también el trabajo rechazado.
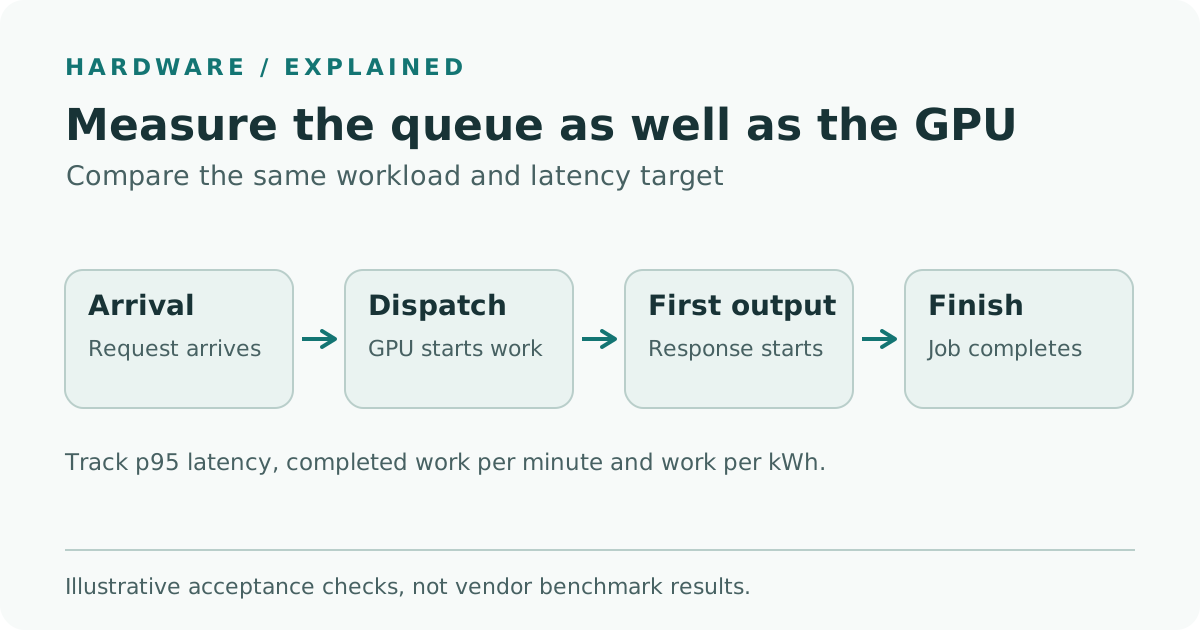
Ilustración de Telli.sh de una prueba de aceptación. Un cambio en la espera, en la primera respuesta o en el tiempo de finalización puede señalar límites distintos.
Traza una distribución de latencia por servicio. El p95 es el tiempo en el que termina el 95 % de los eventos medidos. Puede variar aunque la mediana permanezca estable, algo que importa si una persona suele enviar sus solicitudes durante el pico. Anota el número de casos detrás de cada distribución. Un percentil con cinco tareas nocturnas dice algo distinto de otro basado en cientos de solicitudes interactivas. Una reducción sostenida de la espera del servicio más ocupado, con calidad comparable y menos tiempos de espera agotados, justifica mejor dedicarle una tarjeta que un pico de rendimiento.
Aplica también el mismo alcance de medición. Para estimar la eficiencia energética, cuenta la salida útil durante un intervalo fijo y mide el mismo equipamiento en ambas configuraciones. Si solo mides el servidor y los chasis de GPU, identifica el resultado como energía del sistema informático. Si incluyes almacenamiento compartido o refrigeración, mídelo de forma coherente en los dos diseños. Registra la potencia en reposo si el servicio permanece activo todo el día. Un sistema veloz necesita menos minutos de cálculo por trabajo, pero una instalación que pasa la noche en espera con mayor consumo en reposo puede gastar más energía al cabo de un día.
Los 22 kW se deben comprobar con el equipo de instalaciones
LIQID indica unos 22 kW para su sistema completo de 30 GPU refrigerado por aire. AMD especifica una potencia típica máxima de 600 W por tarjeta MI350P y un ajuste configurable de 450 W. Treinta tarjetas a 600 W suman 18 kW para las tarjetas con ese valor de potencia. Los 22 kW indicados corresponden al sistema completo. La electricidad del edificio, los requisitos del armario y la capacidad de refrigeración dependen de la instalación. Operar a 450 W también podría cambiar el rendimiento útil. Si el proveedor admite los dos ajustes para la configuración presupuestada, compáralos con la misma carga y los mismos requisitos de calidad. Potencia de sistema según LIQID · Especificaciones de AMD MI350P
Consulta al equipo de instalaciones antes de elegir un sistema mayor. Revisa el número de chasis, la capacidad de los circuitos en operación normal y redundante, la extracción de calor en las condiciones de entrada de aire y si la instalación admite una vuelta repentina a plena carga tras un reinicio. Usa el presupuesto para aclarar cómo se gestionan el mantenimiento, la asistencia y los ajustes de potencia. Valora esas condiciones junto al coste de una cola larga de documentos. Un solo anfitrión puede reducir el número de servidores que gestionas y exigir una densidad de potencia que limite las salas disponibles.
LIQID anuncia sistemas de 4 a 30 GPU que se pueden pedir a sus socios, sujetos a existencias. Su página de producto describe un proceso de entrega de cuatro a seis semanas y vincula el plazo anunciado de cuatro semanas a la confirmación de la orden de compra. Pide un presupuesto fechado para la configuración concreta y un plazo comprometido para tu lugar de instalación. LIQID anunció que expondría en SC26, en McCormick Place, a partir del 17 de noviembre. Guía de LIQID sobre pedidos y entregas a través de socios · Anuncio de LIQID sobre SC26
¿Cuánto merece la pena pagar por reducir la espera?
Un acelerador dedicado a la traducción puede estar bien aprovechado si el siguiente equipo necesita de inmediato los pasajes traducidos. La misma tarjeta podría quedar inactiva casi toda la semana si las traducciones pueden esperar hasta mañana. Empieza con la configuración más pequeña que reproduzca trabajos simultáneos de tu laboratorio y repite varias veces el periodo de mayor actividad. Añade capacidad donde reducir la espera siga mejorando los resultados. Para un archivo, el criterio puede ser tan concreto como que el técnico reciba respuestas a tiempo y que el lote diario completo del escáner esté listo antes de entregarlo al siguiente turno.
Fuentes
- Anuncio de LIQID para SC26 e imágenes oficiales de UltraStack, 12 de noviembre de 2026
- Página de LIQID UltraStack con AMD Instinct MI350P, pedidos y potencia, consultada el 15 de noviembre de 2026
- Ficha técnica de LIQID UltraStack, consultada el 15 de noviembre de 2026
- Método y resultados de las pruebas de la fase 3 de LIQID, consultados el 15 de noviembre de 2026
- Especificaciones de AMD Instinct MI350P, consultadas el 15 de noviembre de 2026
- Fechas oficiales del evento y las exposiciones de SC26 en 2026
Para guardar notas de pruebas, gráficos y decisiones de despliegue en un lugar donde puedas buscarlos, crea una cuenta en Telli.sh.