Deep Hat Sift zamienia pominięcie uruchomienia agenta w decyzję wymagającą zatwierdzenia
Model Kindo uczy się, które alerty agent odrzuca. Jak tryb obserwacyjny, ocena progu i próbkowanie przeoczeń zmieniają ekonomię pracy agentów przy dużym wolumenie.
Agent operacyjny może doskonale oceniać alerty, a mimo to większość dnia spędzać na stwierdzaniu, że nic nie trzeba robić. Przy odpowiednio dużym wolumenie te poprawne, ale bezowocne wykonania stają się problemem projektowania systemu.
Kindo zapowiedziało Deep Hat Sift 28 października 2026 r. To model decyzyjny System One, który uczy się na werdyktach agenta i ocenia, które przychodzące zdarzenia zasługują na jego uruchomienie. Zaczyna w trybie obserwacyjnym, przepuszczając wszystko, a wstrzymywanie rozpoczyna dopiero po zatwierdzeniu progu przez człowieka. Ogłoszenie Kindo.
Interesująca jest zgoda na brak działania: wykonanie, które w ogóle się nie rozpocznie. Ten przewodnik wyjaśnia taką decyzję, porównuje ją z prostszymi kontrolami kosztów i przedstawia pilotaż mierzący ważne przeoczenia obok unikniętych wywołań.
 Centrum monitoringu bezpieczeństwa fizycznego University of Maryland, opublikowane w 2008 r. Historyczny kontekst monitorowania alertów; zdjęcie nie przedstawia Kindo, Sift ani panelu cyberbezpieczeństwa. Zdjęcie: UMD-Eskin, domena publiczna; zmniejszone z dodanymi marginesami. Źródło obrazu · Licencja i informacje o obrazie. Oficjalna informacja o produkcie.

Oszczędzenie wykonania zmienia zakres obserwacji systemu
Kiedy każde zdarzenie trafia do agenta, system może sprawdzić każdy werdykt. Gdy filtr zaczyna wstrzymywać zdarzenia, ta prosta ścieżka informacji zwrotnej się zmienia. Zdarzenia uznane za najmniej interesujące stają się tymi, którym agent nie poświęca już pełnej uwagi.
Dlatego filtrowanie różni się od wyboru tańszego modelu do tego samego żądania. Tańszy model nadal daje wynik dla każdego zdarzenia. Decyzja o wstrzymaniu usuwa wykonanie ze zwykłej ścieżki. Plan pomiaru musi uwzględniać brakujący wynik.
Naszym zdaniem pomijanie jest zachowaniem produktu wymagającym własnego właściciela. Ktoś musi ustalić, jakie dowody je uzasadniają, które rodzaje zdarzeń są chronione i co nastąpi po zmianie źródła. Traktowanie tego jako niewidocznej optymalizacji utrudnia ocenę tych decyzji.
Wyobraź sobie filtr jako dyspozytornię. Ma przekazywać dalej właściwą pracę, zachowując zapis tego, co zatrzymała. Jakość dyspozycji jest ważna, bo specjalista dalej w procesie nie zbada czegoś, czego nigdy nie otrzymał.
W pilotażu zdefiniuj zadanie agenta przed kryterium sukcesu filtra. Czy agent wykrywa incydenty, prosi o kontekst, kieruje zgłoszenia czy przygotowuje analizę? „Wymaga wykonania” powinno odpowiadać tej pracy. Inaczej model może nauczyć się spójnej decyzji niezgodnej z celem operacyjnym zespołu.
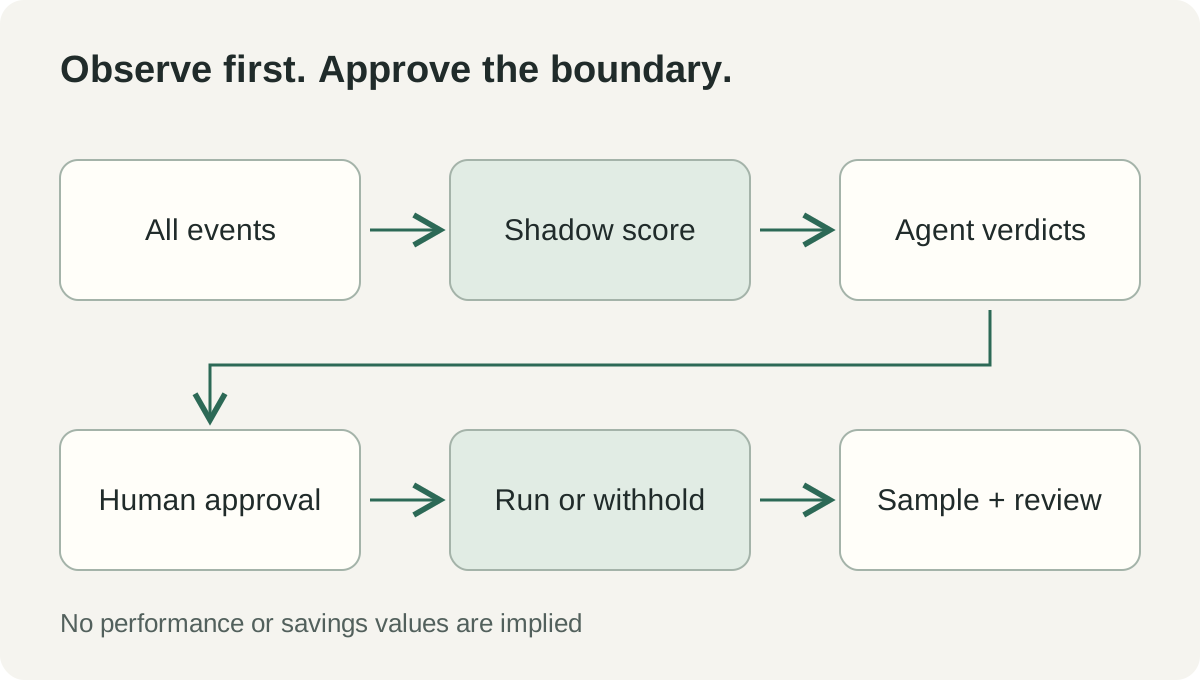 Autorskie wyjaśnienie przejścia od obserwacji do zatwierdzenia opisanego w ogłoszeniu Kindo. To uproszczony obraz działania, nie schemat wdrożenia.
Tryb obserwacyjny umożliwia porównanie, zanim zmieni dostarczanie zdarzeń
Ogłoszenie Kindo z 28 października opisuje początkowy okres, w którym Sift ocenia zdarzenia, ale wszystkie nadal docierają do docelowego agenta. Następnie pokazuje proponowane wstrzymania względem wyników tego źródła. Zatwierdzenie zawiera pisemne uzasadnienie, a losowa próbka nadal przechodzi po aktywacji, aby ujawniać przeoczenia. Zapowiedziana metoda działania.
Taka kolejność daje zespołowi operacyjnemu użyteczny scenariusz alternatywny. Przed zmianą dostarczania może zapytać, które historyczne wykonania zniknęłyby przy proponowanym ustawieniu. Pytanie jest wystarczająco konkretne, by omówić je z osobami odpowiedzialnymi za źródło i agenta.
Podgląd powinien zawierać przykłady, nie tylko sumaryczną miarę. Duża grupa rutynowych zdarzeń może zdominować główny wskaźnik, podczas gdy mała, ważna kategoria działa źle. Poproś zatwierdzającego o obejrzenie zdarzeń kosztownych w razie pominięcia oraz tych bliskich proponowanej granicy.
Długość obserwacji powinna wynikać z pokrycia przypadków. Pracowity dzień roboczy może różnić się od weekendu, dnia wydania czy nietypowego incydentu. Okres kalendarzowy jest przydatny tylko wtedy, gdy obejmuje warunki ważne dla decyzji. Nie traktuj określonej liczby spokojnych dni jako uniwersalnej oznaki gotowości.
Zatwierdzenie powinno określać zamierzone warunki działania. Zapis „zatwierdzono dla tego źródła i agenta, z tymi wyłączeniami i terminem ponownej oceny” jest użyteczniejszy od samego „tak”. Daje punkt odniesienia po zmianie schematu źródła, polecenia agenta lub priorytetów operacyjnych.
Trzy przykładowe kolejki wymagają różnej ostrożności
Powtarzalny alert infrastrukturalny może być dobrym, ograniczonym początkiem
Wyobraźmy sobie kolejkę SRE otrzymującą wiele powtórzeń znanego powiadomienia podczas rutynowej konserwacji. Zespół rozumie źródło i ma udokumentowaną drogę pilnych wyjątków. Pilotaż mógłby sprawdzić, czy agent wielokrotnie poświęca czas na ten sam werdykt o braku działania.
Najpierw oddziel znaną obsługę duplikatów od nowej decyzji. Jeśli prosta reguła korelacji już łączy identyczne zdarzenia, zachowaj ten punkt odniesienia. Oceną modelu obejmij pozostałe różnice, które sprawiają, że pełne wykonanie agenta jest kosztowne lub niepotrzebne.
W okresie obserwacji porównuj proponowane pominięcia z faktycznym działaniem agenta. Szukaj różnic w ważności, usłudze lub kontekście, przez które powierzchownie podobne zdarzenie staje się inne. Przydatne pytanie brzmi: czy filtr zachowuje rozróżnienia już uznawane za istotne przez operacje?
Przykładowe kryterium sukcesu mogłoby wymagać określonego udziału kontroli i braku przeoczonych zdarzeń w chronionej kategorii podczas oceny. Warunki wybiera zespół; nie są uniwersalnymi gwarancjami Sift. Ćwiczenie powinno prowadzić do jasnej decyzji o jednym źródle, nie natychmiastowego wdrożenia w całej organizacji.
Kolejka zgłoszeń phishingu uwidacznia koszt przeoczenia
Rozważmy przykładowy zespół bezpieczeństwa, do którego pracownicy zgłaszają podejrzane wiadomości. Wiele może nie wymagać dalszych działań, ale rzadka wiadomość wymagająca reakcji może mieć nieproporcjonalnie duże znaczenie. Ekonomia filtra zależy od tej asymetrii.
Dla tego źródła sprawdź przykłady przypominające zwykłą korespondencję, ale zawierające sygnały istotne dla zespołu. Zachowaj narzędzia bezpieczeństwa i proces incydentowy dalej w łańcuchu. Filtr przed agentem AI należy oceniać pod kątem kierowania pracy, a nie traktować jako cały program wykrywania zagrożeń.
W ocenie powinni uczestniczyć analitycy rozumiejący konsekwencje pominiętej analizy. Osoba z finansów może pomóc wycenić wykonanie, ale nie może samodzielnie określić akceptowalnego pokrycia incydentów. Próg jest wspólnym wyborem operacyjnym, którego zatwierdzenie wymaga odpowiedniej wiedzy.
Sprawdź też błędy samego agenta. Uczenie się przewidywania jego odrzuceń może odtworzyć jego ślepe punkty. Oddzielny zestaw oceniony przez analityków może ujawnić przypadki, w których agent i filtr zgadzają się ze sobą, ale oba rozmijają się z oczekiwanym wynikiem zespołu.
Kolejka zgłoszeń potrzebuje definicji użytecznego działania
W przykładowym service desku zgłoszenie może wyglądać rutynowo, ale nadal wymagać potwierdzenia, uruchomienia zegara SLA lub przekierowania. „Nie wymaga analizy” i „nie wymaga wykonania agenta” mogą więc być różnymi etykietami. Zdefiniuj dokładnie, co wolno pominąć przy wstrzymaniu wykonania.
W razie potrzeby pozostaw obowiązkowe działania poza niejednoznaczną decyzją. System zgłoszeniowy może na przykład odpowiadać za wymagane potwierdzenia, podczas gdy model pomaga zdecydować, czy uruchomić konkretnego agenta analitycznego. Taka granica jest łatwiejsza do wyjaśnienia.
Testuj zgłoszenia z różnych zespołów, języków i typów próśb. Filtr uczony głównie na rutynowych żądaniach jednego działu może źle odpowiadać wzorcom eskalacji innego. Ocena dla konkretnego źródła jest lepsza niż założenie, że sam wolumen czyni dwie kolejki równoważnymi.
Wynikiem pilotażu może być bardziej przejrzysta kolejka analiz, nie mniejsza liczba zgłoszeń. Mierz przekazanie człowiekowi i czas do kolejnego istotnego działania. To wiąże ocenę z jakością obsługi, zamiast ograniczać ją do liczby wywołań modelu.
Cztery sposoby kontroli kosztów odpowiadają na różne pytania
Poniższe porównanie opisuje decyzje projektowe możliwe do oceny przez zespół. Nie twierdzi, że konkretna implementacja dostawcy wygrywa w każdej kategorii. Kilka kontroli może współistnieć, ponieważ działa w różnych miejscach systemu.
| Kontrola | Podejmowana decyzja | Co mierzyć |
|---|---|---|
| Deduplikacja lub reguły korelacji | Czy zdarzenia się powtarzają lub są powiązane? | Zachowane odrębne incydenty i połączone powtórzenia |
| Tańszy model dla każdego zdarzenia | Czy można zastosować tańszą analizę? | Jakość i pełny koszt na zdarzenie |
| Filtr wyboru wykonań, np. Sift | Czy to zdarzenie w ogóle potrzebuje tego agenta? | Uniknięte wykonania, przeoczenia wymagające reakcji i pokrycie kontroli |
| Budżety wywołań i routing | Które wywołanie modelu jest dozwolone i mieści się w budżecie? | Wydatki, odrzucone wywołania i ukończenie zadania dalej w procesie |
Porównanie zaczyna od decyzji, co pomaga uniknąć podwójnego liczenia oszczędności. Jeśli reguła korelacji już usuwa powtórzone zdarzenie, filtr nie może również przypisać sobie zapobieżenia temu samemu wykonaniu. Określ punkt odniesienia po istniejących kontrolach i dopiero oblicz dodatkowy efekt.
Uwzględnij własny koszt działania filtra. Hosting, monitorowanie, wykonania próbkowane i kontrola człowieka należą do rachunku pilotażu. Niższy rachunek jednego endpointu dostawcy jest przydatny, ale to tylko część pełnego procesu.
Jakość należy omawiać razem z kosztem. Próg oszczędzający wiele wywołań, ale ukrywający potrzebną pracę, zmienił usługę. Zespół powinien umieć wyjaśnić kompromis językiem rzeczywistej kolejki, zamiast jedną ogólną wartością procentową dokładności.
Wykorzystaj próbkowane przeoczenia do lepszych pytań
FAQ Kindo, sprawdzone 2 listopada, opisuje domyślną 3-procentową próbkę przepuszczanych zdarzeń, konfigurowalną od 1% do 5%, oraz początkowe domyślne minimum 400 oznaczonych werdyktów. Według opisu dryf lub przekroczenie pułapu uruchomień przywraca tryb obserwacyjny. To opublikowane wartości domyślne, nie gwarancja dostatecznych dowodów dla każdego obciążenia.
Przykładowe obliczenie pokazuje znaczenie pokrycia próbki. Jeśli wstrzymano by 10 000 zdarzeń, a próbka obejmuje 3%, otrzymamy około 300 zdarzeń. Jeśli ważne przypadki są rzadkie, zespół nadal musi zbadać, czy próbka reprezentuje kategorie, których przeoczenia mają znaczenie. Ta arytmetyka ilustruje problem próbkowania, nie szacuje rzeczywistego błędu Sift.
W swojej ocenie podawaj co najmniej dwa mianowniki. Jeden opisuje zdarzenia wymagające działania, które filtr by przeoczył. Drugi opisuje udział wstrzymanych zdarzeń później uznanych za wymagające działania. Odpowiadają na różne pytania: pokrycie ważnej pracy i zanieczyszczenie zbioru pominięć.
Gdy to istotne, analizuj przekroje według typu źródła, ważności, zespołu i zmieniającego się formatu wejścia. Średnia może się poprawiać, podczas gdy mała kategoria się pogarsza. Kategorie powinny odzwierciedlać ryzyko i obciążenie operacji, a nie najłatwiejszy sposób narysowania wykresu.
Wreszcie oddziel werdykt agenta od niezależnie ocenionego wyniku. Zgodność z agentem mierzy, jak dobrze Sift go przewiduje. Sama nie dowodzi poprawności jego osądu. Obie miary mogą być użyteczne, jeśli ich znaczenie pozostaje jawne.
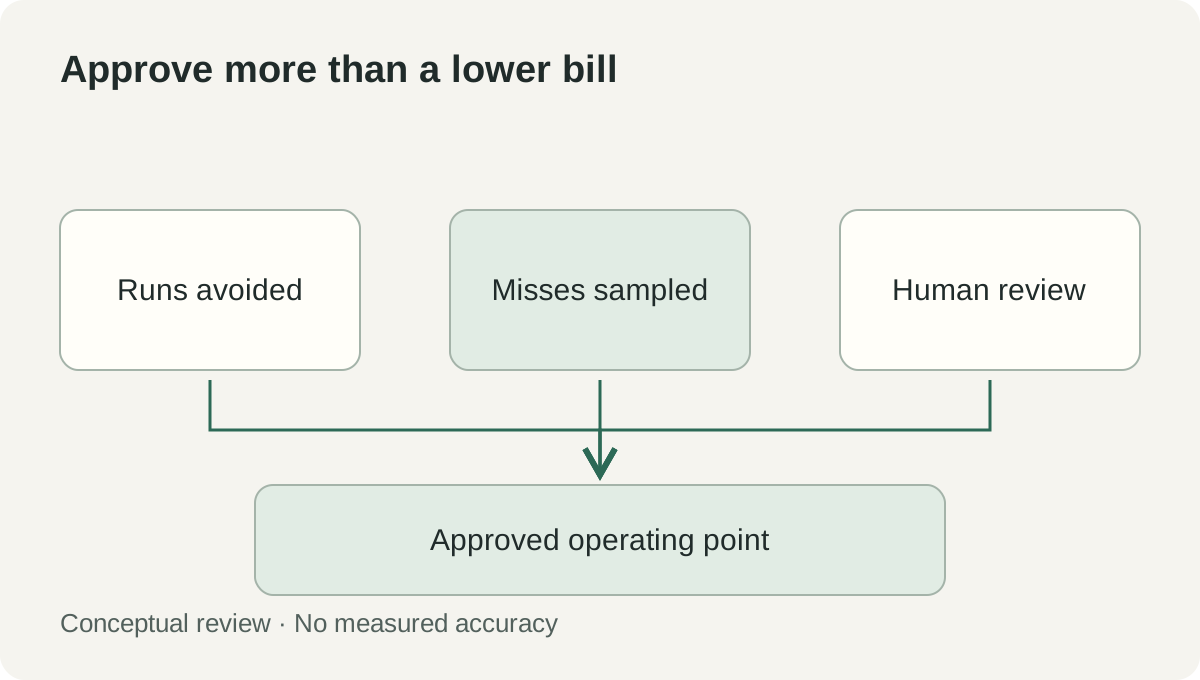 Autorska pomoc w ocenie decyzji. Pokazuje, co operator powinien porównywać, bez zmierzonych oszczędności lub dokładności. Próbkowanie i zatwierdzanie opisano na stronie produktu Kindo.
Obecne wdrożenie ma ograniczenia, które pilotaż musi uwzględnić
Według stanu na 2 listopada Kindo opisuje Sift jako usługę samodzielnie hostowaną dla agentów Kindo. FAQ wymienia wdrożenie Docker Compose na jednym hoście, bez klastra i przełączania awaryjnego, oraz konta lokalne bez SSO i MFA. Sift nie ma osobnej bezpłatnej wersji próbnej ani poziomu użycia. FAQ obecnego wydania.
Te warunki wpływają na miejsce pilotażu. Omów granice wdrożenia z osobami odpowiedzialnymi za tożsamość, dostępność i reagowanie na incydenty. Udana demonstracja punktacji nie odpowie, czy usługa spełnia wymagania operacyjne organizacji.
- Wskaż jedno źródło, agenta i właściciela decyzji. Zapisz zadanie agenta i to, co pominęłoby wstrzymanie. Zachowaj istniejącą odpowiedzialność za wykrywanie i zgłoszenia.
- Omów aktualne wymagania wdrożenia z Kindo. Potwierdź dostępny model hostingu i obowiązki wsparcia należące do twojego zespołu.
- Zdefiniuj zatwierdzony punkt odniesienia. Uwzględnij obecne reguły, korelację i routing modeli, by pilotaż mierzył dodatkową wartość.
- Zacznij w trybie obserwacyjnym. Zbierz reprezentatywne werdykty i oceń proponowane wstrzymania w ważnych kategoriach przed zmianą dostarczania.
- Oceniaj błędy niezależnie. Uwzględnij przykłady sprawdzone przez analityków i przypadki chronione, zamiast polegać wyłącznie na zgodności z docelowym agentem.
- Zatwierdź konkretne ustawienie i uzasadnienie. Zapisz zakres, osobę oceniającą, plan próbkowania i warunki ponownej oceny.
- Przećwicz powrót do obserwacji. Potwierdź, co widzą operatorzy i jak pełny strumień ponownie trafia do agenta. W końcowej ocenie uwzględnij koszt, jakość i dostępność.
Wynikiem powinna być ograniczona decyzja operacyjna z właścicielem. Jeśli pilotaż ujawni niepewną kategorię, pozostawienie jej na ścieżce pełnej analizy jest użytecznym rezultatem. Chodzi o ustalenie, gdzie wstrzymywanie jest uzasadnione, a nie o maksymalizację pominięć przy pierwszej okazji.
Uniknięte wywołanie jest cenne, gdy wiadomo, jakiej pracy nie ukryło
Sift wnosi do procesu agenta ważne pytanie: które zdarzenia zasługują na pełne wykonanie i kto odpowiada za tę granicę? Podejście rozpoczynające od obserwacji daje zespołom miejsce do zbadania decyzji, zanim zmieni ona dostarczanie zdarzeń.
Trwałą miarą jest zdolność operacji do pokazania zaoszczędzonych wykonań, zaobserwowanych przeoczeń i uzasadnienia obecnego progu. Właśnie to zamienia brak aktywności w decyzję, za którą ktoś może wziąć odpowiedzialność.
Źródła
- Ogłoszenie Deep Hat Sift firmy Kindo, rozpowszechnione przez PR Newswire, 28 października 2026 r., 09:00 ET.
- Kindo: szczegóły Deep Hat Sift i FAQ obecnego wydania, sprawdzono 2 listopada 2026 r.
Zachowaj materiały stojące za decyzją
Telli.sh to jedna z możliwości przechowywania materiałów źródłowych, do których masz uprawnienia, wraz z przejrzanymi notatkami. Utwórz przestrzeń na notatki.