Avec Deep Hat Sift, ne pas lancer un agent devient une décision à faire approuver
Le modèle de tri de Kindo apprend quelles alertes un agent écarte. Comment le mode observation, l’approbation du seuil et l’échantillonnage des omissions changent l’économie des agents à fort volume.
Un agent d’exploitation peut parfaitement examiner les alertes tout en passant l’essentiel de sa journée à conclure qu’aucune action n’est nécessaire. À un volume suffisant, ces exécutions correctes mais sans suite deviennent un problème de conception du système.
Kindo a annoncé Deep Hat Sift le 28 octobre 2026, un modèle de décision System One qui apprend des verdicts d’un agent et attribue aux événements entrants un score indiquant s’ils méritent une exécution. Il commence en mode observation, en laissant tout passer, puis ne commence à retenir des événements qu’après l’approbation du seuil par une personne. Annonce de Kindo.
Le point intéressant est l’approbation d’une absence : une exécution qui ne démarre jamais. Ce guide explique cette décision, la compare à des contrôles de coûts plus simples et décrit un pilote mesurant les omissions importantes autant que les appels évités.
 Centre de surveillance de la sécurité physique de l’université du Maryland, image publiée en 2008. Contexte historique de surveillance des alertes ; cette photo ne montre ni Kindo, ni Sift, ni un tableau de bord de cybersécurité. Photo : UMD-Eskin, domaine public ; redimensionnée avec des marges. Source de l’image · Licence et précisions sur l’image. Référence officielle du produit.

Économiser une exécution change ce que le système peut observer
Lorsque chaque événement atteint un agent, le système peut examiner chaque verdict. Dès qu’un filtre retient certains événements, ce circuit de retour simple change. Les événements jugés les moins intéressants deviennent ceux qui ne reçoivent plus toute l’attention de l’agent.
Le filtrage diffère donc du choix d’un modèle moins cher pour la même demande. Un modèle moins coûteux produit toujours un résultat pour chaque événement. Une décision de rétention supprime une exécution du parcours habituel. Le plan de mesure doit tenir compte de ce résultat absent.
Notre avis : ne pas exécuter est un comportement du produit qui doit avoir son propre responsable. Quelqu’un doit décider quelles preuves le rendent acceptable, quels types d’événements restent protégés et ce qui se passe lorsque la source change. En faire une optimisation invisible complique l’examen de ces décisions.
Imaginez un poste de répartition. Sa tâche utile est de transmettre le bon travail tout en gardant une trace de ce qui n’est pas parti. La qualité de cette répartition compte, car le spécialiste en aval ne peut pas examiner ce qu’il ne reçoit jamais.
Pour un pilote, définissez la tâche de l’agent avant de définir la réussite du filtre. L’agent identifie-t-il des incidents, demande-t-il davantage de contexte, oriente-t-il des tickets ou prépare-t-il une enquête ? « Nécessite une exécution » doit correspondre à cette tâche. Sinon, un modèle peut apprendre une décision cohérente qui ne répond pas à l’objectif opérationnel de l’équipe.
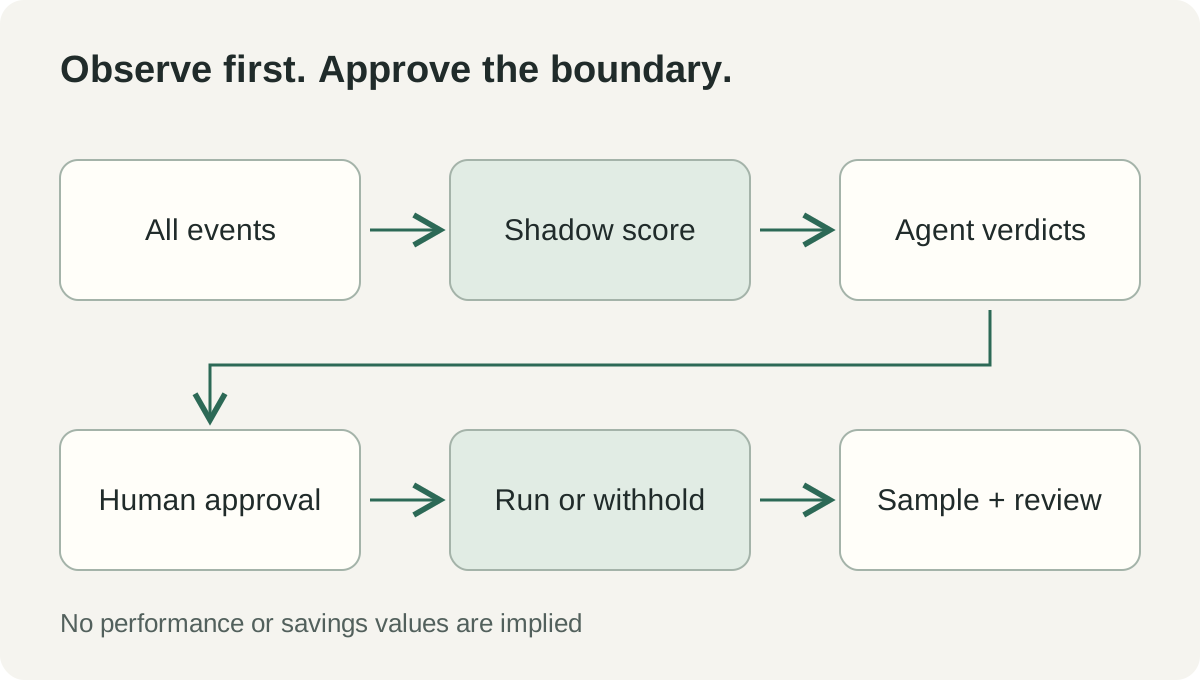 Explication originale du passage de l’observation à l’approbation décrit dans l’annonce de Kindo. Il s’agit d’une vue opérationnelle simplifiée, pas d’un schéma de déploiement.
Le mode observation crée une comparaison avant de modifier la transmission
Le communiqué de Kindo du 28 octobre décrit une période initiale durant laquelle Sift note les événements tandis qu’ils atteignent tous l’agent cible. Il présente ensuite les rétentions proposées au regard des résultats de cette source ; l’approbation comprend une justification écrite et, après activation, un échantillon aléatoire continue de passer afin de révéler les omissions. Méthode opérationnelle annoncée.
Cet ordre donne à l’équipe d’exploitation un scénario contrefactuel utile. Avant de changer la transmission, elle peut identifier les exécutions historiques qui auraient disparu avec un réglage proposé. La question est assez concrète pour être examinée avec les responsables de la source et de l’agent.
L’aperçu doit comprendre des exemples, pas seulement un agrégat. Un grand nombre d’événements courants peut dominer un taux global tandis qu’une petite catégorie importante fonctionne mal. Demandez à la personne qui approuve d’examiner les événements dont l’omission coûterait cher et ceux proches de la limite proposée.
La durée d’observation doit dépendre de la couverture. Un jour ouvré chargé peut différer d’un week-end, d’une journée de mise en production ou d’un incident inhabituel. Une période calendaire n’est utile que si elle contient les conditions importantes pour la décision. Un certain nombre de journées calmes ne constitue pas un signal universel de préparation suffisante.
L’approbation doit préciser les conditions opérationnelles visées. Un enregistrement comme « approuvé pour cette source et cet agent, avec ces exclusions et cet intervalle de révision » est plus utile qu’un simple oui. Il fournit un point de référence lorsque le schéma source, la consigne de l’agent ou les priorités opérationnelles changent.
Trois files illustratives exigent des précautions différentes
Une alerte d’infrastructure répétitive peut offrir un premier périmètre bien délimité
Imaginons une file SRE recevant de nombreuses répétitions d’une notification connue pendant une maintenance courante. L’équipe connaît déjà la source et dispose d’un parcours documenté pour les exceptions urgentes. Un pilote pourrait examiner si un agent passe régulièrement du temps à conclure qu’aucune action n’est nécessaire.
Commencez par séparer le traitement des doublons connus de la nouvelle décision. Si une règle simple de corrélation regroupe déjà les événements identiques, conservez cette référence. Utilisez l’évaluation du modèle pour examiner les variations restantes qui rendent une exécution complète coûteuse ou inutile.
Pendant l’observation, comparez les exécutions que le filtre propose d’éviter à ce que l’agent a réellement fait. Recherchez les changements de gravité, de service concerné ou de contexte qui distinguent des événements superficiellement similaires. Il faut savoir si le filtre préserve les distinctions déjà importantes pour l’exploitation.
Un critère de réussite illustratif pourrait imposer un taux de vérification donné et aucune omission dans une catégorie protégée pendant l’évaluation. Ces conditions sont choisies par l’équipe ; ce ne sont pas des garanties universelles de Sift. L’exercice doit aboutir à une décision claire concernant une source, pas à un déploiement immédiat dans toute l’organisation.
Une file de signalements de phishing rend plus visible le coût d’une omission
Prenons une équipe de sécurité illustrative dont les salariés signalent des messages suspects. Beaucoup de signalements peuvent ne demander aucune suite, mais un message rare nécessitant une action peut avoir une importance disproportionnée. L’économie du filtre dépend de cette asymétrie.
Pour cette source, examinez des exemples ressemblant à de la correspondance ordinaire mais contenant les signes recherchés par l’équipe. Maintenez les outils de sécurité et le processus de gestion des incidents en aval. Un filtre placé devant un agent IA doit être évalué pour cette décision d’orientation, sans être assimilé à tout le dispositif de détection.
L’évaluation doit associer les analystes qui comprennent les conséquences d’une enquête manquée. Un interlocuteur financier peut aider à quantifier le coût des exécutions, mais ne peut pas définir seul une couverture acceptable des incidents. Le seuil est un choix opérationnel partagé dont l’approbation exige les bonnes compétences.
Examinez aussi les erreurs de l’agent lui-même. Apprendre à prévoir qu’un agent écartera un cas peut reproduire ses angles morts. Un jeu distinct contrôlé par des analystes peut révéler les cas où l’agent et le filtre sont d’accord entre eux tout en s’écartant du résultat souhaité par l’équipe.
Une file de tickets exige une définition de l’action utile
Dans un service d’assistance illustratif, un ticket peut sembler courant mais nécessiter quand même un accusé de réception, un chronomètre de niveau de service ou une étape d’orientation. « Aucune enquête nécessaire » et « aucune exécution d’agent nécessaire » peuvent donc être des étiquettes différentes. Définissez exactement ce qu’une exécution supprimée est autorisée à omettre.
Maintenez les actions obligatoires en dehors d’une décision ambiguë lorsque c’est nécessaire. Le système de tickets peut, par exemple, conserver la responsabilité des accusés de réception requis tandis que le modèle aide à décider si un agent d’enquête donné doit intervenir. La limite devient ainsi plus facile à expliquer.
Testez les tickets de différentes équipes, langues et catégories de demandes. Un filtre entraîné surtout sur les demandes courantes d’un service peut mal correspondre aux schémas d’escalade d’un autre. Une évaluation propre à chaque source est plus utile que l’hypothèse selon laquelle le volume rend deux files équivalentes.
Pour ce pilote, le résultat peut être une file d’enquête plus nette plutôt qu’une baisse du nombre de tickets. Mesurez la transmission humaine et le délai jusqu’à la prochaine action significative. L’évaluation reste ainsi liée à la qualité de service plutôt qu’au seul décompte des appels de modèle.
Quatre contrôles de coûts répondent à des questions différentes
La comparaison suivante décrit des choix de conception qu’une équipe peut évaluer. Elle n’affirme pas que l’implémentation d’un fournisseur gagne dans toutes les catégories. Plusieurs contrôles peuvent coexister dans le même système, puisqu’ils interviennent à des endroits différents.
| Contrôle | Décision prise | Éléments à mesurer |
|---|---|---|
| Déduplication ou règles de corrélation | Ces événements sont-ils répétés ou liés ? | Incidents distincts préservés et répétitions regroupées |
| Modèle moins cher pour chaque événement | Cet événement peut-il être analysé à moindre coût ? | Qualité et coût complet par événement |
| Filtre de sélection des exécutions comme Sift | Cet événement a-t-il vraiment besoin de cet agent ? | Exécutions évitées, cas utiles manqués et couverture de vérification |
| Budgets et routage par appel | Quel appel de modèle est autorisé et abordable ? | Dépenses, appels refusés et achèvement des tâches en aval |
Cette comparaison part de la décision, ce qui évite de compter deux fois les économies. Si une règle de corrélation supprime déjà un événement répété, le filtre ne peut pas revendiquer lui aussi la suppression de cette même exécution en aval. Définissez la référence après les contrôles existants, puis calculez les effets supplémentaires.
Incluez les coûts propres au filtre. Hébergement, surveillance, exécutions échantillonnées et vérification humaine appartiennent tous au bilan du pilote. Une facture réduite pour un point d’accès fournisseur est utile, mais ne représente qu’une composante du processus complet.
La qualité doit être discutée en même temps que le coût. Un seuil qui économise beaucoup d’appels tout en cachant du travail utile modifie le service. L’équipe doit pouvoir expliquer ce compromis dans les termes de sa file réelle plutôt qu’avec un pourcentage générique d’exactitude.
Utilisez les omissions échantillonnées pour poser de meilleures questions
La FAQ de Kindo, consultée le 2 novembre, décrit un échantillon laissé passer de 3% par défaut, réglable de 1% à 5%, et un seuil initial par défaut de 400 verdicts étiquetés. Elle indique qu’une dérive ou le dépassement d’un plafond de déclenchement ramène le système en observation. Ce sont des réglages opérationnels publiés, pas une garantie de preuves suffisantes pour toutes les charges.
Un calcul illustratif montre pourquoi la couverture de l’échantillon compte. Supposons que 10 000 événements soient destinés à être retenus et que 3% soient échantillonnés : cela produit environ 300 événements examinés. Si les cas importants sont rares, l’équipe doit encore vérifier si cet échantillon représente les catégories dont les omissions seraient significatives. Ce calcul illustre la question d’échantillonnage et n’estime pas le taux d’erreur réel de Sift.
Présentez au moins deux dénominateurs dans votre évaluation. L’un concerne les événements nécessitant une action que le filtre manquerait. L’autre décrit la part des événements retenus jugés utiles après coup. Ils répondent à des questions opérationnelles différentes : couverture du travail important et présence de cas utiles dans l’ensemble écarté.
Examinez les sous-ensembles par type de source, gravité, équipe et évolution du format d’entrée lorsque ces critères sont pertinents. L’agrégat peut s’améliorer pendant qu’une petite catégorie se dégrade. Les catégories doivent refléter les risques et la charge de l’exploitation, plutôt que le regroupement le plus facile à représenter dans un graphique.
Enfin, distinguez le verdict de l’agent d’un résultat vérifié indépendamment. L’accord avec l’agent mesure la capacité de Sift à prévoir cet agent. Il ne prouve pas, à lui seul, que le jugement de l’agent était correct. Les deux mesures sont utiles lorsque leur signification reste explicite.
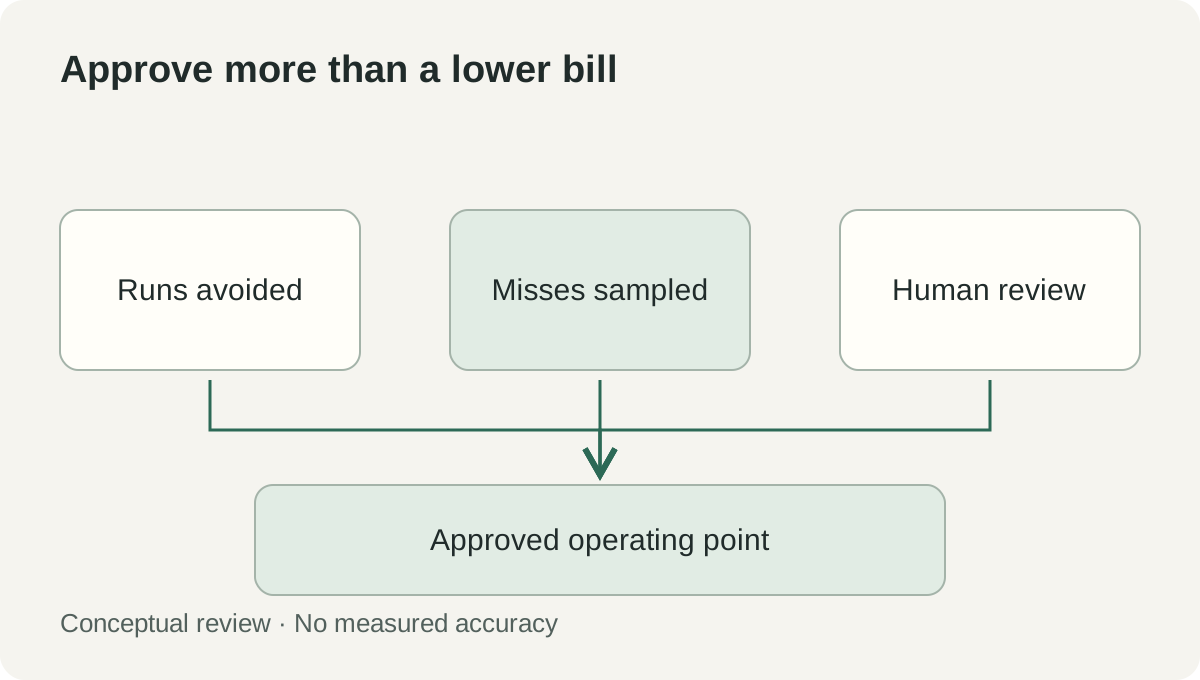 Aide originale à l’examen des décisions. Elle illustre les éléments à comparer et ne contient aucune mesure d’économies ou d’exactitude. L’échantillonnage et l’approbation sont documentés sur la page produit de Kindo.
Le déploiement actuel comporte des limites à intégrer au pilote
Au 2 novembre, Kindo décrit Sift comme un service auto-hébergé pour les agents Kindo. Sa FAQ indique un déploiement Docker Compose sur un hôte unique, sans cluster ni basculement, et des comptes locaux sans SSO ni MFA. Sift ne possède ni essai gratuit ni palier d’utilisation distinct. FAQ de la version actuelle.
Ces conditions déterminent où un pilote peut s’insérer. Examinez le périmètre de déploiement avec les responsables de l’identité, de la disponibilité et de la réponse aux incidents. Une démonstration de scoring réussie ne suffit pas à établir que le service répond aux exigences opérationnelles de l’organisation.
- Désignez une source, un agent et un responsable de décision. Écrivez ce que fait l’agent et ce qu’une exécution évitée omettrait. Conservez les responsabilités existantes de détection et de gestion des tickets.
- Examinez les exigences actuelles de déploiement avec Kindo. Confirmez l’hébergement disponible et le soutien opérationnel qui incomberait à votre équipe.
- Définissez une référence approuvée. Incluez les règles, la corrélation et le routage de modèles existants afin de mesurer la valeur supplémentaire du pilote.
- Commencez en mode observation. Recueillez des verdicts représentatifs et examinez les rétentions proposées dans les catégories importantes avant de changer la transmission.
- Vérifiez les erreurs indépendamment. Incluez des exemples examinés par des analystes et des cas protégés, au lieu de vous fier entièrement à l’accord avec l’agent cible.
- Approuvez un réglage précis et sa justification. Consignez le périmètre, la personne chargée de l’examen, le plan d’échantillonnage et les conditions exigeant une nouvelle révision.
- Exercez le retour en mode observation. Confirmez ce que voient les opérateurs et la manière dont tout le flux atteint de nouveau l’agent. Incluez coût, qualité et disponibilité dans le bilan final.
Le résultat doit être une décision opérationnelle délimitée, avec un responsable. Si le pilote révèle une catégorie incertaine, la maintenir dans le parcours d’analyse complète est un résultat utile. L’objectif est de découvrir où la rétention est justifiée, pas de maximiser les événements écartés dès la première occasion.
Un appel évité a de la valeur si vous pouvez expliquer quel travail il n’a pas caché
Sift introduit une question importante dans le fonctionnement des agents : quels événements méritent une exécution complète, et qui répond de cette frontière ? Son approche commençant par l’observation permet aux équipes d’examiner la décision avant de modifier la transmission.
La mesure durable est la capacité de l’exploitation à montrer les exécutions économisées, les omissions observées et la raison pour laquelle le seuil actuel reste approprié. C’est ce qui transforme une absence d’activité en décision dont quelqu’un peut répondre.
Sources
- Annonce de Deep Hat Sift par Kindo, diffusée via PR Newswire, 28 octobre 2026, 09:00 ET.
- Kindo : informations produit Deep Hat Sift et FAQ de la version actuelle, consultées le 2 novembre 2026.
Conserver les éléments qui fondent une décision
Telli.sh est une option pour conserver des sources dont l’utilisation est autorisée aux côtés des notes que vous avez révisées. Créer un espace de notes.