Deep Hat Sift convierte omitir la ejecución de un agente en una decisión que alguien debe aprobar
El modelo de clasificación de eventos de Kindo aprende qué alertas descarta un agente. Cómo el modo sombra, la revisión de umbrales y el muestreo de omisiones cambian los costes del trabajo de agentes a gran escala.
Un agente de operaciones puede revisar una alerta de forma excelente y aun así pasar casi todo el día concluyendo que no hace falta actuar. Con suficiente volumen, esas ejecuciones correctas pero sin consecuencias se convierten en un problema de diseño del sistema.
Kindo anunció Deep Hat Sift el 28 de octubre de 2026, un modelo de decisión System One que aprende de los veredictos de un agente y puntúa qué eventos entrantes merecen ejecutarlo. Empieza en modo sombra, dejando pasar todo, y solo comienza a retener eventos después de que una persona apruebe el umbral. Anuncio de Kindo.
Lo interesante es aprobar una ausencia: una ejecución que nunca empieza. Esta guía explica esa decisión, la compara con controles de coste más sencillos y propone un piloto que mida las omisiones importantes junto a las llamadas evitadas.
 Centro de vigilancia de seguridad física de la Universidad de Maryland, publicado en 2008. Contexto histórico de supervisión de alertas; no muestra Kindo, Sift ni un panel de ciberseguridad. Fotografía: UMD-Eskin, dominio público; redimensionada con márgenes. Fuente de la imagen · Licencia y notas de la imagen. Referencia oficial del producto.

Ahorrar una ejecución cambia lo que el sistema puede observar
Cuando todos los eventos llegan al agente, el sistema puede inspeccionar cada veredicto. Cuando un filtro empieza a retener eventos, cambia esa vía sencilla de retroalimentación. Los eventos considerados menos interesantes pasan a ser los que ya no reciben toda la atención del agente.
Eso distingue el filtrado de elegir un modelo más barato para la misma petición. Un modelo más barato sigue produciendo un resultado para cada evento. Retenerlo elimina una ejecución del recorrido habitual. El plan de medición debe contemplar ese resultado ausente.
Nuestra opinión: omitir es un comportamiento del producto con un responsable propio. Alguien debe decidir qué evidencia lo justifica, qué tipos de evento siguen protegidos y qué ocurre cuando cambia la fuente. Tratarlo como una optimización invisible dificulta revisar esas decisiones.
Piensa en el filtro como una central de distribución. Su función útil es remitir el trabajo adecuado y conservar un registro de lo que queda atrás. La calidad de esa distribución importa porque el especialista posterior no puede investigar algo que nunca recibe.
En el piloto, define el trabajo del agente antes de definir el éxito del filtro. ¿Identifica incidentes, solicita contexto, distribuye incidencias o prepara una investigación? «Necesita una ejecución» debería corresponder a ese trabajo. De lo contrario, el modelo puede aprender una decisión consistente que no coincida con el propósito operativo del equipo.
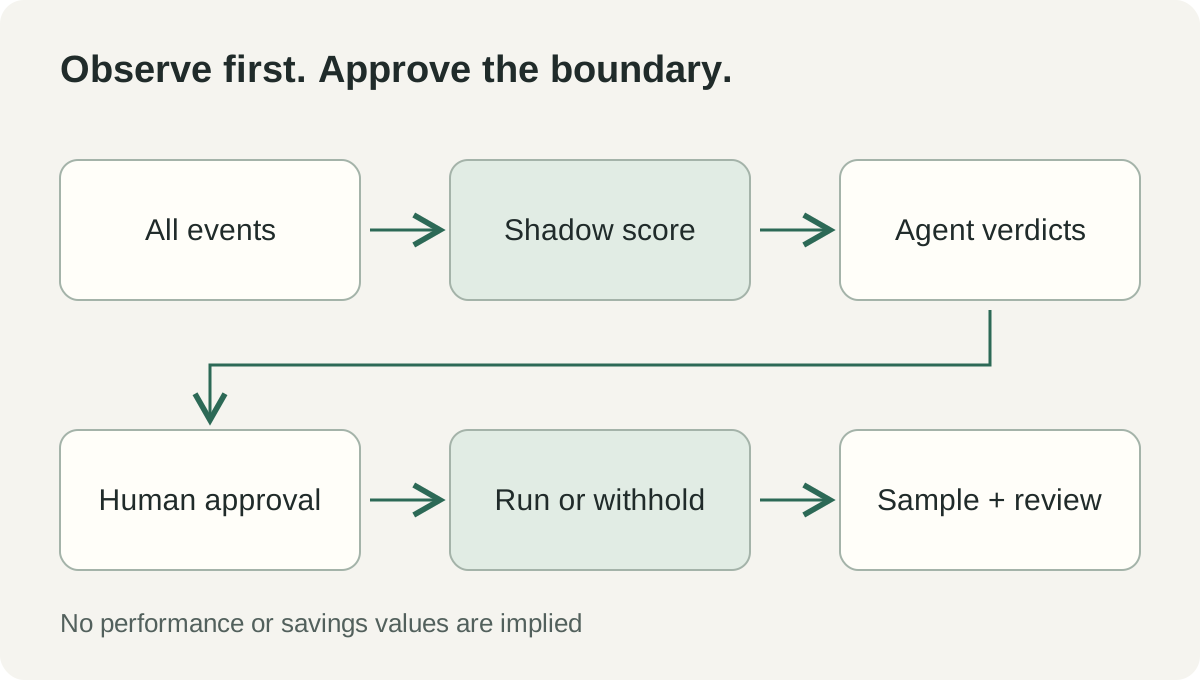 Explicación original del paso del modo sombra a la aprobación descrito en el anuncio de Kindo. Es una vista operativa simplificada, no un diagrama de despliegue.
El modo sombra permite comparar antes de cambiar la entrega
El comunicado de Kindo del 28 de octubre describe un periodo inicial en que Sift puntúa eventos mientras todos siguen llegando al agente destinatario. Después muestra una previsión de las retenciones propuestas frente a los resultados de esa fuente; la aprobación incluye un motivo escrito y, tras activarla, una muestra aleatoria sigue pasando para revelar omisiones. Método operativo anunciado.
Ese orden ofrece al equipo un contrafactual útil. Antes de cambiar la entrega, puede preguntar qué ejecuciones históricas habrían desaparecido con el punto de funcionamiento propuesto. Es una pregunta suficientemente concreta para revisarla con quienes responden de la fuente y del agente.
La previsión debería incluir ejemplos además de un agregado. Un gran grupo de eventos rutinarios puede dominar una tasa principal mientras una categoría pequeña pero importante funciona mal. Pide a quien aprueba que inspeccione los eventos cuya omisión sería costosa y los cercanos al límite propuesto.
La duración de la observación debería depender de la cobertura. Un día laborable concurrido puede diferir de un fin de semana, un lanzamiento o un incidente poco habitual. Un periodo solo resulta útil si contiene las condiciones relevantes. Evita tratar un número concreto de días tranquilos como una señal universal de preparación.
La aprobación debería nombrar la condición operativa prevista. «Aprobado para esta fuente y este agente, con estas exclusiones y este intervalo de revisión» resulta más útil que un simple sí. Proporciona algo que revisar cuando cambien el esquema de la fuente, las instrucciones del agente o las prioridades.
Tres colas ilustrativas requieren cautelas distintas
Una alerta repetida de infraestructura puede ser un buen punto de partida acotado
Imagina una cola SRE que recibe muchas repeticiones de una notificación conocida durante el mantenimiento rutinario. El equipo ya conoce la fuente y tiene una vía documentada para excepciones urgentes. Un piloto podría examinar si el agente invierte tiempo reiteradamente en concluir que no debe actuar.
Empieza separando el tratamiento conocido de duplicados de la nueva decisión. Si una regla sencilla de correlación ya agrupa eventos idénticos, conserva esa referencia. Utiliza la evaluación para examinar la variación restante que encarece o vuelve innecesaria una ejecución completa.
Durante la observación en sombra, compara las omisiones propuestas con lo que realmente hizo el agente. Busca cambios de gravedad, servicio afectado o contexto que distingan eventos superficialmente similares. La pregunta útil es si el filtro conserva las diferencias que operaciones ya considera importantes.
Un criterio ilustrativo de éxito podría exigir una tasa específica de revisión y ningún evento omitido de una categoría protegida durante la evaluación. Son condiciones elegidas por el equipo, no garantías universales de Sift. El ejercicio debería producir una decisión clara sobre una fuente, no un despliegue inmediato en toda la organización.
Una cola de denuncias de phishing hace más visible el coste de una omisión
Considera un equipo de seguridad ilustrativo cuyos empleados notifican mensajes sospechosos. Muchos avisos pueden no requerir actuación, pero un mensaje infrecuente que sí la requiera puede importar desproporcionadamente. Los costes y beneficios del filtro dependen de esa asimetría.
Para esta fuente, inspecciona ejemplos similares a correspondencia ordinaria que contengan las señales relevantes. Mantén las herramientas de seguridad posteriores y el proceso de incidentes. Evalúa el filtro previo al agente para esa decisión de distribución, sin tratarlo como todo el programa de detección.
La evaluación debería involucrar a los analistas que entienden las consecuencias de perder una investigación. Un responsable financiero puede ayudar a cuantificar el coste de ejecución, pero no definir por sí solo la cobertura aceptable. El umbral es una elección operativa compartida cuya aprobación requiere conocimientos adecuados.
Revisa también los errores del agente. Aprender a predecir sus descartes puede reproducir sus puntos ciegos. Un conjunto separado revisado por analistas puede revelar casos en que agente y filtro coinciden entre sí, pero ambos discrepan del resultado que desea el equipo.
Una cola de incidencias necesita definir qué acción es útil
En un servicio de asistencia ilustrativo, una incidencia puede parecer rutinaria pero exigir acuse de recibo, un temporizador de nivel de servicio o una asignación. «No requiere investigación» y «no requiere ejecutar el agente» pueden ser etiquetas distintas. Define exactamente qué puede omitirse al retener una ejecución.
Cuando sea necesario, deja las acciones obligatorias fuera de una decisión ambigua. Por ejemplo, el sistema de incidencias puede conservar la responsabilidad de los acuses exigidos mientras el modelo ayuda a decidir si debe ejecutarse un agente investigador concreto. Así resulta más fácil explicar el límite.
Prueba incidencias de distintos equipos, idiomas y tipos de petición. Un filtro entrenado principalmente con las solicitudes rutinarias de un departamento puede encajar mal con los patrones de escalado de otro. Una evaluación específica de la fuente vale más que suponer que el volumen hace equivalentes dos colas.
En este piloto, el resultado puede ser una cola de investigación más limpia en lugar de menos incidencias. Mide el traspaso humano y el tiempo hasta la siguiente acción significativa. Así mantienes la evaluación vinculada a la calidad del servicio y no a contar llamadas al modelo.
Cuatro controles de coste responden a preguntas diferentes
La comparación siguiente describe opciones de diseño evaluables. No afirma que la implementación de un proveedor gane en todas las categorías. Varios controles pueden convivir porque actúan en puntos distintos.
| Control | Decisión que toma | Qué medir |
|---|---|---|
| Reglas de deduplicación o correlación | ¿Estos eventos se repiten o están relacionados? | Incidentes distintos conservados y repeticiones agrupadas |
| Un modelo más barato para cada evento | ¿Puede analizarse este evento con menor coste? | Calidad y coste completo por evento |
| Un filtro de selección como Sift | ¿Necesita este evento realmente a este agente? | Ejecuciones evitadas, omisiones relevantes y cobertura de revisión |
| Presupuestos por llamada y distribución | ¿Qué llamada está permitida y es asumible? | Gasto, llamadas rechazadas y finalización de la tarea posterior |
Empezar por la decisión evita contar dos veces el ahorro. Si una regla de correlación ya elimina un evento repetido, el filtro no puede atribuirse también haber evitado esa misma ejecución. Define la referencia después de los controles existentes y calcula los efectos incrementales.
Incluye el coste operativo del propio filtro. Alojamiento, supervisión, ejecuciones muestreadas y revisión humana pertenecen a las cuentas del piloto. Reducir la factura de un punto de acceso es útil, pero solo es un componente del proceso completo.
La calidad pertenece a la misma conversación que el coste. Un umbral que ahorra muchas llamadas ocultando trabajo útil ha cambiado el servicio. El equipo debería poder explicar ese compromiso con el lenguaje de su cola real, no con un único porcentaje genérico de exactitud.
Utiliza las omisiones muestreadas para formular mejores preguntas
Las preguntas frecuentes de Kindo, consultadas el 2 de noviembre, describen una muestra predeterminada del 3% que se deja pasar, configurable del 1% al 5%, y un mínimo inicial predeterminado de 400 veredictos etiquetados. Indican que la deriva o superar el límite del disparador devuelve el sistema al comportamiento en sombra. Son valores operativos publicados, no una garantía de evidencia suficiente para cualquier carga.
Un cálculo ilustrativo muestra la importancia de la cobertura. Supongamos que se retendrían 10,000 eventos y se muestrea el 3%: resultarían aproximadamente 300 eventos. Si los casos importantes son raros, aún hay que comprobar si la muestra representa las categorías cuyas omisiones importarían. Esta aritmética ilustra el problema de muestreo, no estima la tasa real de error de Sift.
Comunica al menos dos denominadores en tu evaluación. Uno describe los eventos que requieren actuar y que el filtro omitiría. Otro, la proporción de eventos retenidos que después se consideran relevantes. Responden a preguntas distintas: cobertura del trabajo importante y contaminación del conjunto omitido.
Examina segmentos por tipo de fuente, gravedad, equipo y cambios de formato cuando sean relevantes. El agregado puede mejorar mientras empeora una categoría pequeña. Las categorías deberían reflejar los riesgos y la carga de la operación, no la agrupación más fácil de dibujar.
Por último, separa el veredicto del agente del resultado revisado independientemente. Coincidir con el agente mide lo bien que Sift lo predice. No demuestra, por sí solo, que el criterio del agente fuera correcto. Ambas medidas pueden ser útiles si su significado permanece explícito.
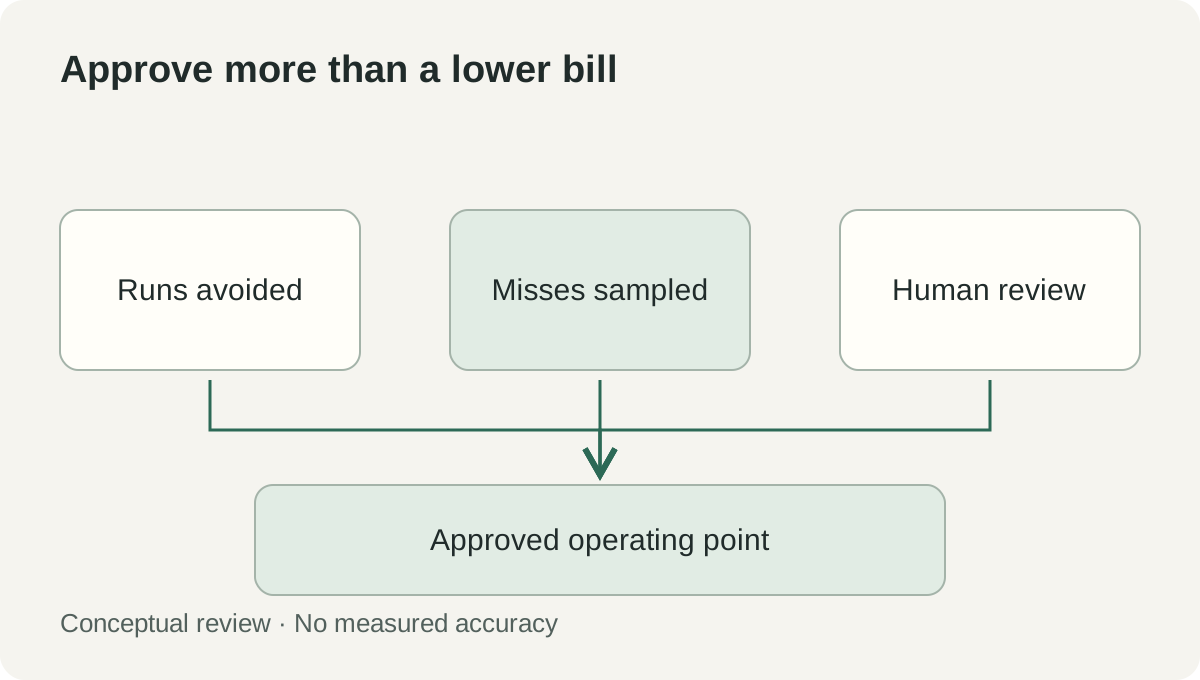 Guía original de revisión de decisiones. Ilustra qué debería comparar el operador y no contiene cifras medidas de ahorro ni exactitud. El muestreo y la aprobación se documentan en la página de Kindo.
El despliegue actual tiene límites que debe incluir el piloto
A 2 de noviembre, Kindo describe Sift como un servicio autoalojado para agentes de Kindo. Sus preguntas frecuentes indican un despliegue Docker Compose en un único servidor, sin clúster ni conmutación por error, y cuentas locales sin SSO ni MFA. No hay una prueba gratuita ni un nivel de uso gratuito específicos de Sift. Preguntas frecuentes de la versión actual.
Esas condiciones afectan a dónde encaja el piloto. Revisa el perímetro de despliegue con quienes responden de identidad, disponibilidad y gestión de incidentes. Una demostración satisfactoria de puntuación no determina si el servicio cumple los requisitos operativos de la organización.
- Nombra una fuente, un agente y un responsable de decisión. Escribe qué hace el agente y qué se omitiría al no ejecutarlo. Conserva las responsabilidades actuales de detección e incidencias.
- Revisa los requisitos actuales con Kindo. Confirma el alojamiento disponible y el soporte operativo que asumiría tu equipo.
- Define una referencia aprobada. Incluye reglas, correlación y distribución de modelos existentes para medir el valor incremental.
- Empieza en modo sombra. Recoge veredictos representativos e inspecciona las retenciones propuestas en categorías importantes antes de cambiar la entrega.
- Revisa los errores independientemente. Incluye ejemplos revisados por analistas y casos protegidos, sin depender por completo de coincidir con el agente destinatario.
- Aprueba un punto operativo y un motivo concretos. Registra alcance, revisor, plan de muestreo y condiciones que exigirían otra revisión.
- Prueba la vuelta al modo sombra. Confirma qué ven los operadores y cómo vuelve a llegar todo el flujo al agente. Incluye coste, calidad y disponibilidad en la valoración final.
El resultado debería ser una decisión operativa acotada con responsable. Si el piloto revela una categoría incierta, conservarla en el análisis completo es útil. Se trata de aprender dónde está justificada la retención, no de maximizar los eventos omitidos a la primera oportunidad.
Una llamada evitada aporta valor cuando puedes explicar el trabajo que no ocultó
Sift introduce una pregunta importante en el trabajo de agentes: ¿qué eventos merecen una ejecución completa y quién responde de ese límite? Su enfoque de empezar en sombra permite examinar la decisión antes de utilizarla para cambiar la entrega.
La medida duradera es poder mostrar las ejecuciones ahorradas, las omisiones observadas y la razón por la que el umbral sigue siendo adecuado. Eso convierte una ausencia de actividad en una decisión que alguien puede defender.
Fuentes
- Anuncio de Deep Hat Sift de Kindo, distribuido mediante PR Newswire, 28 de octubre de 2026, 09:00 ET.
- Kindo: detalles de Deep Hat Sift y preguntas frecuentes de la versión actual, consultados el 2 de noviembre de 2026.
Conserva el material que sustenta una decisión
Telli.sh es una opción para conservar material autorizado de las fuentes junto a las notas que has revisado. Crea un espacio de notas.