Jev choisit au lieu de converser : trois démonstrations et leurs limites
Ce que fait réellement Jev de TypeSafe, avec un GIF Browser Use et une démo vidéo, un cas portant sur 1 500 e-mails et des démonstrations officielles de jeux. Découvrez où les décisions typées aident, où elles échouent et comment évaluer un vrai processus.
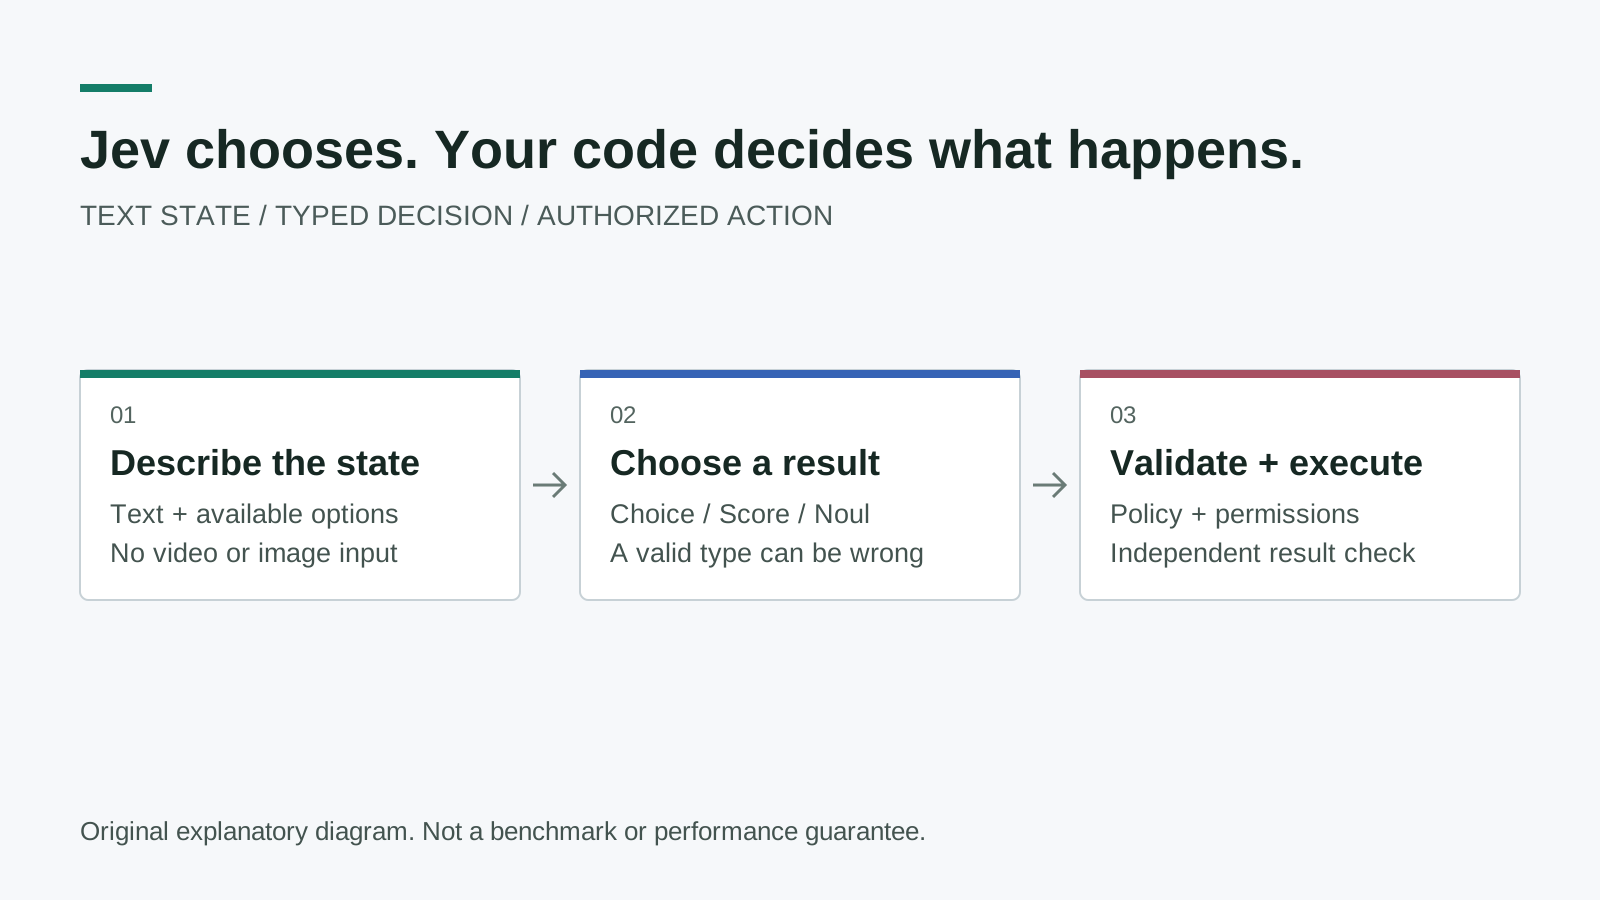
Schéma explicatif original, et non benchmark du fournisseur. Le modèle choisit dans un espace défini ; le code de l’application reste responsable des autorisations, de la validation et de l’exécution.
Un outil de tri des e-mails n’a pas besoin de rédiger un essai avant de choisir un dossier. Un contrôleur de navigateur doit souvent choisir un bouton disponible, et non inventer une nouvelle commande. C’est dans ces petites décisions que Jev, le premier modèle System One de TypeSafe AI, présente l’argument le plus intéressant.
TypeSafe a présenté Jev le 15 septembre 2026. Ce qui compte n’est pas simplement qu’il s’agisse d’un autre modèle rapide : il renvoie des décisions contraintes plutôt que du texte libre. Cela change la façon de construire le programme qui l’entoure, sans supprimer le risque d’une mauvaise réponse. Consultez le lancement officiel pour connaître la présentation du fournisseur.
Ce guide examine trois démonstrations publiques : une tâche dans un navigateur avec des preuves vidéo et GIF téléchargeables, le récit d’un auteur sur le classement de 1,500 e-mails et les démonstrations de jeux de TypeSafe. Nous transformons également ces exemples en un plan d’évaluation concret. L’article de cas d’usage de Tistory, publié le 18 septembre, a servi de point de départ à la recherche ; les applications qu’il propose ne sont pas présentées ici comme des déploiements clients vérifiés de façon indépendante.
En bref :
- Jev peut choisir, noter ou évaluer une proposition à partir d’un texte ; il ne remplace pas un modèle qui rédige librement.
- Un résultat typé valide peut tout de même être erroné sur le fond. Gardez la validation et l’autorisation finale dans le code.
- L’enregistrement du navigateur est réel, mais une tâche ne constitue pas un benchmark général. L’exemple des e-mails est le récit d’un auteur, pas une étude de précision publiée.
- Commencez par une classification réversible, mesurez les erreurs sur vos propres données et prévoyez l’abstention comme résultat possible.
Une réponse courte exige parfois une question très précise
Les trois primitives principales de l’API sont Choice, Score et Noul. Choice sélectionne une option parmi des choix nommés. Score évalue des niveaux décrits et ordonnés. Noul renvoie la probabilité d’une proposition binaire ; une valeur proche du milieu exprime l’incertitude à son sujet, pas un niveau de gravité moyen. La documentation des primitives définit ces contrats.
Le changement pratique consiste à définir les résultats possibles avant de demander au modèle de décider. Au lieu de lui demander un paragraphe sur un message d’assistance reçu, vous pouvez lui demander s’il concerne la facturation, l’accès au compte, un défaut du produit ou une catégorie non résolue. Votre application décide ensuite quelle file afficher. C’est un aiguillage sur une voie ferrée, pas le train entier : cela aide à diriger le travail, sans fournir toutes les capacités nécessaires pour le terminer.
| Primitive | Question utile | Responsabilité de l’application |
|---|---|---|
| Choice | Quelle file parmi celles-ci correspond le mieux à ce message ? | Définir un ensemble complet d’options, avec un parcours de révision |
| Score | Dans quelle mesure ce message correspond-il aux niveaux d’urgence décrits ? | Définir les niveaux et vérifier si les évaluateurs sont d’accord |
| Noul | Ce message demande-t-il explicitement une annulation ? | Décider quelle probabilité justifie une vérification ou une action réversible |
La formulation de bonnes options fait partie du travail d’ingénierie. Si deux étiquettes se chevauchent, un choix apparemment assuré peut masquer un problème dans votre taxonomie. Si aucune étiquette ne convient, forcer une sélection fait passer un manque de couverture pour de la certitude. Une option de révision est souvent plus utile qu’une nouvelle catégorie étroitement définie, car elle révèle les points à améliorer dans le contrat de décision.
Au 30 septembre 2026, la référence des modèles indique jev-1.13.0, une entrée textuelle uniquement et un tarif de $0.042 par million de jetons d’entrée, les jetons de sortie étant gratuits. C’est le prix des jetons du modèle, pas le coût total d’exécution d’un agent. Navigateurs, extraction, modèles auxiliaires, nouvelles tentatives et vérification humaine doivent aussi figurer dans le budget opérationnel.
Le GIF du navigateur montre une vraie recherche, pas une réservation de vol
Le dépôt public jev-ultrafast de Browser Use comprend l’enregistrement d’une recherche sur Google Flights, de Zurich à Londres. Jev choisit une opération et une cible à partir de la représentation de la page actuelle. Un assistant génératif distinct fournit le texte lorsque l’opération choisie nécessite une saisie. Il s’agit d’un système composé, et non d’une preuve que Jev génère lui-même chaque chaîne ou interprète les images vidéo.
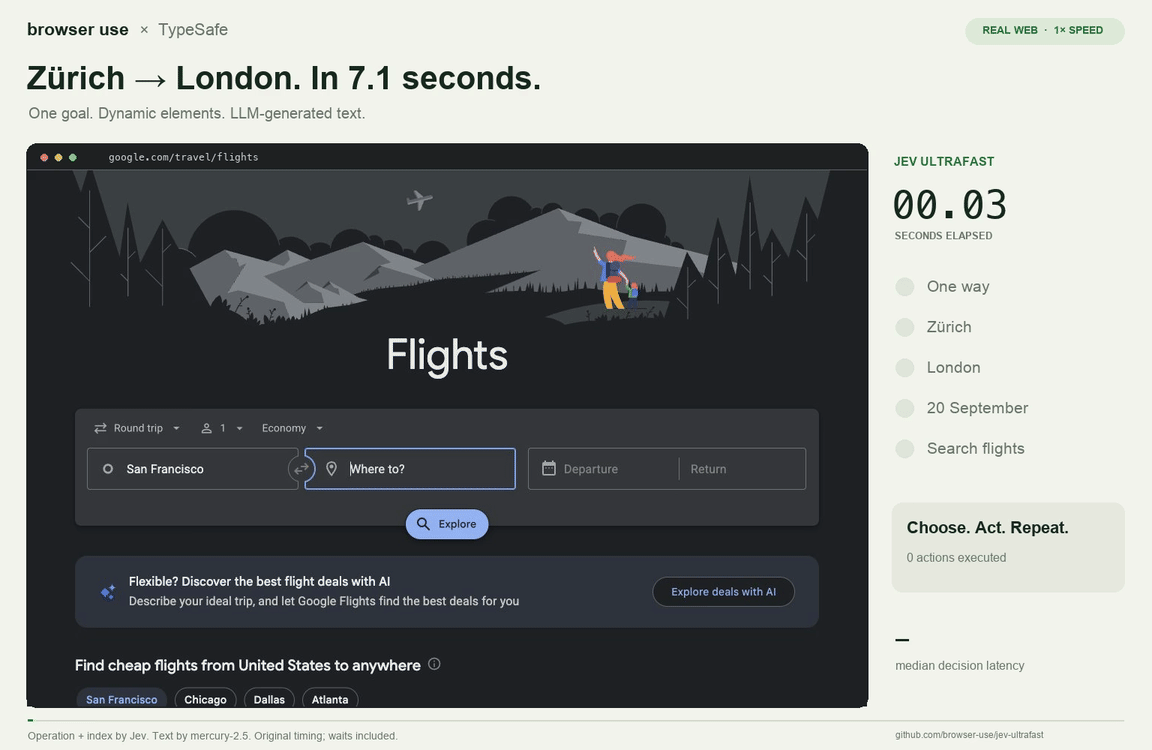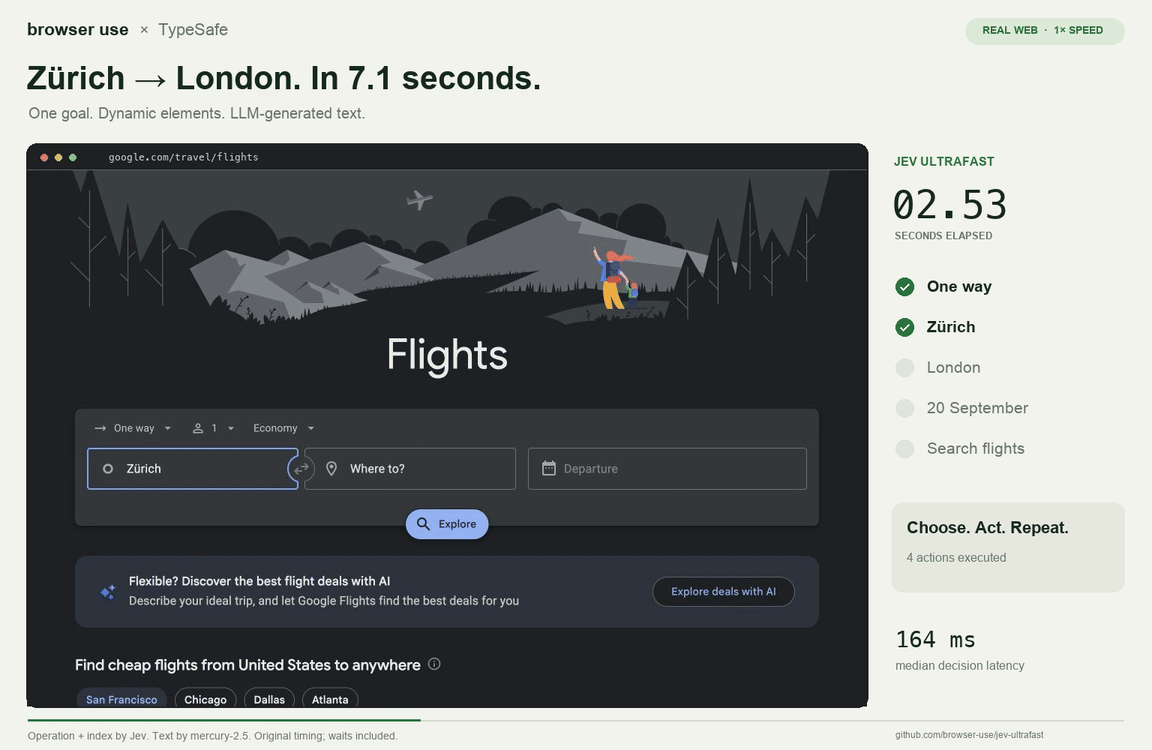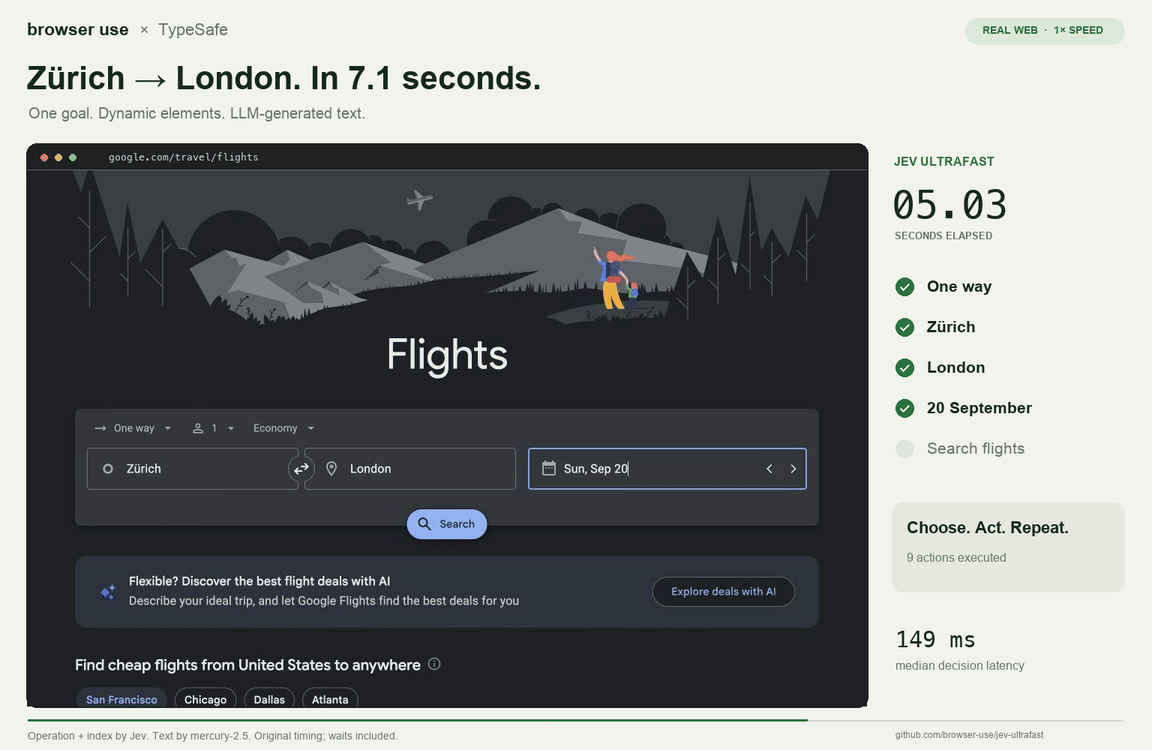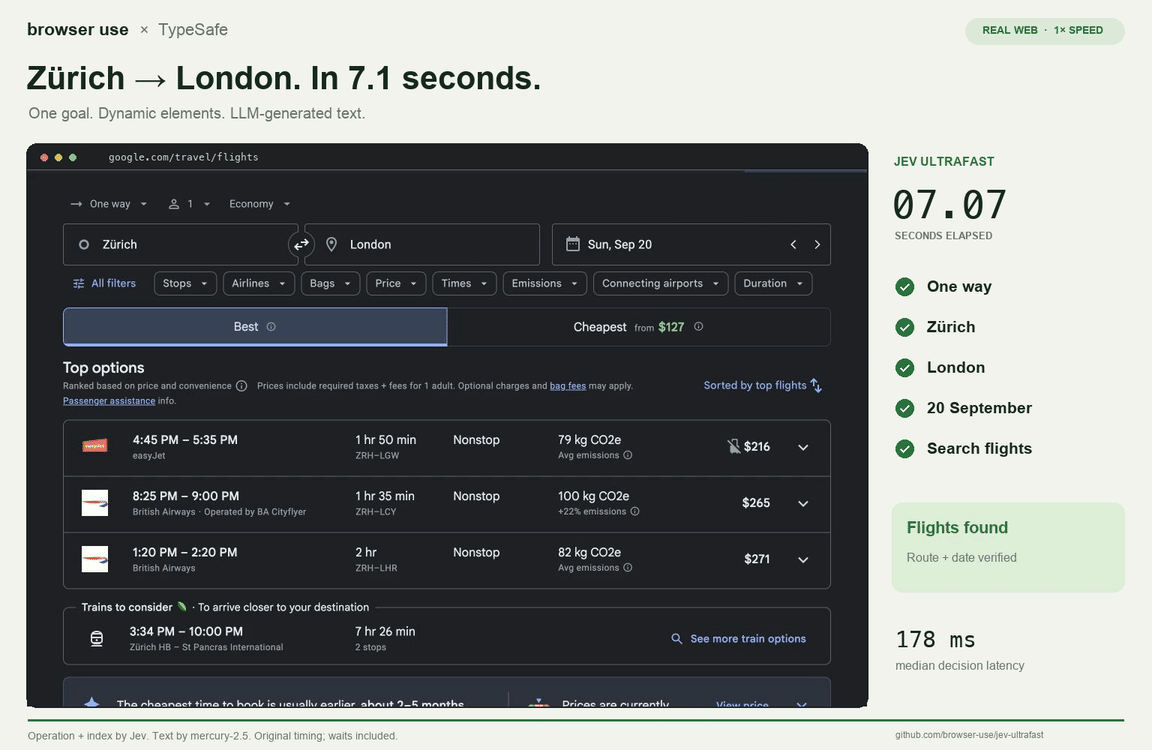
GIF réel enregistré par l’auteur avec Browser Use, épinglé au commit 1231850a0bf1a0c0341fe408ef1668dbbfdfac46. Copyright 2026 Browser Use, licence MIT. Il montre une recherche, pas un achat. Le même enregistrement peut être lu ci-dessous.
Fichier MP4 de l’auteur, affiché à sa vitesse d’enregistrement avec les commandes du lecteur. Enregistrement original et notes de mesure ; licence MIT conservée. Nous avons examiné les éléments publics, sans refaire ce benchmark.
Le temps d’exécution mesuré par l’auteur pour cet enregistrement est de 7.073 secondes. Le chronomètre démarre à la première prédiction après l’observation initiale de la page d’accueil, et non au lancement d’un navigateur vierge. La configuration, la navigation initiale et la vérification indépendante effectuée après l’exécution à partir d’un état vierge sont hors de cet intervalle chronométré. Les résultats de recherche sont vérifiés ; aucun billet n’est sélectionné ni acheté. Ces limites sont indispensables pour comprendre ce que signifie ce chiffre.
Le même compte rendu compare six exécutions alternées, trois pour chaque environnement d’exécution. La durée médiane de la tâche passe de 9.450 secondes à 7.092 secondes, tandis que le nombre médian d’appels au protocole du navigateur descend de 1,092 à 101. Les deux groupes utilisent Jev et le même assistant textuel ; il s’agit donc principalement d’une comparaison d’environnements d’exécution, pas d’une compétition entre deux familles de modèles. L’auteur souligne explicitement le faible échantillon et la variabilité du Web en direct dans le rapport de performance.
À notre avis, la boucle du navigateur mérite autant d’attention que le modèle. Recueillir la page de façon répétée, résoudre les cibles et invalider les décisions peut coûter davantage que ne le suggère la simplicité apparente d’un clic. Un moteur de décision rapide ne compense pas une description peu fiable du bouton qu’il doit choisir. Le dépôt conserve une vérification indépendante du résultat, car le fait qu’un modèle affirme avoir terminé ne prouve pas que la tâche l’est.
C’est aussi là que les limites de la démonstration deviennent utiles. L’implémentation documentée ne couvre pas toutes les images, tous les canevas, parcours de téléversement ou widgets clavier arbitraires. Une équipe qui l’évalue devrait reproduire ses propres tâches représentatives et leurs cas d’échec, plutôt que de déduire d’une recherche de vol réussie une compétence générale de navigation. Considérez l’enregistrement comme une preuve consultable d’une composition qui fonctionne.
Le billet sur 1,500 e-mails est prometteur, mais ses dénominateurs manquent
Le 16 septembre 2026, vogel (@ryanvogel) a publié sur X qu’il avait essayé Jev sur 1,500 de ses propres e-mails et était impressionné par les résultats de classification. La publication originale comprend une vidéo. C’est un exemple d’utilisation réelle utile : la charge de travail est concrète et la source est la personne qui relate l’expérience, plutôt qu’une liste d’applications hypothétiques sans attribution.
Ce n’est toutefois pas un rapport de précision. La publication ne définit ni jeu de test public annoté, ni taux d’erreur mesuré, ni accord entre évaluateurs, ni coût des erreurs. Le nombre de messages traités indique l’ampleur de l’expérience, pas sa justesse. Regardez la démonstration originale sur X en gardant cette distinction à l’esprit ; sa vidéo est liée plutôt que recopiée sans licence de redistribution.
Le classement des e-mails reste néanmoins un bon point de départ pour une évaluation, car il peut être rendu réversible. Affichez les étiquettes suggérées à côté de la boîte de réception existante, laissez les messages originaux intacts et consignez les corrections. Comparez les paires ambiguës : une facture et un rappel de paiement, ou une demande d’annulation et une plainte qui ne fait que mentionner une annulation. Ces cas montrent si les catégories correspondent à votre véritable processus.
Un déploiement initial ne devrait pas supprimer automatiquement des e-mails, envoyer des réponses ou approuver des transactions simplement parce qu’une classification semble assurée. Ces actions engagent d’autres autorisations et conséquences. Commencez par des suggestions ou une file de vérification ; ne promouvez une action limitée qu’après avoir mesuré son profil d’erreur. Voici notre procédure d’évaluation proposée, et non une affirmation sur l’implémentation de l’auteur du message sur X.
Doom et Wikiracing rendent visible la boucle de décision
Le lancement de TypeSafe comprend une démonstration de Doom et une démonstration de Wikiracing, toutes deux liées dans l’article de lancement officiel. Elles expliquent visuellement les décisions répétées. Elles ne prouvent pas que Jev est un modèle visuel généraliste ni qu’il peut résoudre n’importe quel problème de planification.
Dans l’exemple de Doom, le modèle reçoit une description textuelle structurée de l’état, pas des captures d’écran. Dans Wikiracing, il choisit parmi les liens disponibles au lieu d’inventer une URL de destination. Le mécanisme intéressant est le cycle répété d’observation, de choix encadré et d’action. Les démonstrations de jeux rendent ce cycle facile à voir, sans répondre à la question de sa transférabilité à un autre environnement.
La même séparation apparaît dans la documentation de la démo domotique de TypeSafe. Différentes questions peuvent classer les aspects d’une demande, tandis qu’un autre composant gère la conversation libre ou la décomposition d’une demande complexe. Il ne faut pas décrire cette architecture comme un modèle unique qui génère du langage et exécute chaque décision. Des termes comme assistant ou agent masquent souvent ces limites, à moins que l’implémentation ne les rende explicites.
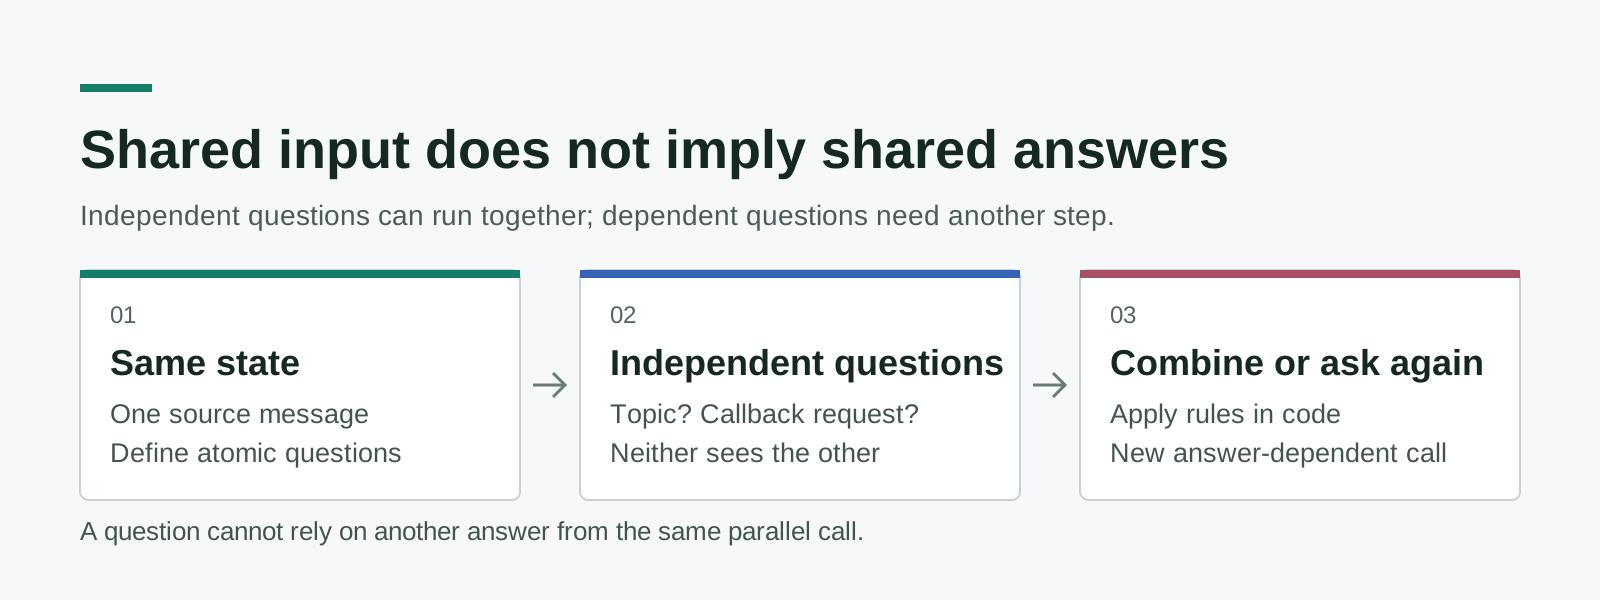
Schéma original fondé sur le contrat documenté du fan-out. Les questions simultanées partagent le même état ; elles ne lisent pas secrètement les réponses les unes des autres.
Le modèle fan-out peut réduire l’attente séquentielle lorsque plusieurs questions dépendent de la même source. Par exemple, on peut évaluer indépendamment le sujet d’un message et la présence d’une demande explicite de rappel. Une question qui dépend d’un sujet nouvellement choisi ne peut pas supposer que cette réponse existe déjà au sein du même appel. Séparez cette dépendance en une étape ultérieure ou combinez les résultats indépendants de façon déterministe dans le code.
Une réponse typée n’est pas nécessairement une bonne réponse
L’interprétation la plus dangereuse d’un modèle contraint consiste à croire qu’une réponse bien formée ne peut pas être erronée. C’est faux. Un classificateur peut choisir une étiquette autorisée mais inadaptée, et un sélecteur d’action peut choisir un bouton valide sur le mauvais formulaire. Éliminer les formulations mal formées d’une interface est utile, mais cela corrige une autre catégorie d’échec que la mauvaise compréhension de la tâche.
Les notes sur les irrégularités de Jev 1.13 de TypeSafe, examinées pour la dernière fois le 17 septembre, décrivent des faiblesses en arithmétique, en comptage, dans les comparaisons de dates, face aux contextes distrayants et aux entrées adversariales. Pour des comparaisons exactes, analysez les dates et calculez les quantités avec du code ordinaire. Ne transformez pas une règle déterministe en jugement sémantique simplement parce que le modèle accepte la question.
La documentation sur la confiance compte également : Choice et Score exposent des distributions de probabilités et une valeur de confiance dérivée ; Noul n’a pas de champ de confiance distinct. Cette valeur n’est pas une probabilité universelle que la réponse soit correcte. Les seuils doivent être validés pour votre propre tâche, surtout lorsque les conséquences d’un faux positif diffèrent de celles d’un faux négatif.
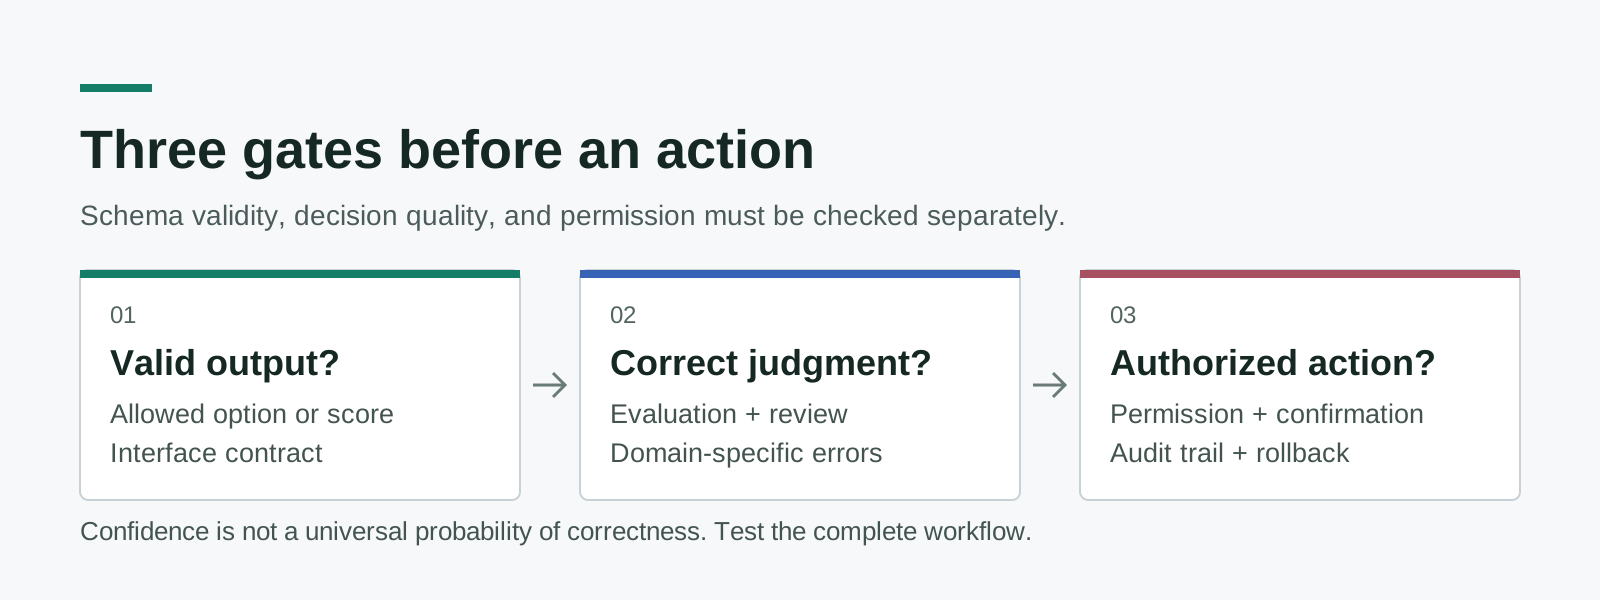
Schéma d’évaluation original. Réussir un contrôle ne garantit pas de réussir le suivant ; une sortie autorisée doit encore être bien interprétée et l’action doit être permise.
Pour les usages multilingues, testez chaque langue réellement prise en charge. La documentation du modèle indique que l’anglais est la langue principale d’entraînement et que la qualité varie selon les autres langues, notamment les écritures CJK. Une file d’assistance en coréen ou des archives de lettres d’information multilingues doivent donc constituer leur propre segment d’évaluation, et non être considérées comme une extension garantie d’un score anglais. La traduction peut également modifier les éléments de preuve : conservez l’original si vous évaluez une représentation traduite.
Concevez un essai qui puisse échouer honnêtement
Un pilote utile commence par une décision que votre équipe peut annoter de façon cohérente. Choisissez une tâche réversible, par exemple suggérer une file d’assistance, signaler un doublon potentiel ou étiqueter un document à vérifier plus tard. Ne définissez pas la réussite par l’impression de fluidité que donne la démonstration. Définissez les erreurs que vous remarquerez, celles qui pourraient vous échapper et le coût de chacune pour l’utilisateur.
- Rédigez le contrat de décision. Énumérez les résultats possibles, les champs sources nécessaires et l’option de révision. Séparez l’interprétation sémantique des calculs et des autorisations.
- Constituez un jeu d’évaluation. Utilisez des éléments que vous êtes autorisé à traiter. Incluez des cas habituels, des limites ambiguës, des langues mélangées, des champs vides et des instructions malveillantes présentes dans le texte source.
- Gardez un échantillon de validation à part. Ajustez les critères sur un jeu, puis mesurez-les sur des données qui n’ont pas influencé leur formulation. Consignez les désaccords au lieu de redéfinir discrètement la réponse attendue.
- Mesurez le processus complet. Suivez les erreurs par catégorie, le taux de révision, la latence de bout en bout, les nouvelles tentatives et le coût total. Un appel rapide au modèle intégré à une boucle de récupération lente reste un produit lent.
- Lancez en mode suggestion. Consignez l’option choisie, les probabilités pertinentes, la version du modèle et la correction humaine, sans exécuter automatiquement d’actions lourdes de conséquences.
- Promouvez une seule action encadrée. Exigez une autorisation explicite lorsque c’est nécessaire, conservez une piste d’audit et prévoyez un retour arrière si la source ou la version du modèle change.
Cette procédure est volontairement plus stricte que le simple visionnage d’un enregistrement. Elle vérifie si le modèle aide sur la distribution réelle de vos cas, y compris les plus délicats. Un taux de révision apparemment élevé peut être préférable à quelques erreurs silencieuses et coûteuses. Décidez de cet arbitrage avant de fixer un seuil, pas après un incident.
Épinglez une version pour rendre l’évaluation reproductible et consignez la version renvoyée avec chaque résultat. Les alias qui évoluent facilitent l’exploration, mais peuvent modifier le comportement sans changement du code de votre application. Un artefact d’évaluation doit permettre à une autre personne de reconstituer les critères, les entrées, les résultats attendus et les limites d’exécution. C’est ainsi qu’une expérience prometteuse devient une fonctionnalité maintenable, au lieu d’une collection de séquences impressionnantes.
En résumé : encadrez le jugement dans un contrat délimité
Jev est surtout intéressant lorsqu’il prend une décision restreinte et inspectable au sein d’un programme qui connaît déjà ses règles. La vidéo du navigateur montre une composition fonctionnelle, la publication sur les e-mails fournit une expérience concrète à tester, et les démonstrations officielles révèlent la boucle. La question suivante n’est pas de savoir si le modèle peut choisir une réponse, mais si votre système saura reconnaître un mauvais choix avant qu’il n’ait des conséquences.
Sources et crédits des médias
- TypeSafe : présentation des modèles System One et de Jev, 15 septembre 2026 ; lancement officiel et contexte des vidéos de jeux.
- Browser Use : jev-ultrafast, source épinglée consultée le 30 septembre 2026. GIF et MP4 : copyright 2026 Browser Use, licence MIT ; aucune affiliation n’est suggérée.
- Browser Use : enregistrement et mesures d’exécutions comparables, consultés le 30 septembre 2026 ; mesures de l’auteur, non reproduites par nos soins.
- vogel sur X : expérience de classification de 1,500 e-mails, 16 septembre 2026 ; cas d’usage autodéclaré avec vidéo originale.
- Primitives TypeSafe, modèles, confiance, fan-out et démo domotique, consultés le 30 septembre 2026.
- Irrégularités de Jev 1.13, dernière revue le 17 septembre 2026 ; consultées le 30 septembre.
- Article de cas d’usage de Jev sur Tistory, 18 septembre 2026 ; point de départ de la recherche, et non vérification d’un déploiement.
Gardez les preuves avec vos notes
Lorsque vous étudiez un nouveau modèle, conservez la source, sa date et ce que la démonstration prouve réellement. Créez un compte Telli.sh pour organiser vos recherches et vos notes dérivées sans confondre un résumé avec les preuves originales.