Jev elige en vez de conversar: tres demostraciones y sus límites
Qué hace realmente Jev de TypeSafe, con un GIF de Browser Use y una demostración reproducible, un caso de 1.500 correos en X y demostraciones oficiales de juegos. Descubre dónde ayudan las decisiones tipadas, dónde fallan y cómo evaluar un flujo de trabajo real.
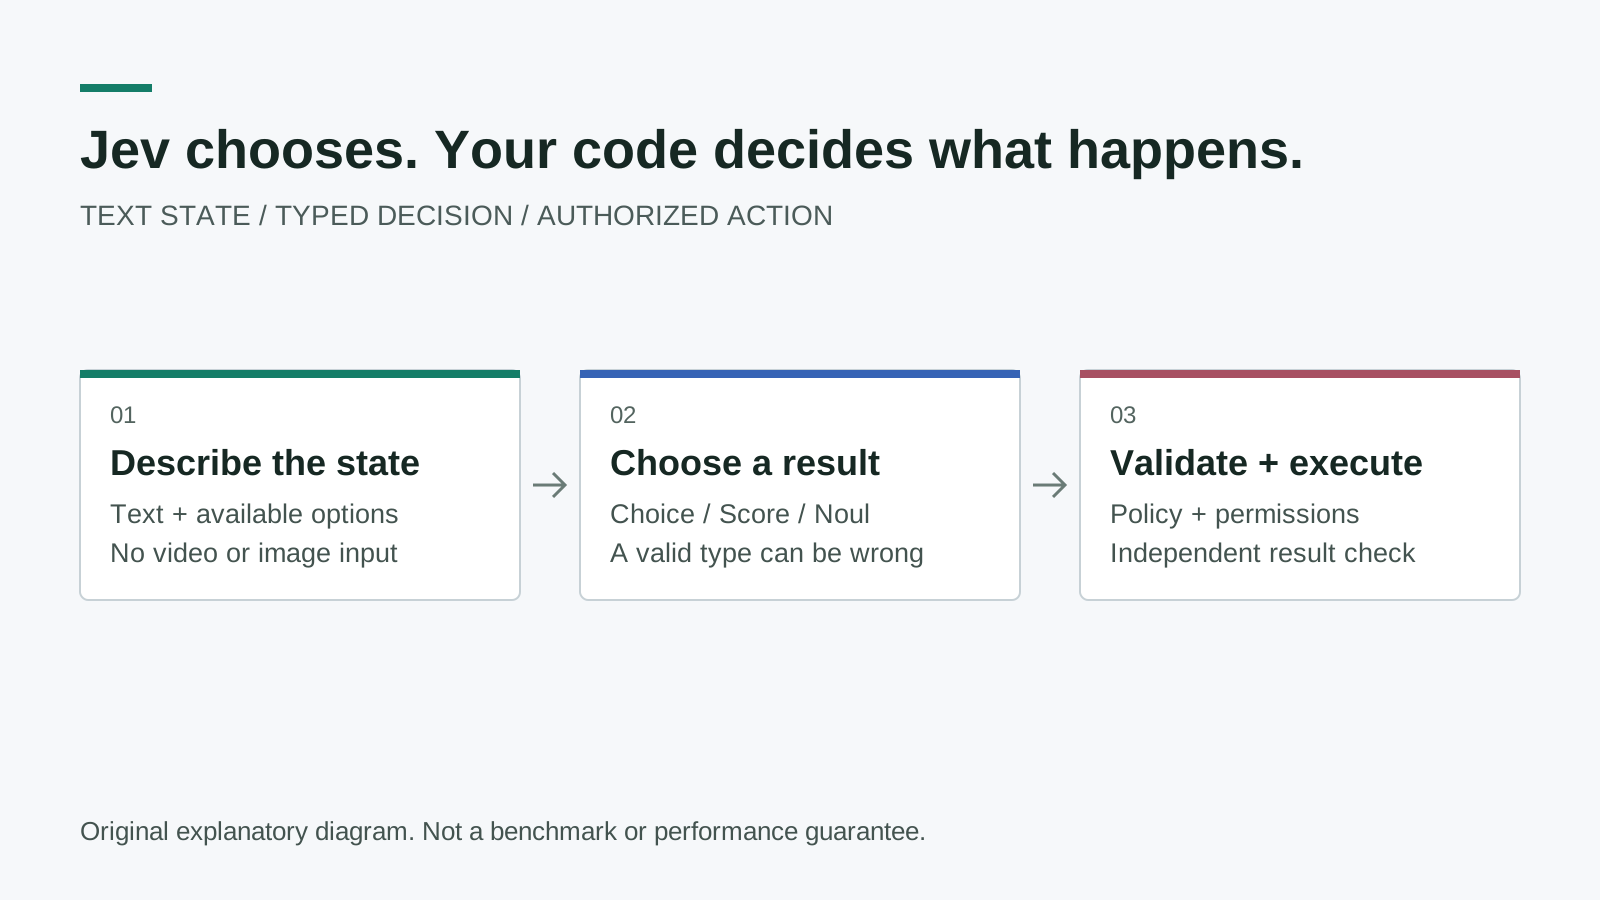
Diagrama explicativo original, no una prueba de rendimiento del proveedor. El modelo elige dentro de un espacio definido; el código de la aplicación sigue siendo responsable de los permisos, la validación y la ejecución.
Un clasificador de bandeja de entrada no necesita escribir un ensayo antes de elegir una carpeta. Un controlador del navegador a menudo tiene que elegir un botón disponible, no inventar un comando. En esas pequeñas decisiones es donde Jev, el primer modelo System One de TypeSafe AI, presenta su argumento más interesante.
TypeSafe presentó Jev el 15 de septiembre de 2026. La distinción útil no es simplemente que sea otro modelo rápido: devuelve decisiones restringidas en vez de prosa abierta. Eso cambia cómo puedes construir el programa que lo rodea, pero no elimina la posibilidad de elegir una respuesta incorrecta. Consulta el lanzamiento oficial para conocer la perspectiva del proveedor.
Esta guía recorre tres demostraciones públicas: una tarea de navegador con pruebas en GIF descargable y vídeo, el informe de un autor que clasificó 1.500 correos y las demostraciones de juegos de TypeSafe. También convertimos esos ejemplos en un plan de evaluación concreto. El artículo sobre casos de uso en Tistory, publicado el 18 de septiembre, fue el punto de partida de la investigación; sus aplicaciones propuestas no se presentan aquí como despliegues de clientes verificados de forma independiente.
En resumen:
- Jev puede elegir, puntuar o evaluar una proposición a partir de texto; no reemplaza a un modelo que redacta texto arbitrario.
- Un resultado tipado válido todavía puede ser semánticamente incorrecto. Mantén la validación y la autorización final en el código.
- La grabación del navegador es real, pero una sola tarea no es una prueba de rendimiento general. El ejemplo de los correos es el informe de un autor, no un estudio de precisión publicado.
- Empieza con una clasificación reversible, mide los errores con tus propios datos y permite abstenerse como resultado válido.
Una respuesta breve puede exigir una pregunta muy clara
Las tres primitivas principales de la API son Choice, Score y Noul. Choice selecciona entre alternativas con nombre. Score evalúa niveles descritos y ordenados. Noul devuelve la probabilidad de una proposición de sí o no; un valor cercano al punto medio representa incertidumbre sobre esa proposición, no un nivel medio de gravedad. La documentación de las primitivas define estos contratos.
El cambio práctico consiste en definir los resultados posibles antes de pedirle al modelo que decida. En vez de solicitar un párrafo sobre un mensaje de soporte entrante, puedes preguntar si se refiere a facturación, acceso a la cuenta, un defecto del producto o una categoría sin resolver. Después, tu aplicación decide qué cola mostrar. El resultado es un desvío en la vía, no el tren entero: ayuda a dirigir el trabajo, pero no ofrece todas las capacidades necesarias para terminarlo.
| Primitiva | Pregunta útil | Responsabilidad de la aplicación |
|---|---|---|
| Choice | ¿Cuál de estas colas describe mejor este mensaje? | Define un conjunto completo de opciones, incluida una vía de revisión |
| Score | ¿Hasta qué punto coincide este mensaje con estos niveles de urgencia descritos? | Define los niveles y comprueba si los revisores coinciden |
| Noul | ¿Solicita explícitamente este mensaje una cancelación? | Decide qué probabilidad justifica una revisión o una acción reversible |
Redactar buenas alternativas forma parte del trabajo de ingeniería. Si dos etiquetas se solapan, una elección aparentemente segura puede ocultar un problema en tu taxonomía. Si ninguna etiqueta encaja, forzar una selección disfraza la falta de cobertura de certeza. Una opción de revisión suele ser más valiosa que otra categoría con un nombre más específico, porque deja ver dónde hay que mejorar el contrato de decisión.
Según la comprobación del 30 de septiembre de 2026, la referencia del modelo enumera jev-1.13.0, entrada solo de texto y un precio de 0,042 $ por millón de tokens de entrada, con los tokens de salida gratis. Ese es el precio de los tokens del modelo, no el coste total de ejecutar un agente. También hay que incluir en el presupuesto operativo los navegadores, la extracción, los modelos auxiliares, los reintentos y la revisión humana.
El GIF del navegador muestra una búsqueda real, no una reserva de vuelo
El repositorio público jev-ultrafast de Browser Use incluye la grabación de una tarea de Google Flights desde Zúrich hasta Londres. Jev elige una operación y un objetivo a partir de la representación actual de la página. Un asistente generativo independiente proporciona texto cuando la operación seleccionada requiere escribir. Es un sistema compuesto, no una prueba de que Jev genere por sí solo cada cadena de texto o interprete fotogramas de vídeo.
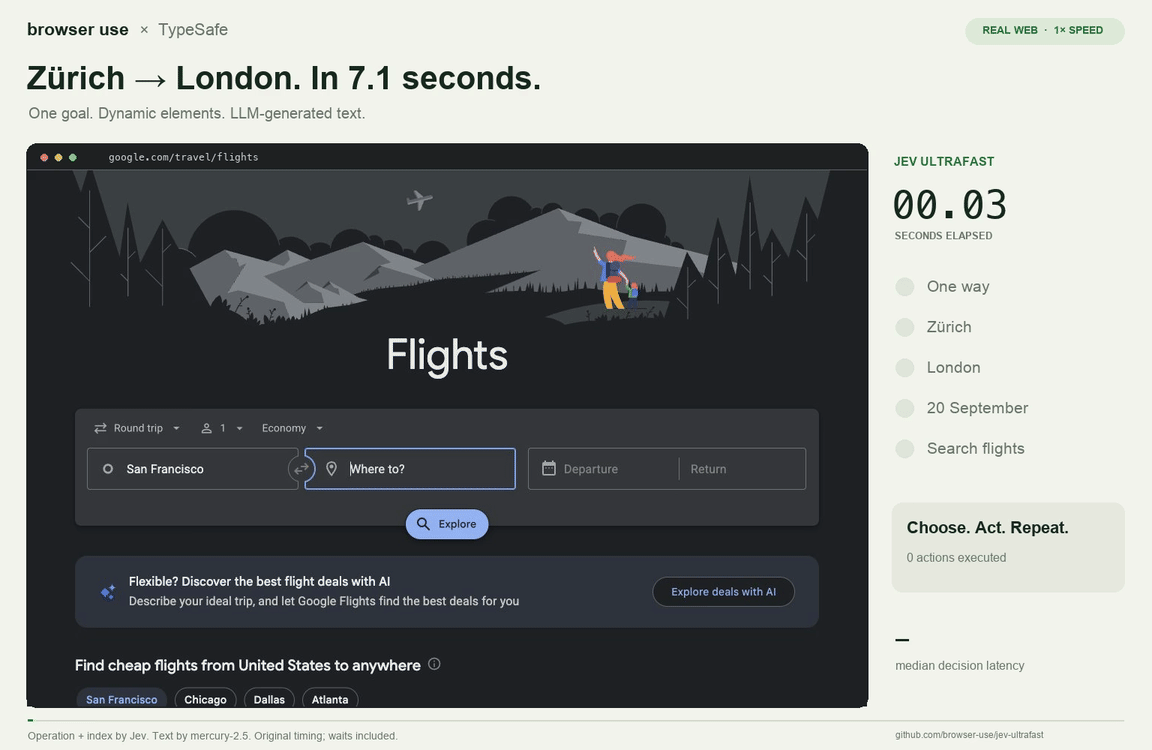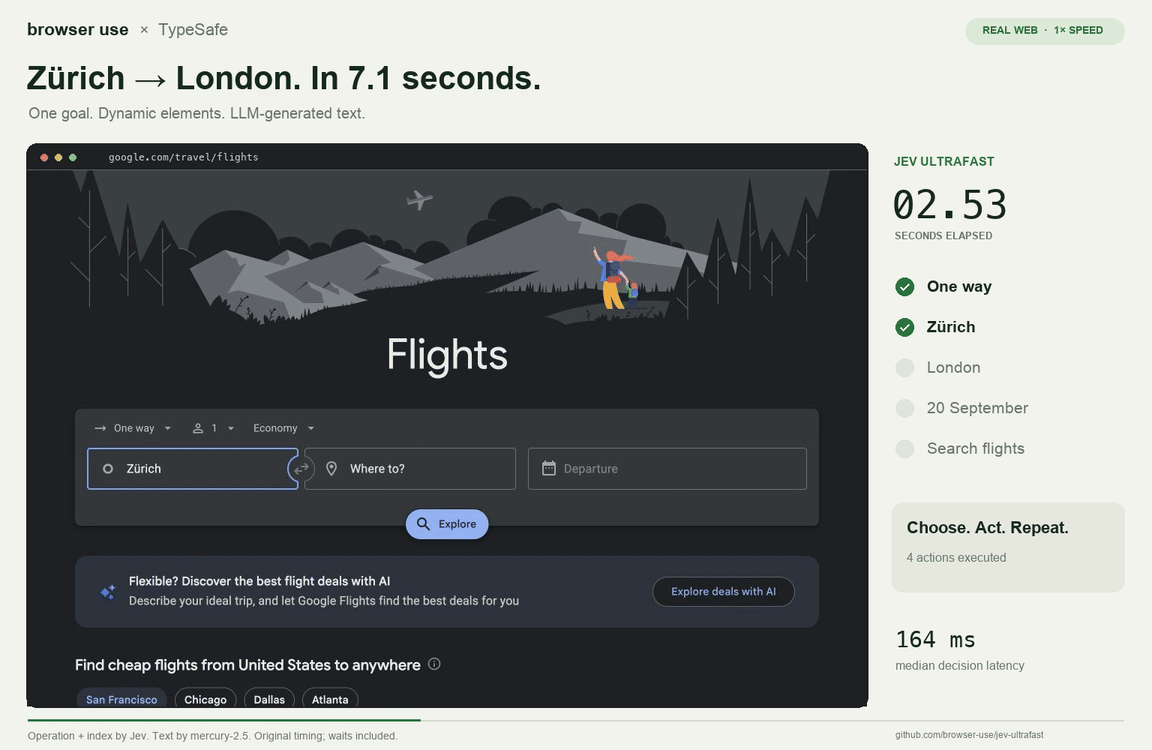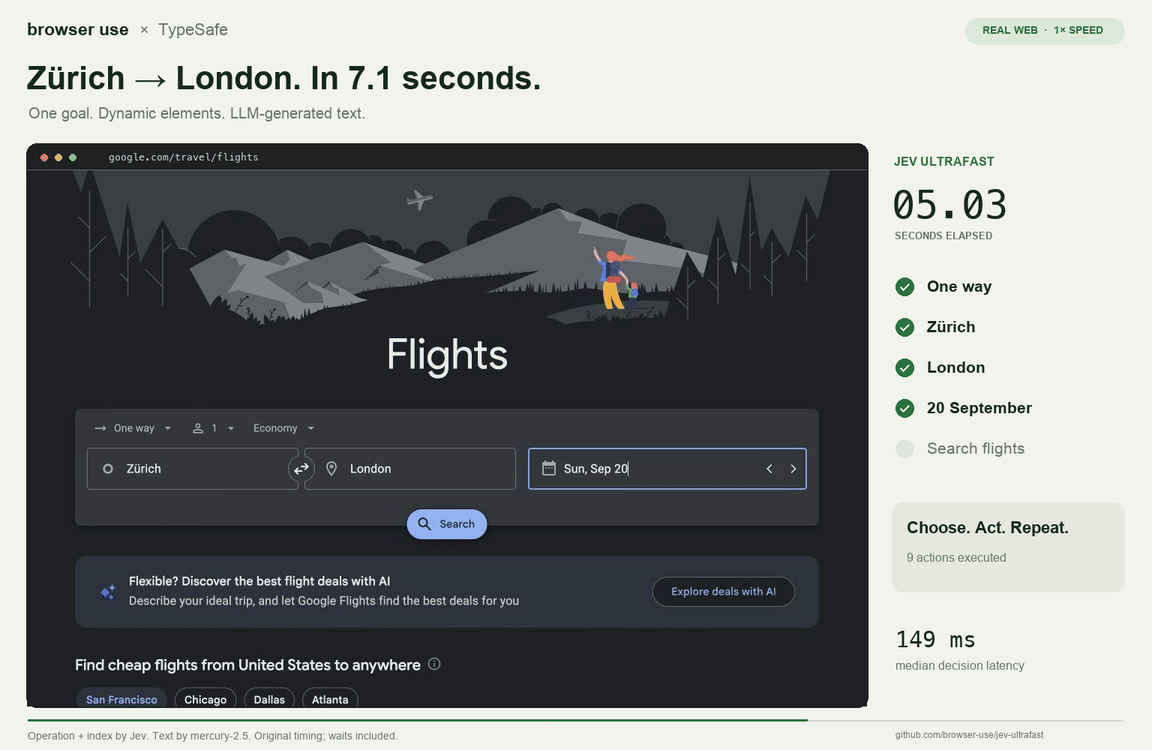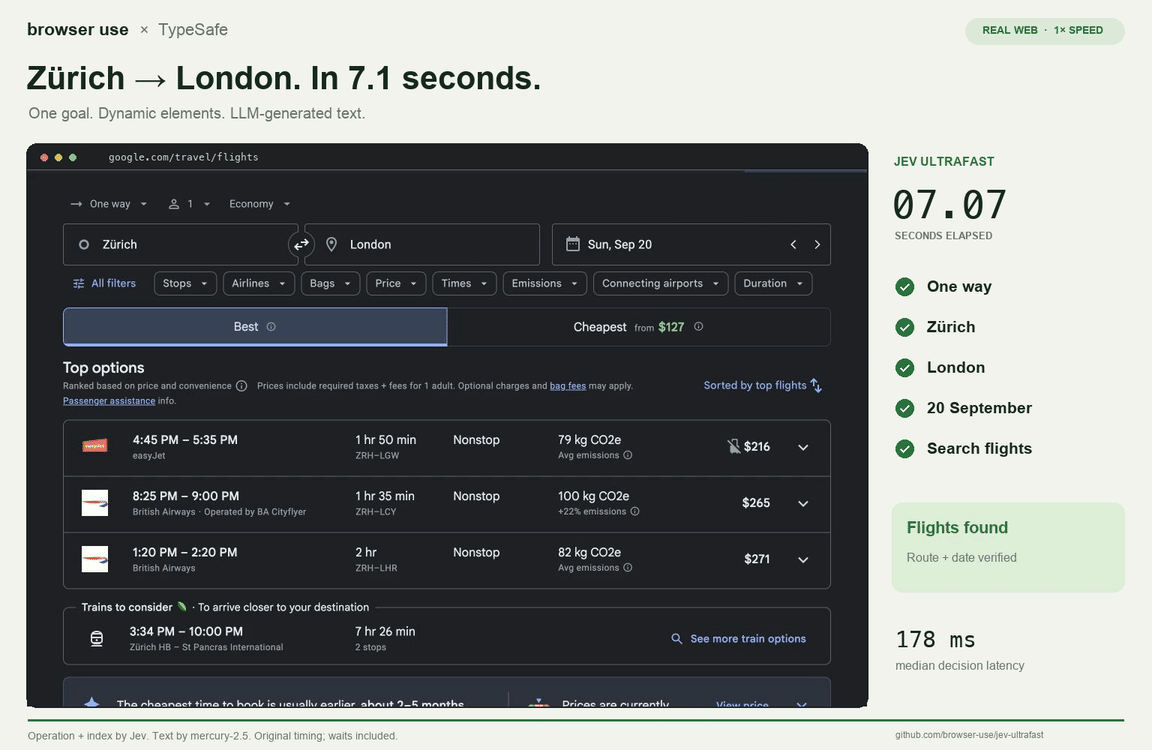
GIF real grabado por el autor de Browser Use, fijado al commit 1231850a0bf1a0c0341fe408ef1668dbbfdfac46. Copyright 2026 Browser Use, licencia MIT. Muestra un flujo de búsqueda, no una compra. La misma grabación puede reproducirse abajo.
Vídeo MP4 del autor, a la velocidad grabada y con los controles del navegador. Grabación original y notas de medición; licencia MIT conservada. Inspeccionamos los artefactos públicos; no repetimos esta prueba de rendimiento.
El tiempo de finalización medido por el autor para la grabación es de 7,073 segundos. El cronómetro empieza con la primera predicción posterior a la observación inicial de la página principal, no cuando se inicia un navegador nuevo. La configuración, la navegación inicial y la verificación independiente posterior con una sesión nueva quedan fuera de ese intervalo cronometrado. Se comprueban los resultados de búsqueda; no se selecciona ni se compra ningún billete. Esos límites son esenciales para entender qué significa la cifra.
El mismo informe compara seis ejecuciones alternadas, tres por cada entorno de ejecución. El tiempo mediano de la tarea pasa de 9,450 segundos a 7,092 segundos, mientras que la mediana de llamadas al protocolo del navegador baja de 1.092 a 101. Ambos grupos utilizan Jev y el mismo asistente de texto, así que esto es principalmente una comparación de entornos de ejecución, no una competición entre dos familias de modelos. El autor señala expresamente el tamaño reducido de la muestra y la variabilidad de la web en directo en el informe de rendimiento.
Nuestra lectura es que el ciclo del navegador que rodea al modelo merece tanta atención como el propio modelo. Recopilar la página repetidamente, resolver los objetivos e invalidar decisiones puede costar más de lo que sugiere la aparente sencillez de un clic. Un motor de decisión más rápido no compensa una descripción poco fiable del botón que debe elegir. El repositorio conserva una verificación independiente del resultado porque que el modelo diga que ha terminado no demuestra que la tarea se haya completado.
Aquí también resultan útiles los límites de la demostración. La implementación documentada no cubre todos los fotogramas, elementos canvas, flujos de carga ni controles de teclado arbitrarios. Un equipo que la evalúe debería reproducir sus propias tareas y vías de fallo representativas, no deducir que una búsqueda de vuelos correcta demuestra competencia general con navegadores. Considera la grabación una prueba inspeccionable de una composición funcional.
El artículo sobre 1.500 correos es un caso prometedor al que le faltan denominadores
El 16 de septiembre de 2026, vogel (@ryanvogel) publicó en X que había probado Jev con 1.500 de sus propios correos y que le habían impresionado los resultados de clasificación. La publicación original incluye un vídeo. Es un ejemplo útil de uso real porque el volumen de trabajo es concreto y la fuente es quien informa del experimento, no una lista de aplicaciones hipotéticas sin atribución.
Sin embargo, no es un informe de precisión. La publicación no establece un conjunto de prueba público etiquetado, una tasa de error medida, el grado de acuerdo entre revisores ni el coste de los errores. El número de mensajes procesados nos indica la escala del experimento, no su corrección. Mira la demostración original en X teniendo presente esa distinción; enlazamos el vídeo en lugar de copiarlo sin una licencia de redistribución.
Aun así, la clasificación de correos es un punto de partida razonable para una evaluación porque puede hacerse reversible. Muestra etiquetas sugeridas junto a la bandeja de entrada existente, deja intacto el mensaje original y registra las correcciones. Compara pares confusos, como una factura frente a un recordatorio de pago, o una solicitud de cancelación frente a una queja que solo menciona la cancelación. Esos casos revelan si las categorías corresponden a tu flujo de trabajo real.
Una implementación inicial no debería eliminar mensajes, enviar respuestas ni aprobar transacciones automáticamente solo porque la clasificación parezca segura. Esas acciones implican permisos y consecuencias distintas. Empieza con una sugerencia o una cola de revisión; promueve una acción acotada solo después de medir su patrón de errores. Este es nuestro procedimiento de evaluación propuesto, no una afirmación sobre la implementación del autor de X.
Doom y Wikiracing hacen visible el ciclo de decisión
El lanzamiento de TypeSafe incluye una demostración de Doom y una demostración de Wikiracing, ambas enlazadas desde el artículo oficial de lanzamiento. Son explicaciones visuales útiles de decisiones repetidas. No demuestran que Jev sea un modelo visual de propósito general ni que pueda resolver problemas arbitrarios de planificación.
En el ejemplo de Doom, el modelo recibe una descripción textual estructurada del estado, no capturas de pantalla. En Wikiracing, elige entre los enlaces disponibles en lugar de inventar una URL de destino. El mecanismo interesante es el ciclo repetido de observación, elección acotada y acción. Las demostraciones de juegos hacen que ese ciclo resulte fácil de ver, pero no resuelven la cuestión de cuánto se transfiere a otro entorno.
La misma separación aparece en la documentación de la demostración de casa inteligente de TypeSafe. Distintas preguntas pueden clasificar aspectos de una solicitud, mientras que otro componente se ocupa de la conversación libre o de dividir una solicitud compuesta. No deberías describir esa arquitectura como un solo modelo que genera lenguaje y ejecuta todas las decisiones. Nombres como asistente o agente suelen ocultar esos límites si la implementación no los hace explícitos.
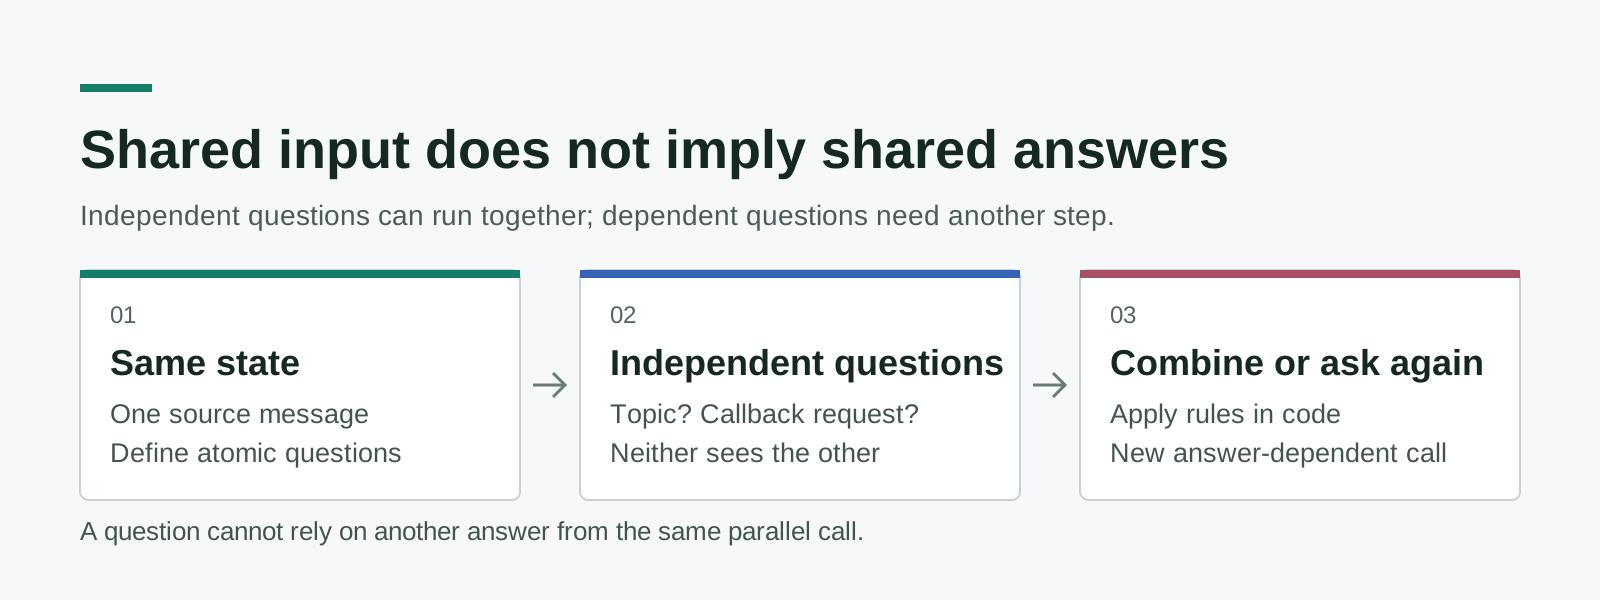
Diagrama original basado en el contrato documentado de fan-out. Las preguntas simultáneas comparten el estado; no leen a escondidas las respuestas de las demás.
El patrón fan-out puede reducir la espera secuencial cuando varias preguntas dependen de la misma fuente. Por ejemplo, se puede evaluar de forma independiente el tema de un mensaje y si solicita expresamente una llamada. Una pregunta que depende de un tema recién elegido no puede dar por sentado que esa respuesta ya existe dentro de la misma llamada. Divide esa dependencia y resuélvela en un paso posterior, o combina los resultados independientes de forma determinista en el código.
Una respuesta tipada no equivale a una respuesta correcta
La interpretación más peligrosa de un modelo restringido es pensar que una respuesta bien formada no puede ser errónea. Sí puede serlo. Un clasificador puede elegir una etiqueta permitida pero inadecuada, y un selector de acciones puede elegir un botón válido del formulario equivocado. Eliminar de una interfaz la prosa mal formada es valioso, pero resuelve una clase de fallos distinta de la comprensión equivocada de la tarea.
Las notas sobre irregularidades de Jev 1.13 de TypeSafe, cuya última revisión fue el 17 de septiembre, describen debilidades en aritmética, recuentos, comparación de fechas, contexto distractor y entradas adversarias. Para las comparaciones exactas, analiza las fechas y calcula las cantidades con código convencional. No conviertas una regla determinista en un juicio semántico solo porque el modelo pueda aceptar la pregunta.
También importa la documentación de confianza: Choice y Score exponen distribuciones de probabilidad y un valor de confianza derivado; Noul no tiene un campo de confianza separado. Ese número no es una probabilidad universal de que la respuesta sea correcta. Los umbrales deben validarse con tu propia tarea, sobre todo cuando las consecuencias de un falso positivo difieren de las de un falso negativo.
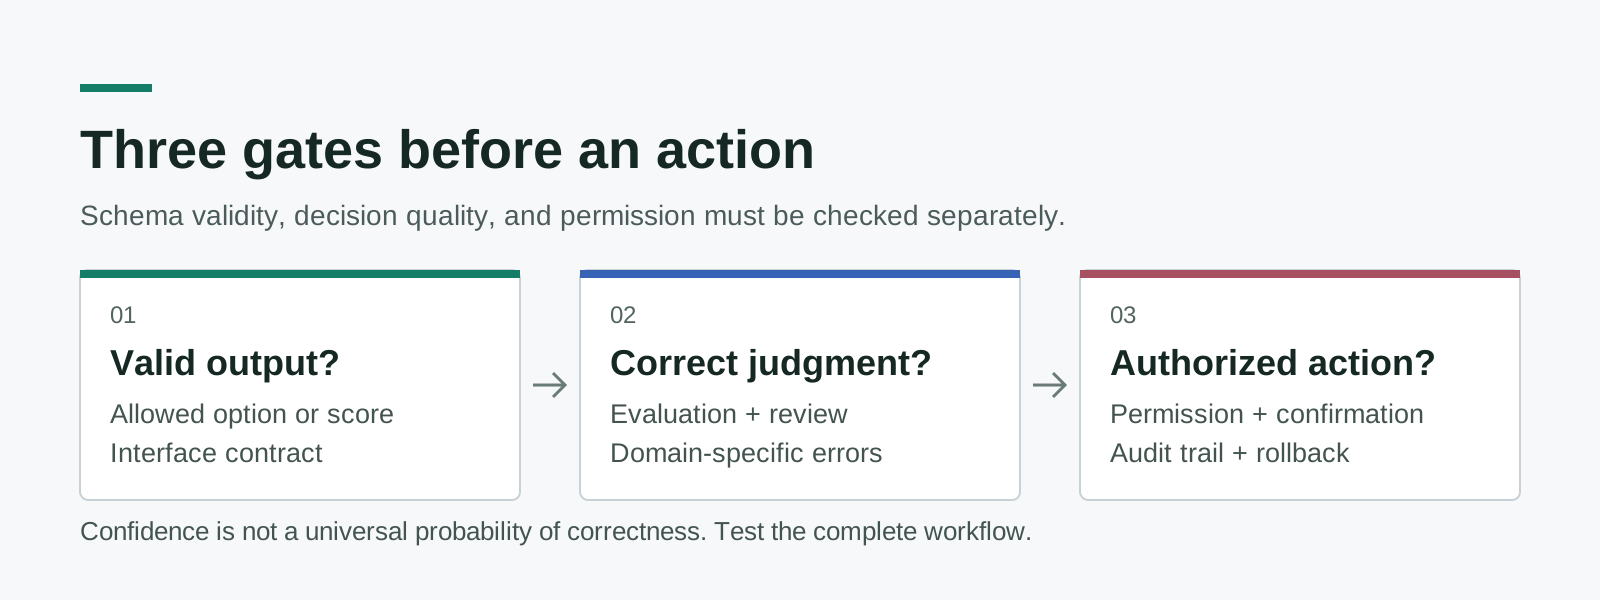
Diagrama de evaluación original. Superar un filtro no implica superar el siguiente; incluso una salida permitida exige una interpretación correcta y una acción autorizada.
En el trabajo multilingüe, prueba cada idioma al que realmente das servicio. La documentación del modelo indica que el inglés es el idioma principal de entrenamiento y que la calidad no es uniforme en otros idiomas, incluidos los que usan escrituras CJK. Por tanto, una cola de soporte en coreano o un archivo de boletines con idiomas mezclados debe constituir su propio segmento de evaluación, no una extensión que se da por supuesta a partir de una puntuación en inglés. La traducción también puede alterar la evidencia, así que conserva el original si evalúas una representación traducida.
Diseña una prueba piloto que pueda fallar con honestidad
Una prueba piloto útil empieza con una decisión que tu equipo pueda etiquetar de forma coherente. Elige una tarea reversible, como sugerir una cola de soporte, señalar un posible duplicado o etiquetar un documento para revisarlo después. No definas el éxito como que la demostración parezca fluida. Define qué resultados incorrectos notarías, cuáles podrían pasar inadvertidos y cuánto le cuesta cada uno al usuario.
- Escribe el contrato de decisión. Enumera los resultados posibles, los campos de origen necesarios y la opción de revisión. Separa la interpretación semántica de los cálculos y los permisos.
- Crea un conjunto de evaluación. Usa material que tengas autorización para procesar. Incluye casos habituales, límites ambiguos, idiomas mezclados, campos vacíos e instrucciones maliciosas dentro del texto de origen.
- Reserva un subconjunto de prueba. Ajusta los criterios en un conjunto y luego mide con material que no haya influido en su redacción. Registra los desacuerdos en vez de redefinir silenciosamente la respuesta esperada.
- Mide el flujo de trabajo. Registra los errores por categoría, la tasa de revisión, la latencia de extremo a extremo, los reintentos y el coste total. Una llamada rápida al modelo dentro de un ciclo lento de recuperación sigue dando un producto lento.
- Ejecuta en modo de sugerencias. Registra la opción elegida, las probabilidades pertinentes, la versión del modelo y la corrección humana, sin realizar automáticamente acciones con consecuencias.
- Promueve una acción acotada. Exige autorización explícita cuando corresponda, conserva un registro de auditoría y mantén una vía de reversión cuando cambie la fuente o la versión del modelo.
Este procedimiento es deliberadamente más estricto que ver una grabación. Pregunta si el modelo ayuda con la distribución de casos que tienes, incluidos los incómodos. Una tasa de revisión que parezca alta puede ser preferible a unos pocos errores silenciosos y costosos. Decide ese equilibrio antes de elegir un umbral, no después de descubrir un incidente.
Fija una versión para que la evaluación sea reproducible y registra la versión que devuelve cada resultado. Los alias que cambian con el tiempo son cómodos para explorar, pero pueden modificar el comportamiento sin que cambie el código fuente de tu aplicación. Un artefacto de evaluación debería permitir que otra persona reconstruya los criterios, las entradas, los resultados esperados y el límite de ejecución. Así se convierte un experimento prometedor en una función mantenible, en vez de dejarlo como una colección de clips impresionantes.
En resumen: incorpora el juicio a un contrato acotado
Jev resulta más interesante cuando toma una decisión pequeña e inspeccionable dentro de un programa que ya conoce sus reglas. El vídeo del navegador muestra una composición funcional, la publicación sobre los correos ofrece un experimento concreto que merece probarse y las demostraciones oficiales revelan el ciclo. La siguiente pregunta no es si el modelo puede elegir una respuesta, sino si tu sistema puede detectar una elección incorrecta antes de que importe.
Fuentes y créditos de los medios
- TypeSafe: Introducing System One Models and Jev, 15 de septiembre de 2026; lanzamiento oficial y contexto de los vídeos de juegos.
- Browser Use: jev-ultrafast, fuente fijada e inspeccionada el 30 de septiembre de 2026. GIF y MP4, copyright 2026 Browser Use, licencia MIT; no se implica afiliación.
- Browser Use: grabación y mediciones de ejecuciones emparejadas, inspeccionado el 30 de septiembre de 2026; mediciones del autor, no una reproducción nuestra.
- vogel en X: experimento de clasificación de 1.500 correos, 16 de septiembre de 2026; caso de uso autodeclarado con vídeo original.
- Primitivas de TypeSafe, modelos, confianza, fan-out y demostración de casa inteligente, comprobados el 30 de septiembre de 2026.
- Irregularidades de Jev 1.13, última revisión el 17 de septiembre de 2026; comprobado el 30 de septiembre.
- Artículo de casos de uso de Jev en Tistory, 18 de septiembre de 2026; punto de partida de la investigación, no verificación de un despliegue.
Conserva las pruebas junto a tus notas
Cuando investigues un modelo nuevo, conserva la fuente, su fecha y lo que demuestra realmente la demostración. Crea una cuenta de Telli.sh para organizar tu propio material de investigación y las notas derivadas sin confundir un resumen con la evidencia original.