Jev entscheidet, statt zu plaudern: drei Demos und ihre Grenzen
Was TypeSafes Jev tatsächlich leistet: eine Browser-Use-GIF und eine abspielbare Demo, ein X-Beispiel mit 1.500 E-Mails und offizielle Spieledemos. Erfahren Sie, wo typisierte Entscheidungen helfen, wo sie scheitern und wie Sie einen echten Arbeitsablauf bewerten.
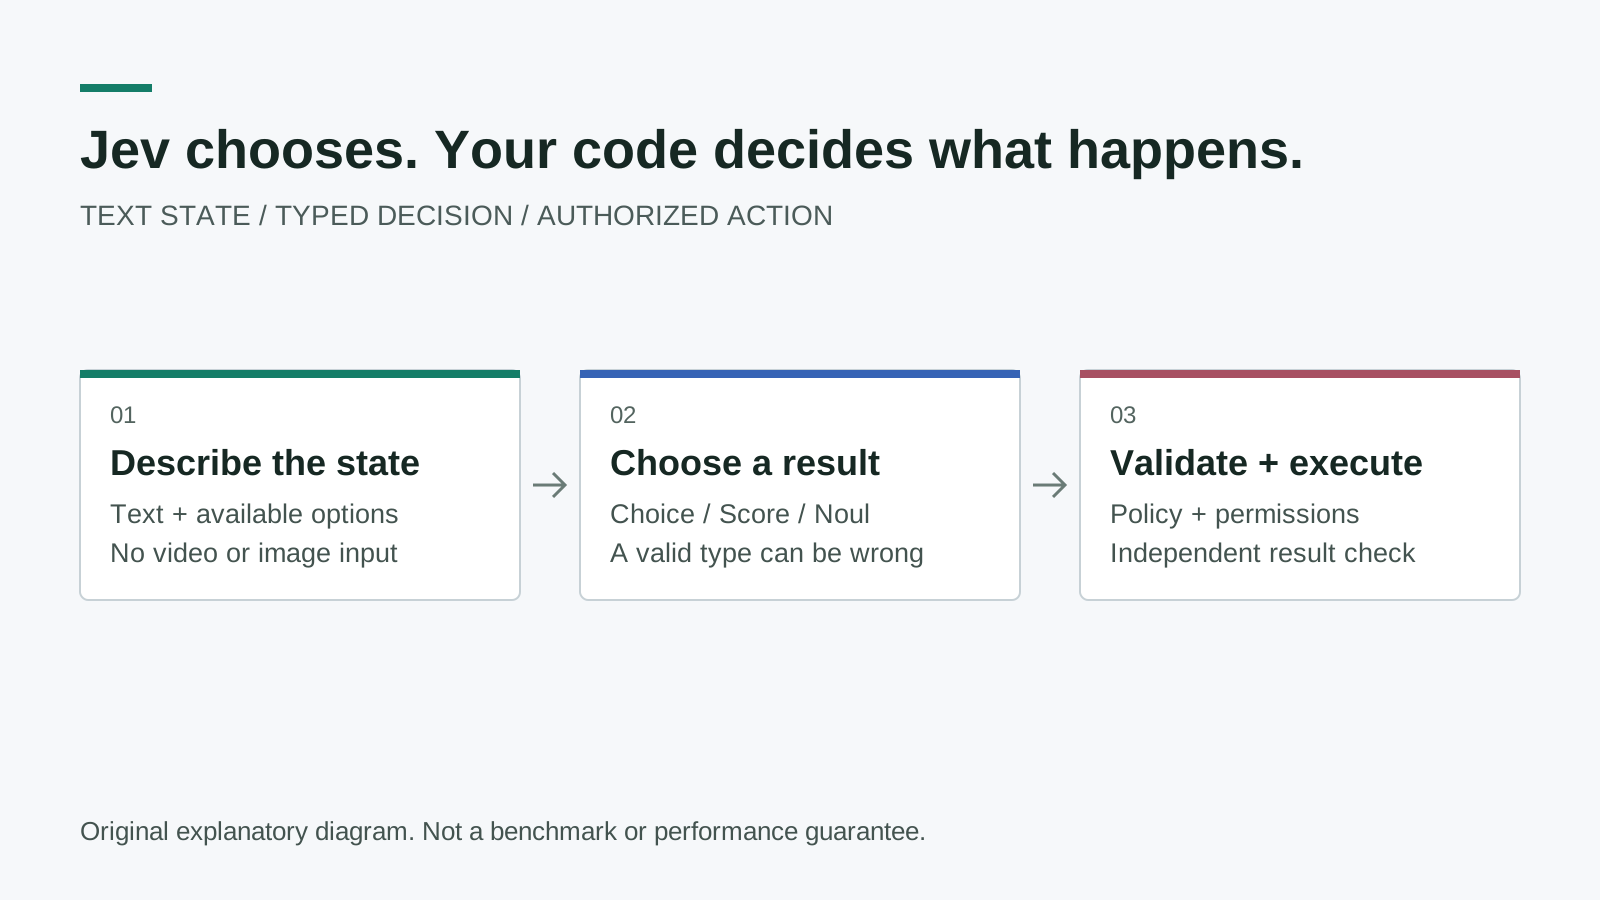
Originales Erklärdiagramm, kein Herstellerbenchmark. Das Modell entscheidet innerhalb eines festgelegten Rahmens; Berechtigungen, Validierung und Ausführung bleiben Aufgabe des Anwendungscodes.
Ein Posteingangsklassifikator muss keinen Aufsatz schreiben, bevor er einen Ordner auswählt. Eine Browsersteuerung muss oft eine verfügbare Schaltfläche wählen, statt einen neuen Befehl zu erfinden. Bei solchen kleinen Entscheidungen zeigt Jev, das erste System-One-Modell von TypeSafe AI, seine interessanteste Stärke.
TypeSafe stellte Jev am 15. September 2026 vor. Der entscheidende Unterschied ist nicht bloß, dass es ein weiteres schnelles Modell ist: Es gibt eingeschränkte Entscheidungen statt frei formulierter Texte zurück. Das verändert, wie Sie das umgebende Programm bauen können, beseitigt aber nicht die Möglichkeit einer falschen Entscheidung. Die Sichtweise des Anbieters finden Sie in der offiziellen Vorstellung.
Dieser Leitfaden folgt drei öffentlich gezeigten Beispielen: einer Browseraufgabe mit herunterladbaren GIF- und Videobelegen, dem Bericht eines Autors über die Klassifikation von 1.500 E-Mails und den Spieledemos von TypeSafe. Außerdem leiten wir daraus einen konkreten Evaluierungsplan ab. Der Tistory-Artikel zum Anwendungsfall, veröffentlicht am 18. September, war der Ausgangspunkt der Recherche; seine vorgeschlagenen Anwendungen behandeln wir nicht als unabhängig verifizierte Kundeneinsätze.
Kurz zusammengefasst:
- Jev kann ausgehend von Text eine Option auswählen, eine Bewertung abgeben oder eine Aussage einschätzen. Es ersetzt kein Modell, das beliebige Texte verfasst.
- Auch ein gültiges, typisiertes Ergebnis kann inhaltlich falsch sein. Validierung und endgültige Freigabe müssen im Code bleiben.
- Die Browseraufzeichnung ist echt, aber eine einzelne Aufgabe ist kein allgemeiner Benchmark. Das E-Mail-Beispiel ist ein Autorenbericht, keine veröffentlichte Genauigkeitsstudie.
- Beginnen Sie mit einer umkehrbaren Klassifikation, messen Sie Fehler anhand Ihrer eigenen Daten und ermöglichen Sie ausdrücklich eine Enthaltung.
Eine kleine Antwort braucht eine sehr klare Frage
Die drei zentralen Primitiven der API sind Choice, Score und Noul. Choice wählt unter benannten Alternativen. Score bewertet geordnete, beschriebene Stufen. Noul liefert eine Wahrscheinlichkeit für eine Ja-oder-Nein-Aussage; ein Wert nahe der Mitte steht für Unsicherheit über diese Aussage, nicht für eine mittlere Schwere. Die Dokumentation der Primitiven definiert diese Verträge.
In der Praxis legen Sie zuerst die möglichen Ergebnisse fest und fragen dann das Modell nach seiner Entscheidung. Statt um einen Absatz zu einer eingehenden Supportnachricht zu bitten, können Sie fragen, ob es um Abrechnung, Kontozugriff, einen Produktfehler oder eine ungeklärte Kategorie geht. Ihre Anwendung entscheidet anschließend, welche Warteschlange angezeigt wird. Das Ergebnis ist eine Weiche auf dem Gleis, nicht der ganze Zug: Es hilft bei der Weiterleitung, bietet aber nicht alle Funktionen, die zur Erledigung nötig sind.
| Primitiv | Geeignete Frage | Verantwortung der Anwendung |
|---|---|---|
| Choice | Welche dieser Warteschlangen passt am besten zu dieser Nachricht? | Einen vollständigen Satz an Optionen einschließlich eines Prüfpfads definieren |
| Score | Wie stark entspricht diese Nachricht den beschriebenen Dringlichkeitsstufen? | Die Stufen definieren und prüfen, ob Beurteilende übereinstimmen |
| Noul | Bittet diese Nachricht ausdrücklich um eine Kündigung? | Festlegen, bei welcher Wahrscheinlichkeit eine Prüfung oder umkehrbare Aktion gerechtfertigt ist |
Gute Alternativen zu formulieren gehört zur Entwicklungsarbeit. Überlappen sich zwei Bezeichnungen, kann eine scheinbar sichere Auswahl ein Problem in Ihrer Taxonomie verschleiern. Passt keine Bezeichnung, verbirgt eine erzwungene Auswahl fehlende Abdeckung hinter scheinbarer Gewissheit. Eine Prüfoption ist oft wertvoller als eine weitere eng gefasste Kategorie, denn sie zeigt, wo der Entscheidungsvertrag verbessert werden muss.
Zum Stand vom 30. September 2026 führt die Modellreferenz jev-1.13.0, reine Texteingabe und einen Preis von $0.042 pro Million Eingabetoken auf; Ausgabetoken sind kostenlos. Das ist der Tokenpreis des Modells, nicht die Gesamtkosten für den Betrieb eines Agents. Browser, Extraktion, Hilfsmodelle, Wiederholungen und menschliche Prüfung gehören ebenfalls ins Betriebsbudget.
Das Browser-GIF zeigt eine echte Suche, keine Flugbuchung
Das öffentliche Repository Browser Use jev-ultrafast enthält eine aufgezeichnete Aufgabe in Google Flights von Zürich nach London. Jev wählt eine Aktion und ein Ziel aus der aktuellen Seitenrepräsentation aus. Ein separater generativer Helfer liefert Text, wenn die gewählte Aktion Texteingaben erfordert. Es handelt sich um ein zusammengesetztes System und nicht um einen Beleg dafür, dass Jev selbst jede Zeichenfolge erzeugt oder Videobilder interpretiert.
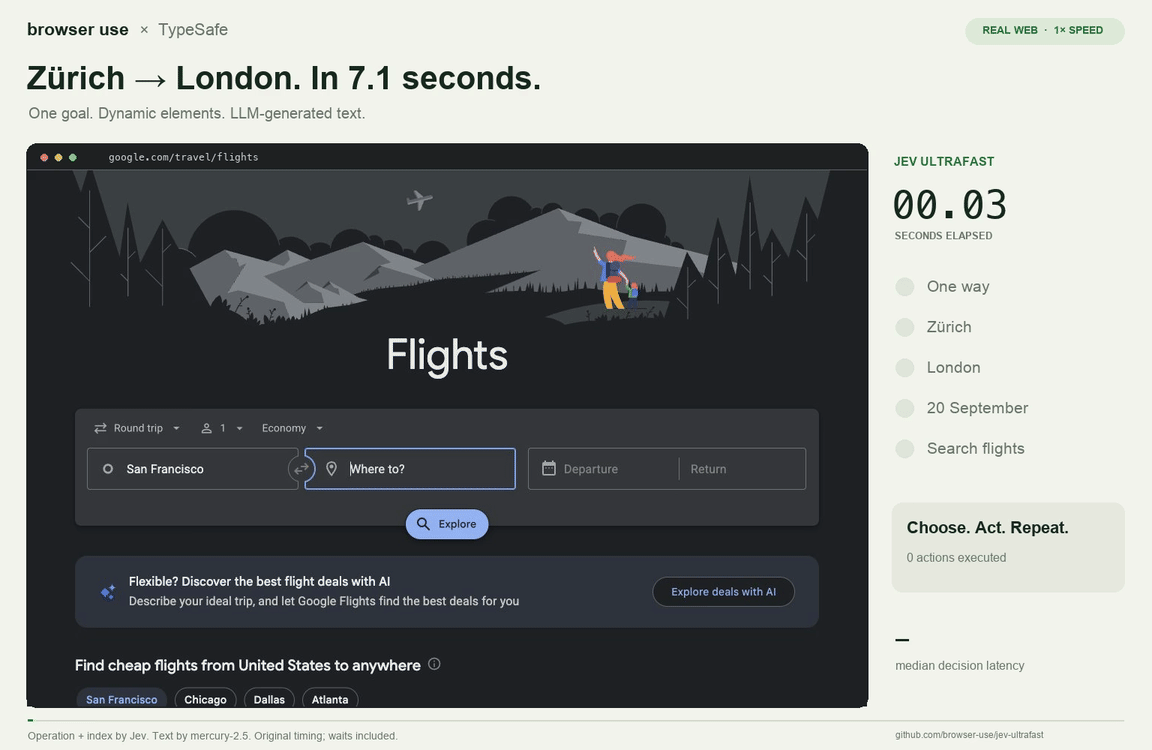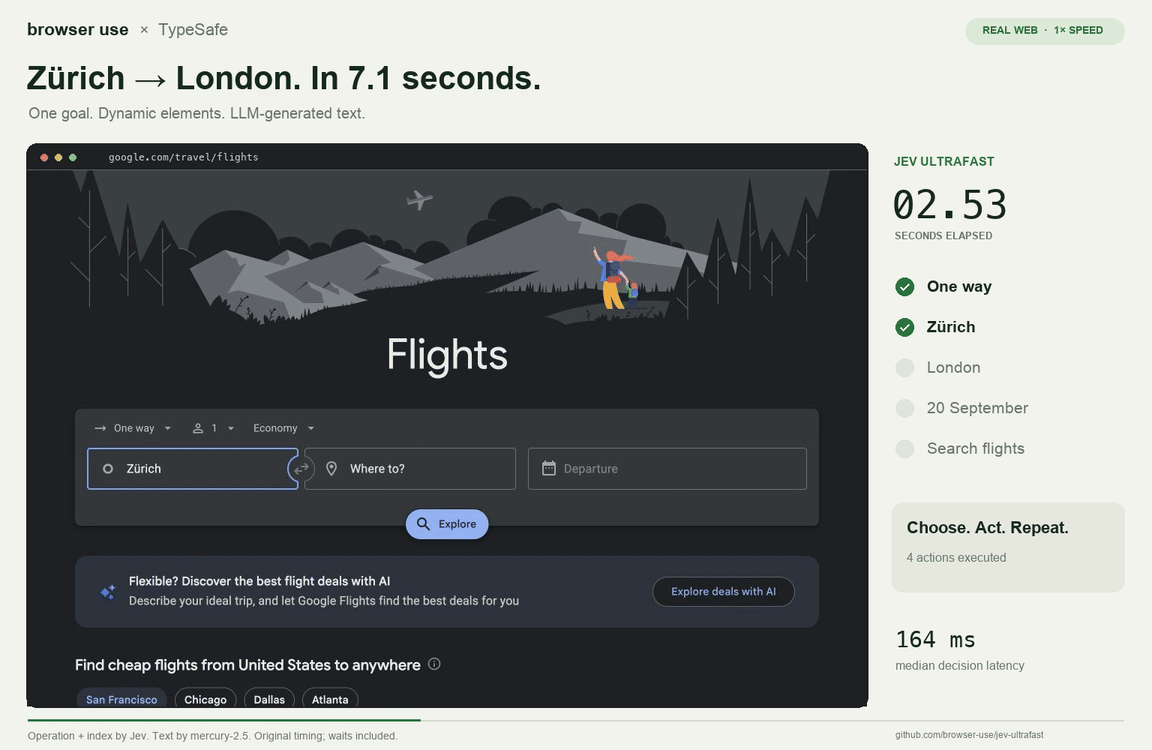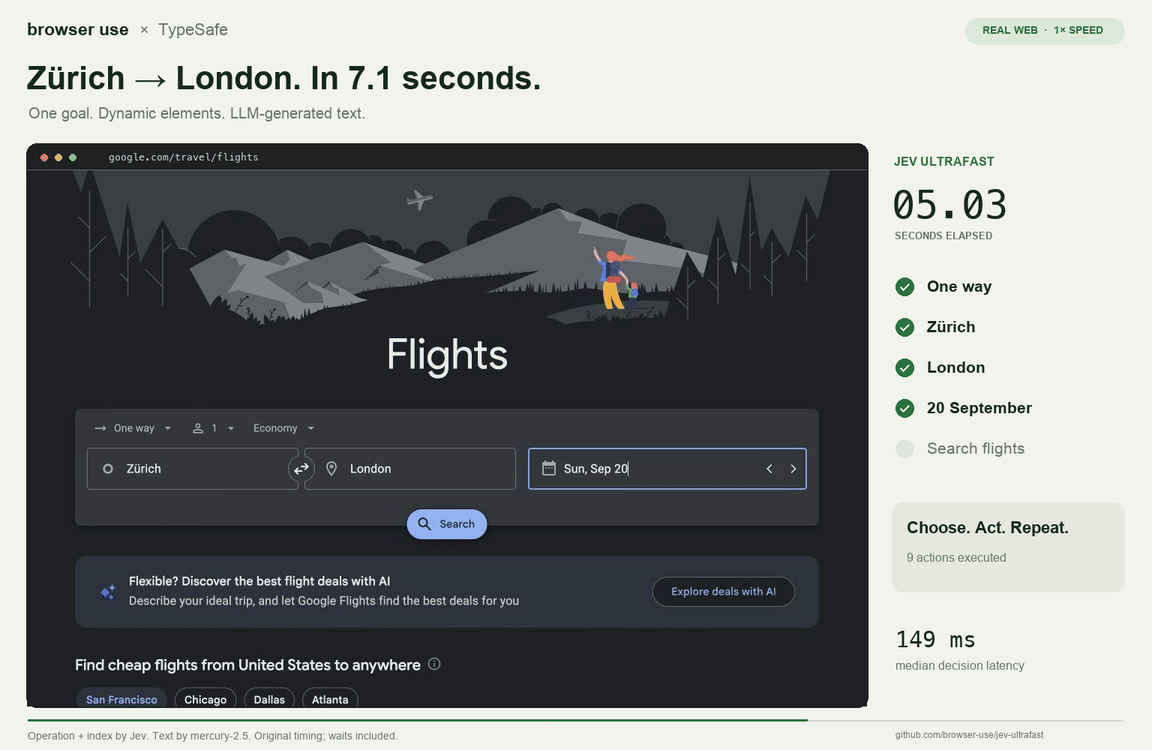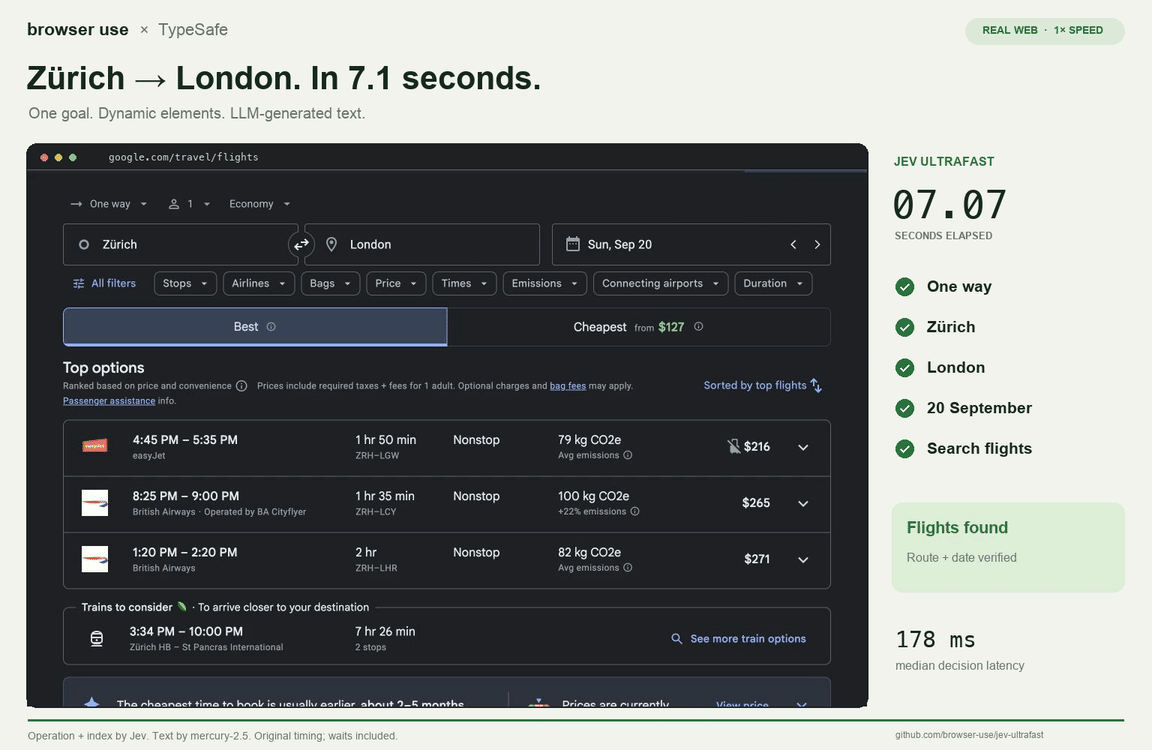
Tatsächliches, vom Autor aufgezeichnetes GIF von Browser Use, festgehalten auf Commit 1231850a0bf1a0c0341fe408ef1668dbbfdfac46. Copyright 2026 Browser Use, MIT-Lizenz. Es zeigt einen Suchablauf, keinen Kauf. Dieselbe Aufzeichnung kann weiter unten abgespielt werden.
MP4 des Autors, in der aufgezeichneten Geschwindigkeit und mit Browser-Steuerelementen. Originalaufzeichnung und Messhinweise; beibehaltene MIT-Lizenz. Wir haben die öffentlichen Artefakte geprüft, den Benchmark aber nicht erneut ausgeführt.
Die vom Autor gemessene Abschlusszeit der Aufzeichnung beträgt 7.073 Sekunden. Die Zeitmessung beginnt mit der ersten Vorhersage nach der anfänglichen Beobachtung der Startseite, nicht mit dem Start eines neuen Browsers. Einrichtung, erste Navigation und die unabhängige Überprüfung nach dem Durchlauf liegen außerhalb dieses Zeitintervalls. Die Suchergebnisse werden geprüft; es wird kein Ticket ausgewählt oder gekauft. Diese Grenzen sind entscheidend dafür, was die Zahl aussagt.
Im selben Bericht werden sechs abwechselnde Durchläufe verglichen, drei pro Laufzeitumgebung. Die mediane Aufgabendauer sinkt von 9.450 Sekunden auf 7.092 Sekunden, während die mediane Zahl der Browser-Protokollaufrufe von 1,092 auf 101 zurückgeht. Beide Varianten nutzen Jev und denselben Texthilfsdienst; es ist also in erster Linie ein Vergleich der Laufzeitumgebungen und kein Wettstreit zwischen zwei Modellfamilien. Im Leistungsbericht weist der Autor ausdrücklich auf die kleine Stichprobe und die Schwankungen im Live-Web hin.
Wir meinen, dass die umgebende Browserschleife mindestens so viel Aufmerksamkeit verdient wie das Modell. Wiederholtes Erfassen der Seite, Auffinden von Zielen und Verwerfen von Entscheidungen können mehr Zeit kosten, als ein scheinbar einfacher Klick vermuten lässt. Eine schnellere Entscheidungsengine gleicht keine unzuverlässige Beschreibung der Schaltfläche aus, die sie auswählen soll. Das Repository behält eine unabhängige Ergebnisprüfung bei, denn die Aussage des Modells, es sei fertig, beweist keinen erfolgreichen Abschluss.
Gerade hier sind die Grenzen der Demo nützlich. Die dokumentierte Implementierung deckt nicht alle Bildsequenzen, Canvas-Elemente, Upload-Abläufe oder beliebigen Tastatur-Widgets ab. Ein Team sollte eine repräsentative eigene Aufgabe mitsamt Fehlerpfaden nachstellen, statt aus einer erfolgreichen Flugsuche allgemeine Browserkompetenz abzuleiten. Betrachten Sie die Aufzeichnung als überprüfbaren Beleg für eine funktionierende Zusammensetzung.
Der Bericht über 1.500 E-Mails ist vielversprechend, aber wichtige Bezugsgrößen fehlen
Am 16. September 2026 schrieb vogel (@ryanvogel) auf X, er habe Jev mit 1,500 seiner eigenen E-Mails ausprobiert und sei von den Klassifikationsergebnissen beeindruckt gewesen. Der Originalbeitrag enthält ein Video. Es ist ein nützliches Beispiel aus der Praxis, weil der Umfang konkret und die Quelle die Person ist, die über das Experiment berichtet, statt einer nicht zugeordneten Liste hypothetischer Anwendungen.
Es ist jedoch kein Genauigkeitsbericht. Der Beitrag weist weder einen öffentlichen, beschrifteten Testsatz noch eine gemessene Fehlerrate, eine Übereinstimmung zwischen Prüfenden oder die Kosten von Fehlern nach. Die Zahl der verarbeiteten Nachrichten sagt etwas über den Umfang des Experiments, nicht über seine Korrektheit aus. Sehen Sie sich die Originaldemo auf X mit diesem Unterschied im Hinterkopf an; das Video ist verlinkt, nicht ohne Weiterverbreitungslizenz kopiert.
Die E-Mail-Klassifikation ist dennoch ein sinnvoller Ausgangspunkt für eine Evaluierung, denn sie lässt sich umkehrbar gestalten. Zeigen Sie vorgeschlagene Bezeichnungen neben dem bestehenden Posteingang an, lassen Sie die Originalnachricht unangetastet und protokollieren Sie Korrekturen. Vergleichen Sie leicht zu verwechselnde Fälle wie eine Rechnung und eine Zahlungserinnerung oder eine Kündigungsbitte und eine Beschwerde, in der eine Kündigung lediglich erwähnt wird. An solchen Fällen zeigt sich, ob die Kategorien zu Ihrem tatsächlichen Arbeitsablauf passen.
Bei einer ersten Einführung sollten E-Mails nicht automatisch gelöscht, Antworten nicht versendet und Transaktionen nicht genehmigt werden, nur weil eine Klassifikation sicher wirkt. Solche Aktionen bringen andere Berechtigungen und Folgen mit sich. Beginnen Sie mit einem Vorschlag oder einer Prüfwarteschlange und lassen Sie erst nach der Messung des Fehlermusters eine eng begrenzte Aktion zu. Dies ist unser vorgeschlagenes Evaluierungsverfahren, keine Behauptung über die Implementierung des X-Autors.
Doom und Wikiracing machen die Entscheidungsschleife sichtbar
TypeSafes Vorstellung enthält eine Doom-Demo und eine Wikiracing-Demo, beide sind im offiziellen Vorstellungsartikel verlinkt. Sie veranschaulichen wiederholte Entscheidungen. Sie belegen nicht, dass Jev ein allgemeines Bildmodell ist oder beliebige Planungsaufgaben lösen kann.
Im Doom-Beispiel erhält das Modell eine strukturierte Textbeschreibung des Zustands und keine Screenshots. Bei Wikiracing wählt es unter verfügbaren Links aus, statt eine Ziel-URL zu erfinden. Der interessante Mechanismus ist der wiederholte Kreislauf aus Beobachtung, begrenzter Auswahl und Aktion. Spieledemos machen diesen Kreislauf sichtbar, lassen aber weiterhin offen, wie gut er sich auf eine andere Umgebung übertragen lässt.
Dieselbe Trennung findet sich in TypeSafes Dokumentation zur Smart-Home-Demo. Unterschiedliche Fragen können Aspekte einer Anfrage klassifizieren, während eine andere Komponente freie Unterhaltung oder die Aufteilung einer zusammengesetzten Anfrage übernimmt. Beschreiben Sie diese Architektur nicht als ein einzelnes Modell, das sowohl Sprache erzeugt als auch jede Entscheidung ausführt. Bezeichnungen wie Assistent oder Agent verdecken solche Grenzen oft, wenn sie in der Implementierung nicht ausdrücklich sichtbar gemacht werden.
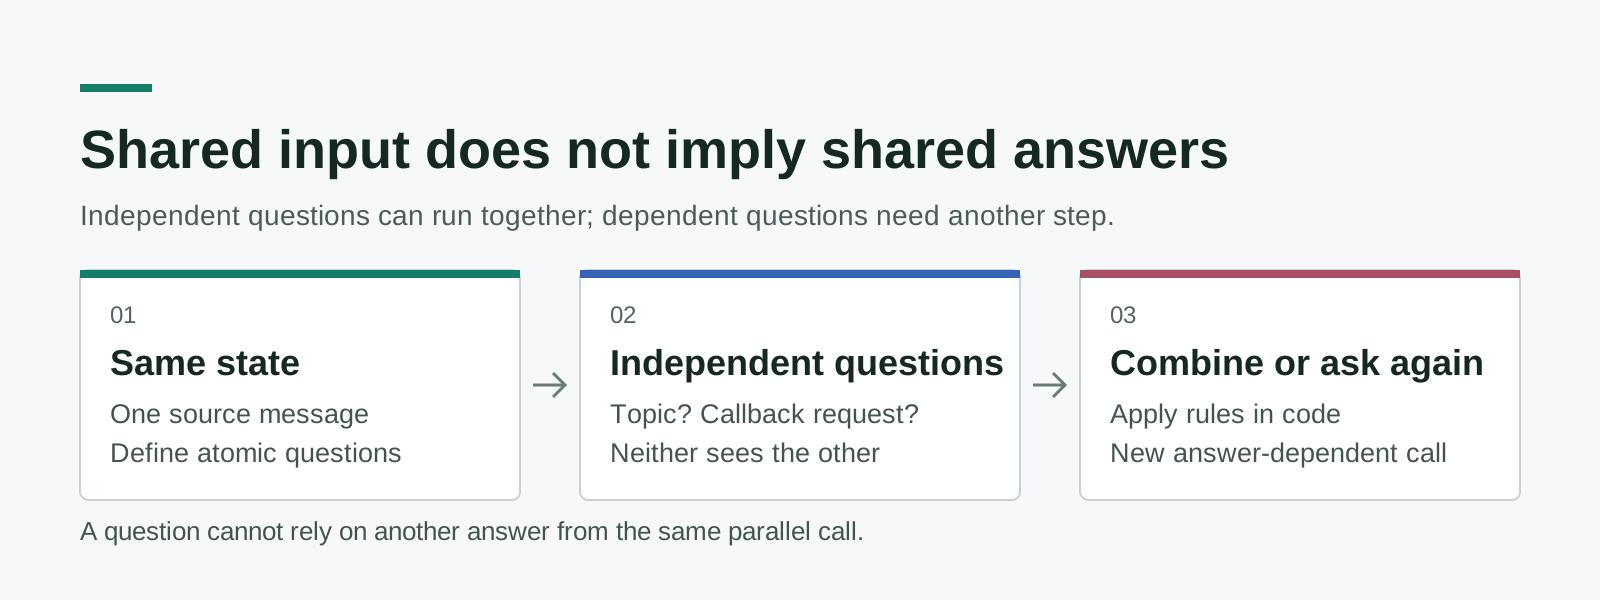
Originaldiagramm auf Grundlage des dokumentierten Fan-out-Vertrags. Gleichzeitige Fragen teilen den Zustand, lesen aber nicht heimlich die Antworten voneinander.
Das Fan-out-Muster kann serielle Wartezeiten verringern, wenn mehrere Fragen von derselben Quelle abhängen. Beispielsweise lassen sich das Thema einer Nachricht und die Frage, ob sie ausdrücklich um einen Rückruf bittet, unabhängig voneinander bewerten. Eine Frage, die vom neu gewählten Thema abhängt, kann nicht davon ausgehen, dass diese Antwort innerhalb desselben Aufrufs bereits vorliegt. Teilen Sie diese Abhängigkeit in einen späteren Schritt auf oder führen Sie die unabhängigen Ergebnisse deterministisch im Code zusammen.
Eine typisierte Antwort ist nicht automatisch richtig
Die gefährlichste Fehlinterpretation eines eingeschränkten Modells lautet, eine wohlgeformte Antwort könne nicht falsch sein. Doch das kann sie. Ein Klassifikator kann eine zulässige, aber unpassende Bezeichnung wählen, und eine Aktionsauswahl kann eine gültige Schaltfläche im falschen Formular anklicken. Fehlerhaft formulierte Texte aus einer Schnittstelle fernzuhalten, ist wertvoll, behebt aber eine andere Fehlerklasse als ein Missverständnis der Aufgabe.
TypeSafes Anmerkungen zu Jev 1.13 und seinen Schwankungen, zuletzt am 17. September geprüft, beschreiben Schwächen bei Arithmetik, Zählen, Datumsvergleichen, ablenkendem Kontext und adversarialen Eingaben. Für exakte Vergleiche sollten Sie Datumswerte parsen und Größen mit gewöhnlichem Code berechnen. Machen Sie aus einer deterministischen Regel kein semantisches Urteil, nur weil das Modell die Frage beantworten kann.
Auch die Dokumentation zu Konfidenz ist wichtig: Choice und Score geben Wahrscheinlichkeitsverteilungen sowie einen daraus abgeleiteten Konfidenzwert aus; Noul hat kein separates Konfidenzfeld. Diese Zahl ist keine allgemeingültige Wahrscheinlichkeit dafür, dass die Antwort stimmt. Schwellenwerte müssen für Ihre eigene Aufgabe validiert werden, insbesondere wenn die Folgen eines falsch positiven Ergebnisses andere sind als die eines falsch negativen.
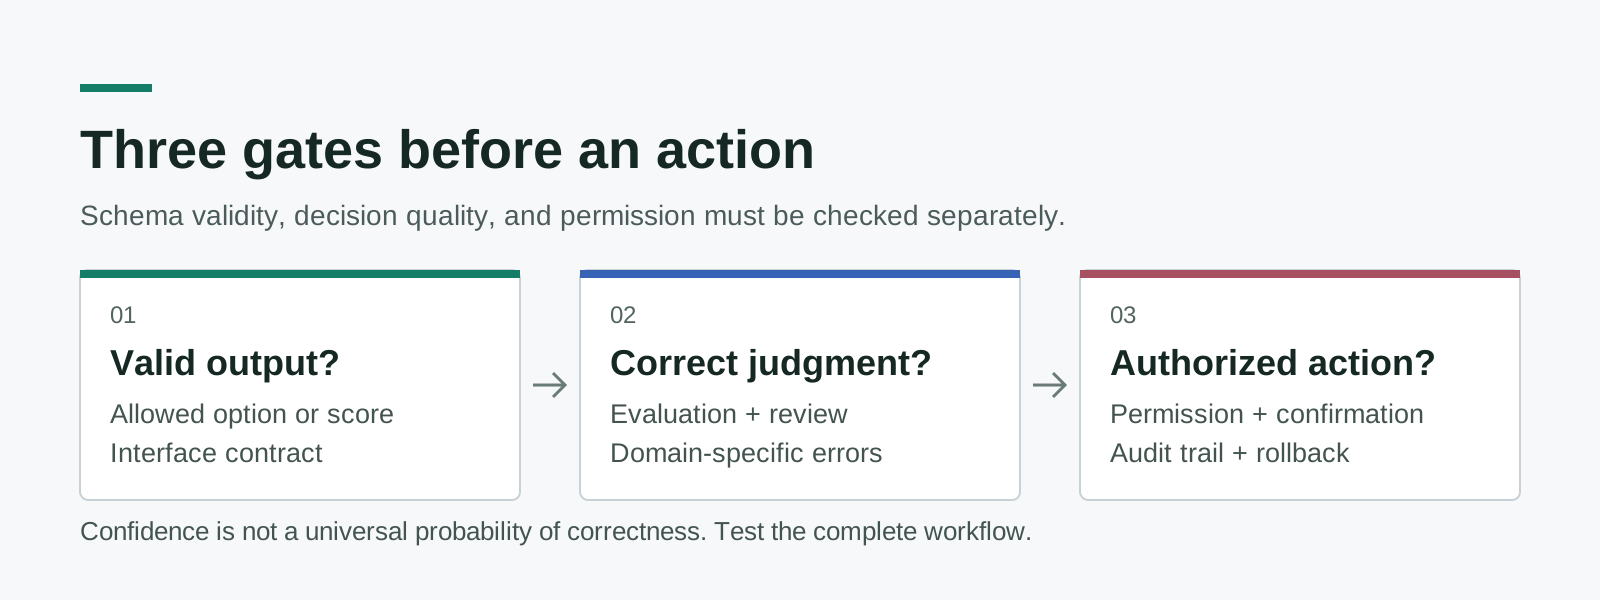
Originales Evaluierungsdiagramm. Das Bestehen einer Prüfstufe bedeutet nicht, dass auch die nächste bestanden wird; selbst eine zulässige Ausgabe muss korrekt interpretiert und die Aktion autorisiert sein.
Bei mehrsprachiger Nutzung sollten Sie jede tatsächlich bediente Sprache testen. Laut Modelldokumentation ist Englisch die primäre Trainingssprache; die Qualität ist in anderen Sprachen, einschließlich CJK-Schriften, nicht einheitlich. Eine koreanische Supportwarteschlange oder ein mehrsprachiges Newsletter-Archiv sollte daher eine eigene Evaluierungskategorie bilden und nicht als Erweiterung eines englischen Ergebnisses vorausgesetzt werden. Übersetzungen können zudem die Belege verändern. Bewahren Sie das Original auf, wenn Sie eine übersetzte Darstellung evaluieren.
Entwickeln Sie einen Testlauf, der ehrlich scheitern darf
Ein sinnvoller Pilot beginnt mit einer Entscheidung, die Ihr Team einheitlich beschriften kann. Wählen Sie eine umkehrbare Aufgabe, etwa eine Supportwarteschlange vorzuschlagen, mögliche Duplikate zu markieren oder ein Dokument für eine spätere Prüfung zu kennzeichnen. Definieren Sie Erfolg nicht danach, ob die Demo reibungslos aussieht. Legen Sie fest, welche falschen Ergebnisse auffallen würden, welche Ihnen entgehen könnten und was jedes davon die Nutzer kostet.
- Den Entscheidungsvertrag formulieren. Listen Sie die möglichen Ergebnisse, benötigten Quellfelder und die Prüfoption auf. Trennen Sie semantische Interpretation von Berechnungen und Berechtigungen.
- Einen Evaluierungssatz zusammenstellen. Verwenden Sie nur Material, dessen Verarbeitung Sie autorisiert sind. Berücksichtigen Sie typische Fälle, unklare Abgrenzungen, mehrere Sprachen, leere Felder und bösartige Anweisungen im Quelltext.
- Einen zurückgehaltenen Datenausschnitt bewahren. Stimmen Sie Kriterien anhand eines Datensatzes ab und messen Sie anschließend mit Material, das die Formulierung nicht beeinflusst hat. Protokollieren Sie abweichende Bewertungen, statt die erwartete Antwort stillschweigend umzudefinieren.
- Den Arbeitsablauf messen. Erfassen Sie Fehler je Kategorie, Prüfquote, Ende-zu-Ende-Latenz, Wiederholungen und Gesamtkosten. Ein schneller Modellaufruf in einer langsamen Abrufschleife ergibt trotzdem ein langsames Produkt.
- Im Vorschlagsmodus starten. Protokollieren Sie die gewählte Option, relevante Wahrscheinlichkeiten, Modellversion und menschliche Korrektur, ohne folgenreiche Aktionen automatisch auszuführen.
- Eine begrenzte Aktion freigeben. Verlangen Sie bei Bedarf eine ausdrückliche Autorisierung, führen Sie einen Prüfpfad und halten Sie einen Rückweg bereit, falls sich Quelle oder Modellversion ändern.
Dieses Verfahren ist bewusst strenger, als sich eine Aufzeichnung anzusehen. Es prüft, ob das Modell bei Ihrer Fallverteilung hilft, einschließlich der schwierigen Fälle. Eine hohe Prüfquote kann besser sein als eine kleine Anzahl unbemerkter, kostspieliger Fehler. Entscheiden Sie über diesen Zielkonflikt, bevor Sie einen Schwellenwert festlegen, nicht erst nach einem Vorfall.
Fixieren Sie für reproduzierbare Evaluierungen eine Version und protokollieren Sie die mit jedem Ergebnis zurückgegebene Version. Veränderliche Aliase sind zum Erkunden praktisch, können aber das Verhalten ändern, ohne dass sich der Anwendungscode ändert. Ein Evaluierungsartefakt sollte einer anderen Person ermöglichen, Kriterien, Eingaben, erwartete Ergebnisse und Ausführungsgrenzen nachzuvollziehen. So wird aus einem vielversprechenden Experiment eine wartbare Funktion statt einer Sammlung beeindruckender Clips.
Das Fazit: Urteilen Sie innerhalb eines klar begrenzten Vertrags
Jev ist dann am interessantesten, wenn es eine kleine, nachvollziehbare Entscheidung innerhalb eines Programms trifft, dessen Regeln bereits feststehen. Das Browser-Video zeigt eine funktionierende Zusammensetzung, der E-Mail-Beitrag liefert ein konkretes, prüfenswertes Experiment, und die offiziellen Demos machen den Kreislauf sichtbar. Die nächste Frage lautet nicht, ob das Modell eine Antwort auswählen kann, sondern ob Ihr System eine falsche Auswahl erkennt, bevor sie Folgen hat.
Quellen und Mediennachweise
- TypeSafe: Introducing System One Models and Jev, 15. September 2026; offizielle Vorstellung und Kontext zu den Spielvideos.
- Browser Use: jev-ultrafast, gepinnte Quelle, geprüft am 30. September 2026. GIF und MP4: Copyright 2026 Browser Use, MIT-Lizenz; eine Zugehörigkeit wird nicht behauptet.
- Browser Use: Aufzeichnung und Messwerte aus Vergleichsdurchläufen, geprüft am 30. September 2026; Messungen des Autors, nicht von uns reproduziert.
- vogel auf X: Klassifikationsexperiment mit 1.500 E-Mails, 16. September 2026; selbst berichteter Anwendungsfall mit Originalvideo.
- TypeSafe-Primitiven, Modelle, Konfidenz, Fan-out und Smart-Home-Demo, geprüft am 30. September 2026.
- Jev 1.13 und seine Schwankungen, zuletzt geprüft am 17. September 2026; abgerufen am 30. September.
- Jev-Anwendungsfallartikel auf Tistory, 18. September 2026; Ausgangspunkt der Recherche, kein Nachweis eines Einsatzes.
Belege zusammen mit Ihren Notizen aufbewahren
Wenn Sie ein neues Modell recherchieren, bewahren Sie die Quelle, ihr Datum und den tatsächlichen Aussagewert der Demo auf. Erstellen Sie ein Telli.sh-Konto, um Ihre eigenen Recherchematerialien und abgeleiteten Notizen zu ordnen, ohne eine Zusammenfassung mit den Originalbelegen zu verwechseln.