Cette start-up a gardé Claude et Codex et confié la paperasse à une IA locale
Grayhat Developers a essayé de remplacer ses agents de code payants avant de confier à des modèles locaux la documentation, les tickets et les transmissions. Son étude de cas montre comment tester cette répartition.
Un développeur demande à un agent de code de corriger un bug dans un service. L’agent doit d’abord retrouver le ticket initial, consulter quelques décisions produit et déterminer quelles exigences sont toujours d’actualité. Après le correctif, quelqu’un doit créer des tickets pour que la conception ou le support puisse reprendre le travail restant. La modification du code ne représente qu’une partie de la tâche, mais le même modèle payant peut se retrouver à tout faire.
Grayhat Developers, une entreprise de logiciels de moins de 40 personnes, a décrit dans une prépublication du 5 novembre 2026 ce qui s’est passé lorsqu’elle a séparé ces activités. Ses ingénieurs avaient essayé des modèles auto-hébergés pour le développement. Le remplacement des agents de code commerciaux avait rendu certaines tâches sur les dépôts plus lentes ou plus difficiles. L’équipe a gardé ces agents pour les modifications complexes et transféré une partie de la recherche documentaire, de la préparation du contexte et de la synchronisation des tickets vers un service local.
Pour une autre petite équipe, la question est de savoir quelle tâche transférer en premier. L’expérience de Grayhat fournit un point de départ, une estimation dont les hypothèses méritent examen et un exemple de déploiement qui peut faire échouer un pilote avant même qu’on puisse juger la qualité du modèle.
Corriger un bug commence par retrouver son contexte
Grayhat utilisait Outline pour la documentation, Plane pour le suivi du travail et ERPNext pour les informations sur l’organisation. Ces services tournaient déjà sur une machine au bureau, avec Authentik pour la gestion des identités. Les connecteurs du Model Context Protocol, ou MCP, étaient hébergés sur la même machine. Une seconde machine prenait en charge l’inférence. La séparation répondait à un besoin pratique. La documentation et les tickets pouvaient rester accessibles via leurs interfaces habituelles pendant que les modèles mobilisaient les ressources de calcul ailleurs.
Le processus décrit dans l’article repose sur des transmissions humaines. Un membre de l’équipe utilise le modèle interne pour retrouver et condenser des éléments du wiki ou de l’outil de suivi. Les extraits pertinents peuvent être placés dans un fichier du dépôt destiné à l’agent de code. Après les modifications dans le dépôt, une personne peut rapporter les prochaines étapes à l’assistant interne, en faire des brouillons de tickets et les envoyer dans l’outil de suivi. Les échanges directs entre agents restent une piste de travail. Dès aujourd’hui, une personne peut voir les informations au moment du transfert et décider lesquelles transmettre.
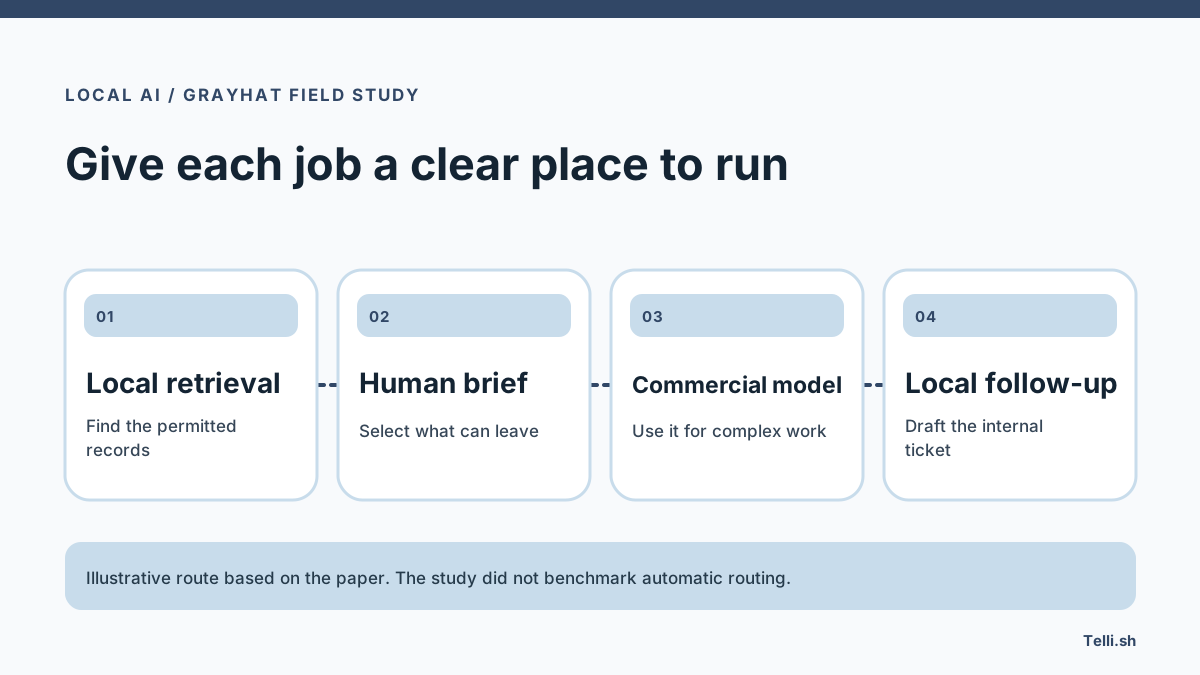
Les points de transmission du processus de Grayhat. Illustration originale de Telli.sh d’après l’étude du 5 novembre.
Imaginons qu’un client signale des lignes en double dans un export. Le rapport initial contient un identifiant de compte confidentiel et la transcription d’une conversation sans rapport avec le bug. Un assistant local peut retrouver les règles d’export en vigueur, la personne responsable du service et la solution de contournement précédente. L’ingénieur peut alors préparer une fiche avec un exemple fictif et le nombre de lignes attendu. L’agent de code reçoit de quoi reproduire le bug. Les éléments sensibles restent dans les systèmes internes parce qu’une personne a choisi ce qui pouvait en sortir.
Conservez les liens d’origine dans le brouillon interne. Quand deux exigences se contredisent, la personne chargée de relire peut voir si la règle proposée découle d’une décision récente ou d’une ancienne solution de contournement. Un résumé produit localement qui perd ses sources recrée une partie du problème de départ. Le collègue suivant doit de nouveau déterminer quelle version est fiable.
L’équipe a payé pour de la capacité et estimé quelle part elle pouvait transférer
Les auteurs déclarent une dépense de référence d’environ 325 dollars par mois pour l’IA commerciale, dont quelque 175 dollars pour sept accès Claude, 140 dollars pour sept abonnements Codex et 10 dollars de crédits. Ils font aussi état de plus de 25,93 milliards de jetons enregistrés dans ces services. L’article ne démontre pas que le relevé des jetons couvre la même période de facturation que les 325 dollars. Chaque chiffre décrit une mesure différente. Leur rapport ne donne pas un prix fiable par jeton.
Grayhat estimait que la transmission du contexte, la documentation et la coordination de projets représentaient 30 à 40 % de sa charge de travail avec l’IA commerciale. Selon les auteurs, le système local pouvait absorber environ 90 % de cette catégorie. Le calcul donne 27 à 36 % de la charge commerciale totale. Rapportée au montant de référence de 325 dollars, cette part équivaut à environ 88 à 117 dollars par mois. L’étude du 5 novembre fournit des estimations de charge et de leur équivalent financier. Elle n’a pas réalisé d’expérience contrôlée sur les factures avant et après.
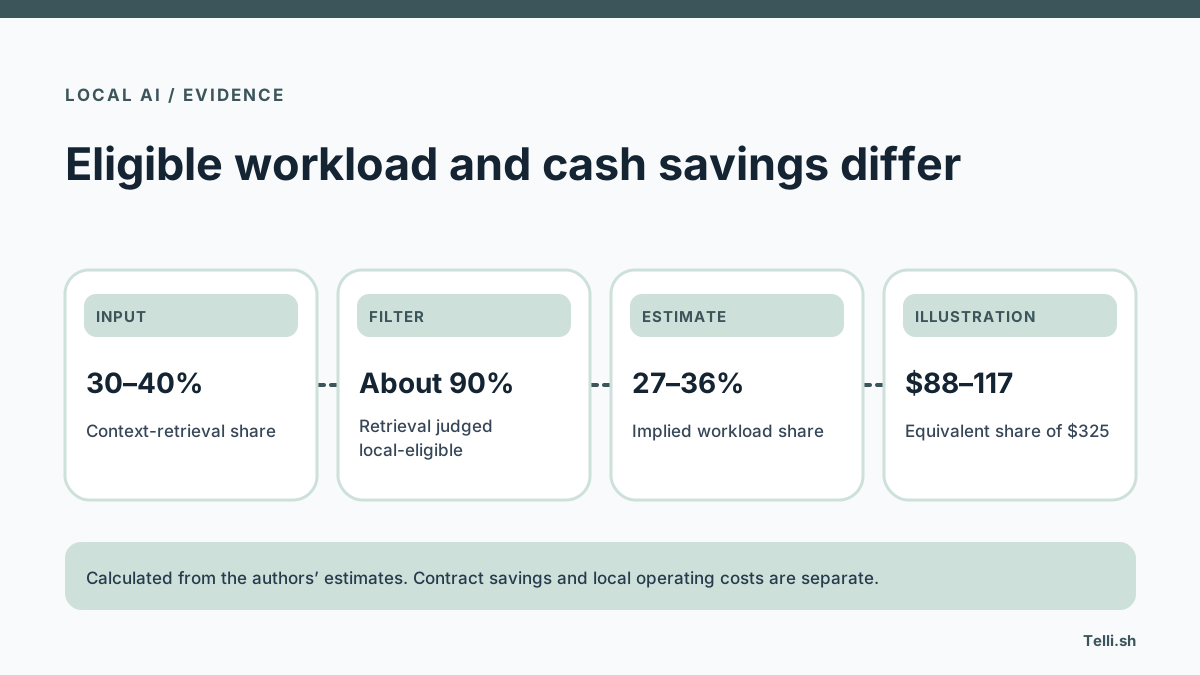
Grayhat part d’une estimation de la charge et en calcule un équivalent financier. Illustration originale de Telli.sh.
| Chiffre de la prépublication | Ce qu’il représente | Comment l’utiliser |
|---|---|---|
| 325 dollars par mois | Montant de référence déclaré pour les abonnements commerciaux et les crédits | Établir un montant comparable à partir de ses factures |
| 30 à 40 % | Part estimée du travail consacrée au contexte et à la coordination | Recenser les tâches récurrentes avant d’installer un autre service |
| Environ 90 % | Part estimée de la coordination réalisable en local | Vérifier chaque résultat avec les personnes chargées de le valider |
| 27 à 36 % et 88 à 117 dollars par mois | Part de travail estimée transférable et son équivalent financier | Comparer les factures séparément des mesures d’activité du modèle |
| 10 à 30 dollars par mois | Coût d’exploitation du modèle local dans le tableau des auteurs | Comptabiliser à part le matériel et le temps de maintenance |
Cette distinction compte lorsque la facturation se fait par utilisateur. Si sept développeurs ont toujours besoin de leurs abonnements pour les travaux complexes, la facture suivante peut rester identique malgré une baisse d’usage. Le gain peut prendre la forme de capacité disponible pour d’autres correctifs, de plafonds moins contraignants ou d’achats supplémentaires évités. Pour une équipe facturée à la requête, l’effet peut se voir plus tôt, mais les relances et les files d’attente peuvent absorber une part du gain apparent. S’il faut acheter un GPU et consacrer du temps à sa disponibilité, ce coût entre aussi dans la comparaison.
Choisissez une unité que vous pouvez contrôler. Les brouillons de tickets sont faciles à compter. Un ticket que la responsable du projet réécrit entièrement apporte peu de preuves d’un gain de temps. Mesurez les fiches et tickets acceptés, et relevez les retouches qui modifient le sens d’une tâche. Une fois que les personnes chargées de la validation reconnaissent systématiquement un résultat acceptable, suivez l’effort nécessaire pour le produire.
La deuxième interface a changé qui faisait la configuration
Le premier déploiement utilisait LobeHub. Les ingénieurs recevaient une procédure pour connecter leur propre interface aux outils internes de l’organisation. Les auteurs rapportent que les démonstrations prometteuses n’ont pas débouché sur un usage régulier. Les personnes devaient savoir quel connecteur choisir, où le trouver et comment s’authentifier. Chaque choix supplémentaire repoussait le moment de la première réponse utile.
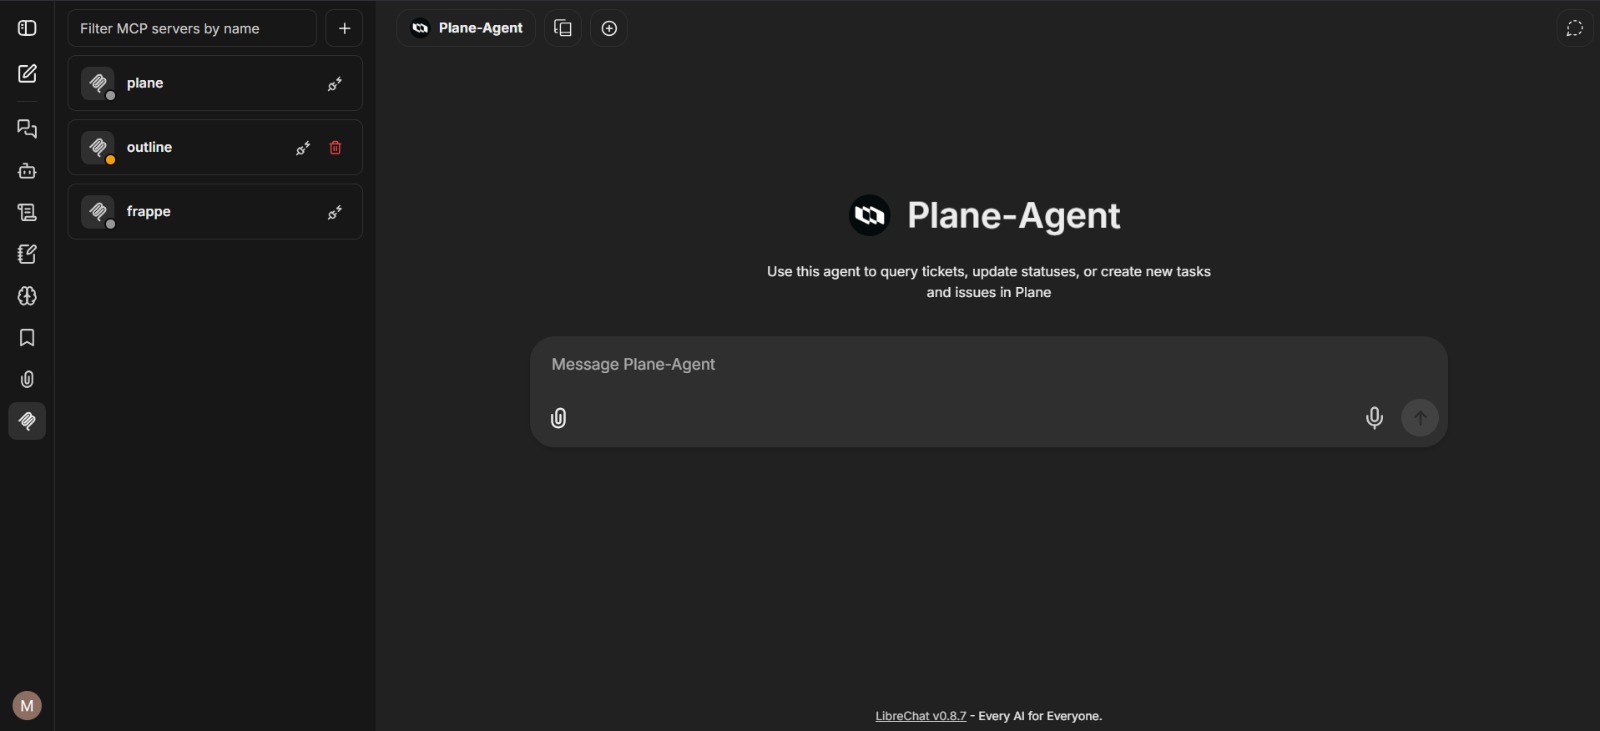
La deuxième interface de Grayhat proposait des outils configurés de manière centralisée. Figure 2 de « Create Your Own Work Stack » par Saad Ahmed Bazaz, Talha Amjad, Abdurrehman Subhani, Sohaib Ahmed Bazaz et Abdullah Aamir, CC BY 4.0.
L’équipe est passée à un déploiement LibreChat configuré de manière centralisée. Les utilisateurs voyaient les outils déjà configurés et s’authentifiaient en y accédant. Pour la première version, les auteurs ont compté huit remarques sur la configuration et la prise en main dans onze entretiens structurés. Pour la deuxième, ils en ont relevé trois dans des retours Discord non structurés. Les méthodes de collecte diffèrent. Ces données éclairent la difficulté de prise en main sans indiquer à quel point l’adoption a augmenté ou combien de personnes ont cessé de rencontrer cette difficulté.
Construisez la première session autour d’une petite tâche réelle. Une responsable de projet qui se connecte pour retrouver les critères d’acceptation d’un ticket doit pouvoir voir si l’outil de suivi est connecté et quel compte est actif. Un ingénieur qui veut préparer trois tickets doit pouvoir les relire avant de les publier. Si chacun doit apprendre à configurer les connecteurs avant de retrouver son travail, le pilote risque surtout de mesurer sa patience.
Une configuration centrale crée une nouvelle responsabilité. Quelqu’un doit tenir à jour la liste des connecteurs autorisés, renouveler les identifiants et préciser qui peut modifier les permissions. Une mauvaise configuration risque sinon de toucher tout le monde. L’avantage est qu’une correction apportée une seule fois à un problème récurrent bénéficie à toutes les personnes qui utilisent le service.
Confier au système local des tâches dont le résultat a un responsable
Le tri des signalements est un bon point de départ. L’assistant interne peut regrouper des rapports similaires et proposer une synthèse avec les liens des tickets d’origine. La personne responsable du projet décide si les deux rapports décrivent le même problème et si la description fusionnée oublie une condition. L’assistant peut préparer un commentaire expliquant le regroupement. Une responsabilité identifiable permet de savoir qui a validé ce qui s’est passé.
La mise à jour de la documentation est un autre travail. Supposons qu’un changement déplace un réglage vers un autre écran. L’assistant peut retrouver les pages d’aide périmées, repérer les éditions du produit qu’elles concernent et proposer des corrections. Une personne vérifie la navigation actuelle et publie les changements appropriés. Un modèle distant plus puissant apporte peu si l’obstacle principal consiste à accéder aux pages internes à jour et à conserver le bon périmètre pour chaque article.
Les modifications complexes du code constituent le cas inverse. Une migration de base de données peut exiger d’examiner d’anciens contrats de données, de modifier plusieurs services et de valider un retour arrière. La configuration locale testée par Grayhat peinait sur les travaux de grande ampleur dans les dépôts, surtout quand le modèle devait traiter beaucoup de contexte et répondre rapidement. L’étude décrit le matériel, les modèles et l’expérience de l’équipe. Elle incite à tester sa propre charge localement avant d’étendre le périmètre.
Une tâche qui mêle mise en forme simple et données sensibles mérite un parcours limité. Un brouillon envoyé hors du réseau peut exposer des informations même si les outils d’origine fonctionnent sur place. Si un transfert externe est nécessaire, validez la destination et préparez uniquement les éléments dont elle a besoin. En l’absence d’approbation, gardez le résultat dans la file de relecture interne. Lorsqu’un délai expire, affichez l’erreur pour éviter un transfert inattendu.
Un pilote court pour distinguer le travail utile des tâches d’exploitation
- Définir trois résultats. Choisissez une fiche de ticket avec ses liens, une correction de documentation et un brouillon de ticket. Pour chacun, indiquez en une phrase qui le valide et quelles preuves sont nécessaires. Gardez un exemple raté à côté d’un bon, avec des erreurs faciles à manquer.
- Mesurer le processus actuel. Pendant une semaine de travail ordinaire, comptez les exemples traités, les corrections de fond et le temps passé à retrouver le contexte. Quand c’est possible, rattachez l’usage commercial à chaque processus. Relevez si le retrait de ces tâches modifierait réellement les abonnements facturés ou les dépassements. Consignez séparément le travail que l’équipe a complètement évité de faire.
- Connecter un outil interne. Commencez par un accès en lecture dans un projet identifié. Vérifiez qu’un membre autorisé peut retrouver un ticket connu et qu’une personne extérieure au projet ne le peut pas. Limitez le pilote à quelques personnes qui exécutent déjà les tâches retenues. Prévoyez un moyen clair de terminer manuellement si l’outil tombe en panne.
- Comparer les brouillons avant d’autoriser l’écriture. Demandez à la même personne d’accepter ou de rejeter les résultats selon les mêmes critères. Relevez les liens vers le mauvais ticket, les faits périmés et les conclusions sans source. Ajoutez une prévisualisation, une validation et une trace durable avant d’autoriser l’assistant à modifier le véritable outil de suivi.
- Observer ce qui a changé. Comparez le travail accepté, le temps de relecture, l’usage actif et les factures réelles. Ajoutez le temps consacré à la maintenance des machines, aux interruptions et aux changements de connecteurs. Incluez l’aide apportée directement aux utilisateurs. Une application qui fonctionne après dix minutes d’accompagnement individuel par personne entraîne toujours un coût de prise en main.
Si vous faites déjà tourner un modèle local pour les développeurs, essayez ce pilote en parallèle de l’activité ordinaire. Des files d’attente apparaissent quand plusieurs personnes commencent en même temps. Un service peut traiter rapidement une requête isolée et faire attendre trois personnes. Pour les tâches urgentes, donnez un moyen de suivre l’avancement et de reprendre le processus manuel habituel. Le pilote reste ainsi utilisable pendant que l’équipe apprend quelles charges lui conviennent.
L’annexe de Grayhat fournit un ordre de grandeur. La machine des outils disposait de 16 Go de mémoire vive. La machine d’inférence séparée disposait de 32 Go et d’une RTX 4080 avec 16 Go de VRAM. L’équipe dit avoir ajouté de la supervision réseau, de la planification et une alimentation sans interruption lorsque les besoins d’exploitation se sont précisés. Ce sont des éléments à intégrer au budget d’un pilote. Au coût d’une réponse du modèle s’ajoute celui d’un service sur lequel les collègues peuvent compter.
Décider à quoi consacrer la prochaine heure d’IA
L’idée réutilisable consiste à séparer la préparation du contexte du raisonnement spécialisé et à confier chaque transmission à une personne responsable. Commencez par une tâche fréquente qui produit un document que votre équipe sait déjà relire. Mesurez l’effort nécessaire pour le faire accepter, puis décidez si le processus local mérite une autre tâche. L’expérience de Grayhat donne une façon de faire ce choix tout en gardant les outils de code qui restent utiles.
Sources
- Prépublication de Grayhat Developers du 5 novembre 2026
- Article intégral, estimations de charge, infrastructure et figure 2
- Image d’origine de la figure 2
- Licence CC BY 4.0 de la figure de l’article

Pour retrouver les discussions qui ont préparé une transmission, créez un compte Telli.sh.