Esta empresa mantuvo Claude y Codex y pasó el papeleo a la IA local
Grayhat Developers probó a sustituir sus agentes de pago y acabó usando modelos locales para documentos, incidencias y traspasos. Su estudio explica cómo probar ese reparto.
Un desarrollador pide a un agente de programación que corrija un fallo de un servicio. Antes, el agente debe localizar la incidencia original, recuperar algunas decisiones de producto y distinguir los requisitos vigentes. Después del parche, alguien tiene que convertir el trabajo pendiente en incidencias visibles para diseño o soporte. Cambiar el código es solo una parte, aunque todo el trabajo puede recaer en el mismo modelo de pago.
Grayhat Developers, una empresa de software de menos de 40 personas, describió qué ocurrió al separar esas tareas en una prepublicación del 5 de noviembre de 2026. Sus ingenieros probaron modelos de alojamiento propio en tareas de desarrollo y observaron que sustituir los agentes comerciales volvía algunos trabajos en el repositorio más lentos o difíciles. Mantuvieron esos agentes para cambios complejos y trasladaron parte de la recuperación de documentos, la preparación del contexto y la sincronización de incidencias a un servicio local.
Para otro equipo pequeño, la cuestión interesante es qué trasladar primero. La experiencia de Grayhat ofrece un punto de partida concreto, una estimación que merece examinarse y un error de incorporación capaz de malograr el piloto antes de aprender nada sobre la calidad del modelo.
Corregir un fallo exige reunir contexto antes de tocar el código
Grayhat usaba Outline para documentación, Plane para el seguimiento del trabajo y ERPNext para la información de la organización. Ya alojaba esos servicios en un equipo de la oficina y gestionaba la identidad con Authentik. Los conectores del protocolo MCP (Model Context Protocol) estaban en la misma máquina. Otra se encargaba de la inferencia. La separación tenía un propósito práctico. Los sistemas de documentación e incidencias podían mantener sus interfaces habituales mientras los procesos del modelo consumían recursos en otro equipo.
El flujo descrito en el estudio incluye traspasos humanos. Una persona usa el modelo interno para recuperar y condensar información de la wiki o del gestor de incidencias. Puede colocar lo pertinente en un archivo del repositorio para el agente de programación. Tras trabajar en el repositorio, alguien puede llevar los próximos pasos al asistente interno, convertirlos en borradores y enviarlos al gestor. El estudio deja la comunicación directa entre agentes para el futuro. En el flujo actual, una persona puede inspeccionar la información en el punto de traspaso y decidir si debe pasar al otro lado.
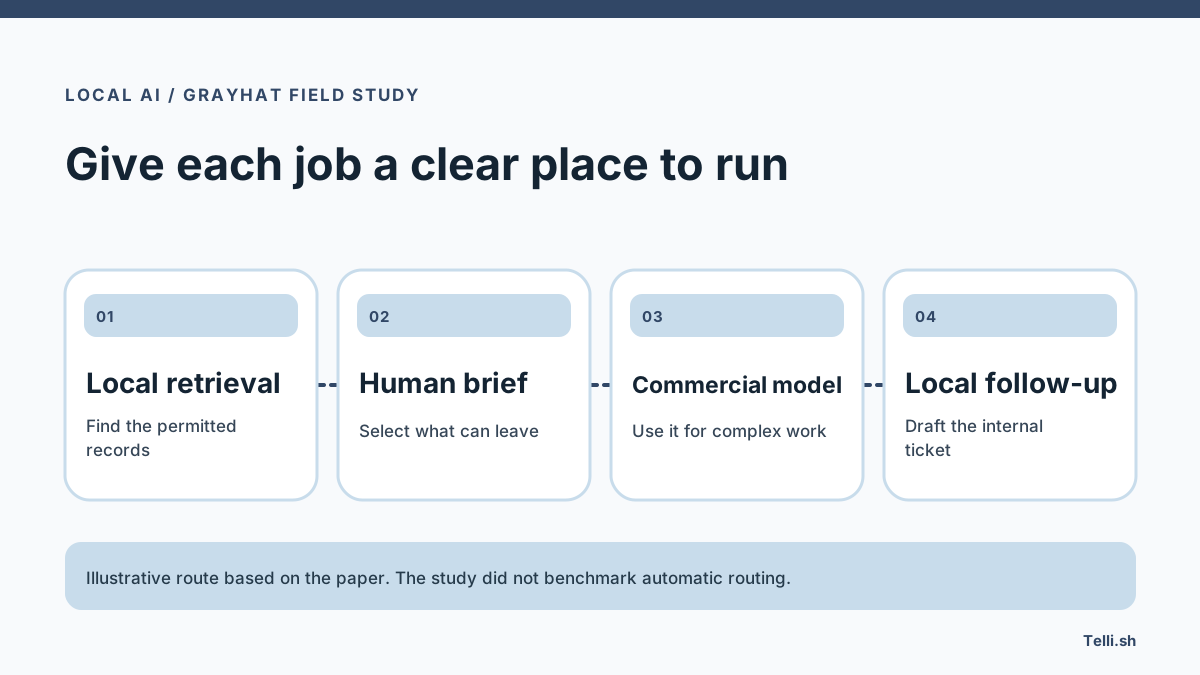
Puntos de traspaso del flujo de Grayhat. Ilustración original de Telli.sh a partir del estudio del 5 de noviembre.
Supón que un cliente informa de filas duplicadas en una exportación. El informe incluye una referencia privada de cuenta y una transcripción que no incide en el fallo. Un asistente local puede encontrar las reglas vigentes de exportación, quién mantiene el servicio y la solución provisional anterior. El ingeniero puede preparar un resumen con un ejemplo sintético y la cantidad esperada de filas. El agente de programación recibe lo necesario para reproducir el fallo. El contenido sensible permanece en los sistemas internos porque una persona eligió qué trasladar.
Conserva los enlaces originales en el borrador interno. Cuando los requisitos discrepan, quien revisa puede ver si una regla viene de una decisión reciente o de una solución provisional antigua. Un resumen local que pierde sus fuentes recrea el problema que debía resolver. El siguiente compañero tendrá que averiguar qué descripción merece confianza.
El equipo compró capacidad y estimó qué parte podía trasladar
Los autores declaran un gasto comercial de referencia de unos 325 dólares al mes, repartidos en unos 175 por siete plazas de Claude, 140 por siete suscripciones a Codex y 10 en créditos. También declaran más de 25.930 millones de tokens registrados en esos servicios. El artículo no establece que los tokens correspondan al mismo periodo de facturación que los 325 dólares. Cada cifra mide algo distinto y no permite calcular un precio por token dividiendo una por otra.
Grayhat estimó que transferir contexto, mantener documentación y coordinar proyectos representaba el 30–40 % del trabajo de su IA comercial. Los autores calcularon que el sistema local podía absorber alrededor del 90 % de esa categoría. El producto de ambos porcentajes da un 27–36 % de la carga comercial total. Aplicar esa proporción a 325 dólares da unos 88–117 dólares mensuales. Son estimaciones de trabajo y su equivalente en coste del estudio del 5 de noviembre. El estudio no realizó una comparación controlada de facturas antes y después.
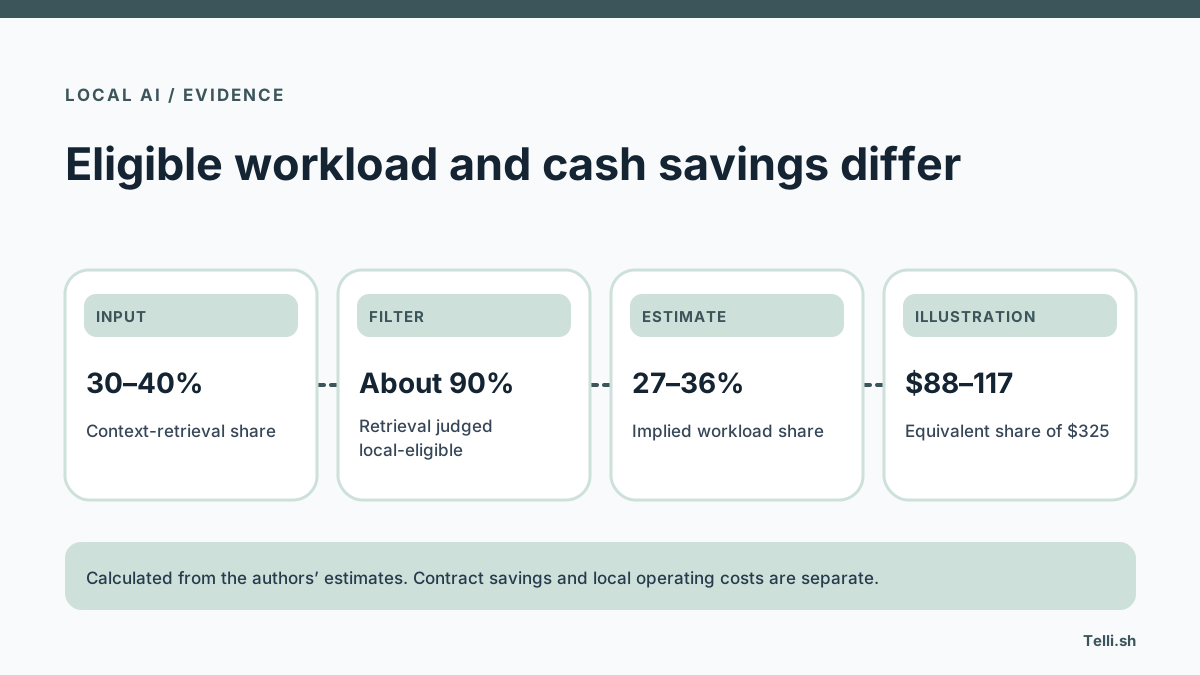
La estimación de Grayhat parte de una proporción del trabajo y llega a un equivalente en coste. Ilustración original de Telli.sh.
| Cifra de la prepublicación | Qué representa | Cómo utilizarla |
|---|---|---|
| 325 dólares mensuales | Gasto declarado de referencia en suscripciones y créditos comerciales | Calcula un punto de referencia equivalente con tus facturas |
| 30–40 % | Proporción estimada de trabajo en coordinación y contexto | Registra las tareas repetidas antes de instalar otro servicio |
| Alrededor del 90 % | Proporción estimada de coordinación que se puede atender en local | Comprueba cada tarea con quien acepta su resultado |
| 27–36 % y 88–117 dólares mensuales | Carga estimada que podría desplazarse y su coste de referencia equivalente | Contrasta las facturas por separado de la actividad del modelo |
| 10–30 dólares mensuales | Coste de operación del modelo local en la tabla de los autores | Contabiliza por separado el equipo y el tiempo de mantenimiento |
La diferencia importa con la facturación por plaza. Si siete desarrolladores siguen necesitando sus suscripciones para los trabajos complejos, usar menos el servicio puede dejar intacta la factura siguiente. El beneficio podría aparecer como capacidad para más parches, menos presión por los límites de uso o menos compras por exceso. Un equipo que paga por petición puede ver cambios antes, aunque los reintentos y las colas lentas pueden absorber parte del ahorro aparente. Si hace falta comprar una GPU y pagar a alguien para mantenerla disponible, incluye también ese coste.
Elige una unidad que puedas revisar. Contar incidencias redactadas es fácil, pero si la persona responsable las reescribe desde cero, hay poca evidencia de ahorro. Mide los resúmenes y las incidencias aceptados y apunta las correcciones que cambian el sentido de una tarea. Cuando los revisores distingan de forma coherente qué es aceptable, registra el esfuerzo que cuesta producirlo.
La segunda interfaz cambió quién debía configurarla
El primer despliegue usó LobeHub. Los ingenieros recibieron instrucciones para enlazar su propia interfaz con las herramientas internas. Según los autores, unas demostraciones prometedoras no se convirtieron en uso habitual. Había que saber qué conector elegir, dónde estaba y cómo autenticarse. Cada decisión adicional retrasaba la primera respuesta útil.
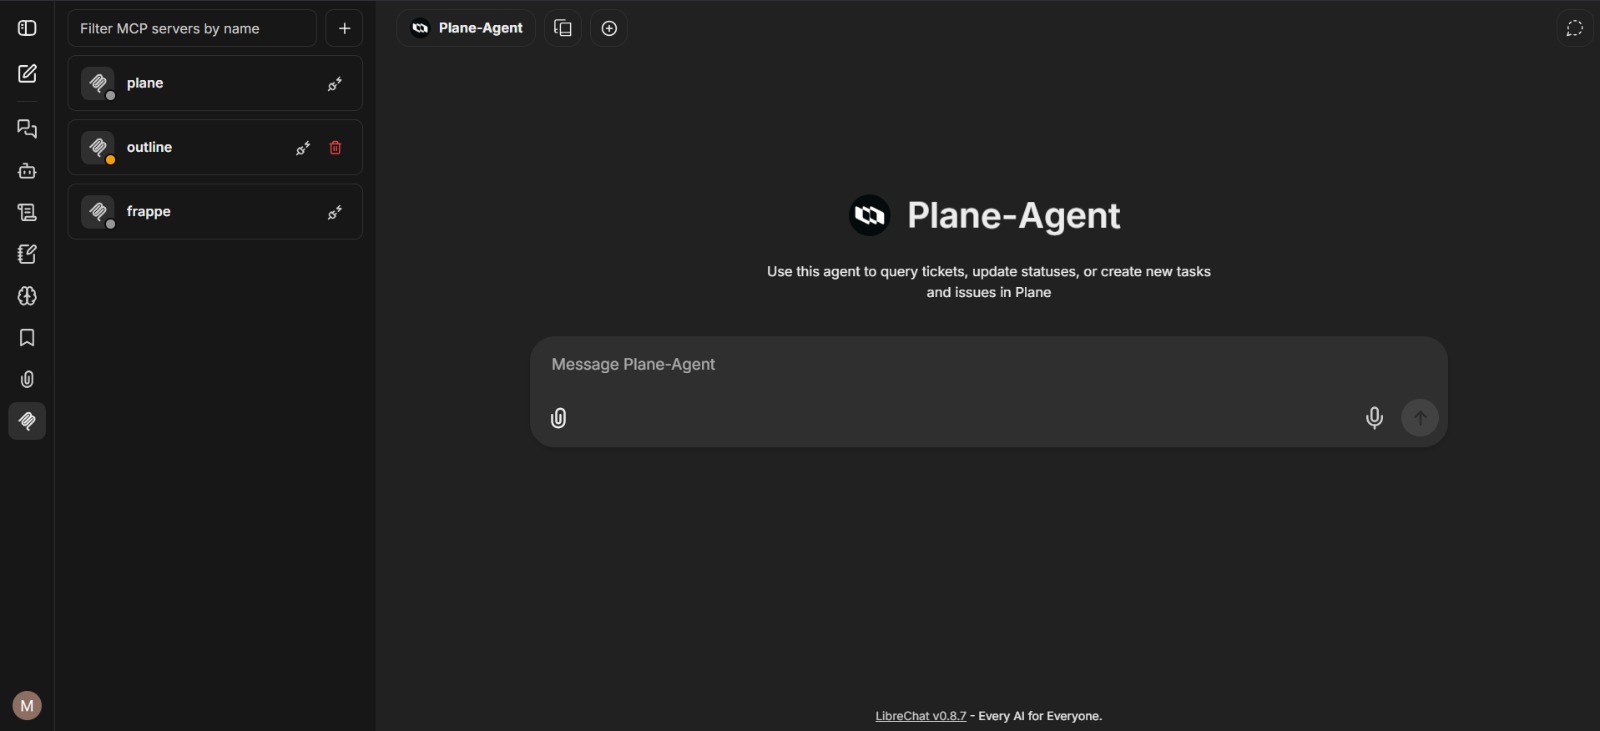
La segunda interfaz de Grayhat tenía las herramientas de trabajo configuradas de forma central. Figura 2 de «Create Your Own Work Stack», de Saad Ahmed Bazaz, Talha Amjad, Abdurrehman Subhani, Sohaib Ahmed Bazaz y Abdullah Aamir, CC BY 4.0.
El equipo pasó a un despliegue de LibreChat configurado de forma central. Los usuarios podían ver las herramientas preparadas y autenticarse al acceder. Los autores contaron ocho comentarios sobre configuración e incorporación en 11 entrevistas estructuradas de la primera versión. La segunda recibió tres comentarios de esa categoría mediante observaciones no estructuradas en Discord. Son métodos de recogida distintos. Ayudan a localizar el problema de incorporación, pero no muestran cuánto creció la adopción ni cuántas personas dejaron de encontrarlo.
Diseña la primera sesión en torno a la tarea real más pequeña. Quien entra a consultar los criterios de aceptación de una incidencia debería poder ver si el gestor está conectado y qué cuenta está activa. Un ingeniero que quiere preparar tres incidencias debería poder revisarlas antes de publicarlas. Enseñar a configurar conectores antes de que la gente encuentre su propio trabajo puede acabar midiendo paciencia en lugar de utilidad.
La configuración central añade una responsabilidad. Alguien debe mantener la lista de conectores autorizados, renovar credenciales y explicar quién puede cambiar los permisos. Sin esa gestión, un error de configuración puede afectar a todo el equipo. La ventaja es que puedes corregir una dificultad repetida una sola vez y aplicar el arreglo a todos los usuarios del servicio.
Asigna al sistema local tareas con un responsable claro
La clasificación de incidencias es un primer caso práctico. El asistente interno puede agrupar informes duplicados y proponer un resumen con enlaces a las incidencias originales. Quien dirige el proyecto decide si realmente son duplicados y si la descripción conjunta omite alguna condición. El asistente puede preparar un comentario explicando el grupo. El cambio es comprensible porque tiene una persona responsable visible.
Mantener documentación es otra tarea. Supón que un ajuste pasa de una pantalla a otra. El asistente puede encontrar las páginas de ayuda obsoletas, identificar qué ediciones del producto cubren y proponer cambios. Un editor verifica la navegación vigente y publica lo correcto. Un modelo remoto más potente aporta poco si la dificultad es acceder a las páginas internas actuales y respetar el alcance de cada artículo.
La programación compleja ofrece el caso contrario. Una migración de base de datos puede exigir inspeccionar contratos históricos, cambiar varios servicios y validar la reversión. Grayhat observó dificultades con su configuración local en trabajos grandes del repositorio, sobre todo cuando el modelo necesitaba un contexto amplio y una inferencia rápida. El estudio describe el equipo, los modelos y la experiencia de esa empresa. Sirve de base para probar tu propia carga antes de ampliar el encargo.
Usa una vía restringida cuando una tarea mezcle formato sencillo y datos sensibles. Enviar un borrador fuera de la red aún puede exponer información aunque las herramientas originales estén en tus instalaciones. Si hace falta un traspaso remoto, aprueba el destino y prepara el material mínimo para él. Mientras falte aprobación, conserva el resultado en la cola de revisión interna. Si vence el tiempo, muestra un error en lugar de trasladar los datos por sorpresa.
Un piloto breve puede distinguir el trabajo útil del mantenimiento
- Define tres resultados. Elige un resumen con enlaces a incidencias, una modificación de documentación y un borrador de incidencia. Escribe una frase por cada uno con quién lo acepta y qué pruebas exige. Guarda un ejemplo fallido junto a uno bueno, con errores fáciles de pasar por alto.
- Mide el proceso actual. Durante una semana normal, cuenta ejemplos completados, correcciones de fondo y tiempo de búsqueda de contexto. Atribuye el uso comercial a cada flujo cuando puedas. Indica si quitar las tareas cambiaría realmente las plazas facturadas o los excesos. Registra por separado el trabajo que el equipo decidió no hacer.
- Conecta una herramienta interna. Empieza con acceso de lectura y un proyecto concreto. Confirma que un empleado autorizado puede recuperar una incidencia conocida y alguien ajeno al proyecto no puede. Limita el piloto a unas pocas personas que ya realizan esas tareas. Ofrece una vía clara para terminarlas manualmente si la herramienta falla.
- Compara los borradores antes de permitir escrituras. Pide a la misma persona que acepte o rechace resultados con los mismos criterios. Registra enlaces a incidencias equivocadas, datos obsoletos y conclusiones sin respaldo. Añade vista previa, aprobación y registro duradero antes de permitir al asistente modificar un gestor real.
- Examina qué trabajo se trasladó. Compara trabajo aceptado, tiempo de revisión, uso activo y facturas reales. Añade mantenimiento de equipos, tiempos de caída y cambios de conectores. Incluye la ayuda de configuración directa. Si una aplicación funciona después de diez minutos de asistencia especializada por persona, aún tiene un coste de incorporación.
Si ya ejecutas un modelo local para desarrolladores, prueba en paralelo al tráfico habitual. Las colas aparecen cuando varias personas empiezan a la vez. Un servicio rápido para una sola consulta puede hacer esperar a tres personas. Para tareas urgentes, muestra el progreso y ofrece volver al procedimiento manual. El piloto sigue siendo utilizable mientras el equipo descubre qué cargas encajan.
El apéndice de Grayhat aporta cifras para la comparación. El equipo de herramientas usaba 16 GB de memoria de sistema. El equipo separado de inferencia tenía 32 GB y una RTX 4080 con 16 GB de VRAM. El equipo declara que añadió supervisión de red, planificación de tareas y un sistema de alimentación ininterrumpida al identificar necesidades de operación. Son datos útiles al presupuestar el piloto. Describen el coste de mantener un servicio del que dependen los compañeros, además de conseguir que el modelo responda.
Decide dónde invertir la próxima hora de trabajo con IA
La idea reutilizable consiste en separar la preparación de contexto del razonamiento especializado y asignar un responsable a cada traspaso. Empieza con un trabajo repetido cuyo resultado el equipo ya sepa revisar. Mide cuánto cuesta aceptarlo y decide si la vía local merece otra tarea. La experiencia de Grayhat permite tomar esa decisión y conservar las herramientas de programación que aún aportan valor.
Fuentes
- Prepublicación de Grayhat Developers, 5 de noviembre de 2026
- Artículo completo con estimaciones, infraestructura y figura 2
- Imagen original de la figura 2
- Licencia CC BY 4.0 de la figura

Para guardar las conversaciones de un traspaso en un registro en el que puedas buscar, crea una cuenta de Telli.sh.