Granite Switch 4.1: od angielskiej wypowiedzi do użytecznej decyzji
Wypróbuj Granite Switch 4.1, a następnie zbuduj praktyczny proces czatu, transkrypcji angielskiej mowy i podejmowania decyzji z realistyczną konfiguracją oraz wskazówkami o pamięci, prywatności i kosztach.
Obsługa wypowiedzianego polecenia wymaga zwykle trzech różnych zadań: rozpoznania słów, wyjaśnienia ich znaczenia i zdecydowania, co zrobić dalej. Granite Switch 4.1 udostępnia te możliwości za pośrednictwem jednego endpointu, zamiast wymagać składania trzech niezależnych serwerów modeli.
W ogłoszeniu z 15 października 2026 r. IBM przedstawił gotowe kompozycje w wersjach 8B i 30B, obejmujące czat, ogólny adapter decyzyjny, kontrolę bezpieczeństwa Guardian i rozpoznawanie mowy. Praktyczną zaletą jest krótsza droga od angielskiej notatki głosowej do działania, które można sprawdzić. Artykuł IBM o premierze, 15 października 2026 r..
Przewodnik zaczyna się od krótkiego ćwiczenia w przeglądarce, potem pokazuje lokalną konfigurację i trzy realistyczne przepływy pracy. Dowiesz się też, gdzie przebiegają istotne granice: angielski dźwięk to nie dźwięk wielojęzyczny, wynik decyzji nie jest dowodem, a wagi modelu nie wyczerpują budżetu pamięci GPU.
Grafika nagłówkowa: oryginalny schemat redakcyjny, w którym angielska wypowiedź staje się transkrypcją, a następnie rozgałęzia się na odpowiedź czatu, opcje decyzji i kontrolę bezpieczeństwa. Przed końcowym działaniem następuje weryfikacja przez człowieka; to nie jest oficjalny zrzut ekranu ani deklaracja wydajności.
Uzyskaj pierwszy użyteczny wynik, zanim cokolwiek zainstalujesz
Zacznij od oficjalnego demo Speech to Decisions. IBM podlinkowuje je w ogłoszeniu z 15 października; dokumentacja samego demo opisuje nagrywanie na żywo, krótki opis tematu, kontrole bezpieczeństwa i oceny „tak/nie”. Oficjalna dokumentacja demo, sprawdzona 18 października 2026 r..
-
Otwórz demo i użyj wyłącznie wymyślonych, niesensytywnych informacji. To usługa hostowana, a nie przetwarzanie lokalne.
-
Jeśli aplikacja działa, zezwól na dostęp do mikrofonu i wypowiedz poniższe zdania po angielsku, czyli w obsługiwanym języku ASR:
Zwykły tekstThe replacement keyboard arrived damaged. Please send a new one. I can share a photo tomorrow. -
Zatrzymaj nagrywanie i porównaj wyświetloną transkrypcję z wypowiedzianymi słowami. Osobno sprawdź opis tematu i dostępne flagi oceny.
-
Upewnij się, że zachowały się prośba, uszkodzony przedmiot i obiecana dalsza czynność. Wiarygodna etykieta tematu nie oznacza sukcesu, jeśli transkrypcja zgubiła przeczenie albo zmieniła przedmiot.
To przydatny pierwszy punkt kontrolny: jedno zrozumiałe wejście i wyniki, które możesz sprawdzić. Nie jest to obietnica dokładnego brzmienia, opóźnień ani nieprzerwanej dostępności demo. Jeśli Space nie działa albo organizacja zabrania przesyłania dźwięku na zewnątrz, przejdź do lokalnej konfiguracji poniżej i nie wysyłaj prywatnych materiałów gdzie indziej.
Co właściwie przełącza Switch?
Bazowy model językowy obsługuje zwykły czat. Adapter to mniejszy zestaw wyuczonych modyfikacji, który specjalizuje model w danym zadaniu. Adapter decision wybiera spośród opisanych opcji; guardian-core sprawdza tekst pod kątem określonych zagrożeń bezpieczeństwa. Aplikacja wybiera adapter przez szablon czatu, zamiast ładować drugi kompletny model językowy. Repozytorium Granite Switch, sprawdzone 18 października 2026 r..
Rozpoznawanie mowy przebiega inną ścieżką. Automatyczne rozpoznawanie mowy, czyli ASR, zamienia przebieg dźwiękowy na tekst, który następnie odczytuje model językowy. Dołączony rozpoznawacz to angielski model IBM Granite Speech TurboCTC o 470 mln parametrów, sprawdzony 18 października 2026 r.. Potraktuj transkrypcję jak potwierdzenie przekazania: wszystko, co dzieje się dalej, zależy od zapisanych w niej słów. Zachowaj ją obok podsumowania po redakcji, aby można było prześledzić wątpliwą decyzję aż do danych wejściowych.
| Punkt kontrolny | Stan i zalecany punkt startowy | Oczekiwania wobec dźwięku |
|---|---|---|
granite-switch-4.1-8b | Wydany; mniejsza gotowa kompozycja | Zawiera angielski ASR |
granite-switch-4.1-30b | Wydany; większy model bazowy z tym samym pakietem możliwości | Zawiera angielski ASR |
granite-switch-4.1-3b-preview | Wersja zapoznawcza z innym pakietem adapterów | To nie jest wydany wariant z obsługą mowy |
Karta modelu 8B, wydana 14 października 2026 r. odróżnia wydania obsługujące dźwięk od rodziny podglądowej bez audio. Karta 30B i karta podglądowej wersji 3B, sprawdzone 18 października, opisują odpowiednie kompozycje. Mniejszy model preview nie jest zamiennikiem do rozpoznawania mowy.
Karta 8B wymienia 12 języków czatu: angielski, niemiecki, hiszpański, francuski, japoński, portugalski, arabski, czeski, włoski, koreański, niderlandzki i chiński. Ta lista nie rozszerza domyślnego rozpoznawania mowy poza angielski.
Zanim skopiujesz polecenia, wybierz system operacyjny
Do opisanej tu konfiguracji CUDA/vLLM wybierz Linuksa ze zgodnym GPU NVIDIA i sterownikiem. W Windows użyj poprawnie skonfigurowanego WSL z dostępem do GPU; te polecenia Bash nie są natywnymi poleceniami PowerShell. Na macOS zacznij od hostowanego ćwiczenia albo hosta z GPU Linux, zamiast zakładać, że ten przepis CUDA działa na Apple Silicon. Wskazówki vLLM dotyczące instalacji GPU, sprawdzone 18 października 2026 r..
vLLM-Metal i inne środowiska mają własne ścieżki zgodności. Obsługa danego systemu operacyjnego przez środowisko nie dowodzi, że działa w nim dokładnie ten checkpoint Switch wraz z adapterami i kaskadą mowy. Przed wyborem tej drogi wymagaj zgodnego przykładu.
Uruchom lokalnie czat, a potem dodaj dźwięk i decyzje
W terminalu Bash w Linuksie lub WSL użyj nowego folderu roboczego. Najpierw zainstaluj Git i Python 3.12 oraz sprawdź, czy nvidia-smi widzi GPU. Wykorzystany tu snapshot repozytorium wymaga Pythona >=3.11,<3.14, PyTorch >=2.11.0, Transformers >=5.16,<=5.17.0 i vLLM >=0.26.0,<0.31.0. Deklaracje pakietu w rewizji 7e72456, sprawdzone 18 października 2026 r..
- Zainstaluj pakiet Switch i zależności audio razem. Ta konfiguracja przypina przepis ze źródła, zamiast polegać na starszym opublikowanym wheelu.
git clone https://github.com/generative-computing/granite-switch.git
cd granite-switch
git checkout 7e724560f9a9449bba2f08e16e8678c4dd6a06e7
python3.12 -m venv .venv
source .venv/bin/activate
python -m pip install --upgrade pip
python -m pip install -e '.[vllm,audio]' openai
python -m pip check
Dodatki są zależne od zadania: [hf] dodaje obsługę inferencji Hugging Face, [compose] — narzędzia kompozycji, a [audio] pobiera zależności dekodowania dźwięku vLLM. Samo zainstalowanie vllm nie instaluje wtyczki Switch. Zachowaj zgodność rozwiązanego zestawu PyTorch/CUDA ze sterownikiem; nie naprawiaj błędu resolvera przez usuwanie kontroli zależności. Pierwsze użycie pobiera wagi modelu, więc przed rozpoczęciem nagrywania zapewnij czas na przygotowanie oraz miejsce na checkpointy.
- Uruchom jeden serwer dostępny tylko lokalnie. Limity kontekstu i współbieżności poniżej są ostrożnymi ustawieniami początkowymi, a nie gwarancją, że model zmieści się na danym sprzęcie.
VLLM_PLUGINS=register_granite_switch \
python -m vllm.entrypoints.openai.api_server \
  --model ibm-granite/granite-switch-4.1-8b \
  --host 127.0.0.1 --port 8000 \
  --max-model-len 4096 --max-num-seqs 1 \
  --gpu-memory-utilization 0.80 --enable-prefix-caching
Pakiet rejestruje register_granite_switch w vllm.general_plugins. vLLM odnajduje zainstalowane entry pointy; zmienna środowiskowa jawnie wybiera tę wtyczkę. W tym przepisie nie potrzeba kopiowanego skryptu rejestracji ani obejścia --trust-remote-code. Kod rejestracji Switch i system wtyczek vLLM, sprawdzone 18 października 2026 r.
- Sprawdź zwykłą odpowiedź czatu. W drugim terminalu Bash poczekaj na gotowość serwera, a potem uruchom:
curl --fail http://127.0.0.1:8000/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -d '{"model":"ibm-granite/granite-switch-4.1-8b","messages":[{"role":"user","content":"Rewrite this request clearly without adding facts: The replacement keyboard arrived damaged. Please send a new one."}],"max_tokens":120,"temperature":0}'
Odczytaj wiadomość asystenta w odpowiedzi JSON. Sukces oznacza zachowanie prośby bez wymyślania numeru zamówienia, terminu ani zgody na zwrot pieniędzy. Sama odpowiedź HTTP nie jest kontrolą użyteczności wyniku.
- Wyślij krótki angielski plik WAV. Umieść w folderze repozytorium niesensytywne nagranie, na którego przetwarzanie uzyskano zgodę, i nazwij je
request.wav. W drugim terminalu aktywuj to samo środowisko wirtualne, zapisz poniższy skrypt jakotry_audio.pyi uruchompython try_audio.py.
import base64
from pathlib import Path
from openai import OpenAI

audio_bytes = Path("request.wav").read_bytes()
message_parts = [
    {"type": "text", "text": "List the requests in this recording. Do not add facts."},
    {"type": "input_audio", "input_audio": {
        "format": "wav",
        "data": base64.b64encode(audio_bytes).decode("ascii"),
    }},
]
local = OpenAI(api_key="unused", base_url="http://127.0.0.1:8000/v1")
reply = local.chat.completions.create(
    model="ibm-granite/granite-switch-4.1-8b",
    messages=[{"role": "user", "content": message_parts}],
    max_tokens=160,
    temperature=0,
)
print(reply.choices[0].message.content)
Wynikiem jest odpowiedź modelu językowego oparta na wewnętrznie wstawionej transkrypcji, a nie niezmieniony eksport ASR. Przewodnik audio opisuje kaskadę i format wejściowy; gdy potrzebujesz niezależnie kontrolować oba etapy, użyj aplikacji udostępniającej transkrypcję. Dokumentacja audio, sprawdzona 18 października 2026 r..
- Wypróbuj jedną ograniczoną decyzję na sprawdzonym tekście. Pozostaw serwer uruchomiony i wyślij:
curl --fail http://127.0.0.1:8000/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -d '{"model":"ibm-granite/granite-switch-4.1-8b","messages":[{"role":"user","content":"State:\nThe replacement keyboard arrived damaged. Please send a new one."},{"role":"user","content":"### DECISION\nQuestion:\nWhich queue should review this request?\n\nOptions:\nA: Damaged-item replacements\nB: Account access\nC: Human triage because neither category fits\n\nReply with exactly one option label."}],"chat_template_kwargs":{"adapter_name":"decision"},"max_tokens":1,"temperature":0}'
To ćwiczy wybór adaptera i prosi o jedną etykietę, a nie raport prawdopodobieństwa. Aby uzyskać prawdopodobieństwa, skorzystaj z przykładu decyzji na karcie modelu, sprawdzonego 18 października 2026 r.: zweryfikuj etykiety jednoznakowe, poproś o ich logprob_token_ids i znormalizuj wartości pośród kandydatów. Dokumentacja odczytu adaptera decyzji, sprawdzona 18 października objaśnia softmax na poziomie opcji. Nie zastępuj go zdaniem czatu „mam 95% pewności”.
Zadbaj, by trzy przepływy pracy dało się sprawdzić, a nie tylko zautomatyzować
Poniższe zastosowania są przykładami, a nie opisami przeprowadzonych testów. Zacznij od wyników, które ułatwiają komuś kontrolę; konsekwentne działania dodawaj dopiero po ocenie reprezentatywnych przypadków.
Przekierowanie głosowej wiadomości klienta. Użyj ASR, by przechwycić prośbę, czatu do przygotowania neutralnego podsumowania, a pytania decyzyjnego do wyboru między wymianą, pomocą dotyczącą konta i ręczną weryfikacją. Zachowaj oryginalny dźwięk powiązany ze sprawdzoną transkrypcją. Prośba „nie anulujcie mojego zamówienia” powinna być celowym przypadkiem testowym, a nie refleksją dopiero po wdrożeniu automatycznego anulowania.
Kryterium akceptacji jest konkretne: czy wybrana kolejka pasuje do rzeczywistych słów i czy pracownik obsługi może ją skorygować, zanim cokolwiek zostanie wysłane? Flaga bezpieczeństwa może poprosić o dodatkową kontrolę, ale nie powinna po cichu odrzucać skargi zirytowanego klienta.
Przekształcenie aktualizacji projektu w szkic zadania. Wyobraź sobie angielskie nagranie, w którym współpracownik mówi: „I can review the draft Friday, but I cannot approve the budget.” Poproś czat o oddzielenie zobowiązań od wyłączeń, a potem zapytaj adapter decyzyjny, czy zatwierdzenie budżetu jest obecne, nieobecne czy niejasne. Zachowaj opcję „niejasne”, gdy nagranie lub kontekst są niewystarczające. Zanim zadanie trafi do wspólnego rejestru, człowiek sprawdza datę i odpowiedzialność.
Przygotowanie listy pytań po rozmowie. Za zgodą rozmówcy transkrybuj krótki angielski fragment wywiadu i przygotuj pytania o brakujące szczegóły. Używaj ograniczonych decyzji w rodzaju „Czy w tym fragmencie wyraźnie podano datę dostawy?”, zamiast „Czy tej osobie można ufać?”. Zachowaj fragment uzasadniający każdą flagę. Dzięki temu rozbieżność można wyjaśnić bez traktowania interpretacji modelu jako oceny rozmówcy.
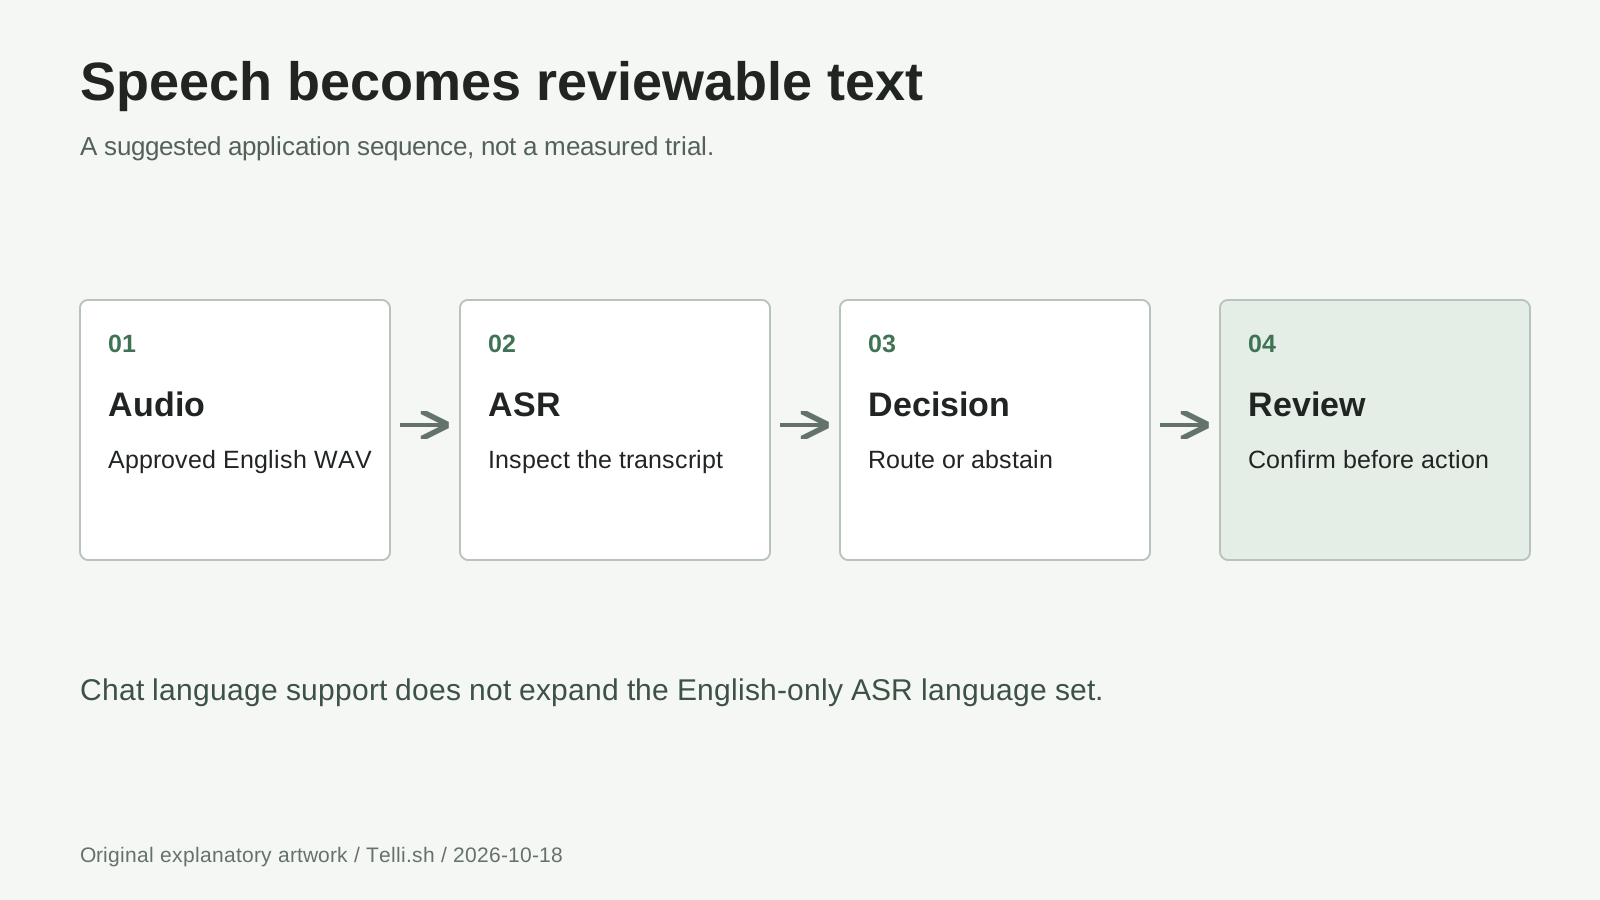
Oryginalny schemat przepływu: zachowaj dźwięk i transkrypcję, generuj osobne wyniki pochodne, a przed działaniem przeprowadź weryfikację. Ilustruje opisane zastosowania, nie oficjalny interfejs; podstawową kaskadę opisuje przewodnik audio, sprawdzony 18 października 2026 r.
Dlaczego kilka możliwości może współdzielić ten sam kontekst?
Pamięć podręczna klucz-wartość przechowuje informacje uwagi obliczone dla wcześniejszych tokenów. Aktywowane LoRA, czyli aLoRA, pozwala specjaliście uaktywnić się po wspólnym kontekście, zamiast — jak w typowym przypadku adaptera — ponownie przetwarzać cały prefiks. IBM przedstawił tę metodę w objaśnieniu badawczym z 17 kwietnia 2025 r. IBM Research o aLoRA.
Switch używa znormalizowanego stanu pamięci podręcznej modelu bazowego, dzięki czemu wyspecjalizowane adaptery nie korzystają ze swoich prywatnych stanów po adaptacji. W aplikacji zachowaj identyczny prefiks dowodowy i dopisz pytanie właściwe dla zadania. Przepisanie transkrypcji inaczej na potrzeby każdej kontroli niweczy ponowne użycie prefiksu. Dokumentacja mechanizmu Switch, sprawdzona 18 października 2026 r..
Wspólna pamięć podręczna to mechanizm wydajności, a nie darmowa inferencja. Buforowanie prefiksu oszczędza ponowne przetwarzanie powtarzającego się promptu, ale nie eliminuje generowania odpowiedzi ani rozpoznawania mowy. Dokumentacja vLLM dotycząca buforowania prefiksów, sprawdzona 18 października 2026 r.. Nasza konkluzja: porównuj kompletne przepływy z weryfikacją, a nie wyizolowane nagłówkowe wyniki szybkości.
Planuj koszty całego obciążenia, nie tylko wag 8B
W uproszczonym rachunku planistycznym 8 miliardów parametrów po dwa bajty zajmuje około 16 GB, czyli 14,9 GiB; 30 miliardów — około 60 GB, czyli 55,9 GiB. To przykładowe obliczenia dla wag bazowych, a nie rozmiary checkpointów ani minimalne wymagania VRAM. Nie obejmują adapterów, enkodera mowy, pamięci podręcznej, buforów tymczasowych ani narzutu środowiska.
Dłuższy kontekst i większa liczba równoległych sekwencji zwiększają presję na pamięć. Reklamowany limit kontekstu modelu nie oznacza, że warto rezerwować go w całości do pierwszego eksperymentu. Dokumentacja vLLM wskazuje zmniejszenie max_model_len i max_num_seqs jako sposoby ograniczania zużycia pamięci. Wskazówki vLLM dotyczące pamięci, sprawdzone 18 października 2026 r..
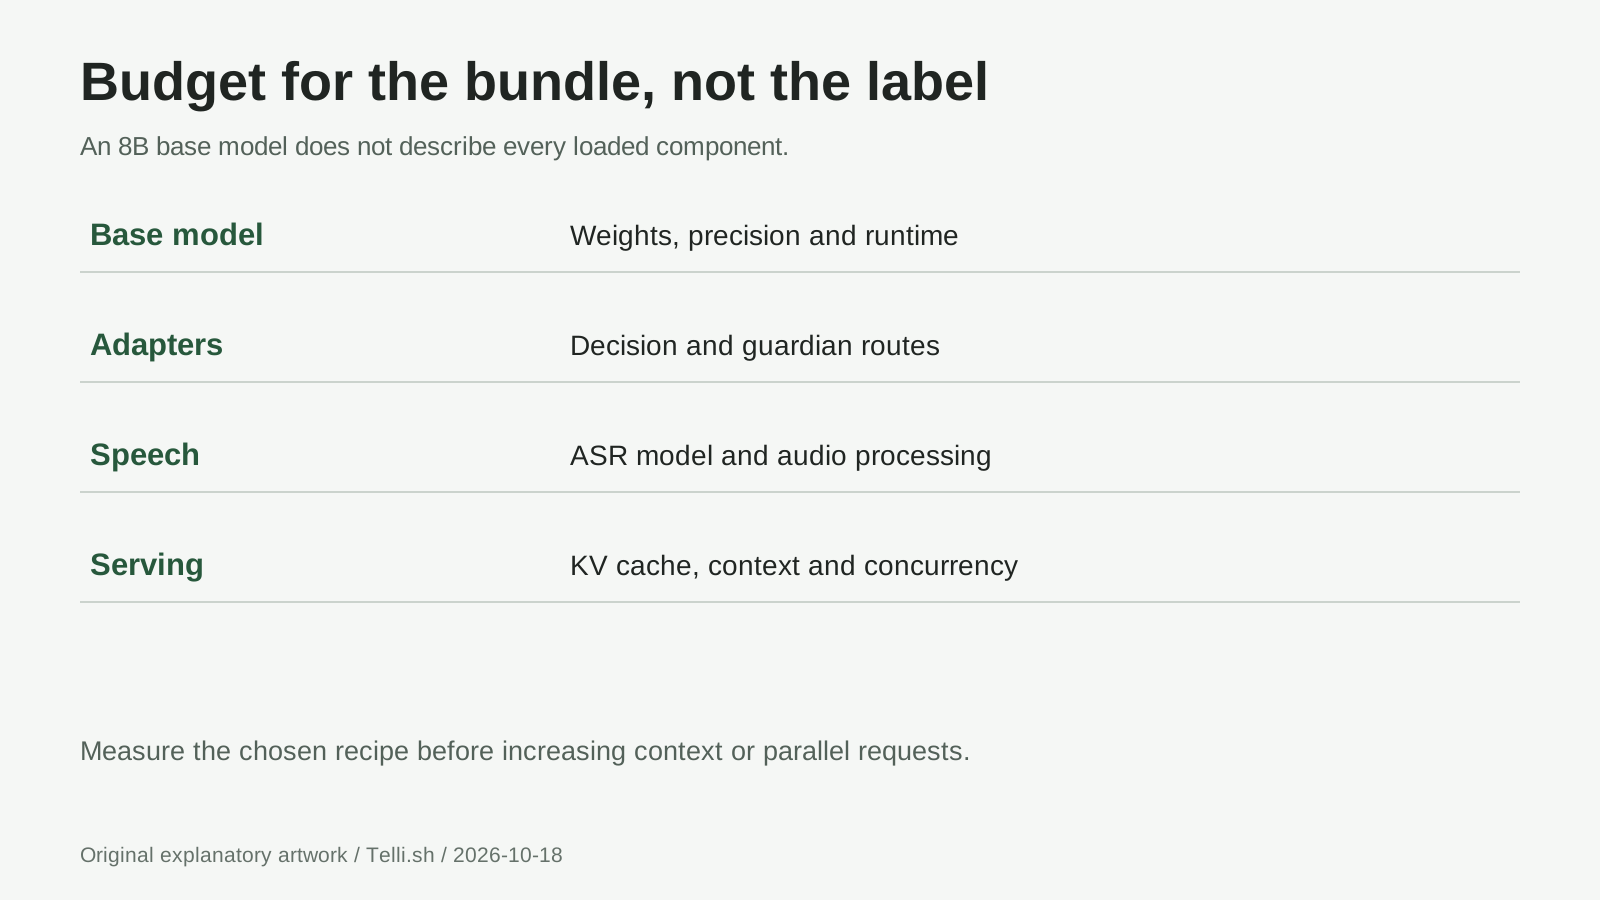
Oryginalna lista kontrolna pamięci, nie proporcjonalny podział: wagi bazowe + adaptery + wagi i aktywacje ASR + pamięć KV + zapas środowiska i wyświetlania. Przewodnik audio ostrzega, że wstępna alokacja pamięci podręcznej może pozostawić za mało miejsca na ASR; sprawdzono 18 października 2026 r.
Osobno przetestuj krótki czat, krótki klip i najdłuższe zwykłe wejście. Zapisuj zaobserwowany szczyt pamięci, czas ukończenia i błędy. Ograniczenie przydziału pamięci podręcznej może zostawić więcej miejsca na mowę, ale nie sprawi, że zbyt duże wagi się zmieszczą. Alternatywa kwantyzowana wymaga osobnego sprawdzenia zgodności z adapterami Switch i dźwiękiem, a nie tylko oceny mniejszego pobrania.
Uwzględnij koszty i prywatność w wyborze wdrożenia
Licencja Apache-2.0 na model nie sprawia, że jego obsługa jest bezkosztowa. Użycie lokalne pochłania zasoby sprzętowe, prąd, miejsce i czas na utrzymanie; hostowany endpoint dodaje opłaty dostawcy i warunki przetwarzania danych. Nie zakładaj jednej uniwersalnej stawki Granite Switch za minutę. W pilotażu podziel pełne koszty obliczeń i weryfikacji przez liczbę pomyślnie ukończonych elementów, uwzględniając nieudane żądania i poprawki.
Prosty hipotetyczny budżet pokazuje skalę: 10 godzin po 1 USD za godzinę to 10 USD za obliczenia, przed kosztami przechowywania, transferu i ludzkiej kontroli. To przykładowe dane, a nie cytowana cena usługi. Liczą się także godziny bezczynności endpointu.
W przypadku wrażliwych zadań przed nagrywaniem zdecyduj, gdzie będą przechowywane dźwięk, transkrypcje, pamięci podręczne, logi i kopie zapasowe. Nasłuchiwanie wyłącznie na loopback ogranicza dostęp sieciowy, ale nie ustala zasad retencji ani nie wyłącza całej telemetrii bibliotek. Nie wystawiaj serwera publicznie, sprawdzaj zależności i logowanie, uzyskaj zgodę rozmówców oraz osobno określ zasady usuwania źródłowego dźwięku i danych pochodnych. Hostowane demo nadaje się do nauki, ale nie powinno być domyślnym miejscem dla poufnych spotkań.
Napraw wadliwy etap, zanim zmienisz cały stos
Nieznana architektura. Sprawdź, czy środowisko wirtualne zawiera granite-switch, czy vLLM używa tego środowiska oraz czy VLLM_PLUGINS uwzględnia register_granite_switch. Zanim wymienisz pakiety, odczytaj pierwszy błąd importu wtyczki.
Czat działa, ale dźwięk nie. Potwierdź identyfikator wydania obsługującego audio, zależności [audio] i prawdziwy WAV zamiast pliku tylko przemianowanego na WAV. Sprawdź wersję Transformers i dostępną pamięć. Instalacja bibliotek dekodujących nie zmieni tekstowego wariantu preview w checkpoint obsługujący audio.
Błędne nazwy lub interpunkcja. Domyślny angielski rozpoznawacz CTC zwraca małe litery i tekst bez interpunkcji; nie pozwala sterować językiem w czasie dekodowania. Zachowaj surowy tekst; przywracanie interpunkcji jest zmianą pochodną. Kaskada może przenieść błędy transkrypcji do późniejszych decyzji. Ograniczenia audio, sprawdzone 18 października 2026 r..
Długi klip przekracza kontekst. Skróć wejście lub podziel je na sensowne fragmenty, zachowując odwołania do źródła. Transkrypcja zajmuje kontekst tekstowy; musi zostać dość miejsca na pytanie i odpowiedź. Zwiększenie limitu kontekstu zmienia też budżet pamięci.
Co warto wiedzieć, zanim zaczniesz polegać na modelu?
Czy potrafi wypowiadać odpowiedzi na głos? Dołączona ścieżka mowy to ASR, a nie synteza mowy. Aplikacja generująca głos potrzebuje osobnego komponentu TTS.
Czy może transkrybować wszystkie 12 języków czatu? Nie przy użyciu domyślnego rozpoznawacza angielskiego. Przewodnik audio opisuje wymianę backendu ASR na obsługujący wiele języków; to inna konfiguracja, którą trzeba ocenić.
Czy prawdopodobieństwo opcji 0,95 oznacza 95% poprawności w rzeczywistym użyciu? Nie. Opisuje rozkład modelu wśród podanych możliwości, a nie zweryfikowany wskaźnik sukcesu w twojej domenie. Brakujące opcje, błędna transkrypcja i niejednoznaczne pytania mogą nadal prowadzić do silnej preferencji. Zanim zautomatyzujesz działania, oceń oznakowane przykłady i ustal reguły wstrzymania decyzji. Dokumentacja adaptera decyzji, sprawdzona 18 października 2026 r..
Czy Guardian dowodzi prawdziwości odpowiedzi? Nie. Kontrola bezpieczeństwa różni się od weryfikacji faktów. Gotowa kompozycja nie zawiera każdego specjalisty z szerszego zbioru Granite Libraries; przed projektowaniem procesu weryfikacji faktów sprawdź wykaz adapterów.
Konkluzja: jeden endpoint nadal potrzebuje ścieżki dowodowej
Granite Switch 4.1 jest najbardziej przydatny, gdy czat wyjaśnia, mowa dostarcza tekst do sprawdzenia, a ograniczone decyzje porządkują dalsze działania. Modularny sposób serwowania ogranicza powielanie infrastruktury; zgoda, dowody i uprawnienie do działania nadal należą do twojego przepływu pracy.
Zacznij od jednego krótkiego nagrania i jednej odwracalnej decyzji. Rozwijaj proces tylko wtedy, gdy transkrypcja, interpretacja i działanie pozostają zrozumiałe dla osoby odpowiedzialnej za wynik.
Źródła
Daty wydań: artykuł premierowy IBM pochodzi z 15 października 2026 r.; karta modelu 8B podaje 14 października 2026 r. Podlinkowaną dokumentację sprawdzono 18 października 2026 r. Instrukcje konfiguracji opracowano na podstawie źródeł pierwotnych; nie są wynikami testów wydajnościowych. Diagramy to oryginalne schematy redakcyjne; obrazy dostawców nie są reprodukowane.
- Artykuł premierowy IBM, karta modelu 8B, karta modelu 30B i karta preview 3B: zakres wydania i różnice między checkpointami.
- Repozytorium Granite Switch, przypięte wymagania pakietu i przewodnik audio: instalacja, architektura i ograniczenia mowy.
- Oficjalne demo mowy, dokumentacja demo i oficjalny notebook porównujący aLoRA: materiały do poznania, a nie wyniki pomiarów z tego przewodnika.
- Objaśnienie aLoRA IBM z 17 kwietnia 2025 r. i dokumentacja vLLM: opisane mechanizmy i wymagania operacyjne.
Opcjonalna rekomendacja Telli.sh: zachowaj źródła stojące za decyzją
Zachowuj oryginalne nagrania, notatki i sprawdzone wyniki razem, aby późniejsze decyzje miały kontekst. Utwórz konto Telli.sh, by porządkować materiały referencyjne w miarę rozwoju procesu.