Granite Switch 4.1: dall'inglese parlato a una decisione utile
Prova Granite Switch 4.1 e crea un flusso pratico per chat, trascrizione inglese e decisioni, con indicazioni realistiche su configurazione, memoria, privacy e costi.
Una richiesta pronunciata di solito richiede tre tipi di lavoro: riconoscere le parole, spiegarne il significato e decidere cosa fare. Granite Switch 4.1 raccoglie queste capacità dietro un unico endpoint, invece di chiederti di assemblare tre server di modelli indipendenti.
L'annuncio IBM del 15 ottobre 2026 ha presentato le versioni pronte e composte da 8B e 30B, con chat, un adattatore decisionale generale, il controllo di sicurezza Guardian e il riconoscimento vocale. Il vantaggio pratico è abbreviare il percorso da una nota vocale inglese a un'azione verificabile. Articolo di lancio IBM, 15 ottobre 2026.
Questa guida parte da un piccolo esercizio nel browser, poi mostra una configurazione locale e tre flussi realistici. Vedrai anche dove contano i limiti: l'audio inglese non equivale ad audio multilingue, un punteggio decisionale non è una prova e i pesi del modello non rappresentano tutto il budget di memoria della GPU.
Immagine principale: schema editoriale originale in cui l'audio inglese diventa trascrizione, poi si dirama in risposta di chat, opzioni decisionali e controllo di sicurezza. L'azione finale passa dalla revisione umana; non è uno screenshot ufficiale né un'affermazione prestazionale.
Ottieni un primo risultato utile prima di installare alcunché
Parti dalla demo ufficiale Speech to Decisions. IBM la collega all'annuncio del 15 ottobre; la documentazione della demo descrive input dal microfono dal vivo, breve descrizione di un argomento, controlli di sicurezza e giudizi sì/no. Documentazione ufficiale della demo, verificata il 18 ottobre 2026.
-
Apri la demo e usa soltanto contenuti inventati e non sensibili. È un servizio ospitato, non un'elaborazione locale.
-
Se l'app è disponibile, consenti l'accesso al microfono e pronuncia quanto segue in inglese, la lingua supportata dall'ASR:
Testo sempliceThe replacement keyboard arrived damaged. Please send a new one. I can share a photo tomorrow. -
Interrompi la registrazione e confronta la trascrizione mostrata con ciò che hai detto. Esamina separatamente la descrizione dell'argomento e gli eventuali indicatori di giudizio.
-
Verifica che siano rimasti intatti la richiesta, l'oggetto danneggiato e il seguito promesso. Un'etichetta plausibile dell'argomento non è un successo se la trascrizione ha perso una negazione o cambiato l'oggetto.
Questo è un primo controllo utile: un input comprensibile e risultati che puoi ispezionare. Non garantisce formulazione esatta, latenza o disponibilità continua della demo. Se lo Space non è disponibile o la tua organizzazione vieta il caricamento di audio esterno, passa al percorso locale qui sotto senza inviare altrove materiale privato.
Che cosa cambia davvero lo switch?
Il modello linguistico di base gestisce la chat ordinaria. Un adattatore è un insieme più piccolo di modifiche apprese che specializza il modello per un compito. L'adattatore decision sceglie tra opzioni etichettate; guardian-core controlla il testo per specifici rischi di sicurezza. L'applicazione seleziona l'adattatore tramite il modello di chat, invece di caricare un secondo modello linguistico completo. Repository Granite Switch, verificato il 18 ottobre 2026.
Il parlato segue un percorso diverso. Il riconoscimento automatico del parlato, o ASR, converte la forma d'onda in testo prima che il modello linguistico la legga. Il riconoscitore incluso è il modello inglese IBM Granite Speech TurboCTC da 470M parametri, verificato il 18 ottobre 2026. Considera quella trascrizione la ricevuta del passaggio: tutto ciò che viene dopo dipende dalle parole registrate lì. Conservala insieme a ogni riepilogo ripulito, così chi legge può risalire dall'esito dubbio all'input.
| Checkpoint | Stato e punto di partenza previsto | Aspettative sull'audio |
|---|---|---|
granite-switch-4.1-8b | Rilasciato; opzione pronta e composta più piccola | ASR inglese incluso |
granite-switch-4.1-30b | Rilasciato; modello base più grande con lo stesso pacchetto di capacità | ASR inglese incluso |
granite-switch-4.1-3b-preview | Anteprima con un pacchetto di adattatori diverso | Non è il pacchetto rilasciato con supporto al parlato |
La scheda del modello 8B, pubblicata il 14 ottobre 2026, distingue le versioni abilitate all'audio dalla famiglia di anteprima senza audio. La scheda 30B e quella dell'anteprima 3B, verificate il 18 ottobre, descrivono le rispettive composizioni. Un'anteprima più piccola non sostituisce direttamente una versione che supporta il parlato.
La scheda 8B elenca 12 lingue per la chat: inglese, tedesco, spagnolo, francese, giapponese, portoghese, arabo, ceco, italiano, coreano, olandese e cinese. Questo elenco non estende oltre l'inglese il riconoscitore vocale predefinito.
Scegli il sistema operativo prima di copiare i comandi
Per la configurazione CUDA/vLLM qui descritta, scegli Linux con GPU NVIDIA e driver compatibili. Su Windows usa WSL configurato correttamente con accesso alla GPU: questi comandi Bash non sono comandi PowerShell nativi. Su macOS, parti dall'esercizio ospitato o da un host Linux con GPU, invece di presumere che questa ricetta CUDA valga anche per Apple Silicon. Indicazioni d'installazione GPU vLLM, verificate il 18 ottobre 2026.
vLLM-Metal e altri runtime hanno percorsi di compatibilità propri. Il fatto che un runtime supporti il tuo sistema operativo non dimostra che funzionino lì questo checkpoint Switch, i suoi adattatori e l'intera catena vocale. Prima di scegliere quel percorso, cerca un esempio corrispondente.
Parti localmente dalla chat, poi aggiungi audio e decisioni
Usa una nuova cartella di lavoro in un terminale Linux o Bash su WSL. Installa prima Git e Python 3.12 e verifica che nvidia-smi rilevi la GPU. Lo snapshot del repository usato qui richiede Python >=3.11,<3.14, PyTorch >=2.11.0, Transformers >=5.16,<=5.17.0 e vLLM >=0.26.0,<0.31.0. Dichiarazioni dei pacchetti alla revisione 7e72456, verificate il 18 ottobre 2026.
- Installa insieme il pacchetto Switch e le dipendenze audio. In questo modo usi la ricetta sorgente fissata, invece di dipendere da una wheel pubblicata in precedenza.
git clone https://github.com/generative-computing/granite-switch.git
cd granite-switch
git checkout 7e724560f9a9449bba2f08e16e8678c4dd6a06e7
python3.12 -m venv .venv
source .venv/bin/activate
python -m pip install --upgrade pip
python -m pip install -e '.[vllm,audio]' openai
python -m pip check
Gli extra dipendono dal compito: [hf] aggiunge il supporto all'inferenza Hugging Face, [compose] gli strumenti di composizione e [audio] le dipendenze di decodifica audio di vLLM. Installare soltanto vllm non installa il plugin Switch. Mantieni la combinazione risolta di PyTorch/CUDA compatibile con il driver; non risolvere un errore del resolver eliminando i controlli sulle dipendenze. Al primo avvio vengono scaricati i pesi del modello: prevedi tempo di configurazione e spazio disco per i checkpoint prima di iniziare una registrazione.
- Avvia un solo server accessibile tramite loopback. I limiti di contesto e concorrenza seguenti sono valori iniziali prudenti, non una garanzia di compatibilità con l'hardware.
VLLM_PLUGINS=register_granite_switch \
python -m vllm.entrypoints.openai.api_server \
  --model ibm-granite/granite-switch-4.1-8b \
  --host 127.0.0.1 --port 8000 \
  --max-model-len 4096 --max-num-seqs 1 \
  --gpu-memory-utilization 0.80 --enable-prefix-caching
Il pacchetto registra register_granite_switch in vllm.general_plugins. vLLM rileva gli entry point installati; la variabile d'ambiente seleziona esplicitamente questo plugin. Per questa ricetta non serve copiare uno script di registrazione né usare la soluzione alternativa --trust-remote-code. Sorgente di registrazione Switch e sistema plugin vLLM, verificati il 18 ottobre 2026.
- Verifica una semplice risposta di chat. In un secondo terminale Bash, attendi che il server sia pronto, poi esegui:
curl --fail http://127.0.0.1:8000/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -d '{"model":"ibm-granite/granite-switch-4.1-8b","messages":[{"role":"user","content":"Rewrite this request clearly without adding facts: The replacement keyboard arrived damaged. Please send a new one."}],"max_tokens":120,"temperature":0}'
Leggi il messaggio dell'assistente nella risposta JSON. Il successo consiste nel preservare la richiesta senza inventare numero d'ordine, scadenza o approvazione di rimborso. Una risposta HTTP, da sola, non dimostra l'utilità del risultato.
- Invia un breve file WAV in inglese. Metti nella cartella del repository una registrazione autorizzata e non sensibile chiamata
request.wav. Attiva lo stesso ambiente virtuale nel secondo terminale, salva quanto segue cometry_audio.pyed eseguipython try_audio.py.
import base64
from pathlib import Path
from openai import OpenAI

audio_bytes = Path("request.wav").read_bytes()
message_parts = [
    {"type": "text", "text": "List the requests in this recording. Do not add facts."},
    {"type": "input_audio", "input_audio": {
        "format": "wav",
        "data": base64.b64encode(audio_bytes).decode("ascii"),
    }},
]
local = OpenAI(api_key="unused", base_url="http://127.0.0.1:8000/v1")
reply = local.chat.completions.create(
    model="ibm-granite/granite-switch-4.1-8b",
    messages=[{"role": "user", "content": message_parts}],
    max_tokens=160,
    temperature=0,
)
print(reply.choices[0].message.content)
Il risultato è una risposta del modello linguistico basata sulla trascrizione inserita internamente, non un'esportazione ASR non modificata. La guida audio descrive la catena e il formato di input; se vuoi ispezionare separatamente entrambe le fasi, usa un'applicazione che esponga la trascrizione. Documentazione audio, verificata il 18 ottobre 2026.
- Prova una decisione circoscritta su testo revisionato. Lascia il server in esecuzione e invia:
curl --fail http://127.0.0.1:8000/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -d '{"model":"ibm-granite/granite-switch-4.1-8b","messages":[{"role":"user","content":"State:\nThe replacement keyboard arrived damaged. Please send a new one."},{"role":"user","content":"### DECISION\nQuestion:\nWhich queue should review this request?\n\nOptions:\nA: Damaged-item replacements\nB: Account access\nC: Human triage because neither category fits\n\nReply with exactly one option label."}],"chat_template_kwargs":{"adapter_name":"decision"},"max_tokens":1,"temperature":0}'
Questo esercita la selezione dell'adattatore e chiede un'unica etichetta, non un rapporto di probabilità. Per ottenere probabilità, segui l'esempio decisionale della scheda del modello, verificato il 18 ottobre 2026: verifica le etichette a singolo token, richiedi i relativi logprob_token_ids e normalizza sui candidati. La documentazione di lettura dell'adattatore decisionale, verificata il 18 ottobre, spiega la softmax sulle opzioni. Non sostituirla con una frase generata dalla chat come «sono sicuro al 95%».
Rendi verificabili tre flussi, invece di automatizzarli e basta
Sono usi illustrativi, non prove riportate. Comincia con risultati che aiutino una persona a controllare il lavoro; aggiungi azioni con conseguenze soltanto dopo aver valutato casi rappresentativi.
Instrada un messaggio vocale di un cliente. Usa l'ASR per acquisire la richiesta, la chat per preparare un riepilogo neutrale e una domanda decisionale per scegliere tra sostituzione, assistenza sull'account e revisione umana. Mantieni collegato l'audio originale alla trascrizione revisionata. Una richiesta come «non annullare il mio ordine» dovrebbe diventare un caso di prova deliberato, non un ripensamento dopo aver creato l'automazione di annullamento.
Il criterio di accettazione è concreto: la coda selezionata corrisponde alle parole effettive e un addetto può correggerla prima che venga inviato alcunché? Un segnale di sicurezza può richiedere un controllo aggiuntivo, ma non dovrebbe eliminare silenziosamente il reclamo di un cliente frustrato.
Trasforma un aggiornamento di progetto in una bozza di attività. In una registrazione inglese, un collega dice: «I can review the draft Friday, but I cannot approve the budget» (Posso rivedere la bozza venerdì, ma non posso approvare il budget). Chiedi alla chat di separare impegni ed esclusioni, poi domanda all'adattatore se l'approvazione del budget è presente, assente o poco chiara. Mantieni disponibile «non chiaro» quando registrazione o contesto non bastano. Prima che l'attività entri in un tracker condiviso, una persona verifica data e responsabilità.
Prepara un elenco di domande di approfondimento per un'intervista. Con il consenso dell'interlocutore, trascrivi un breve estratto in inglese e prepara domande sui dettagli mancanti. Usa decisioni circoscritte, come «Questo passaggio indica esplicitamente una data di consegna?», non «Questa persona è affidabile?». Conserva l'estratto che giustifica ogni indicatore. Così un disaccordo si può risolvere senza trattare l'interpretazione del modello come un giudizio sull'interlocutore.
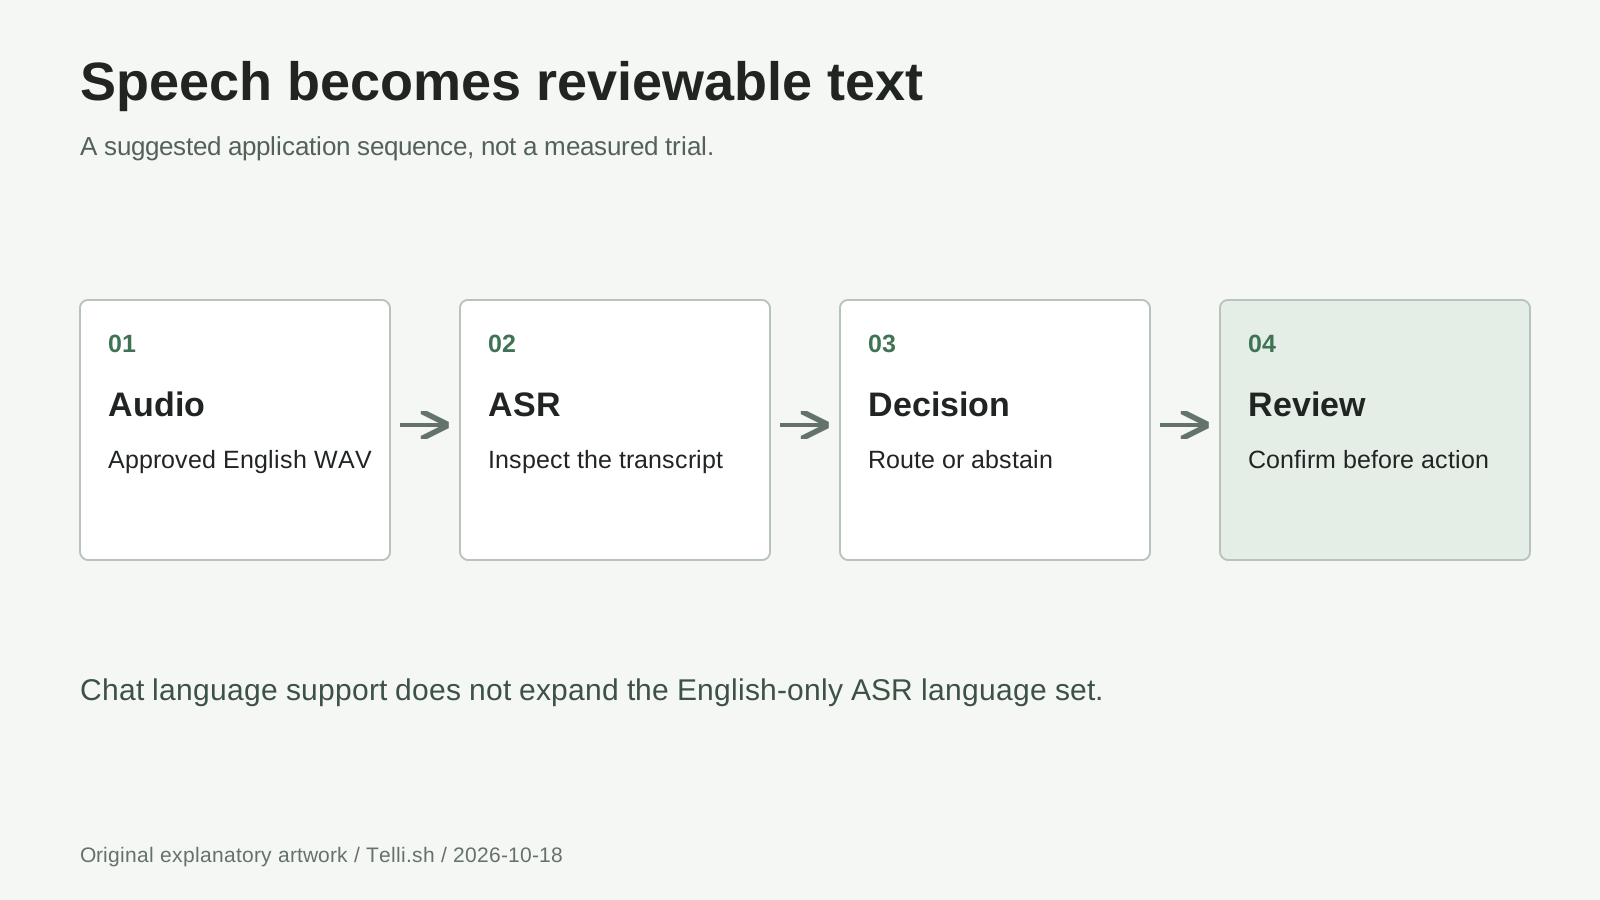
Schema originale del flusso: conserva audio e trascrizione, produci separatamente i risultati derivati e poi revisiona prima di agire. Illustra gli usi sopra, non un'interfaccia ufficiale; la catena sottostante è descritta nella guida audio, verificata il 18 ottobre 2026.
Perché più capacità possono condividere lo stesso contesto?
Una cache key/value memorizza informazioni di attenzione calcolate sui token precedenti. LoRA attivata, o aLoRA, consente a uno specialista di attivarsi dopo un contesto condiviso, invece di richiedere la normale rielaborazione specifica dell'adattatore sull'intero prefisso. IBM ha presentato l'approccio alla base nella spiegazione di ricerca del 17 aprile 2025. Ricerca IBM su aLoRA.
Switch usa uno stato normalizzato della cache del modello base, così gli specialisti non consumano lo stato adattato privato degli altri. Nell'applicazione, mantieni identico il prefisso delle prove e aggiungi la domanda specifica del compito. Riscrivere la trascrizione in modo diverso per ogni controllo compromette il riuso del prefisso. Documentazione del meccanismo Switch, verificata il 18 ottobre 2026.
La cache condivisa è un meccanismo di efficienza, non inferenza gratuita. Il caching del prefisso riduce l'elaborazione ripetuta del prompt, ma non elimina la generazione delle risposte né il riconoscimento vocale. Documentazione vLLM sul caching del prefisso, verificata il 18 ottobre 2026. Il nostro punto di vista: confronta flussi completi e revisionati, non velocità isolate da titolo.
Calcola il carico completo, non soltanto i pesi 8B
Come calcolo orientativo, 8 miliardi di parametri a due byte ciascuno occupano circa 16GB, cioè 14,9GiB; 30 miliardi occupano circa 60GB, cioè 55,9GiB. Sono esempi aritmetici sui pesi base, non dimensioni dei checkpoint né requisiti VRAM minimi. Escludono adattatori, encoder vocale, cache, buffer temporanei e overhead del runtime.
Un contesto più lungo e più sequenze simultanee aumentano la pressione sulla memoria. Il limite massimo pubblicizzato del contesto non è un invito a riservarlo per il primo esperimento. vLLM documenta la riduzione di max_model_len e max_num_seqs come controlli della memoria. Indicazioni vLLM sulla memoria, verificate il 18 ottobre 2026.
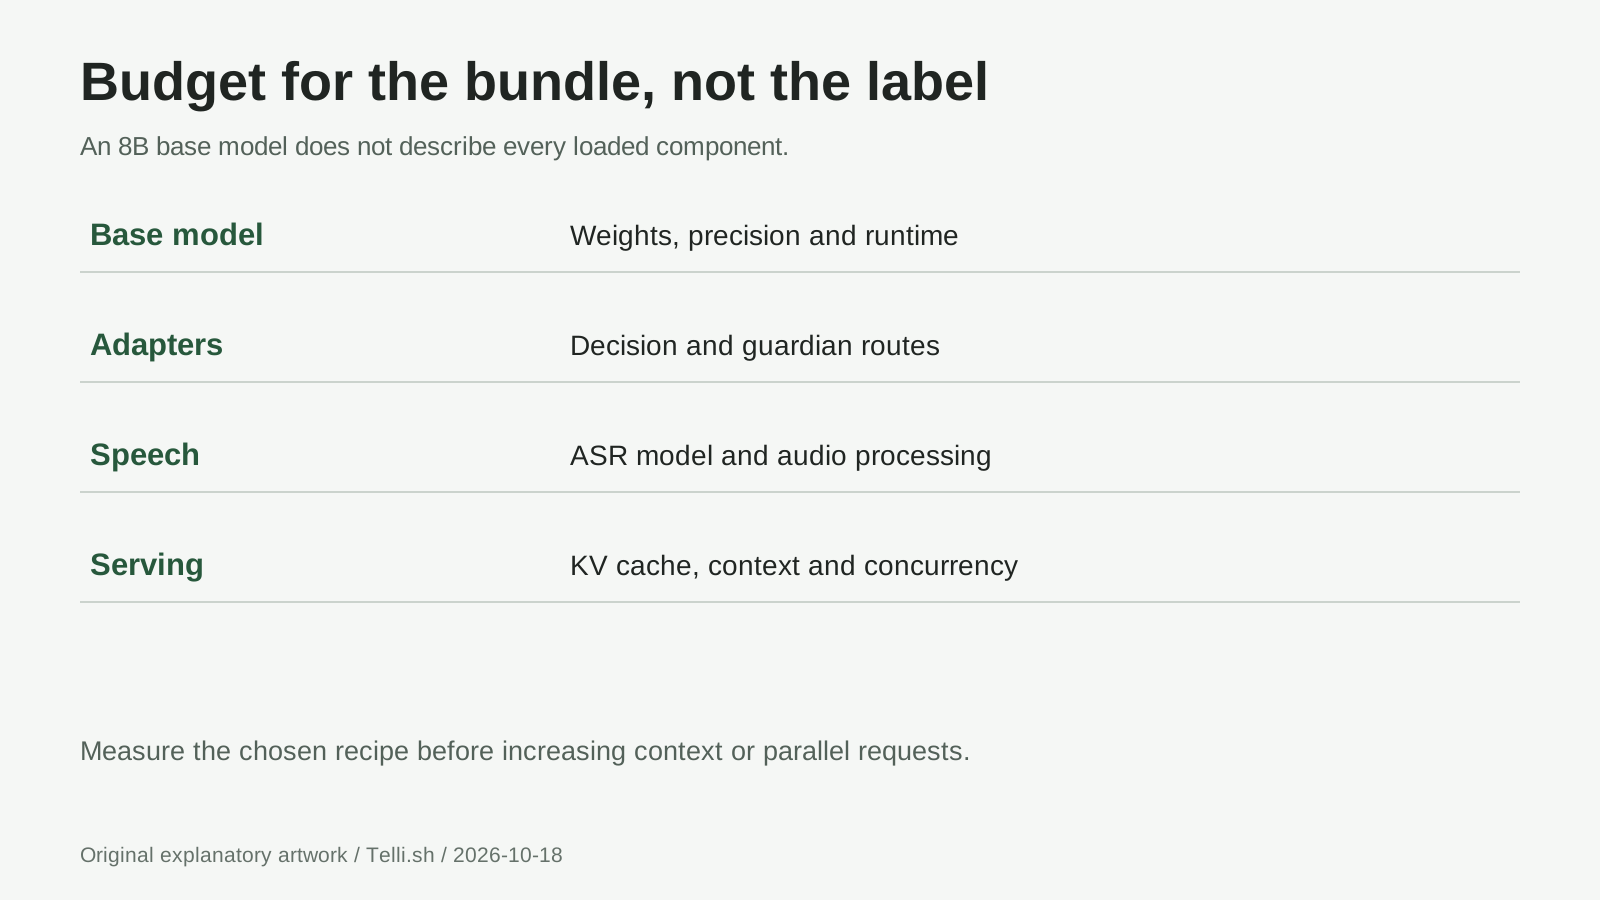
Lista di controllo originale della memoria, non proporzioni di allocazione: pesi base + adattatori + pesi e attivazioni ASR + cache KV + margine per runtime e schermo. La guida audio avverte che la preallocazione della cache può lasciare spazio insufficiente per l'ASR; verificata il 18 ottobre 2026.
Prova separatamente una breve chat, una clip breve e il tuo input normale più lungo. Registra picchi osservati di memoria, tempo di completamento ed errori. Ridurre l'allocazione della cache può lasciare più spazio al parlato, ma non rende utilizzabili pesi troppo grandi. Un'alternativa quantizzata richiede un controllo specifico di compatibilità con adattatori Switch e audio, non basta che il download sia più piccolo.
Associa costi e privacy alla scelta di distribuzione
La licenza Apache-2.0 del modello non rende gratuito l'esercizio. L'uso locale consuma hardware, elettricità, spazio e tempo di manutenzione; un endpoint ospitato comporta fatturazione del provider e termini di trattamento dei dati. Non presumere un prezzo universale per minuto di Granite Switch. Per un progetto pilota, dividi i costi totali di calcolo e revisione per gli elementi completati con successo, includendo richieste fallite e correzioni.
Un semplice budget ipotetico rende l'idea: 10 ore a una tariffa del provider di 1$ l'ora equivalgono a 10$ di calcolo, prima di archiviazione, trasferimento e revisione umana. Sono valori illustrativi, non il prezzo di un servizio specifico. Contano anche le ore in cui l'endpoint resta inattivo.
Per attività sensibili, decidi dove risiedono audio, trascrizioni, cache, log e backup prima di registrare. Il binding loopback limita l'accesso di rete, ma non stabilisce le regole di conservazione né disattiva tutta la telemetria delle librerie. Mantieni il server fuori dalle interfacce pubbliche, controlla dipendenze e log, ottieni il consenso degli interlocutori e definisci separatamente la cancellazione dell'audio sorgente e dei dati derivati. Una demo ospitata è utile per imparare, non una destinazione predefinita per riunioni riservate.
Correggi la fase fallita prima di cambiare l'intero stack
Architettura non riconosciuta. Controlla che l'ambiente virtuale contenga granite-switch, che vLLM usi quell'ambiente e che VLLM_PLUGINS includa register_granite_switch. Leggi il primo errore d'importazione del plugin prima di sostituire pacchetti.
La chat funziona, l'audio no. Verifica l'ID della versione con audio, le dipendenze [audio] e un vero WAV invece di un file soltanto rinominato. Controlla la versione di Transformers e la memoria disponibile. Installare librerie di decodifica non trasforma un'anteprima solo testuale in un checkpoint audio.
Nomi o punteggiatura errati. Il riconoscitore CTC inglese predefinito produce testo minuscolo e senza punteggiatura, senza controllo della lingua in decodifica. Conserva quel testo grezzo; il ripristino della punteggiatura è una modifica derivata. La catena può propagare gli errori di trascrizione nelle decisioni successive. Limiti audio, verificati il 18 ottobre 2026.
Una clip lunga supera il contesto. Accorcia l'input o suddividilo in sezioni significative, mantenendo i riferimenti alla sorgente. La trascrizione occupa il contesto testuale; deve restare spazio sufficiente per domanda e risposta. Aumentare il limite di contesto cambia anche il budget di memoria.
Cosa dovresti sapere prima di farci affidamento?
Può pronunciare le risposte ad alta voce? Questo percorso vocale integrato è ASR, non sintesi vocale. Un'applicazione con output vocale ha bisogno di un componente TTS separato.
Può trascrivere tutte le 12 lingue della chat? Non con il riconoscitore inglese predefinito. La guida audio descrive la sostituzione del backend ASR per input multilingue: è una configurazione diversa che richiede valutazione.
Una probabilità di opzione pari a 0,95 significa 95% di correttezza nel mondo reale? No. Esprime la distribuzione del modello sulle opzioni fornite, non un tasso di successo verificato nel tuo dominio. Opzioni mancanti, trascrizioni errate e domande ambigue possono comunque produrre una preferenza netta. Valuta esempi etichettati e definisci regole di astensione prima di automatizzare azioni. Documentazione dell'adattatore decisionale, verificata il 18 ottobre 2026.
Guardian dimostra che una risposta è vera? No. Il controllo di sicurezza è distinto dalla verifica dei fatti. La versione pronta e composta non include ogni specialista della più ampia raccolta Granite Libraries; prima di progettare un flusso di verifica fattuale, controlla l'inventario degli adattatori.
In sintesi: anche un endpoint unico richiede prove tracciabili
Granite Switch 4.1 è più utile quando la chat spiega, il parlato fornisce parole verificabili e decisioni circoscritte organizzano i passaggi successivi. Il serving modulare riduce la duplicazione dell'infrastruttura; il flusso resta responsabile di consenso, prove e autorità ad agire.
Comincia con una registrazione breve e una decisione reversibile. Amplia il flusso soltanto quando trascrizione, interpretazione e azione restano comprensibili alla persona responsabile del risultato.
Fonti
Date di rilascio: l'articolo di lancio IBM è datato 15 ottobre 2026; la scheda del modello 8B riporta il 14 ottobre 2026. Documentazione collegata verificata il 18 ottobre 2026. Le istruzioni di configurazione sono adattate da documentazione primaria, non da risultati prestazionali ottenuti direttamente. I diagrammi sono schemi editoriali originali; le immagini dei fornitori non sono riprodotte.
- Articolo di lancio IBM, scheda modello 8B, scheda modello 30B e scheda anteprima 3B: ambito dei rilasci e differenze tra checkpoint.
- Repository Granite Switch, requisiti del pacchetto fissati e guida audio: installazione, architettura e limiti del parlato.
- Demo vocale ufficiale, documentazione della demo e notebook ufficiale aLoRA race: esempi da esplorare, non risultati misurati in questa guida.
- Spiegazione IBM di aLoRA del 17 aprile 2025 e documentazione vLLM: meccanismi e requisiti operativi discussi sopra.
Un consiglio facoltativo di Telli.sh: conserva le fonti alla base della decisione
Tieni insieme registrazioni originali, appunti e risultati revisionati, così le decisioni successive non perdono contesto. Crea un account Telli.sh per organizzare i materiali di riferimento man mano che il flusso evolve.