Granite Switch 4.1 : de la parole anglaise à une décision utile
Découvrez Granite Switch 4.1, puis créez un workflow pratique de chat, transcription en anglais et prise de décision, avec des conseils réalistes sur la configuration, la mémoire, la confidentialité et les coûts.
Une demande orale mobilise généralement trois tâches distinctes : reconnaître les mots, en expliquer le sens et décider de la suite. Granite Switch 4.1 réunit ces capacités derrière un seul endpoint, au lieu de vous demander d’assembler trois serveurs de modèles indépendants.
L’annonce d’IBM du 15 octobre 2026 a présenté les versions 8B et 30B précomposées, avec chat, adaptateur de décision généraliste, filtrage de sécurité Guardian et reconnaissance vocale. L’intérêt pratique : réduire le parcours entre une note vocale en anglais et une action que l’on peut vérifier. Article de lancement IBM, 15 octobre 2026.
Ce guide commence par un petit exercice dans le navigateur, puis présente une configuration locale et trois workflows réalistes. Il précise aussi les limites importantes : une entrée audio en anglais n’est pas multilingue, un score de décision ne constitue pas une preuve et les poids du modèle ne représentent pas tout le budget mémoire du GPU.
Visuel d’ouverture : schéma éditorial original où l’audio anglais devient une transcription, puis se répartit entre réponse de chat, options de décision et filtrage de sécurité. L’action finale passe par une vérification humaine ; il ne s’agit ni d’une capture d’écran officielle ni d’une affirmation de performance.
Obtenez un premier résultat utile avant toute installation
Commencez par la démo officielle Speech to Decisions. IBM y renvoie depuis son annonce du 15 octobre ; la documentation de la démo décrit une entrée par microphone en direct, une brève description du sujet, des contrôles de sécurité et des évaluations par oui ou non. Documentation officielle de la démo, consultée le 18 octobre 2026.
-
Ouvrez la démo et utilisez uniquement des exemples inventés et non sensibles. Il s’agit d’un service hébergé, pas d’un traitement local.
-
Si l’application est disponible, autorisez l’accès au microphone et prononcez la phrase suivante en anglais, la langue prise en charge par l’ASR :
Texte brutThe replacement keyboard arrived damaged. Please send a new one. I can share a photo tomorrow. -
Arrêtez l’enregistrement et comparez la transcription affichée à ce que vous avez dit. Examinez séparément la description du sujet et les indicateurs de jugement disponibles.
-
Vérifiez que la demande, l’article endommagé et le suivi promis ont bien été conservés. Une étiquette de sujet plausible ne suffit pas si la transcription a perdu une négation ou changé l’article concerné.
En français, cela signifie : « Le clavier de remplacement est arrivé endommagé. Veuillez m’en envoyer un nouveau. Je peux partager une photo demain. »
C’est un premier point de contrôle utile : une entrée compréhensible et des sorties que vous pouvez examiner. Cela ne garantit ni une formulation exacte, ni une latence donnée, ni une disponibilité continue de la démo. Si l’Espace est indisponible ou si votre organisation interdit l’envoi d’audio à un service externe, passez à la solution locale ci-dessous plutôt que de transmettre des contenus privés ailleurs.
Que permet réellement de sélectionner le « Switch » ?
Le modèle de langage de base gère les échanges ordinaires. Un adaptateur est un ensemble plus léger d’ajustements appris qui spécialise le modèle pour une tâche donnée. L’adaptateur decision choisit parmi des options étiquetées ; guardian-core examine le texte à la recherche de certains risques de sécurité. L’application sélectionne l’adaptateur au moyen du modèle de chat, sans charger un deuxième modèle de langage complet. Dépôt Granite Switch, consulté le 18 octobre 2026.
La parole suit un autre parcours. La reconnaissance automatique de la parole (ASR) convertit l’onde sonore en texte avant que le modèle de langage ne le lise. Le système inclut le modèle anglais Granite Speech TurboCTC d’IBM, qui compte 470 millions de paramètres, selon la fiche consultée le 18 octobre 2026. Considérez cette transcription comme un reçu de transmission : tout le traitement en aval dépend des mots qui y figurent. Conservez-la avec tout résumé révisé afin de pouvoir remonter d’une décision discutable à son entrée.
| Checkpoint | Statut et point de départ prévu | Prise en charge audio |
|---|---|---|
granite-switch-4.1-8b | Publié ; l’option précomposée la plus compacte | ASR anglais inclus |
granite-switch-4.1-30b | Publié ; une base plus grande avec le même ensemble de capacités | ASR anglais inclus |
granite-switch-4.1-3b-preview | Préversion avec un autre ensemble d’adaptateurs | N’inclut pas l’ensemble publié avec reconnaissance vocale |
La fiche du modèle 8B, publiée le 14 octobre 2026, distingue les versions compatibles avec l’audio de la famille de préversions sans audio. Les fiches 30B et 3B en préversion, consultées le 18 octobre, décrivent leurs compositions respectives. Une préversion plus petite ne remplace pas directement le modèle vocal.
La fiche 8B indique 12 langues pour le chat : anglais, allemand, espagnol, français, japonais, portugais, arabe, tchèque, italien, coréen, néerlandais et chinois. Cette liste n’étend pas la reconnaissance vocale par défaut au-delà de l’anglais.
Choisissez le système d’exploitation avant de copier les commandes
Pour la configuration CUDA/vLLM présentée ici, choisissez Linux avec un GPU NVIDIA et un pilote compatibles. Sous Windows, utilisez un environnement WSL correctement configuré avec accès au GPU : ces commandes Bash ne sont pas des commandes PowerShell natives. Sous macOS, commencez par l’exercice hébergé ou par un hôte Linux avec GPU au lieu de supposer que cette recette CUDA s’applique à Apple Silicon. Guide d’installation GPU de vLLM, consulté le 18 octobre 2026.
vLLM-Metal et les autres environnements d’exécution ont leurs propres parcours de compatibilité. Le fait qu’un environnement prenne en charge votre système d’exploitation ne prouve pas que ce checkpoint Switch précis, ses adaptateurs et sa chaîne de traitement audio y fonctionnent tous. Exigez un exemple correspondant avant de choisir cette voie.
Commencez localement par le chat, puis ajoutez l’audio et les décisions
Dans un terminal Bash sous Linux ou WSL, utilisez un nouveau dossier de travail. Installez d’abord Git et Python 3.12, puis vérifiez que nvidia-smi détecte le GPU. L’instantané du dépôt utilisé ici requiert Python >=3.11,<3.14, PyTorch >=2.11.0, Transformers >=5.16,<=5.17.0 et vLLM >=0.26.0,<0.31.0. Déclarations de dépendances à la révision 7e72456, consultées le 18 octobre 2026.
- Installez ensemble le package Switch et les dépendances audio. Cela épingle la recette du dépôt au lieu de dépendre d’une ancienne version publiée du package.
git clone https://github.com/generative-computing/granite-switch.git
cd granite-switch
git checkout 7e724560f9a9449bba2f08e16e8678c4dd6a06e7
python3.12 -m venv .venv
source .venv/bin/activate
python -m pip install --upgrade pip
python -m pip install -e '.[vllm,audio]' openai
python -m pip check
Les extras dépendent de la tâche : [hf] ajoute la prise en charge de l’inférence Hugging Face, [compose] ajoute les outils de composition et [audio] installe les dépendances de décodage audio de vLLM. Installer uniquement vllm n’installe pas le plugin Switch. Assurez-vous que la combinaison PyTorch/CUDA résolue reste compatible avec votre pilote ; ne contournez pas une erreur de résolution en supprimant les vérifications de dépendances. À la première utilisation, les poids du modèle sont téléchargés : prévoyez le temps et l’espace disque nécessaires aux checkpoints avant de commencer un enregistrement.
- Lancez un seul serveur limité à la boucle locale. Les limites de contexte et de concurrence ci-dessous constituent des réglages de départ prudents, pas une garantie d’adéquation au matériel.
VLLM_PLUGINS=register_granite_switch \
python -m vllm.entrypoints.openai.api_server \
  --model ibm-granite/granite-switch-4.1-8b \
  --host 127.0.0.1 --port 8000 \
  --max-model-len 4096 --max-num-seqs 1 \
  --gpu-memory-utilization 0.80 --enable-prefix-caching
Le package enregistre register_granite_switch dans vllm.general_plugins. vLLM découvre les points d’entrée installés ; la variable d’environnement sélectionne explicitement ce plugin. Cette recette ne nécessite ni script d’enregistrement copié ni contournement avec --trust-remote-code. Code source de l’enregistrement Switch et système de plugins vLLM, consultés le 18 octobre 2026.
- Vérifiez une réponse de chat simple. Dans un deuxième terminal Bash, attendez que le serveur soit prêt, puis lancez :
curl --fail http://127.0.0.1:8000/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -d '{"model":"ibm-granite/granite-switch-4.1-8b","messages":[{"role":"user","content":"Rewrite this request clearly without adding facts: The replacement keyboard arrived damaged. Please send a new one."}],"max_tokens":120,"temperature":0}'
Lisez le message de l’assistant dans la réponse JSON. Pour réussir, il faut préserver la demande sans inventer de numéro de commande, d’échéance ni d’autorisation de remboursement. Une réponse HTTP, à elle seule, ne garantit pas que la réponse soit utile.
- Envoyez un court fichier WAV en anglais. Placez dans le dossier du dépôt un enregistrement non sensible, réalisé avec le consentement des personnes concernées, nommé
request.wav. Activez le même environnement virtuel dans le deuxième terminal, enregistrez le code suivant soustry_audio.py, puis lancezpython try_audio.py.
import base64
from pathlib import Path
from openai import OpenAI

audio_bytes = Path("request.wav").read_bytes()
message_parts = [
    {"type": "text", "text": "List the requests in this recording. Do not add facts."},
    {"type": "input_audio", "input_audio": {
        "format": "wav",
        "data": base64.b64encode(audio_bytes).decode("ascii"),
    }},
]
local = OpenAI(api_key="unused", base_url="http://127.0.0.1:8000/v1")
reply = local.chat.completions.create(
    model="ibm-granite/granite-switch-4.1-8b",
    messages=[{"role": "user", "content": message_parts}],
    max_tokens=160,
    temperature=0,
)
print(reply.choices[0].message.content)
Cette requête renvoie une réponse du modèle de langage fondée sur la transcription insérée en interne, et non un export ASR brut. Le guide audio décrit la chaîne de traitement et le format d’entrée ; si vous devez examiner les deux étapes séparément, utilisez une application qui expose la transcription. Documentation audio, consultée le 18 octobre 2026.
- Testez une décision délimitée à partir d’un texte vérifié. Laissez le serveur tourner et envoyez :
curl --fail http://127.0.0.1:8000/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -d '{"model":"ibm-granite/granite-switch-4.1-8b","messages":[{"role":"user","content":"State:\nThe replacement keyboard arrived damaged. Please send a new one."},{"role":"user","content":"### DECISION\nQuestion:\nWhich queue should review this request?\n\nOptions:\nA: Damaged-item replacements\nB: Account access\nC: Human triage because neither category fits\n\nReply with exactly one option label."}],"chat_template_kwargs":{"adapter_name":"decision"},"max_tokens":1,"temperature":0}'
Cet essai vérifie la sélection de l’adaptateur et demande une seule étiquette, pas un rapport de probabilités. Pour obtenir des probabilités, suivez l’exemple de décision de la fiche du modèle, consultée le 18 octobre 2026 : vérifiez que les étiquettes correspondent à un seul jeton, demandez leurs logprob_token_ids, puis normalisez les valeurs sur l’ensemble des étiquettes candidates. La documentation de lecture de l’adaptateur de décision, consultée le 18 octobre explique la fonction softmax appliquée aux options. Ne remplacez pas ces valeurs par une phrase produite par le chat telle que « Je suis sûr à 95 % ».
Concevez trois workflows vérifiables, pas simplement automatiques
Ces exemples illustrent des usages ; ils ne rapportent pas des essais réalisés. Commencez par produire des résultats qui facilitent la vérification, et n’ajoutez des actions lourdes de conséquences qu’après avoir évalué des cas représentatifs.
Orientez un message vocal de client. Utilisez l’ASR pour transcrire la demande, le chat pour rédiger un résumé neutre et une question de décision pour choisir entre remplacement, assistance liée au compte et examen humain. Gardez l’audio original associé à la transcription vérifiée. Faites de la phrase « do not cancel my order » (« n’annulez pas ma commande ») un cas de test explicite, plutôt que d’y penser après avoir automatisé les annulations.
Le contrôle d’acceptation est concret : la file sélectionnée correspond-elle aux mots prononcés, et un agent d’assistance peut-il la corriger avant tout envoi ? Un indicateur de sécurité peut demander une vérification supplémentaire, mais ne doit pas éliminer silencieusement la réclamation d’un client mécontent.
Transformez une mise à jour de projet en tâche provisoire. Dans un enregistrement en anglais, un collègue dit : « I can review the draft Friday, but I cannot approve the budget » (« Je peux relire le brouillon vendredi, mais je ne peux pas approuver le budget »). Demandez au chat de distinguer les engagements des exclusions, puis demandez à l’adaptateur de décision si l’approbation du budget est présente, absente ou incertaine. Gardez l’option « incertain » lorsque l’enregistrement ou le contexte ne suffit pas. Une personne vérifie la date et la responsabilité avant l’ajout de la tâche à un suivi partagé.
Préparez une liste de questions de suivi pour un entretien. Avec l’autorisation de la personne interrogée, transcrivez un court extrait d’entretien en anglais et rédigez des questions sur les détails manquants. Posez des questions délimitées, par exemple « Ce passage indique-t-il explicitement une date de livraison ? », plutôt que « Cette personne est-elle digne de confiance ? ». Conservez l’extrait qui justifie chaque indicateur. Un désaccord peut ainsi être examiné sans transformer l’interprétation du modèle en jugement sur la personne.
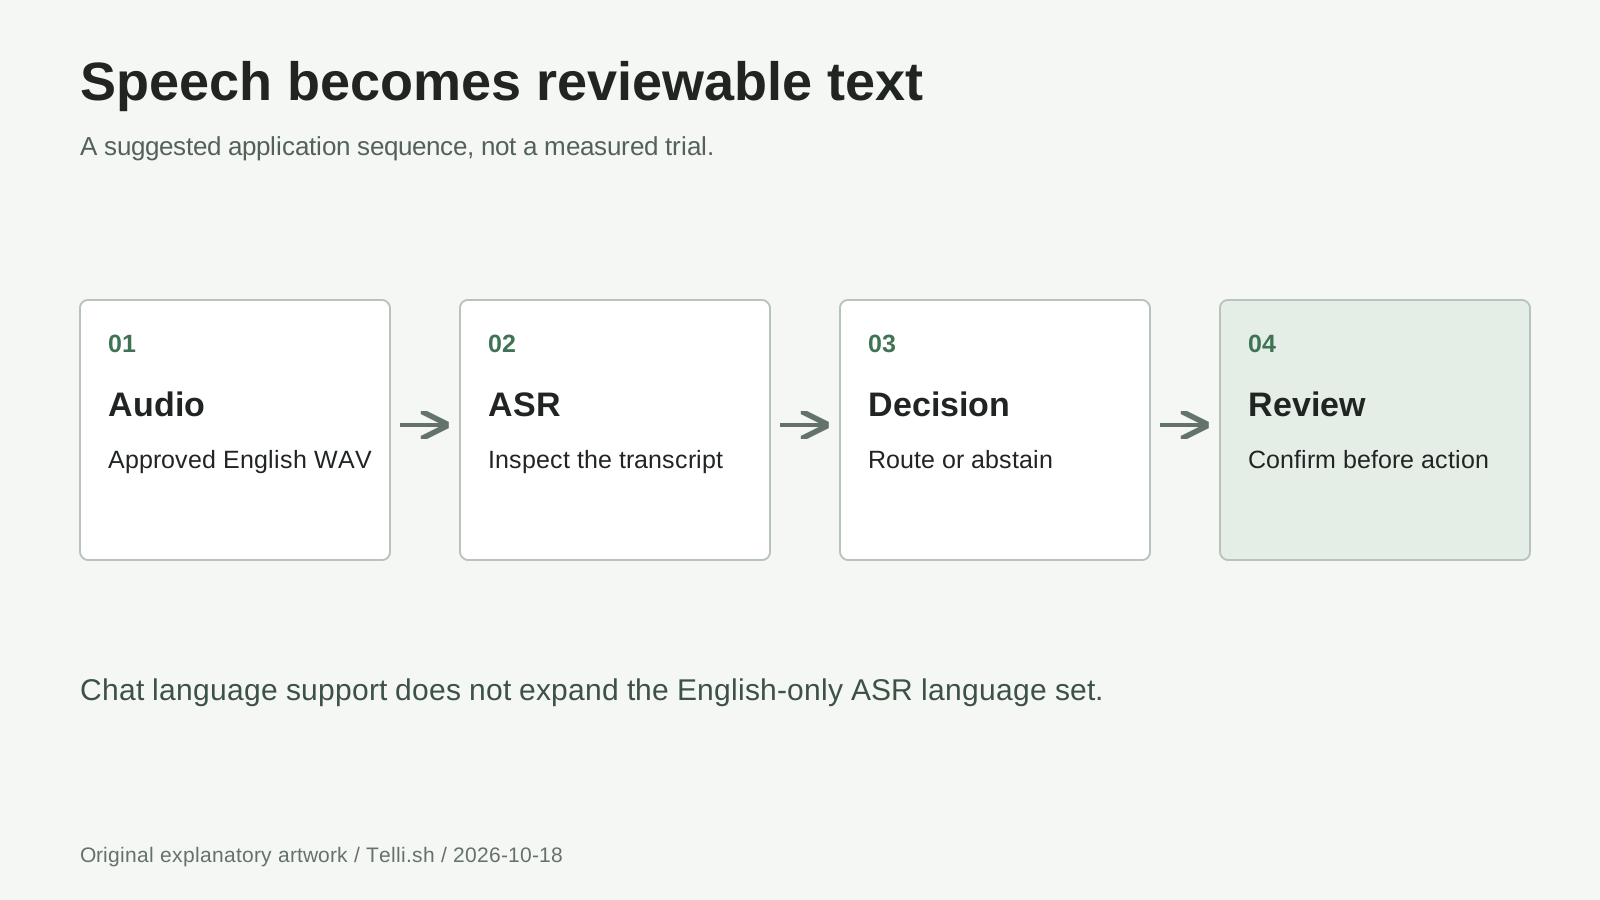
Schéma de workflow original : conservez l’audio et sa transcription, produisez séparément les résultats dérivés, puis vérifiez-les avant toute action. Il illustre les cas d’usage ci-dessus et non une interface officielle ; la chaîne sous-jacente est décrite dans le guide audio, consulté le 18 octobre 2026.
Pourquoi plusieurs capacités peuvent-elles partager le même contexte ?
Un cache clé/valeur conserve les informations d’attention calculées à partir des jetons précédents. LoRA activé, ou aLoRA, permet d’activer un spécialiste après un contexte partagé, au lieu de retraiter normalement tout le préfixe pour chaque adaptateur. IBM a présenté cette approche dans son explication de recherche du 17 avril 2025. IBM Research sur aLoRA.
Switch utilise un état de cache normalisé du modèle de base afin que les spécialistes ne consomment pas l’état adapté privé les uns des autres. Dans une application, gardez le préfixe qui contient les éléments de preuve identique et ajoutez-y la question propre à la tâche. Reformuler la transcription différemment pour chaque vérification compromet la réutilisation du préfixe. Documentation du mécanisme Switch, consultée le 18 octobre 2026.
Le cache partagé est un mécanisme d’efficacité, pas une inférence gratuite. La mise en cache des préfixes évite de retraiter plusieurs fois les mêmes prompts ; elle ne supprime ni la génération des réponses ni la reconnaissance audio. Documentation de vLLM sur la mise en cache des préfixes, consultée le 18 octobre 2026. Notre avis : comparez des workflows complets, avec vérification, et non des chiffres de vitesse isolés.
Budgétez toute la charge, pas seulement les poids 8B
À titre de calcul prévisionnel, 8 milliards de paramètres à deux octets chacun occupent environ 16 Go, soit 14,9 Gio ; 30 milliards en occupent environ 60 Go, soit 55,9 Gio. Ce calcul arithmétique porte sur les poids de base ; il ne donne ni la taille des checkpoints ni une spécification minimale de VRAM. Il exclut les adaptateurs, l’encodeur vocal, le cache, les tampons temporaires et la surcharge de l’environnement d’exécution.
Un contexte plus long et davantage de séquences simultanées augmentent la pression sur la mémoire. La limite de contexte annoncée pour le modèle ne signifie pas qu’il faille la réserver dès le premier essai. La documentation de vLLM recommande de réduire max_model_len et max_num_seqs pour maîtriser la mémoire. Conseils vLLM sur la mémoire, consultés le 18 octobre 2026.
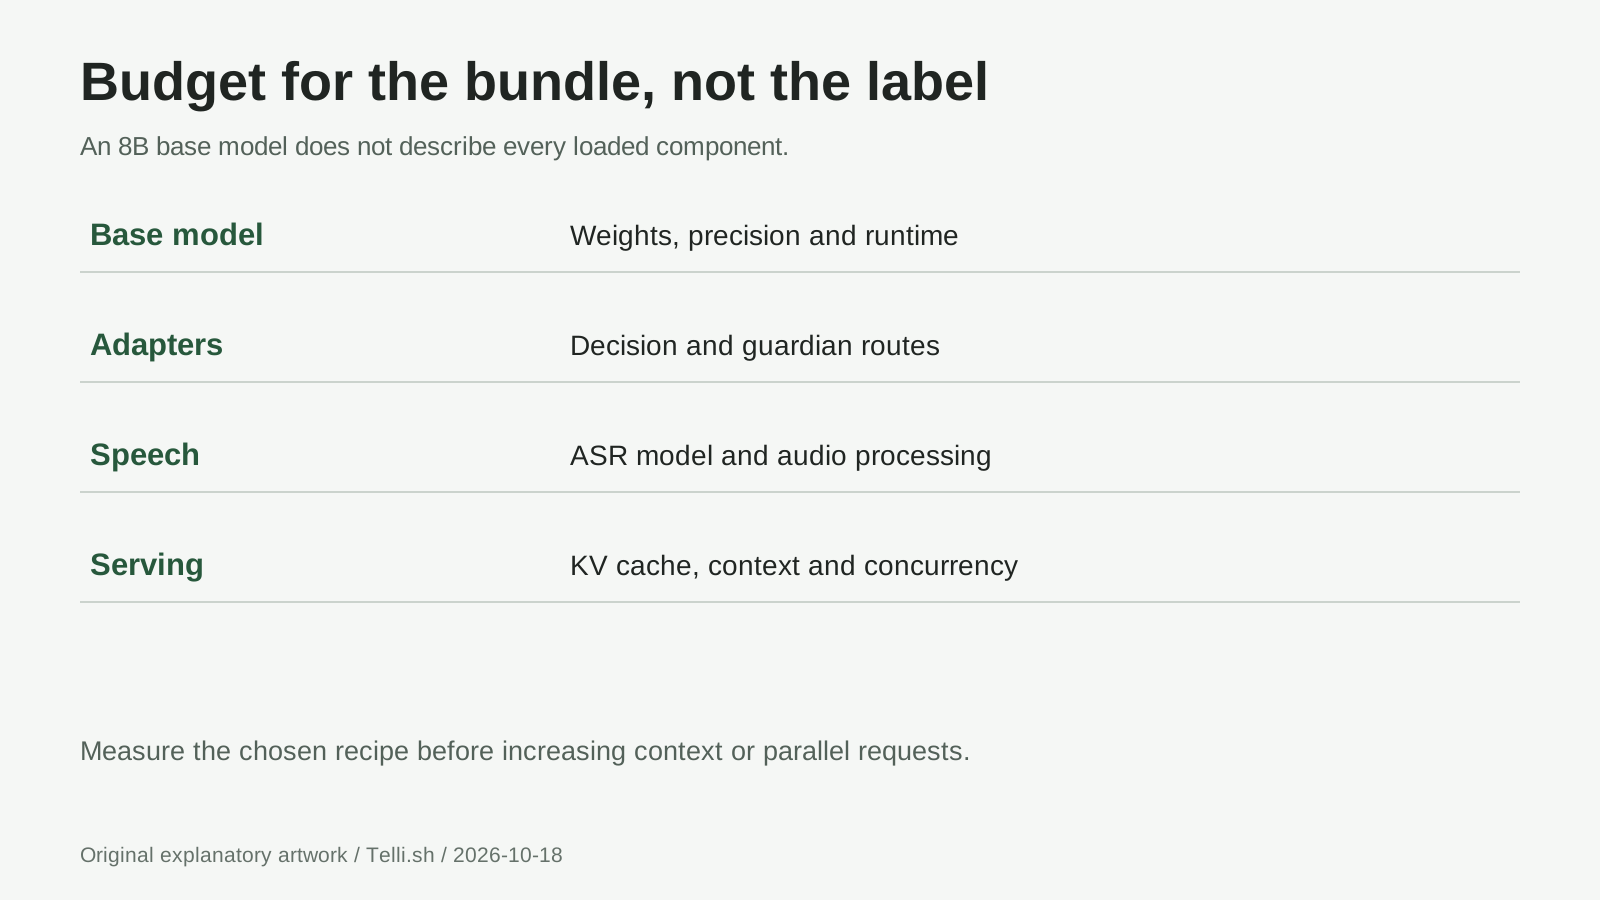
Liste de contrôle mémoire originale, non proportionnelle : poids de base + adaptateurs + poids et activations ASR + cache KV + marge pour l’environnement d’exécution et l’affichage. Le guide audio avertit que la préallocation du cache peut ne pas laisser assez de place à l’ASR ; consulté le 18 octobre 2026.
Testez séparément un court échange, un court extrait audio et votre entrée habituelle la plus longue. Notez les pics de mémoire observés, le temps de traitement et les erreurs. Réduire l’allocation du cache peut libérer de la place pour la parole, mais ne fera pas tenir des poids trop volumineux. Une solution quantifiée doit faire l’objet d’une vérification de compatibilité avec les adaptateurs Switch et l’audio, pas seulement d’un constat que le téléchargement est plus petit.
Tenez compte du coût et de la confidentialité dans votre choix de déploiement
La licence Apache 2.0 du modèle ne rend pas son exploitation gratuite. L’utilisation locale mobilise du matériel, de l’électricité, du stockage et du temps de maintenance ; un endpoint hébergé ajoute la facturation du fournisseur et ses conditions de traitement des données. Ne supposez pas qu’il existe un tarif universel à la minute pour Granite Switch. Pour un pilote, divisez le coût total du calcul et de la vérification par le nombre d’éléments traités avec succès, en comptant aussi les requêtes échouées et les corrections.
Un budget hypothétique simple permet de se représenter ces coûts : 10 heures à un tarif fournisseur de 1 $ l’heure représentent 10 $ de calcul, avant stockage, transfert et vérification humaine. Ce sont des valeurs d’exemple, pas le tarif annoncé d’un service. Les heures où un endpoint reste inutilisé comptent également.
Pour les tâches sensibles, choisissez où seront stockés l’audio, les transcriptions, les caches, les journaux et les sauvegardes avant d’enregistrer. Une liaison à la boucle locale limite l’accès réseau, mais ne définit pas les règles de conservation et ne désactive pas la télémétrie de toutes les bibliothèques. N’exposez pas le serveur sur des interfaces publiques, vérifiez les dépendances et la journalisation, obtenez l’accord des personnes qui parlent et définissez séparément la suppression des fichiers audio sources et des enregistrements dérivés. Une démo hébergée est utile pour apprendre, mais ne devrait pas être la destination par défaut de réunions confidentielles.
Corrigez l’étape défaillante avant de remplacer toute la pile
L’architecture n’est pas reconnue. Vérifiez que l’environnement virtuel contient granite-switch, que vLLM utilise bien cet environnement et que VLLM_PLUGINS inclut register_granite_switch. Lisez la première erreur d’importation du plugin avant de remplacer des packages.
Le chat fonctionne, mais l’audio échoue. Vérifiez l’identifiant de la version compatible avec l’audio, les dépendances [audio] et la présence d’un vrai fichier WAV plutôt que d’un fichier simplement renommé. Contrôlez la version de Transformers et la mémoire disponible. L’installation de bibliothèques de décodage ne transforme pas une préversion texte en checkpoint audio.
Les noms ou la ponctuation sont erronés. Le reconnaisseur CTC anglais par défaut produit du texte en minuscules, sans ponctuation, et ne permet pas de piloter la langue au décodage. Conservez ce texte brut ; toute restauration de la ponctuation constitue une modification dérivée. La chaîne peut propager les erreurs de transcription jusqu’aux décisions ultérieures. Limites audio, consultées le 18 octobre 2026.
Un long extrait dépasse le contexte disponible. Raccourcissez l’entrée ou divisez-la en sections pertinentes en conservant les références à la source. La transcription occupe une partie du contexte textuel ; il faut aussi réserver assez de place à la question et à la réponse. L’augmentation de la limite de contexte modifie également le budget mémoire.
Que faut-il savoir avant de s’y fier ?
Peut-il prononcer ses réponses à voix haute ? Cette chaîne vocale intégrée fait de l’ASR, pas de la synthèse vocale. Une application qui produit une voix doit intégrer un composant TTS distinct.
Peut-il transcrire dans les 12 langues du chat ? Pas avec le reconnaisseur anglais par défaut. Le guide audio décrit le remplacement du moteur ASR pour accepter plusieurs langues ; cette autre configuration doit être évaluée.
Une probabilité de 0,95 pour une option signifie-t-elle une exactitude de 95 % dans le monde réel ? Non. Elle exprime la distribution du modèle sur les choix proposés, pas un taux de réussite vérifié pour votre domaine. Des options manquantes, de mauvaises transcriptions ou des questions ambiguës peuvent malgré tout entraîner une préférence marquée. Évaluez des exemples étiquetés et définissez des règles d’abstention avant d’automatiser des actions. Documentation de l’adaptateur de décision, consultée le 18 octobre 2026.
Guardian prouve-t-il qu’une réponse est vraie ? Non. Le filtrage de sécurité est distinct de la vérification des faits. La version précomposée ne comprend pas tous les spécialistes de la collection Granite Libraries au sens large ; examinez l’inventaire des adaptateurs avant de concevoir un workflow de vérification factuelle.
En bref : un endpoint a toujours besoin d’une piste de vérification
Granite Switch 4.1 est particulièrement utile lorsque le chat explique, que la parole fournit des mots vérifiables et que des décisions délimitées organisent la suite. Son architecture modulaire réduit les doublons d’infrastructure ; votre workflow reste responsable du consentement, des éléments de preuve et de l’autorisation d’agir.
Commencez par un court enregistrement et une décision réversible. N’élargissez le dispositif que si la transcription, l’interprétation et l’action restent compréhensibles pour la personne responsable du résultat.
Sources
Dates de publication : l’article de lancement d’IBM est daté du 15 octobre 2026 ; la fiche du modèle 8B indique le 14 octobre 2026. Les documents liés ont été consultés le 18 octobre 2026. Les instructions de configuration sont adaptées de la documentation primaire et ne constituent pas des résultats de tests pratiques. Les schémas sont des créations éditoriales originales ; les images des fournisseurs ne sont pas reproduites.
- Article de lancement d’IBM, fiche du modèle 8B, fiche 30B et fiche de préversion 3B : périmètre des versions et différences entre checkpoints.
- Dépôt Granite Switch, dépendances épinglées et guide audio : installation, architecture et limites de la reconnaissance vocale.
- Démo vocale officielle, documentation de la démo et notebook officiel de comparaison aLoRA : démonstrations à explorer, et non résultats mesurés dans ce guide.
- Explication d’aLoRA par IBM, 17 avril 2025 et documentation vLLM : mécanismes et exigences d’exploitation évoqués ci-dessus.
Recommandation Telli.sh facultative : conservez les sources qui étayent la décision
Conservez ensemble les enregistrements originaux, vos notes et les résultats vérifiés afin que les décisions ultérieures gardent leur contexte. Créer un compte Telli.sh pour organiser ces documents de référence au fil de l’évolution de votre workflow.