Granite Switch 4.1: convierte el habla en inglés en una decisión útil
Prueba Granite Switch 4.1 y crea un flujo práctico de chat, transcripción de audio en inglés y toma de decisiones, con pautas realistas de instalación, memoria, privacidad y costes.
Una petición hablada suele requerir tres tipos de trabajo: reconocer las palabras, explicar qué significan y decidir qué debería ocurrir después. Granite Switch 4.1 reúne esas capacidades detrás de un endpoint, en vez de pedirte que montes tres servidores de modelos independientes.
El anuncio de IBM del 15 de octubre de 2026 presentó las versiones listas para usar de 8B y 30B con chat, un adaptador general de decisiones, el filtro de seguridad Guardian y reconocimiento del habla. La ventaja práctica es una ruta más corta desde una nota de voz en inglés hasta una acción que se pueda revisar. Artículo de lanzamiento de IBM, 15 de octubre de 2026.
Esta guía empieza con un pequeño ejercicio en el navegador, sigue con una instalación local y muestra tres flujos de trabajo realistas. También explica dónde importan los límites: el audio en inglés no equivale al audio multilingüe, una puntuación de decisión no es una prueba y los pesos del modelo no son todo el presupuesto de memoria de la GPU.
Imagen principal: esquema editorial original en el que el audio en inglés se convierte en una transcripción y luego se ramifica en una respuesta de chat, opciones de decisión y un control de seguridad. Una persona revisa la acción final; no es una captura oficial ni una afirmación de rendimiento.
Obtén un primer resultado útil antes de instalar nada
Empieza en la demo oficial de Speech to Decisions. IBM enlaza a ella desde el anuncio del 15 de octubre; la propia documentación de la demo describe la entrada de audio en directo desde el micrófono, una breve descripción del tema, controles de seguridad y juicios de sí o no. Documentación oficial de la demo, consultada el 18 de octubre de 2026.
-
Abre la demo y utiliza únicamente material inventado y no confidencial. Es un servicio alojado, no un procesamiento local.
-
Si la aplicación está disponible, da permiso para usar el micrófono y di lo siguiente en inglés, el idioma compatible con el ASR incluido:
Texto sin formatoThe replacement keyboard arrived damaged. Please send a new one. I can share a photo tomorrow.Significa: «El teclado de sustitución llegó dañado. Por favor, envíen uno nuevo. Mañana puedo compartir una foto».
-
Detén la grabación y compara la transcripción mostrada con lo que has dicho. Revisa por separado la descripción del tema y las marcas de decisión disponibles.
-
Comprueba si se han conservado la petición, el artículo dañado y el seguimiento prometido. Una etiqueta de tema verosímil no cuenta como éxito si la transcripción pierde una negación o cambia el artículo.
Ese es un primer punto de control útil: una entrada comprensible y unos resultados que puedes inspeccionar. No garantiza una redacción exacta, latencia determinada ni disponibilidad continua de la demo. Si el Space no está disponible o tu organización prohíbe subir audio a servicios externos, pasa a la ruta local que sigue en vez de enviar material privado a otro lugar.
¿Qué cambia realmente Switch?
El modelo de lenguaje base se ocupa del chat normal. Un adaptador es un conjunto menor de ajustes entrenados que especializa el modelo en una tarea. El adaptador decision elige entre opciones etiquetadas; guardian-core analiza el texto en busca de ciertos riesgos de seguridad. La aplicación selecciona el adaptador mediante la plantilla de chat, en vez de cargar un segundo modelo de lenguaje completo. Repositorio de Granite Switch, consultado el 18 de octubre de 2026.
El habla sigue otra ruta. El reconocimiento automático del habla (ASR) convierte la forma de onda en texto antes de que la lea el modelo de lenguaje. El reconocedor incluido es el modelo inglés Granite Speech TurboCTC de IBM, con 470 millones de parámetros, consultado el 18 de octubre de 2026. Modelo Granite Speech de IBM. Piensa en esa transcripción como el recibo de traspaso: todo lo que viene después depende de las palabras que consten allí. Consérvala junto al resumen corregido para que cualquiera pueda rastrear una decisión dudosa hasta su entrada.
| Checkpoint | Estado y punto de partida previsto | Qué esperar del audio |
|---|---|---|
granite-switch-4.1-8b | Publicado; opción lista para usar de menor tamaño | Incluye ASR en inglés |
granite-switch-4.1-30b | Publicado; modelo base mayor con el mismo conjunto de capacidades | Incluye ASR en inglés |
granite-switch-4.1-3b-preview | Versión preliminar con otro conjunto de adaptadores | No incluye el paquete publicado con reconocimiento del habla |
La ficha del modelo 8B, publicada el 14 de octubre de 2026 distingue las versiones con audio de la familia preliminar sin audio. Las fichas de 30B y de la versión preliminar de 3B, consultadas el 18 de octubre, describen sus respectivas composiciones. La versión preliminar más pequeña no sustituye directamente a la opción con reconocimiento del habla.
La ficha de 8B enumera 12 idiomas para el chat: inglés, alemán, español, francés, japonés, portugués, árabe, checo, italiano, coreano, neerlandés y chino. Esa lista no amplía el reconocedor predeterminado más allá del inglés.
Elige el sistema operativo antes de copiar comandos
Para la configuración con CUDA y vLLM que se explica aquí, elige Linux con una GPU y un controlador NVIDIA compatibles. En Windows, usa un entorno WSL bien configurado con acceso a la GPU; estos comandos Bash no son comandos nativos de PowerShell. En macOS, empieza con el ejercicio alojado o con un servidor Linux con GPU, en vez de dar por hecho que esta receta CUDA se adapta a Apple Silicon. Instrucciones de instalación de vLLM para GPU, consultadas el 18 de octubre de 2026.
vLLM-Metal y otros entornos tienen sus propias vías de compatibilidad. Que un entorno admita tu sistema operativo no demuestra que allí funcionen este checkpoint de Switch, sus adaptadores y toda la cadena de voz. Antes de elegir esa opción, exige un ejemplo que coincida con tu caso.
Empieza localmente con el chat y luego añade audio y decisiones
Usa una carpeta de trabajo nueva en una terminal Bash de Linux o WSL. Instala Git y Python 3.12 primero, y confirma que nvidia-smi detecta la GPU. La versión del repositorio utilizada aquí requiere Python >=3.11,<3.14, PyTorch >=2.11.0, Transformers >=5.16,<=5.17.0 y vLLM >=0.26.0,<0.31.0. Declaraciones de dependencias en la revisión 7e72456, consultadas el 18 de octubre de 2026.
- Instala a la vez el paquete Switch y las dependencias de audio. Así fijas la receta del código fuente en vez de depender de una versión antigua del paquete publicado.
git clone https://github.com/generative-computing/granite-switch.git
cd granite-switch
git checkout 7e724560f9a9449bba2f08e16e8678c4dd6a06e7
python3.12 -m venv .venv
source .venv/bin/activate
python -m pip install --upgrade pip
python -m pip install -e '.[vllm,audio]' openai
python -m pip check
Los extras son específicos de cada tarea: [hf] añade compatibilidad con la inferencia de Hugging Face, [compose] incorpora herramientas de composición y [audio] instala las dependencias de decodificación de audio de vLLM. Instalar solo vllm no instala el complemento de Switch. Mantén la combinación resuelta de PyTorch y CUDA compatible con tu controlador; no elimines las comprobaciones de dependencias para ocultar un error del resolver. El primer uso descarga los pesos del modelo, así que reserva tiempo de preparación y espacio en disco para los checkpoints antes de empezar a grabar.
- Inicia un servidor accesible solo desde el equipo. Los límites de contexto y concurrencia siguientes son valores iniciales conservadores, no una garantía de que quepa en tu hardware.
VLLM_PLUGINS=register_granite_switch \
python -m vllm.entrypoints.openai.api_server \
  --model ibm-granite/granite-switch-4.1-8b \
  --host 127.0.0.1 --port 8000 \
  --max-model-len 4096 --max-num-seqs 1 \
  --gpu-memory-utilization 0.80 --enable-prefix-caching
El paquete registra register_granite_switch en vllm.general_plugins. vLLM descubre los puntos de entrada instalados; la variable de entorno selecciona explícitamente este complemento. Esta receta no requiere un script de registro copiado ni el apaño --trust-remote-code. Fuentes: código de registro de Switch y sistema de complementos de vLLM, consultados el 18 de octubre de 2026.
- Comprueba una respuesta de chat normal. En una segunda terminal Bash, espera a que el servidor esté listo y ejecuta:
curl --fail http://127.0.0.1:8000/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -d '{"model":"ibm-granite/granite-switch-4.1-8b","messages":[{"role":"user","content":"Rewrite this request clearly without adding facts: The replacement keyboard arrived damaged. Please send a new one."}],"max_tokens":120,"temperature":0}'
Lee el mensaje del asistente dentro de la respuesta JSON. El resultado es satisfactorio si conserva la petición sin inventar un número de pedido, una fecha límite ni la aprobación de un reembolso. Una respuesta HTTP por sí sola no demuestra que la contestación sea útil.
- Envía un WAV breve en inglés. Coloca en la carpeta del repositorio una grabación consentida y no confidencial llamada
request.wav. Activa el mismo entorno virtual en la segunda terminal, guarda el código siguiente comotry_audio.pyy ejecutapython try_audio.py.
import base64
from pathlib import Path
from openai import OpenAI

audio_bytes = Path("request.wav").read_bytes()
message_parts = [
    {"type": "text", "text": "List the requests in this recording. Do not add facts."},
    {"type": "input_audio", "input_audio": {
        "format": "wav",
        "data": base64.b64encode(audio_bytes).decode("ascii"),
    }},
]
local = OpenAI(api_key="unused", base_url="http://127.0.0.1:8000/v1")
reply = local.chat.completions.create(
    model="ibm-granite/granite-switch-4.1-8b",
    messages=[{"role": "user", "content": message_parts}],
    max_tokens=160,
    temperature=0,
)
print(reply.choices[0].message.content)
La respuesta del modelo de lenguaje se basa en la transcripción insertada internamente; no es una exportación ASR sin modificar. La guía de audio documenta la cadena y el formato de entrada. Si necesitas inspeccionar ambas etapas por separado, usa una aplicación que muestre la transcripción. Documentación de audio, consultada el 18 de octubre de 2026.
- Prueba una decisión acotada con texto revisado. Deja el servidor en ejecución y envía:
curl --fail http://127.0.0.1:8000/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -d '{"model":"ibm-granite/granite-switch-4.1-8b","messages":[{"role":"user","content":"State:\nThe replacement keyboard arrived damaged. Please send a new one."},{"role":"user","content":"### DECISION\nQuestion:\nWhich queue should review this request?\n\nOptions:\nA: Damaged-item replacements\nB: Account access\nC: Human triage because neither category fits\n\nReply with exactly one option label."}],"chat_template_kwargs":{"adapter_name":"decision"},"max_tokens":1,"temperature":0}'
La prueba selecciona un adaptador y pide una etiqueta, no un informe de probabilidades. Para obtener probabilidades, sigue el ejemplo de decisiones de la ficha del modelo, consultada el 18 de octubre de 2026: verifica las etiquetas de un único token, solicita sus logprob_token_ids y normaliza los valores entre las etiquetas candidatas. La documentación de lectura del adaptador de decisiones, consultada el 18 de octubre, explica la función softmax por opción. No sustituyas esto por una frase de chat que diga «Tengo un 95 % de confianza».
Diseña tres flujos que se puedan revisar, no que sean meramente automáticos
Son usos ilustrativos, no pruebas realizadas. Empieza con resultados que faciliten la revisión y añade acciones con consecuencias solo después de evaluar casos representativos.
Clasificar un mensaje de voz de un cliente. Usa ASR para captar la petición, el chat para redactar un resumen neutral y una pregunta de decisión para elegir entre sustitución, asistencia con la cuenta y revisión humana. Mantén el audio original vinculado a la transcripción revisada. «No canceles mi pedido» debería convertirse en un caso de prueba deliberado, no en algo que se comprueba cuando ya existe una automatización de cancelaciones.
El criterio de aceptación es concreto: ¿encaja la cola elegida con las palabras reales y puede corregirla un agente de soporte antes de que se envíe nada? Una marca de seguridad puede solicitar una revisión adicional, pero no debería descartar en silencio la queja de un cliente frustrado.
Convertir una actualización de proyecto en un borrador de tarea. En una grabación en inglés, alguien dice: «I can review the draft Friday, but I cannot approve the budget» («Puedo revisar el borrador el viernes, pero no puedo aprobar el presupuesto»). Pide al chat que separe los compromisos de las exclusiones y luego pregunta al adaptador si la aprobación presupuestaria está presente, ausente o no queda clara. Mantén disponible la opción «no está claro» cuando la grabación o el contexto no basten. Antes de añadir la tarea a un registro compartido, una persona comprueba la fecha y quién es responsable.
Preparar preguntas de seguimiento para una entrevista. Con permiso de quien habla, transcribe un fragmento breve de una entrevista en inglés y redacta preguntas sobre los datos que faltan. Formula decisiones acotadas, como «¿Se indica explícitamente una fecha de entrega en este pasaje?», en vez de «¿Es de fiar esta persona?». Conserva el fragmento que respalda cada marca. Así se pueden resolver los desacuerdos sin convertir la interpretación del modelo en un juicio sobre la persona entrevistada.
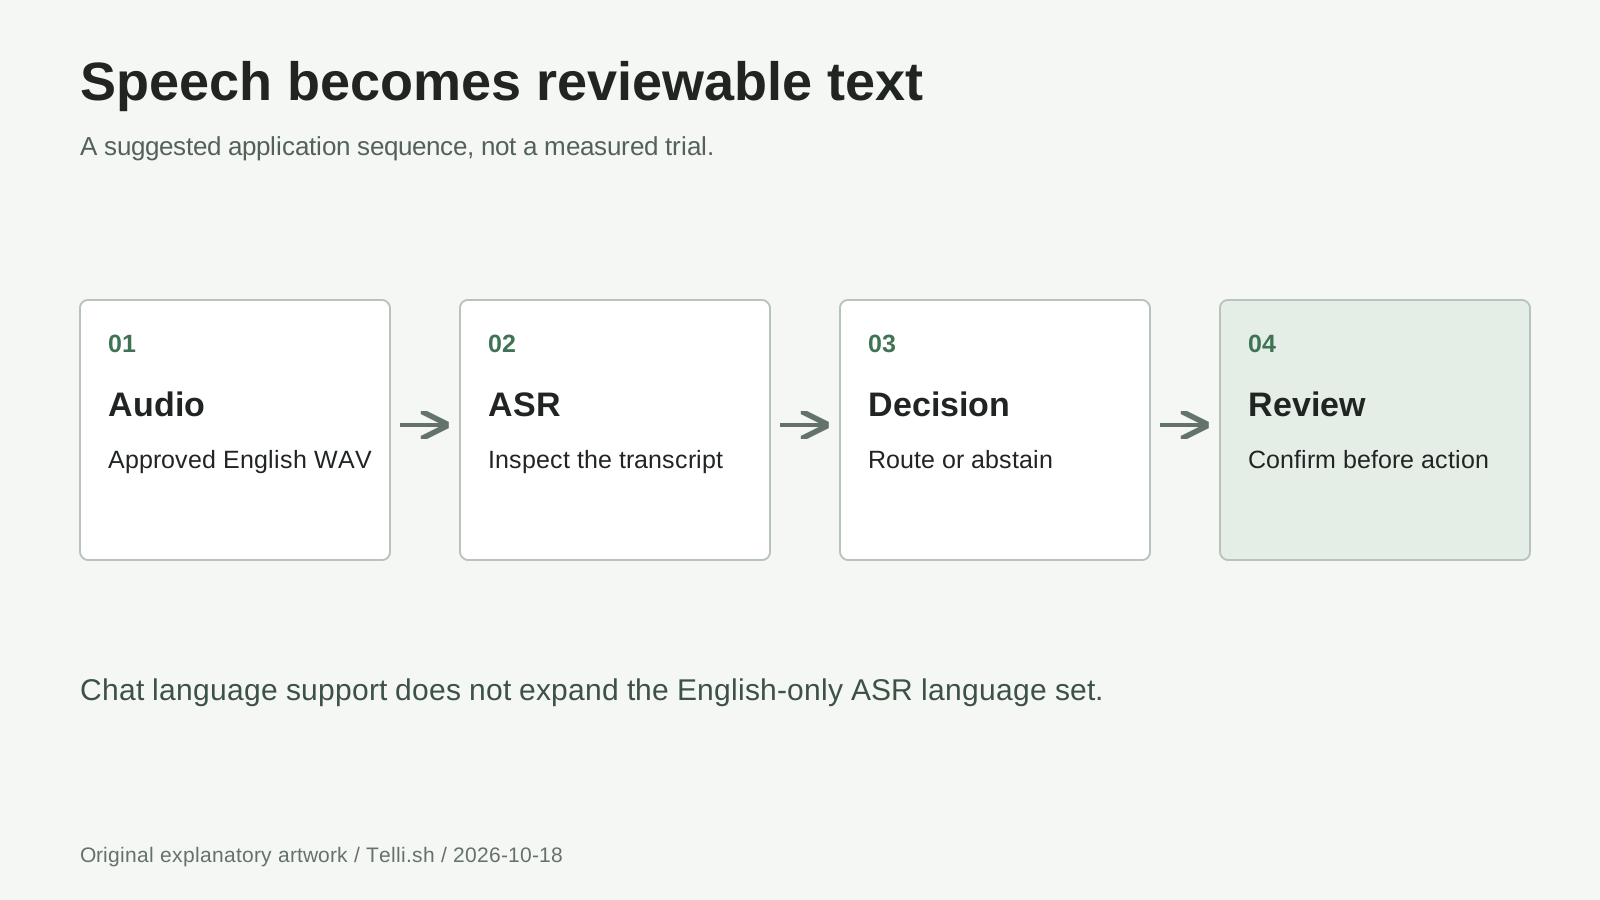
Esquema original del flujo: conservar el audio y la transcripción, producir resultados derivados por separado y revisarlos antes de actuar. Ilustra los usos anteriores, no es una interfaz oficial; la cadena subyacente se describe en la guía de audio, consultada el 18 de octubre de 2026.
¿Cómo pueden varias capacidades compartir el mismo contexto?
Una caché de clave/valor almacena información de atención calculada a partir de tokens anteriores. LoRA activado, o aLoRA, permite activar una especialización después de un contexto compartido, en vez de exigir que un adaptador normal vuelva a procesar todo el prefijo. IBM presentó el enfoque subyacente en una explicación de investigación publicada el 17 de abril de 2025. Investigación de IBM sobre aLoRA.
Switch usa el estado normalizado de la caché del modelo base para que las especializaciones no consuman el estado adaptado privado de las demás. En una aplicación, conserva idéntico el prefijo con las pruebas y añade al final la pregunta específica de cada tarea. Si reescribes la transcripción de forma diferente para cada comprobación, perjudicas la reutilización del prefijo. Documentación del mecanismo de Switch, consultada el 18 de octubre de 2026.
Compartir la caché es un mecanismo de eficiencia, no inferencia gratuita. La caché de prefijos ahorra procesar repetidamente una misma instrucción; no elimina la generación de respuestas ni el reconocimiento del audio. Documentación de vLLM sobre caché de prefijos, consultada el 18 de octubre de 2026. Nuestra conclusión: compara flujos completos con revisión, no cifras de velocidad aisladas.
Calcula el uso total, no solo los pesos de 8B
Como cálculo de planificación, 8.000 millones de parámetros a dos bytes cada uno ocupan unos 16 GB, o 14,9 GiB; 30.000 millones ocupan unos 60 GB, o 55,9 GiB. Son ejemplos aritméticos para los pesos base, no el tamaño de un checkpoint ni los requisitos mínimos de VRAM. No incluyen adaptadores, el codificador de voz, la caché, los búferes temporales ni la sobrecarga del entorno.
Un contexto más largo y un mayor número de secuencias simultáneas elevan la presión sobre la memoria. El límite máximo de contexto anunciado para el modelo no es una recomendación para reservarlo en el primer experimento. La documentación de vLLM indica que reducir max_model_len y max_num_seqs sirve para controlar la memoria. Pautas de memoria de vLLM, consultadas el 18 de octubre de 2026.
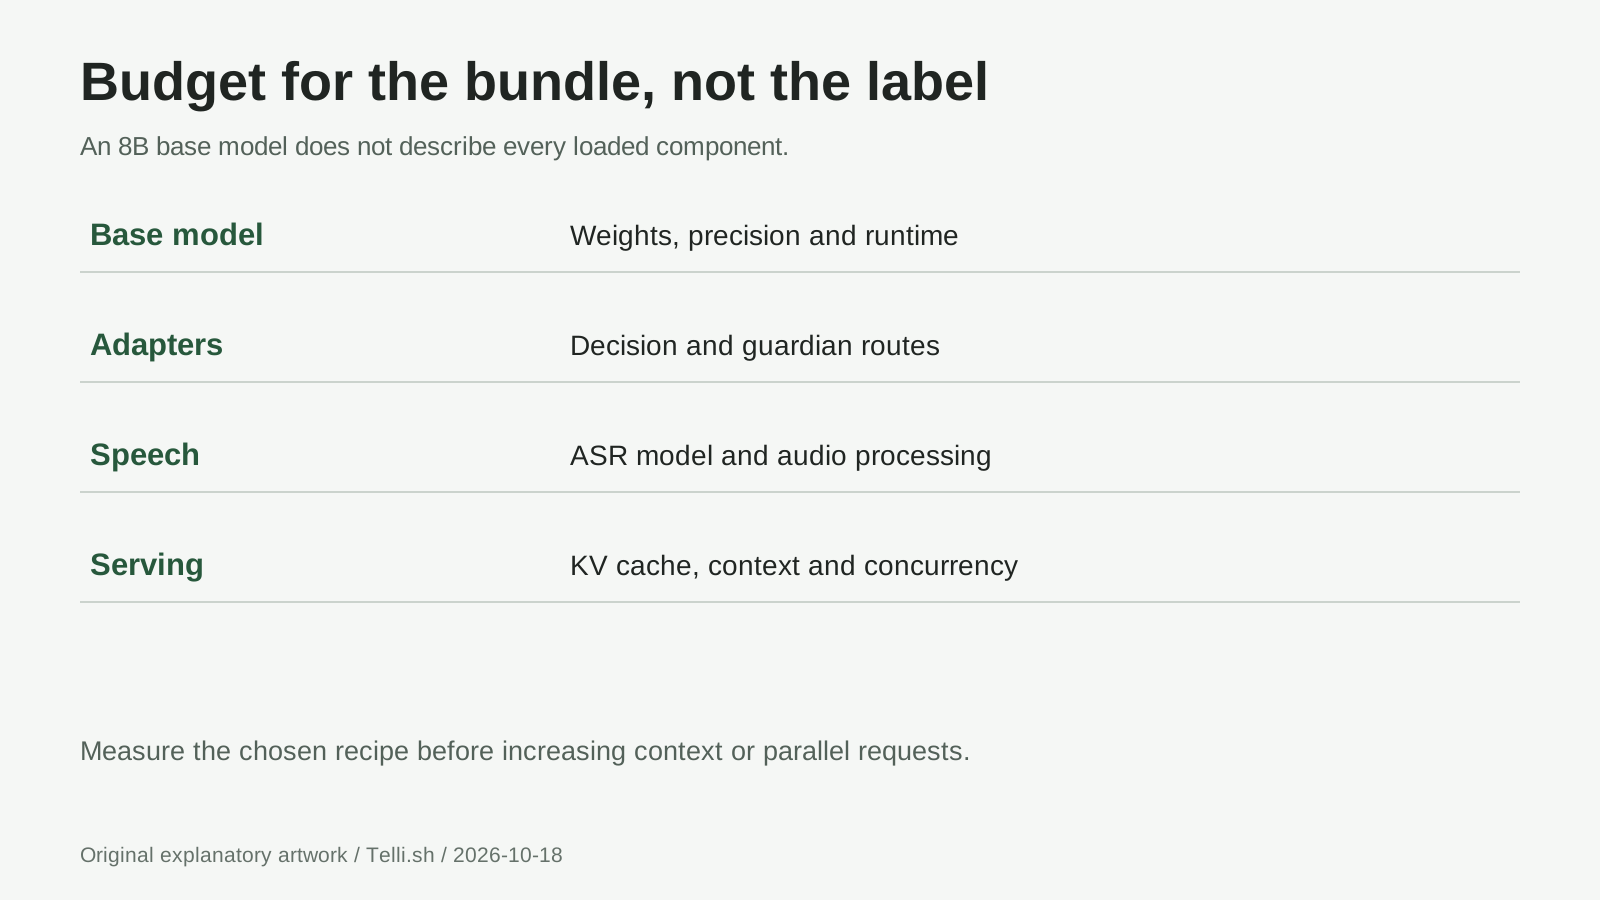
Lista de comprobación original de memoria, no una distribución proporcional: pesos base + adaptadores + pesos y activaciones del ASR + caché KV + margen para el entorno y la pantalla. La guía de audio advierte que reservar previamente la caché puede dejar espacio insuficiente para el ASR; consultada el 18 de octubre de 2026.
Prueba por separado un chat breve, un clip corto y la entrada más larga que uses normalmente. Anota los picos de memoria observados, el tiempo de respuesta y los errores. Reducir la memoria asignada a la caché puede dejar más espacio para la voz, pero no hará que quepan unos pesos demasiado grandes. Una alternativa cuantizada requiere comprobar su compatibilidad con los adaptadores y el audio de Switch, no basta con que ocupe menos al descargarla.
Vincula los costes y la privacidad a la decisión de despliegue
Una licencia Apache-2.0 para el modelo no hace que ejecutarlo sea gratis. El uso local consume hardware, electricidad, almacenamiento y tiempo de mantenimiento; un endpoint alojado añade la facturación del proveedor y sus condiciones de tratamiento de datos. No des por hecho que haya una tarifa universal de Granite Switch por minuto. Para un piloto, divide el coste total de cómputo y revisión entre los elementos completados correctamente, incluidas las solicitudes fallidas y las correcciones.
Un presupuesto hipotético sencillo lo hace más tangible: 10 horas a una tarifa de 1 USD por hora suman 10 USD de cómputo, antes del almacenamiento, la transferencia y la revisión humana. Son cifras ilustrativas, no una tarifa de servicio. También importan las horas en que el endpoint está inactivo.
Para trabajo delicado, decide dónde residirán el audio, las transcripciones, las cachés, los registros y las copias de seguridad antes de grabar. Vincularse a la interfaz de bucle local limita el acceso de red, pero no establece reglas de conservación ni desactiva toda la telemetría de las bibliotecas. Mantén el servidor fuera de interfaces públicas, revisa las dependencias y los registros, obtén permiso de quienes hablan y define por separado cuándo borrar el audio original y los registros derivados. Una demo alojada es útil para aprender, no el destino predeterminado de reuniones confidenciales.
Corrige la etapa que falla antes de cambiar toda la pila
No se conoce la arquitectura. Comprueba que el entorno virtual contiene granite-switch, que vLLM usa ese entorno y que VLLM_PLUGINS incluye register_granite_switch. Lee el primer error al importar el complemento antes de sustituir paquetes.
El chat funciona, pero el audio falla. Confirma el identificador de la versión con audio, las dependencias de [audio] y que sea un WAV real, no un archivo renombrado. Revisa la versión de Transformers y la memoria disponible. Instalar bibliotecas de decodificación no convierte una versión preliminar solo de texto en un checkpoint de audio.
Los nombres o la puntuación son incorrectos. El reconocedor CTC inglés predeterminado produce texto en minúsculas, sin puntuación y sin ajuste del idioma durante la decodificación. Conserva ese texto sin procesar; cualquier restauración de puntuación es una edición derivada. La cadena puede propagar los errores de transcripción a decisiones posteriores. Limitaciones de audio, consultadas el 18 de octubre de 2026.
Un clip largo supera el contexto. Acorta la entrada o divídela en secciones con sentido, conservando las referencias al original. La transcripción consume contexto de texto; debe quedar espacio suficiente para la pregunta y la respuesta. Aumentar el límite de contexto también cambia el presupuesto de memoria.
¿Qué deberías saber antes de confiar en él?
¿Puede leer las respuestas en voz alta? Esta ruta de voz integrada es ASR, no síntesis de voz. Una aplicación que produzca voz necesita un componente TTS aparte.
¿Puede transcribir los 12 idiomas del chat? No con el reconocedor inglés predeterminado. La guía de audio explica cómo sustituir el backend de ASR para admitir entrada multilingüe; es otra configuración que requiere evaluación.
¿Una probabilidad de 0,95 para una opción significa que acertará el 95 % de las veces en el mundo real? No. Representa la distribución del modelo entre las opciones proporcionadas, no una tasa de éxito verificada en tu ámbito. Si faltan opciones, la transcripción es mala o la pregunta es ambigua, el modelo aún puede mostrar una preferencia marcada. Evalúa ejemplos etiquetados y define cuándo abstenerse antes de automatizar acciones. Documentación del adaptador de decisiones, consultada el 18 de octubre de 2026.
¿Guardian demuestra que una respuesta es verdadera? No. El análisis de seguridad es distinto de la verificación factual. La versión lista para usar no incluye todos los especialistas de la colección más amplia Granite Libraries; revisa el inventario de adaptadores antes de diseñar un flujo de verificación de hechos.
En resumen: un solo endpoint sigue necesitando un rastro de pruebas
Granite Switch 4.1 resulta más útil cuando el chat explica, el habla aporta palabras que se pueden revisar y las decisiones acotadas organizan lo que sucede después. Su diseño modular de servicio reduce la duplicación de infraestructura; tu flujo sigue siendo responsable del consentimiento, las pruebas y la autoridad para actuar.
Empieza con una grabación breve y una decisión reversible. Amplía el flujo solo cuando la transcripción, la interpretación y la acción sigan siendo comprensibles para la persona responsable del resultado.
Fuentes
Fechas de publicación: el artículo de lanzamiento de IBM está fechado el 15 de octubre de 2026; la ficha del modelo 8B indica el 14 de octubre de 2026. La documentación enlazada se consultó el 18 de octubre de 2026. Las instrucciones de instalación se basan en documentación primaria, no en resultados de rendimiento obtenidos de primera mano. Los diagramas son esquemas editoriales originales; no se reproducen imágenes del proveedor.
- Artículo de lanzamiento de IBM, ficha del modelo 8B, ficha del modelo 30B y ficha de la versión preliminar 3B: alcance del lanzamiento y diferencias entre checkpoints.
- Repositorio Granite Switch, requisitos fijados del paquete y guía de audio: instalación, arquitectura y límites de voz.
- Demo oficial de voz, documentación de la demo y cuaderno oficial sobre la carrera aLoRA: demostraciones para explorar, no resultados medidos en esta guía.
- Explicación de IBM sobre aLoRA del 17 de abril de 2025 y documentación de vLLM: mecanismos y requisitos operativos comentados arriba.
Recomendación opcional de Telli.sh: conserva las fuentes que sustentan la decisión
Guarda juntas las grabaciones originales, tus notas y los resultados revisados para que las decisiones posteriores tengan contexto. Crea una cuenta de Telli.sh para organizar ese material de referencia a medida que evolucione tu flujo.