GPT-6 Cyber kieruje uwagę na zakres testu bezpieczeństwa
Model cyberbezpieczeństwa OpenAI z ograniczonym dostępem pokazuje różnicę między znalezieniem luki, sprawdzeniem jej w dozwolonym zakresie i wydaniem poprawki.
Opiekun projektu dostaje zgłoszenie błędu w przeglądarce. Zanim poprosi agenta o odtworzenie problemu, zespół potrzebuje kompilacji testowej, jasnego wykazu dozwolonych systemów i zapisu zmiany, która usunie błąd. Znalezienie prawdopodobnej słabości to początek pracy.
OpenAI zaprezentowało GPT-6 Cyber 5 listopada i podało, że początkowo z API i Codex mogą korzystać wybrani zatwierdzeni klienci Daybreak Red. Firma opisuje model jako uczony badania podatności i przestrzegania zakresu autoryzowanych testów. Towarzyszące wyniki oraz wykaz poprawek wydanych przez Mozillę w Firefoksie pozwalają przyjrzeć się zarówno odkrywaniu błędów, jak i procesowi dostarczania ochrony użytkownikom.
Budynek w San Francisco, w którym mieściła się siedziba OpenAI w czerwcu 2025 roku. Zdjęcie kontekstowe Coolcaesar, wykadrowane i przeskalowane, CC BY 4.0. Źródło zdjęcia · Licencja.

Przydatny test ma granice, które narzędzia mogą egzekwować
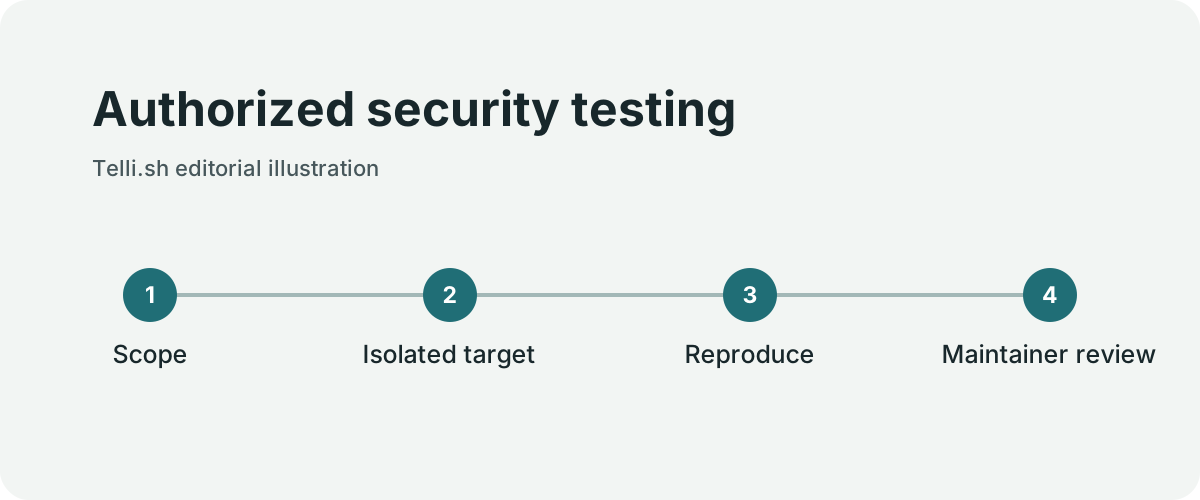
Autoryzowany test bezpieczeństwa. Autorska ilustracja Telli.sh.
Zespół bezpieczeństwa może pozwolić agentowi przejrzeć repozytorium, uruchomić test wobec lokalnej usługi i napisać projekt poprawki. Dostęp do repozytorium testowego nie daje prawa do skanowania powiązanych usług ani kontaktowania się z innymi hostami. Jasno określ dozwolony cel i egzekwuj ten zakres w środowisku.
| Decyzja | Konkretny zakres testu |
|---|---|
| Cel | Wskazane repozytorium, kompilacja testowa i odizolowana usługa testowa |
| Dane | Dane syntetyczne lub wyraźnie zatwierdzone do testu |
| Działania | Określony zestaw narzędzi do kompilacji, testów i analizy |
| Punkt zakończenia | Minimalny przykład odtworzenia i raport dla osoby weryfikującej |
| Publikacja | Plan ujawnienia i wydania zaakceptowany przez opiekuna projektu |
Zatwierdzony zakres można traktować jak umowę między operatorem a narzędziami. Ograniczenie sieci chroni granicę, nawet gdy model błędnie zrozumie polecenie. Uprawnienia narzędzi mogą blokować zapisy w systemach niezwiązanych z zadaniem. Logi pozwalają sprawdzić, do których zasobów rzeczywiście uzyskano dostęp.
Szczegóły zależą od środowiska. Kompilacja bez dostępu do sieci może wystarczyć przy błędzie parsera. Test funkcji sieciowej może wymagać usługi, którą uruchomisz i wyraźnie dopuścisz do tego celu. W obu przypadkach zespół powinien móc odtworzyć zakres z zapisu. Ogólne instrukcje w rodzaju „przetestuj, co trzeba” utrudniają ustalenie, kiedy praca się kończy i co ma sprawdzić następna osoba.
Dwa pytania testowe wymagają osobnych odpowiedzi
Wynik OpenAI z ExploitGym porównuje skuteczność w zadaniach, w których system dostaje wskazaną podatność do wykorzystania. Firma podała 48,5% dla GPT-6 Cyber i 32,1% dla GPT-5.6 Cyber. To 16,4 punktu procentowego różnicy w opisanym teście. Osobny test badał, czy model pozostawał w granicach zadania w odizolowanym środowisku.
To odrębne wyniki. System, który skuteczniej odtwarza lukę, daje zespołowi szansę szybszego zweryfikowania zgłoszenia. Przestrzeganie zakresu trzeba sprawdzać równolegle z tą umiejętnością. OpenAI podało wysoką zgodność z zakresem w warunkach testu, w tym komplet poprawnych wyników z instrukcją używaną przy wdrożeniu. Plan operacyjny nadal wymaga wyraźnej granicy i przeglądu.
Zwróć uwagę na punkt wyjścia każdego testu. Mając znaną lukę i cel laboratoryjny, agent może skupić się na odtworzeniu zachowania. Opiekun otrzymujący niejasne zgłoszenie musi ustalić, czy problem występuje, których wersji dotyczy i co zmieni poprawka. Do tych decyzji potrzeba danych z rzeczywistej bazy kodu.
Poprawka Firefoksa ma własne okno wydania
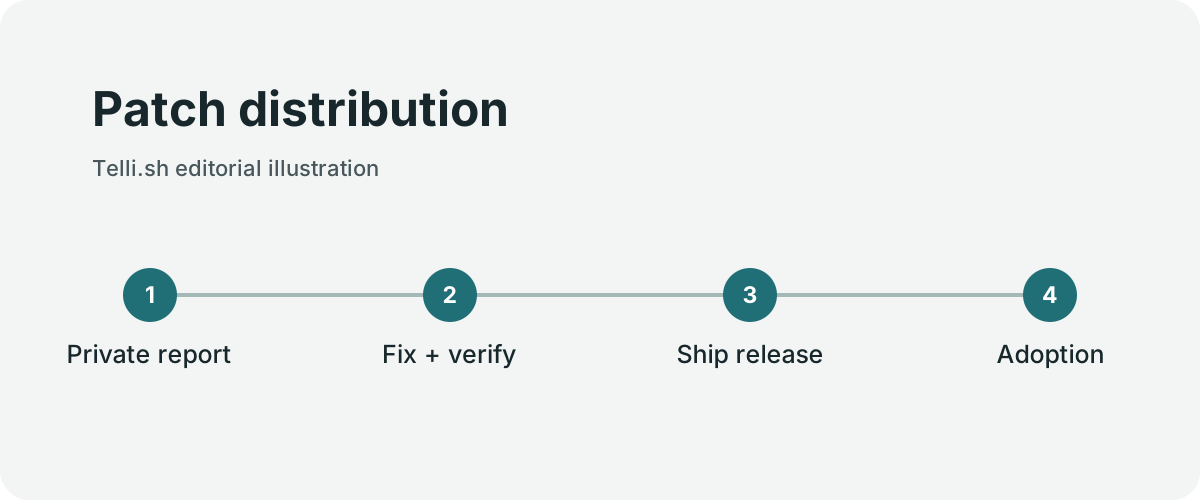
Dystrybucja poprawki. Autorska ilustracja Telli.sh.
OpenAI podało, że model pomógł znaleźć wcześniej nieznane problemy o wysokiej wadze w Firefoksie, i odesłało do biuletynu Mozilli dla Firefoksa 159. Biuletyn niezależnie potwierdza wydanie poprawek w tej wersji. Wskazuje komponenty, wagę i informacje o wydaniu. Liczby i przypisanie odkryć modelowi w komunikacie OpenAI pochodzą z własnego projektu badawczego firmy.
Wyjaśnienie Mozilli z 29 października dotyczące okresu między ujawnieniem poprawki a jej instalacją przedstawia drugą część pracy. Gdy poprawka jest widoczna, zanim zainstaluje ją znaczna część użytkowników, ktoś może wywnioskować naturę problemu z samej zmiany. Wprowadzenie poprawki do repozytorium, jej udostępnienie przez aktualizację i instalacja u użytkowników następują w różnych momentach. Zespół bezpieczeństwa musi skoordynować wszystkie trzy.
Dlatego warto ustalić, co i kiedy można udostępnić. Zwięzły przykład odtworzenia pomaga opiekunom sprawdzić poprawkę. Przedwcześnie opublikowany przykład może też ułatwić atak na niezałataną wersję. Postępuj zgodnie z zasadami ujawniania projektu i pozwól osobom odpowiedzialnym za wydanie zweryfikować treść oraz termin.
Przygotuj materiał, który inna osoba może odtworzyć
- Zapisz systemy, wersje, dane i dozwolone działania. Pracuj w środowisku, którego dostęp do sieci i narzędzi odpowiada temu zakresowi.
- Zadaj modelowi precyzyjne pytanie, na przykład czy opisana regresja występuje w objętej zgłoszeniem kompilacji testowej. Trzymaj poświadczenia produkcyjne i niepowiązane usługi poza środowiskiem.
- Poproś o wskazanie komponentu, minimalny test w dozwolonym środowisku i dowód odróżniający zgłoszone zachowanie od zwykłego błędu.
- Sprawdź proponowaną poprawkę na tym teście i na istniejących zachowaniach. Niech opiekun przejrzy zmianę i jej możliwe skutki uboczne.
- Zapisz potwierdzone ustalenia, wersje objęte problemem i sposób dostarczenia poprawki. Dopóki sprawa nie jest ujawniona, korzystaj z prywatnego kanału zgłoszeń projektu.
- Śledź wydanie i instalację jako osobne zdarzenia. Po udostępnieniu aktualizacji zespoły wsparcia i operacji mogą pomóc użytkownikom rozpoznać wersję z poprawką i na nią przejść.
Dobry materiał zawiera też wynik negatywny. Jeśli zgłoszenia nie da się odtworzyć w oczekiwanych warunkach, dokładny opis pomoże następnej osobie zamknąć sprawę albo spróbować na innych danych. Taki zapis jest cenniejszy niż stanowczy wniosek, którego nie można sprawdzić ponownie.
Sprawdź, czy poprawka nie wprowadza regresji
Opiekun może zacząć od zgłoszenia testera, któremu przeglądarka lub usługa uległa awarii podczas przetwarzania nieprawidłowego przykładu. Pierwsze pytanie brzmi, czy problem można powtórzyć na wskazanej wersji przy udokumentowanej konfiguracji. Model z ograniczonym zakresem może uporządkować właściwe logi, wskazać prawdopodobny komponent i przygotować minimalny materiał do przeglądu. Inny członek zespołu powinien móc odtworzyć obserwację w tym samym odizolowanym środowisku.
Weryfikacja poprawki wymaga osobnego testu. Uruchom pierwotny przypadek na podatnej wersji i na wersji kandydującej, a następnie sprawdź zwykłe zachowania w pobliskich ścieżkach. Poprawka może zatrzymać awarię przez pominięcie kodu potrzebnego użytkownikom. Wynik ma pokazać, czy wadliwe dane zostały obsłużone prawidłowo i czy prawidłowe wejścia nadal działają. Zapisz ten stan przed oceną, jak szybko model zaproponował wyjaśnienie.
Osoba odpowiadająca za wdrożenie ma potem kolejną decyzję. Poprawka w gałęzi źródłowej i poprawka na urządzeniach dotkniętych problemem to różne etapy. Ustal, jak zmiana dotrze do wspieranych kanałów wydania, zarządzanych urządzeń i pakietów downstream. Dla usługi sprawdź wersje faktycznie obsługujące ruch oraz tempo wycofywania starszych instancji. Wynik testu dotyczy konkretnej wersji i nie zastępuje dowodu wdrożenia.
Stosuj różne mianowniki w pomiarze skuteczności i zakresu
OpenAI podaje, że projekt GPT-6 Cyber ujawnił 81 wcześniej nieznanych problemów sklasyfikowanych przez Mozillę jako wysokiej wagi i doprowadził do 30 ponownych ocen wagi. To opis projektu OpenAI. Biuletyn Firefoksa 159 dokumentuje poprawki i autorstwo zgłoszeń w danym wydaniu. Źródła odpowiadają na inne pytania i razem pomagają, bo biuletyn wskazuje konkretną wydaną wersję do sprawdzenia.
ExploitGym Honeypot OpenAI to osobna ocena zakresu. Raport podaje 99,93% bez instrukcji i 100% z instrukcją wdrożeniową w opisanej konfiguracji. Liczby dotyczą zachowania w teście dostawcy. Czytaj je razem z warunkami i niepowodzeniami, zachowując ograniczenia sieci klienta, listę dozwolonych celów i sprawdzanie zgody operatora. Osobny wynik skuteczności ExploitGym porównuje odsetek rozwiązanych zadań technicznych.
Wewnętrzny test może przenieść to rozróżnienie na praktykę. Przetestuj zadanie w zakresie i nieszkodliwy przypadek spoza zakresu. Przydatny asystent zrobi postęp w pierwszym. Środowisko musi zablokować działania w drugim, nawet jeśli model je zasugeruje. Traktuj tekst z logów i stron jako dane, także gdy przedstawia się jako nowa instrukcja. Zachowaj zapis wykonania, aby operator mógł odróżnić działanie proponowane, odrzucone i faktycznie wykonane.
Zamknij zgłoszenie, gdy właściwe osoby mogą potwierdzić wynik
Opiekun może potrzebować małego prywatnego pakietu dowodów dla właściciela komponentu i osobnej noty dla użytkowników. Usuń z obu zbędne dane celu. Przydatny pakiet wewnętrzny zawiera testowaną wersję, dozwolony zakres, bezpieczny sposób odtworzenia, proponowaną poprawkę i wyniki weryfikacji. Nota publiczna powinna powstać według zasad ujawniania projektu.
Sprawdzianem procesu jest zweryfikowana poprawka, która może dotrzeć do użytkowników bez przedwczesnego ujawnienia. Osobno zapisz czas odtworzenia, przeglądu, wydania i instalacji. Szybsze pierwsze dochodzenie ma wartość, gdy prowadzi do szybszego potwierdzonego wyniku. Lepszy model może obniżyć koszt pierwszego etapu, pozostawiając wydanie i aktualizację jako główne ograniczenie.
Śledź naprawioną kompilację od wydania do instalacji
Zespół przeglądarki może mieć stabilny kanał dla komputerów, kanał długiego wsparcia i kompilacje rozprowadzane przez zewnętrzne menedżery pakietów. Poprawka może pojawić się na każdej ścieżce w innym momencie. Osoba odpowiedzialna za wydanie musi wiedzieć, która kompilacja jako pierwsza zawiera poprawkę, kiedy użytkownicy każdego kanału mogą ją pobrać i czy urządzenia zarządzane już ją zainstalowały. Biuletyn może wskazać wersję po naprawie, a inwentarz wdrożenia pokazać, ile urządzeń wciąż ma starszą.
| Etap | Dowód | Pytanie operacyjne |
|---|---|---|
| Kandydat zawiera poprawkę | Test regresji na wersji kandydującej | Czy obsługuje przypadek testowy i zwykłe dane wejściowe? |
| Wydano wspieraną kompilację | Artefakt wydania i biuletyn | Jakie wersje mogą pobrać użytkownicy? |
| Zaktualizowano zarządzane urządzenia | Inwentarz lub raporty wersji | Które urządzenia nadal wymagają aktualizacji? |
| Uwzględniono urządzenia offline | Potwierdzenie właściciela lub planowany termin | Co pozostaje poza zwykłą dystrybucją? |
Przedsiębiorstwo zarządzające klientami może porównać ich inwentarz z listą wersji w biuletynie. Może mieć też maszyny szkoleniowe albo laboratoryjne, które zwykle są offline. Wymagają innego przekazania sprawy. Wyznacz osobę odpowiedzialną za wspieraną procedurę aktualizacji i zapisz, kiedy będzie można potwierdzić wersję z poprawką. Urządzenia, z których nie ma odpowiedzi, oznacz jako niezweryfikowane.
Weź pod uwagę okres między ujawnieniem poprawki a aktualizacją, gdy ustalasz termin i zakres publikacji dowodów. Materiał Mozilli wyjaśnia ryzyko między widoczną zmianą a zainstalowaniem wersji. Zespół autoryzowanych testów może trzymać dane do odtworzenia w zatwierdzonym procesie przeglądu, gdy właściciel wydania przygotowuje kompilacje i zabezpieczenia. Ustal termin ponownego sprawdzenia instalacji i raportuj to, co można ustalić z danych.
Dla małej usługi wewnętrznej można użyć identyfikatora wdrożenia i logów ruchu zamiast telemetrii aktualizacji przeglądarki. Test podstawowy na nowej instancji potwierdza, że działa. Starsze instancje mogą jeszcze obsługiwać ruch w trakcie wycofywania. Dołącz do zapisu wersję testowaną, wersję obsługującą ruch i czas zakończenia, by późniejszy przegląd incydentu mógł ustalić, kiedy ryzyko faktycznie się zmieniło.
Mierz czas do zweryfikowanej poprawki
Model cyberbezpieczeństwa może przyspieszyć weryfikację i wykryć przypadki, które umknęły zespołowi. Korzyść ma największe znaczenie, gdy opiekun widzi zakres, odtwarza wynik i odpowiedzialnie dostarcza poprawkę. Zmierz, ile czasu potrzeba, by rzeczywisty problem przeszedł od rzetelnego zgłoszenia do zweryfikowanego wydania. Ta miara łączy możliwości modelu z celem pracy.
Źródła
-
Komunikat OpenAI z 5 listopada o GPT-6 Cyber wraz z kartą systemu
-
Biuletyn Mozilli o podatnościach naprawionych w Firefoksie 159
-
Wyjaśnienie Mozilli z 29 października o okresie między ujawnieniem poprawki a jej instalacją
Jeśli chcesz przechowywać rozmowy i decyzje związane z pracą w formie, którą można przeszukiwać, załóż konto Telli.sh.