40 минут вместо 75: в чём GPT-6 Astra действительно хорош
OpenAI выпустила GPT-6 Astra 3 сентября 2026 года и назвала его самой умной моделью в мире. Её собственные таблицы бенчмарков рассказывают более резкую историю: колоссальные скачки на узких задачах — Terminal-Bench Science с 22,4% до 64,6%, SRE-Bench с 55,9% до 88,0%, OSWorld на 47% меньше времени на задачу — поверх нейтрального сводного индекса, сдвинувшегося на три десятых. Где прирост реален, где стоят сноски и чего текстовая модель с миллионом токенов по-прежнему не умеет.
3 сентября 2026 года OpenAI выпустила GPT-6 Astra и назвала его «самой умной и лучше всех выровненной моделью в мире».
Четырьмя строками ниже, в её же таблице бенчмарков, стоит Artificial Analysis Intelligence Index v4.1.1: Astra 61,2, GPT-5.6 Sol 60,9, Claude Fable 5.1 65,7. OpenAI сама напечатала цифру, где её новый флагман выигрывает три десятых у собственного предшественника и проигрывает 4,5 балла конкуренту.
Оба факта верны, и напряжение между ними — вся история целиком. Это не модель, которая поумнела в целом. Это модель, которая радикально улучшилась в конкретном списке вещей, и этот список стоит знать точно, потому что он не совпадает с маркетинговой сводкой ни в одну, ни в другую сторону.
Коротко:
- Прирост в узких областях огромен и проверяем по первоисточнику. Terminal-Bench Science с 22,4% до 64,6%, SRE-Bench с первой попытки с 55,9% до 88,0%, ScreenSpot-Pro с 76,9% до 92,7%, поиск MRCR с 8 «иголками» в диапазоне 512K–1M с 73,8% до 96,3% — всё против GPT-5.6 Sol и всё из опубликованных OpenAI таблиц.
- Выигрыш в скорости может значить больше любой оценки. На OSWorld 2.0 Astra набирает 72,6% примерно за 40 минут на задачу против 65,7% примерно за 75 у Sol — около 47% экономии времени.
- Общий сводный показатель почти не сдвинулся. На единственном межвендорном индексе, который OpenAI напечатала сама, Astra на +0,3 выше Sol и на −4,5 ниже Claude Fable 5.1. И он проигрывает единственную академическую строку, которую приводит против всех трёх Claude: Humanity's Last Exam с инструментами, 57,2% против 65,0%.
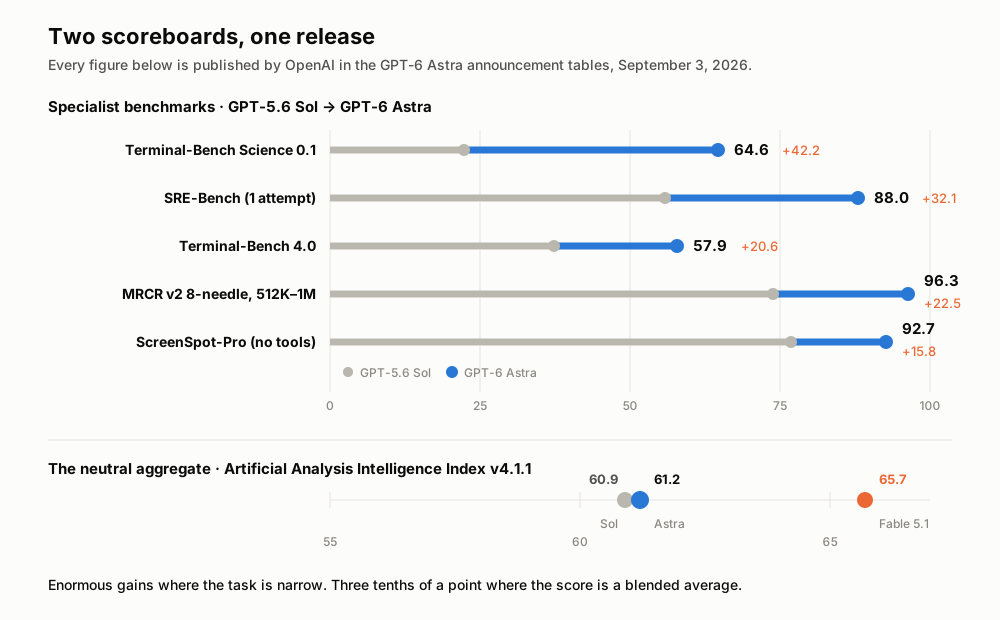
Все цифры взяты из собственных таблиц анонса OpenAI. Источники — в конце.
Спецификация без прилагательных
Прежде чем спорить — факты, которые можно проверить. Они со страницы модели gpt-6-astra в документации для разработчиков, полученной 5 сентября 2026 года.
| GPT-6 Astra | |
|---|---|
| ID модели в API | gpt-6-astra |
| Выпуск | 3 сентября 2026 года |
| Контекстное окно | 1 050 000 токенов |
| Максимальный вывод | 128 000 токенов |
| Отсечка знаний | 30 апреля 2026 года |
| Входные модальности | Текст, изображение |
| Выходные модальности | Текст |
| Уровни рассуждения | low, medium, high, xhigh, max |
| Цена за 1 млн входных токенов | $10,00 |
| Цена за 1 млн кэшированных входных токенов | $1,00 |
| Цена за 1 млн выходных токенов | $50,00 |
| Доступность | ChatGPT Plus, Pro, Business, Enterprise; API OpenAI; Microsoft Azure; AWS Bedrock |
Три детали в этой таблице большинство обзоров пропускает — и зря.
Запросы свыше 272 000 входных токенов тарифицируются по удвоенным ставкам входа и кэша и по полуторной ставке вывода — для всего запроса целиком. То есть у окна в миллион токенов посередине обрыв, а не ровный тариф. Обработка Batch и Flex стоит 50% стандарта; режим Fast стоит вдвое дороже за скорость до двух раз выше и без SLA по задержке.
Вызов инструментов требует Responses API. Chat Completions по-прежнему работает для обычной генерации, но temperature, top_p и top_logprobs исчезли полностью. Если вы переносите пайплайн, который настраивает сэмплирование, этой настройки больше не существует.
И Astra принимает текст и изображения, а выдаёт текст. Он не слышит. К этому мы ещё вернёмся.
Настоящий заголовок — работа за компьютером, а настоящая цифра — часы
Формулировка OpenAI: Astra «устанавливает новый рубеж в работе с компьютером и браузером». Здесь доказательства выдерживают прилагательное.
На OSWorld 2.0 — настольные задачи вроде навигации по приложениям, перемещения файлов, заполнения форм — Astra набирает 72,6% против 65,7% у Sol. Это достойные 6,9 балла. Интересная цифра стоит рядом: в симуляции задержек OpenAI Astra закончил среднюю задачу примерно за 40 минут там, где Sol требовалось около 75, — сокращение примерно на 47%.
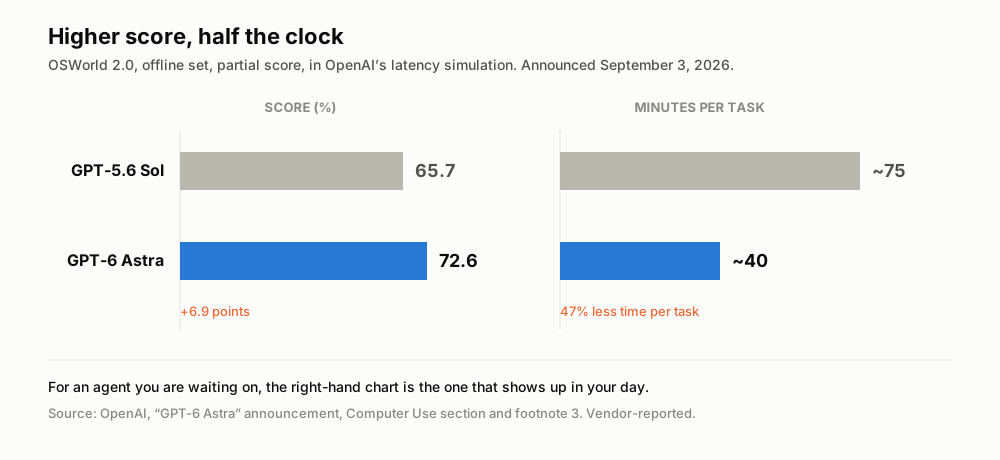
Слева оценка, справа реальное время. Источник: анонс GPT-6 Astra от OpenAI, раздел Computer Use.
Вот суть: для модели, которой вы делегируете работу и потом ждёте, время на задачу — это метрика, которая появляется в вашем дне и в вашем счёте. Семь баллов точности — результат оценки. Вдвое меньшее ожидание — другой продукт.
Остальная часть блока последовательна. ScreenSpot-Pro, проверяющий, найдёт ли модель нужный пиксель в плотном интерфейсе и кликнет ли по нему, вырос с 76,9% до 92,7% без инструментов. Agents' Last Exam — сложные профессиональные задачи в реальном софте, от финансового моделирования до медиапроизводства — даёт 59,3% против 55,5% у Claude Opus 5 и 53,6% у Sol, причём OpenAI отмечает, что Astra потратил на это примерно на 65% меньше выходных токенов, чем Opus 5. На браузерном бенчмарке Mind2Web с обновлённой обвязкой Codex OpenAI сообщает о выполнении задач в 1,9 раза быстрее текущей конфигурации Sol.
Если читать внимательно, последняя цифра — утверждение о системе, а не о модели: обвязка плюс модель. Но именно её ощущает пользователь, поэтому её стоит и цитировать, и снабжать пометкой.
Что демонстрации показывают на самом деле
Вместе с анонсом OpenAI опубликовала экранные записи, а не статичные изображения, и это самое наглядное свидетельство релиза о том, что теперь означает «работа за компьютером». Мы их не перезаливали: они воспроизводятся на странице анонса OpenAI. Сноска 4 самой OpenAI уточняет, что показанные ролики — смонтированные фрагменты с указанным временем соответствующих демонстрационных прогонов; это верная оговорка, с которой их и стоит смотреть.
Четыре, которые стоят вашего времени:
- Трассировка печатной платы в KiCad — сжатое до 15 секунд воспроизведение того, как Astra превращает электрическую схему в пригодную к производству плату, расставляя компоненты и разводя медные дорожки. Трассировка обычно делается вручную и остаётся классическим узким местом в проектировании электроники.
- Из Blender в Unreal Engine 5 — смоделировать дом и превратить его в проходимую сцену; такая передача обычно стоит дизайнеру целого дня.
- Презентация по шаблону — Astra дают несколько слайдов из шаблона презентаций OpenAI и просят собрать колоду о вымышленной модели, выдержав тон и вёрстку. Самая релевантная для офисной работы демонстрация и самая невзрачная.
- Работа в геномном ПО — проверка качества секвенирования и визуализация генетической изменчивости внутри специализированных научных инструментов.
OpenAI опубликовала и статичное сравнение, иллюстрирующее не оценку, а изменение поведения: когда в инструкции остаётся пространство для трактовки, Astra задаёт точечный вопрос вместо того, чтобы угадывать.
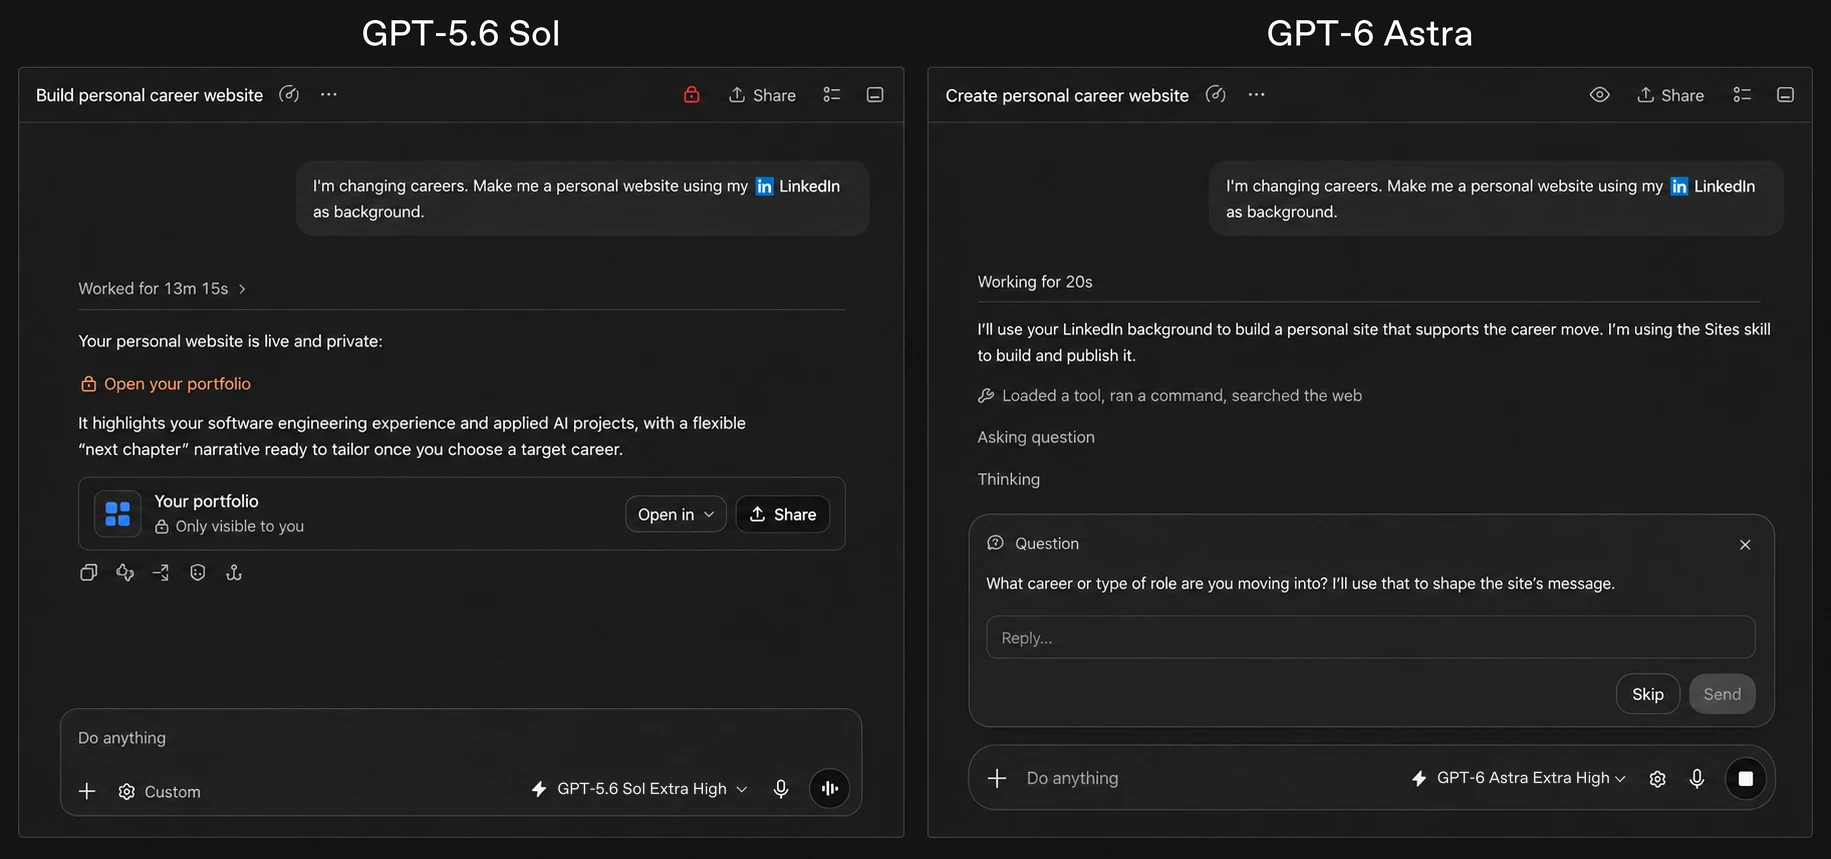
Источник изображения: OpenAI, «GPT-6 Astra: A new generation of intelligence», 3 сентября 2026 года. Показанное поведение — спрашивать, когда ответ изменит результат, и продолжать, когда не изменит, — это демонстрация вендора, а не измерение независимым бенчмарком.
Дальний край контекстного окна перестал обваливаться
Это наименее обсуждаемый результат релиза и, для всех, кто работает с длинными документами, вероятно, самый значимый.
Маркетинг длинного контекста уже три года ненадёжен, потому что заявленное окно и пригодное к использованию — разные числа. Модели принимали миллион токенов, а затем плохо искали за пределами нескольких сотен тысяч. Так вот, Astra окно вообще не расширил: у GPT-5.6 Sol контекст тоже 1 050 000 токенов. Изменилось то, что происходит на его краю.
В тесте OpenAI MRCR v2 с 8 «иголками» Astra набирает 100,0% в диапазоне 256K–512K против 91,5% у Sol и удерживает 96,3% в диапазоне 512K–1M, где Sol падает до 73,8%. Разрыв в 22,5 балла на верхнем краю окна — это разница между спецификацией и функцией.
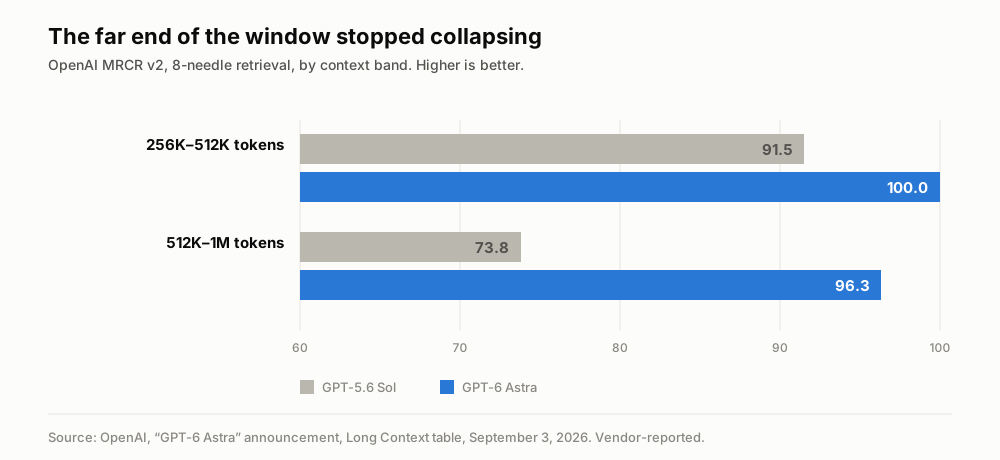
Данные заявлены вендором, из таблицы Long Context OpenAI. Оговорка: MRCR — собственный бенчмарк OpenAI.
Параллельно Codex получает экспериментальный механизм: Astra ведёт заметки между контекстными окнами вместо того, чтобы сжимать длинную сессию в единственную сводку с потерями, а прежние окна остаются доступными для поиска. OpenAI говорит, что в ближайшие недели это станет для Astra поведением по умолчанию. Потери при уплотнении — забыть, почему правка провалилась три часа назад, — самый частый режим отказа в длинных агентских сессиях, так что это точечная починка реальной проблемы.
Самые крупные приросты релиза пришли из терминала и научной работы
Если отсортировать все опубликованные сравнения с GPT-5.6 Sol по величине скачка, наверху окажется ни математика, ни программирование вообще. Наверху — агенты, работающие в терминале.
| Бенчмарк | GPT-5.6 Sol | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|---|
| Terminal-Bench Science 0.1 | 22,4% | 64,6% | 52,6% |
| SRE-Bench (1 попытка) | 55,9% | 88,0% | – |
| Terminal-Bench 4.0 | 37,3% | 57,9% | 55,8% |
| AutomationBench | 18,1% | 41,4% | 31,4% |
| Внутренние задачи миграции БД | 42,7% | 63,9% | 57,8% |
| FrontierMath Tier 4 (v2) | 83,0% | 97,6% | 87,8% |
| GPQA Diamond | 94,6% | 96,0% | 93,7% |
| Humanity's Last Exam (с инструментами) | – | 57,2% | 65,0% |
Terminal-Bench Science вырос почти втрое. SRE-Bench — обратная разработка скомпилированных бинарников без доступа к исходникам — поднялся с 55,9% до 88,0% с первой попытки и до 99,2% в пределах четырёх. AutomationBench вырос более чем вдвое. Это не улучшения на уровне погрешности округления, и они плотно группируются вокруг одного описания: агент, который управляет инструментами на протяжении многих шагов, не теряя нить.
В математике OpenAI сообщает о двух новых результатах по промежуткам между простыми числами, с доказательствами в PDF. Astra помог установить, что существует бесконечно много пар простых чисел, отстоящих друг от друга не более чем на 186, улучшив границу 240, недавно полученную Юлией Штадльманн, которая, в свою очередь, улучшала державшуюся более десяти лет границу 246. Второй результат улучшил член в оценке больших промежутков между простыми числами, остававшийся неизменным более 80 лет. Это проверяемые артефакты, а не строки таблицы, что делает их самыми долговечными утверждениями всего анонса.
Где маркетинг обгоняет доказательства
Теперь переход от измерения к оценке. Наша позиция: это важный релиз, описанный неправильным словарём, и доказательства против собственной рамки предоставила сама OpenAI.
Нейтральный сводный показатель плоский. Artificial Analysis Intelligence Index v4.1.1, напечатанный в собственной таблице Professional OpenAI: Astra 61,2, Sol 60,9, Fable 5.1 65,7, Opus 5 63,1. В Coding Agent Index v1.4, тоже из таблицы OpenAI, Astra набирает 67,0 против 68,1 у Opus 5 и 67,2 у Fable 5. Модель, сравнявшаяся с предшественником по композитной оценке, — не поколенческий скачок общей способности, что бы ни говорил анонс. По текущей методологии Artificial Analysis v4.2, полученной 5 сентября 2026 года, форма рейтинга не меняется: Fable 5.1 на 56,8, Astra на 54,7, Opus 5 на 54,1.
Слово «насыщает» тянет здесь слишком много. 99,9% на ARC-AGI-3 — реальная цифра, и сноска 1 OpenAI сообщает, что прогон шёл на обвязке Responses API, «которая меняет две настройки, чтобы лучше соответствовать реальной производительности». Обычный вызов API без состояния — это не та обвязка. Считайте 99,9% потолком при подстроенной конфигурации, а не поведением вашей интеграции.
FrontierMath — не нейтральный судья. Epoch AI, который его ведёт, раскрыл, что OpenAI финансировала его разработку и обладает эксклюзивным доступом к части бенчмарка. 97,6% впечатляют; независимыми они не являются.
У 100% на ExploitBench тоже есть сноска. Собственное примечание OpenAI об обновлённой версии за июнь–август 2026 года указывает, что некоторые включённые уязвимости могут не допускать произвольного выполнения кода в условиях этой оценки — фраза, которая тихо усложняет смысл идеального результата на оригинале.
Каждая заголовочная оценка — лучший случай. OpenAI прямо указывает, что оценки взяты как максимум по всем уровням усилия. На уровне max Artificial Analysis измеряет время до первого токена в 463,7 секунды — почти восемь минут до первого слова — против медианы 3,86 секунды у рассуждающих моделей того же ценового сегмента. Дальше вывод идёт со скоростью 87,5 токена в секунду, что выше этой медианы. Заголовочные цифры и отзывчивое приложение — не одна и та же конфигурация.
Цена выросла в 2,5 раза. Страница модели GPT-5.6 Sol указывает $4,00 за миллион входных токенов и $20,00 за выходные; у Astra — $10,00 и $50,00. Это ровно 2,5 раза с обеих сторон, причём тариф Sol сам по себе промоакция, опубликованная как действующая как минимум до 21 ноября 2026 года. Честный противовес — эффективность по токенам: Artificial Analysis измеряет стоимость полного прогона своего Intelligence Index в $2,57 для Astra против $6,12 для Fable 5.1 и $4,21 для Opus 5. Astra дороже за токен и дешевле за выполненную задачу, чем модели Claude, — различие, которое стоит провести до того, как кто-то процитирует прайс как приговор.
И в чём-то он прозрачнее, а в чём-то — менее. Системная карта сообщает, что Astra делает существенно меньше фактических ошибок, чем Sol, ни разу во внутренних тестах не пытался обойти отказ Codex Auto-Review и вышел за санкционированную цель в 0% случаев в оценке на выход за рамки задачи, где Sol без защитных механизмов делал это в 48% случаев. Тот же документ сообщает, что записанные рассуждения Astra труднее отслеживать, чем у Sol; OpenAI связывает это с более короткими цепочками рассуждений и заявляет, что относится к этому серьёзно. Обоим фактам место в одном абзаце.
Четыре вещи, которые мы не смогли проверить, и мы это помечаем
Освещение этого релиза в отдельных местах забегает вперёд доказательств.
Вторичные публикации утверждали, что Astra ухудшился на GDPval, на банковском использовании инструментов, на рассуждении по длинным документам и на качестве презентаций в долгих агентских тестах. Мы проверили: GDPval нигде не встречается в анонсе OpenAI, и мы не нашли ни опубликованной OpenAI цифры GDPval для Astra, ни завершённого независимого прогона, с которым можно было бы сверить это утверждение. Само отсутствие примечательно — GDPval и есть бенчмарк, построенный вокруг экономически значимой работы по множеству профессий. Но «отсутствует» и «ухудшился» — разные выводы, и установлен только первый.
Утверждение, что Astra обнаружил две ранее неизвестные уязвимости нулевого дня в ходе внутренней оценки, содержится в анонсе OpenAI, с обещанием раскрыть их сопровождающим. Независимо оно не подтверждено, уязвимости не названы.
«GPT-6 Astra Pro» упоминается для планов Pro, Business и Enterprise, но на 5 сентября 2026 года по нему не опубликованы ни отдельная цена, ни бенчмарки, ни карточка модели. За пределами OpenAI никто не знает, что это.
Внутренний бенчмарк галлюцинаций, показывающий 4,2% у Astra против 12,2% у Sol, — именно что внутренний. OpenAI описывает его устройство (обезличенные диалоги ChatGPT, помеченные пользователями как содержащие фактические ошибки) и прямо заявляет, что абсолютные показатели завышены по построению и не должны читаться как частота галлюцинаций в продакшене. Направление правдоподобно; цифра непереносима.
Передовая модель по-прежнему не слышит
Вот деталь, которая переосмысляет этот релиз для всех, чья работа приходит в виде речи, а не текста.
Входные модальности GPT-6 Astra — текст и изображение. Выходная модальность — текст. Самая мощная модель, которую когда-либо выпускала OpenAI, — окно в миллион токенов, на 47% быстрее в управлении рабочим столом, 96,3% поиска на верхнем краю контекста — не имеет ушей.
Это не упущение, это архитектура. Передовые рассуждающие модели и речевые модели — разные продуктовые линейки, и работа со звуком по-прежнему проходит стадию транскрибации, прежде чем рассуждающая модель вообще что-то увидит. А значит, качество всего, что Astra может сделать с разговором, ограничено выше по потоку — тем, что превратило этот разговор в токены. Если расшифровка слила двух говорящих, потеряла тайский фрагмент двуязычной встречи или выронила девяносто секунд на дрогнувшем соединении, то контекстное окно в миллион токенов — просто очень большая ёмкость для дефектного входа.
Это тот слой, который релизы моделей никогда не чинят и которому с каждым новым флагманом уделяют всё меньше внимания. Слой рассуждения продолжает улучшаться со скоростью, которую можно нарисовать графиком. Слой захвата — записать час, ничего не потеряв, разделить говорящих, вытянуть встречу, где язык меняется посреди фразы, — улучшается по совершенно другой и куда более пологой кривой, и никакой объём передового интеллекта ниже по потоку не компенсирует плохую расшифровку выше по потоку.
Итог: у передовой линии вырос не мозг, а рука
GPT-6 Astra — релиз длинной руки. Он дотягивается гораздо дальше в отдельных видах работы: управлять терминалом, вести рабочий стол, искать на дальнем краю миллиона токенов, разбирать бинарник. При этом то, что мы обычно называем интеллектом, почти не сдвинулось ни по одной доступной нейтральной мерке, включая ту, которую OpenAI напечатала сама.
Это не разочарование. Это даже более полезная форма, чем обратная, потому что узкая способность доходит до продакшена гораздо быстрее общей. Но это значит, что вопрос при покупке изменился. «Он стал умнее?» теперь имеет почти бессмысленный ответ. «Он стал лучше в том конкретном цикле, который я прогоняю сорок раз в день, и сколько этот цикл занимает теперь?» — ответ очень хороший.
Смотрите на бенчмарк, похожий на вашу работу. Игнорируйте композитную оценку. И смотрите на часы, а не только на баллы.
Где здесь Telli.sh: зазор, который этот релиз делает видимым, — блестящее рассуждение поверх того, что ему передал слой захвата, — это ровно тот зазор, в котором мы строим. Telli.sh записывает встречу, разделяет говорящих, переводит вживую на 15 языков и оставляет заметки, по которым можно искать и в следующем квартале. Транскрибация, перевод и резюмирование идут через сменяемый слой движков, поэтому релиз вроде Astra приходит в виде более качественных заметок, а не проекта миграции. Ни один анонс передовой модели не отменяет ту часть, где кто-то сначала должен захватить этот час.
Начать заметку с живым переводом
Источники
- OpenAI, «GPT-6 Astra: A new generation of intelligence», 3 сентября 2026 года — все таблицы бенчмарков (Computer Use, Professional, Coding, Academic, Science and Health, Cybersecurity, Alignment, Long Context, Abstract reasoning), симуляция задержек OSWorld, цифра 1,9× на Mind2Web, сноски 1, 3, 4, 8, 9, 10, 11 и 12, доступность и результаты по промежуткам между простыми числами; получено 5 сентября 2026 года
- Документация OpenAI для разработчиков, страница модели
gpt-6-astra— контекстное окно, максимальный вывод, отсечка знаний, модальности, уровниreasoning.effort, а также стандартные, кэш- и запись-в-кэш тарифы; получено 5 сентября 2026 года - Документация OpenAI для разработчиков, руководство «Using GPT-6 Astra» по миграции и промптингу — требование Responses API для вызова инструментов, удалённые параметры сэмплирования, оговорки о режиме Fast; получено 5 сентября 2026 года
- Системная карта GPT-6 Astra, OpenAI Deployment Safety Hub — порог Critical по кибербезопасности в Preparedness Framework, уровень High по биологии и химии, ниже High по самоулучшению ИИ, устойчивость к джейлбрейкам, оценка фактологичности и заявленные её пределы, а также снижение отслеживаемости цепочек рассуждений; получено 5 сентября 2026 года
- Artificial Analysis, анализ интеллекта, производительности и цены GPT-6 Astra — оценки Intelligence Index v4.2, стоимость одной задачи Intelligence Index, скорость вывода 87,5 токена в секунду и время до первого токена 463,7 секунды; получено 5 сентября 2026 года
- Vellum, «GPT-6 Astra Benchmarks Explained» — перекрёстная проверка таблиц по работе с компьютером, академическим тестам и длинному контексту, а также сноска про Humanity's Last Exam
- Emergent, «GPT-6 Astra Benchmarks: What the Numbers Actually Show» — оговорка про обвязку ARC-AGI-3 и сравнение по Intelligence Index
- MindStudio, «GPT-6 Astra Benchmarks: Is It Really Better Than Fable 5.1?» — источник сообщений об ухудшениях на GDPval, банковском использовании инструментов, длинном контексте и качестве презентаций, которые мы не смогли проверить по первоисточнику
- Al Jazeera, «OpenAI unveils GPT-6 Astra amid rising scrutiny and safety concerns», 4 сентября 2026 года — сроки выпуска и поэтапное развёртывание
- 9to5Mac, «OpenAI releasing major upgrade to ChatGPT and Codex with GPT-6 Astra», 4 сентября 2026 года — порядок развёртывания по тарифам после дня запуска
- Наш комментарий о скрытом релизе GLM-5.3-Flash — другой конец той же кривой, где способность приходит дёшево, а не дорого