40 minutos em vez de 75: no que o GPT-6 Astra é realmente bom
A OpenAI lançou o GPT-6 Astra em 3 de setembro de 2026 e o chamou de modelo mais inteligente do mundo. As próprias tabelas de benchmark contam uma história mais afiada: saltos enormes em tarefas estreitas — Terminal-Bench Science de 22,4% para 64,6%, SRE-Bench de 55,9% para 88,0%, OSWorld com 47% menos tempo por tarefa — apoiados sobre um índice geral neutro que se moveu três décimos. Onde os ganhos são reais, onde estão os asteriscos e o que um modelo de texto de um milhão de tokens ainda não consegue fazer.
Em 3 de setembro de 2026, a OpenAI lançou o GPT-6 Astra e o chamou de "o modelo mais inteligente e mais alinhado do mundo".
Quatro linhas abaixo, na própria tabela de benchmarks, está o Artificial Analysis Intelligence Index v4.1.1: Astra 61,2, GPT-5.6 Sol 60,9, Claude Fable 5.1 65,7. Foi a própria OpenAI que publicou o número em que sua nova carro-chefe ganha três décimos da antecessora e perde 4,5 pontos para uma concorrente.
Os dois fatos são verdadeiros, e a tensão entre eles é a história inteira. Este não é um modelo que ficou mais inteligente em geral. É um modelo que ficou dramaticamente melhor em uma lista específica de coisas, e vale conhecer essa lista com precisão, porque ela não bate com o resumo de marketing em nenhuma das duas direções.
Resumo:
- Os ganhos especializados são enormes e verificáveis em fonte primária. Terminal-Bench Science de 22,4% para 64,6%, SRE-Bench na primeira tentativa de 55,9% para 88,0%, ScreenSpot-Pro de 76,9% para 92,7%, recuperação MRCR de 8 agulhas na faixa 512K–1M de 73,8% para 96,3% — tudo contra o GPT-5.6 Sol e tudo vindo das tabelas publicadas pela OpenAI.
- O ganho de velocidade pode importar mais do que qualquer pontuação. No OSWorld 2.0, o Astra alcança 72,6% em cerca de 40 minutos por tarefa, contra 65,7% em cerca de 75 do Sol — aproximadamente 47% menos tempo.
- O agregado geral quase não se moveu. No único índice entre fornecedores que a própria OpenAI imprimiu, o Astra está +0,3 sobre o Sol e −4,5 em relação ao Claude Fable 5.1. E ele perde a única linha acadêmica que reporta contra os três Claude: Humanity's Last Exam com ferramentas, 57,2% contra 65,0%.
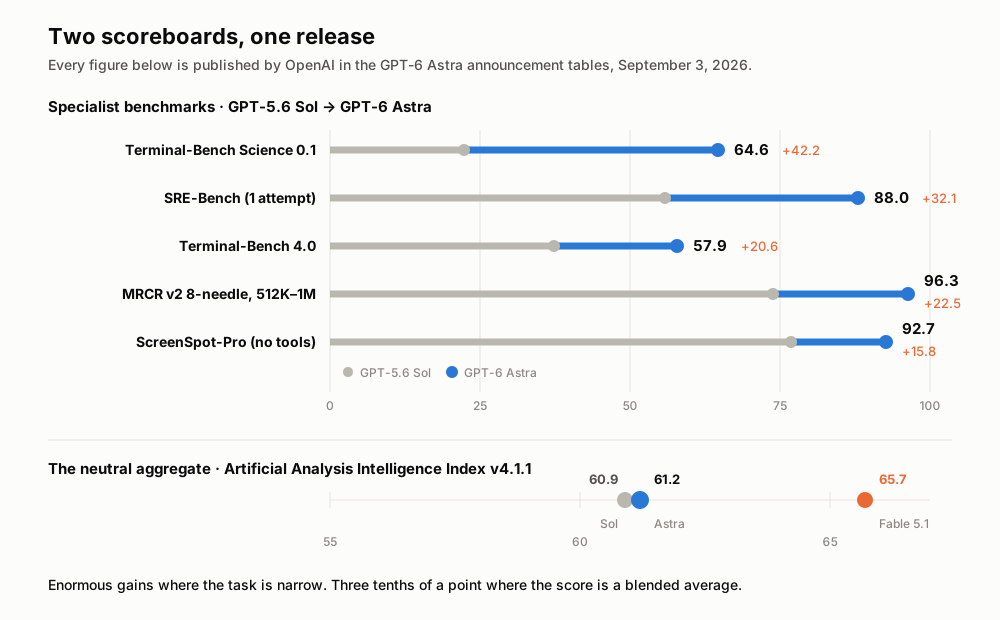
Todos os números vêm das próprias tabelas de anúncio da OpenAI. Fontes no final.
A ficha técnica, sem adjetivos
As especificações do modelo abaixo vêm da página para desenvolvedores da OpenAI sobre gpt-6-astra, consultada em 5 de setembro de 2026.
| GPT-6 Astra | |
|---|---|
| ID do modelo na API | gpt-6-astra |
| Lançamento | 3 de setembro de 2026 |
| Janela de contexto | 1.050.000 tokens |
| Saída máxima | 128.000 tokens |
| Corte de conhecimento | 30 de abril de 2026 |
| Modalidades de entrada | Texto, imagem |
| Modalidades de saída | Texto |
| Níveis de raciocínio | low, medium, high, xhigh, max |
| Preço por milhão de tokens de entrada | US$ 10,00 |
| Preço por milhão de tokens de entrada em cache | US$ 1,00 |
| Preço por milhão de tokens de saída | US$ 50,00 |
| Disponibilidade | ChatGPT Plus, Pro, Business, Enterprise; API da OpenAI; Microsoft Azure; AWS Bedrock |
Três detalhes orientam as decisões práticas sobre custo e integração.
Requisições acima de 272.000 tokens de entrada são cobradas ao dobro das tarifas de entrada e cache e a 1,5 vez a de saída, para a requisição inteira. Ou seja, a janela de um milhão de tokens tem um degrau no meio, não uma tarifa plana. Processamento Batch e Flex custa 50% do padrão; o modo Fast custa o dobro por até o dobro da velocidade, sem SLA de latência.
Chamadas de ferramentas exigem a API Responses. O Chat Completions ainda funciona para geração simples, mas temperature, top_p e top_logprobs sumiram por completo. Se você está migrando um pipeline que ajusta amostragem, esse ajuste não existe mais.
O Astra aceita texto e imagens e produz texto; não aceita áudio.
A manchete real é o uso do computador, e o número real é o relógio
O enquadramento da OpenAI é que o Astra "estabelece uma nova fronteira no uso de computador e navegador". Aqui as evidências sustentam o adjetivo.
No OSWorld 2.0 — tarefas de desktop como navegar por aplicativos, mover arquivos, preencher formulários — o Astra faz 72,6% contra 65,7% do Sol. São 6,9 pontos respeitáveis. O número interessante está ao lado: na simulação de latência da OpenAI, o Astra terminou a tarefa média em cerca de 40 minutos, onde o Sol levava cerca de 75, uma redução de aproximadamente 47%.
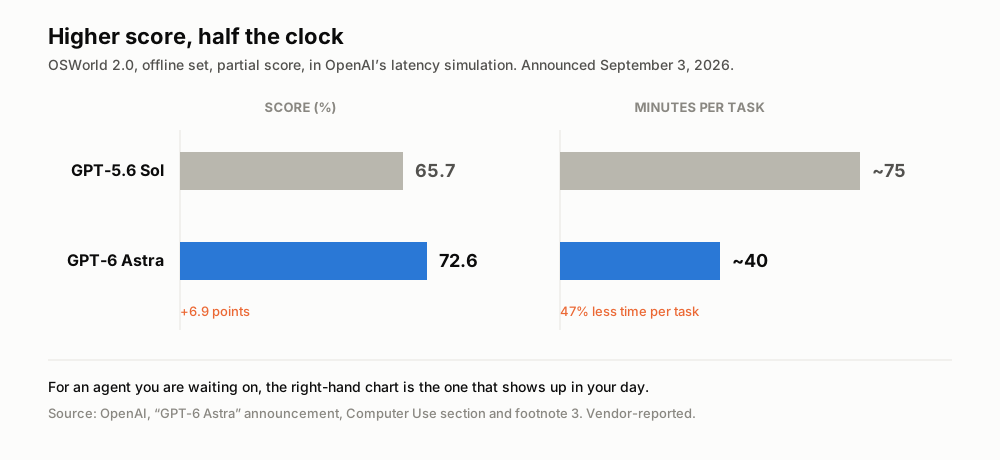
A pontuação à esquerda, o relógio à direita. Fonte: anúncio do GPT-6 Astra da OpenAI, seção Computer Use.
O ponto é este: para um modelo a quem você delega trabalho e depois espera, o tempo por tarefa é a métrica que aparece no seu dia e na sua fatura. Sete pontos a mais de precisão são um resultado de avaliação. Cortar a espera pela metade é outro produto.
O resto do bloco é consistente. O ScreenSpot-Pro, que mede se um modelo encontra e clica no pixel certo em uma interface densa, vai de 76,9% para 92,7% sem ferramentas. O Agents' Last Exam — tarefas profissionais complexas em software real, de modelagem financeira a produção de mídia — chega a 59,3%, contra 55,5% do Claude Opus 5 e 53,6% do Sol, e a OpenAI observa que o Astra usou para isso cerca de 65% menos tokens de saída que o Opus 5. No benchmark de navegador Mind2Web, com um harness Codex atualizado, a OpenAI reporta conclusão de tarefas 1,9 vez mais rápida do que a configuração atual do Sol.
O resultado de 1,9x no Mind2Web mede o harness atualizado do Codex junto com o Astra, não o modelo sozinho. Ele descreve a velocidade dessa configuração combinada.
O que as demos realmente mostram
A página de anúncio da OpenAI inclui gravações de tela que mostram o que "uso do computador" significa na prática. Os clipes exibidos são trechos editados; os tempos informados são das demonstrações, como a OpenAI observa na nota de rodapé 4.
As demonstrações abrangem quatro tipos de trabalho:
- Layout de PCB no KiCad: uma reprodução condensada de 15 segundos em que o Astra transforma um esquema eletrônico em uma placa fabricável, posicionando componentes e roteando trilhas de cobre. O layout costuma ser trabalho manual e um gargalo clássico do projeto eletrônico.
- Do Blender para o Unreal Engine 5: modelar uma casa e convertê-la em uma cena caminhável, uma passagem de bastão que normalmente custa um dia de design.
- Uma apresentação construída a partir de um modelo: dão ao Astra alguns slides do template de apresentação da OpenAI e pedem um deck sobre um modelo fictício, mantendo tom e diagramação. A demo mais relevante para o trabalho de escritório e a menos vistosa.
- Navegação em software de genômica: inspecionar qualidade de sequenciamento e visualizar variação genética dentro de ferramentas científicas especializadas.
A OpenAI também publicou uma comparação estática que ilustra uma mudança de comportamento, e não uma pontuação: quando as instruções deixam margem para interpretação, o Astra faz uma pergunta objetiva em vez de chutar.
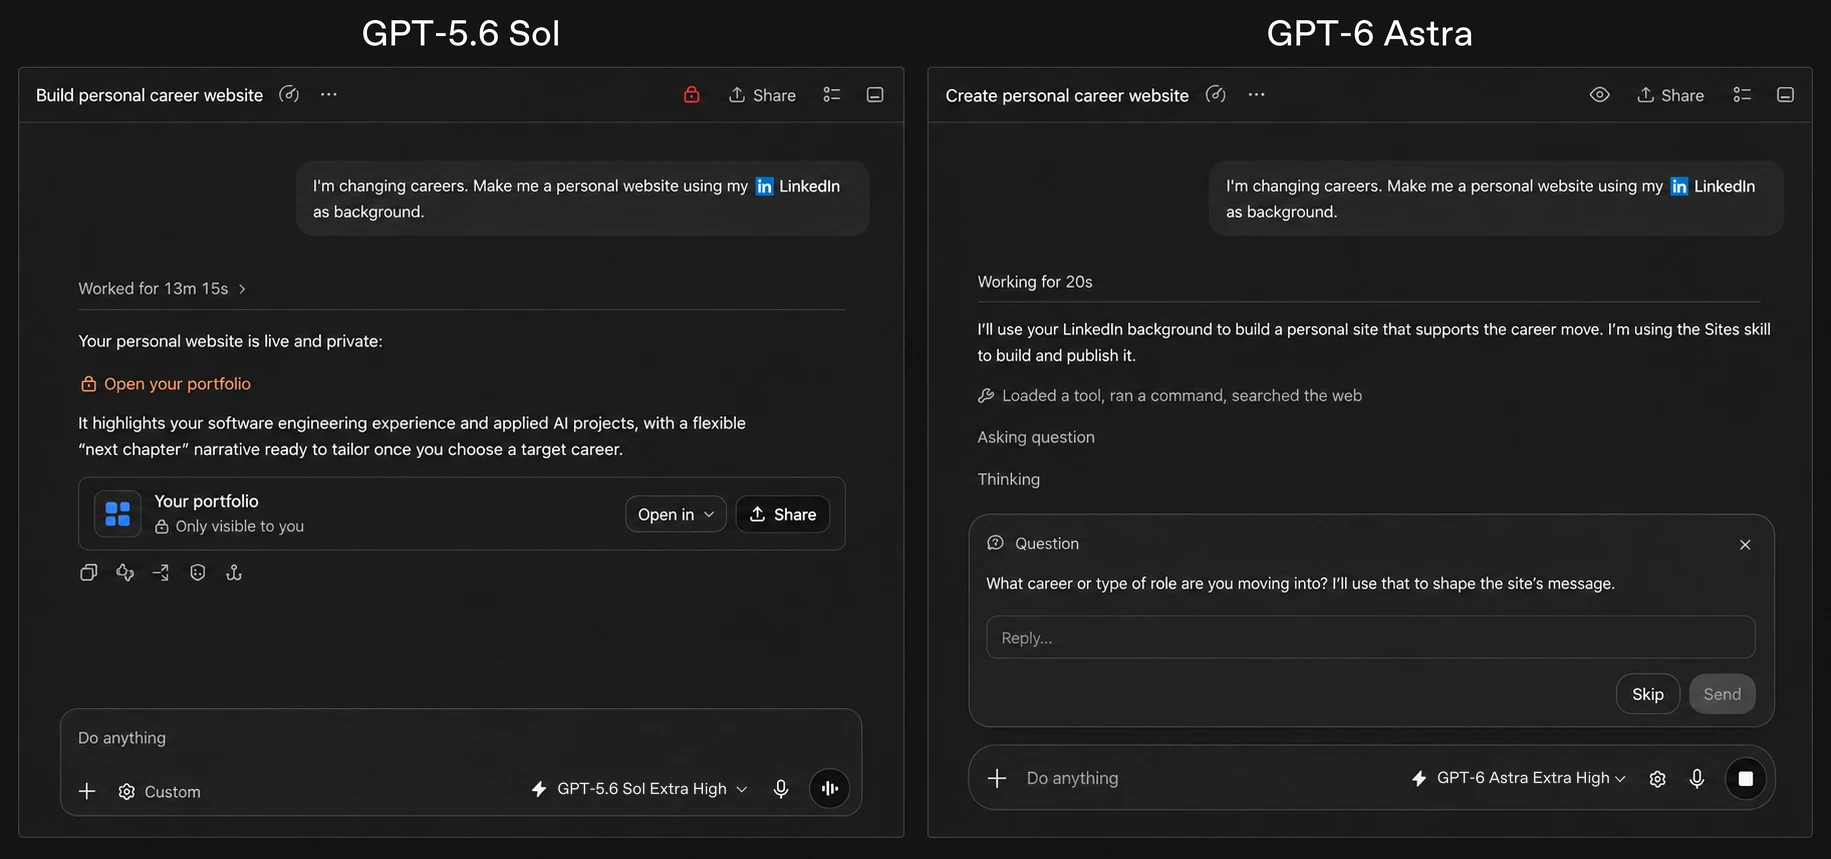
Crédito da imagem: OpenAI, "GPT-6 Astra: A new generation of intelligence", 3 de setembro de 2026. Este exemplo do fornecedor mostra o Astra perguntando quando uma resposta poderia mudar o resultado e seguindo em frente quando não poderia.
A ponta distante da janela de contexto parou de desabar
Para o trabalho com documentos longos, o resultado principal é a recuperação de informações perto do fim da janela de contexto.
GPT-5.6 Sol e Astra têm a mesma janela de contexto de 1.050.000 tokens. A melhoria atribuída ao Astra está na qualidade da recuperação nas partes mais profundas dessa janela, não em um limite anunciado maior.
No teste MRCR v2 de 8 agulhas da OpenAI, o Astra faz 100,0% na faixa 256K–512K contra 91,5% do Sol, e segura 96,3% na faixa 512K–1M, onde o Sol cai para 73,8%. Uma diferença de 22,5 pontos no topo da janela é a distância entre uma especificação e um recurso.
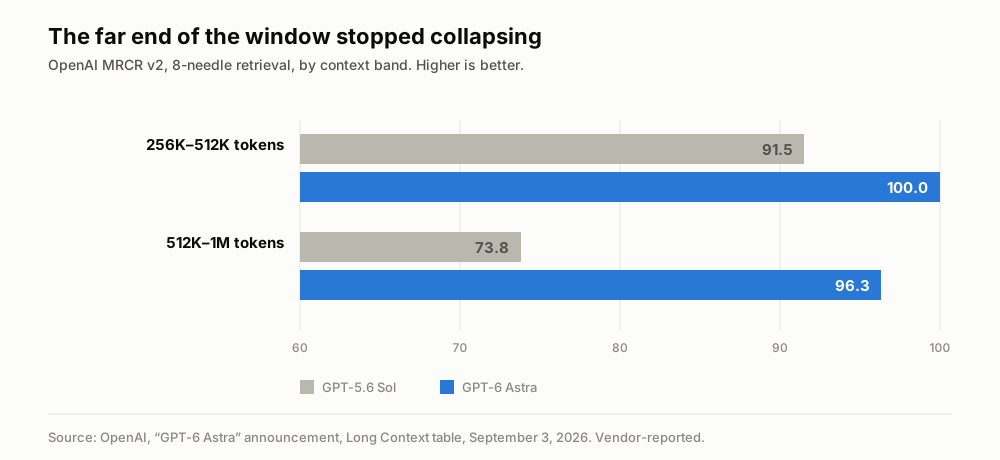
Números declarados pelo fornecedor, da tabela Long Context da OpenAI. A ressalva: o MRCR é um benchmark da própria OpenAI.
Em paralelo, o Codex ganha um mecanismo experimental em que o Astra mantém anotações entre janelas de contexto em vez de comprimir uma sessão longa em um único resumo com perdas, deixando as janelas anteriores pesquisáveis. A OpenAI diz que isso vira o padrão do Astra em algumas semanas. A perda por compactação — esquecer por que uma correção falhou três horas antes — é o modo de falha mais comum em sessões longas de agente, então é uma correção dirigida a um problema real.
Os maiores saltos do lançamento vieram do terminal e do trabalho científico
Entre as comparações com o GPT-5.6 Sol, os maiores ganhos se concentram em agentes que operam um terminal.
| Benchmark | GPT-5.6 Sol | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|---|
| Terminal-Bench Science 0.1 | 22,4% | 64,6% | 52,6% |
| SRE-Bench (1 tentativa) | 55,9% | 88,0% | – |
| Terminal-Bench 4.0 | 37,3% | 57,9% | 55,8% |
| AutomationBench | 18,1% | 41,4% | 31,4% |
| Tarefas internas de migração de banco de dados | 42,7% | 63,9% | 57,8% |
| FrontierMath Tier 4 (v2) | 83,0% | 97,6% | 87,8% |
| GPQA Diamond | 94,6% | 96,0% | 93,7% |
| Humanity's Last Exam (com ferramentas) | – | 57,2% | 65,0% |
O Terminal-Bench Science quase triplicou. O SRE-Bench — engenharia reversa de binários compilados sem acesso ao código-fonte — passou de 55,9% para 88,0% na primeira tentativa, e 99,2% em até quatro. O AutomationBench mais que dobrou. Não são melhorias na casa do arredondamento, e elas se agrupam de forma bem apertada em torno de uma única descrição: um agente que opera ferramentas ao longo de muitos passos sem perder o fio.
Em matemática, a OpenAI reporta dois resultados novos sobre lacunas entre números primos, com provas publicadas em PDF. O Astra ajudou a estabelecer que existem infinitos pares de primos separados por no máximo 186, melhorando um limite de 240 fixado recentemente por Julia Stadlmann, que por sua vez melhorava o 246 vigente por mais de uma década. Um segundo resultado melhorou um termo de um limite sobre lacunas grandes entre primos que estava inalterado havia mais de 80 anos. São artefatos verificáveis em vez de linhas de tabela, o que os torna as afirmações mais duradouras de todo o anúncio.
Onde o marketing corre na frente da evidência
Os resultados apontam para um lançamento importante, com ganhos concentrados em fluxos de trabalho específicos, em vez de desempenho geral nos benchmarks.
O agregado neutro está plano. Artificial Analysis Intelligence Index v4.1.1, impresso na própria tabela Professional da OpenAI: Astra 61,2, Sol 60,9, Fable 5.1 65,7, Opus 5 63,1. No Coding Agent Index v1.4, também na tabela da OpenAI, o Astra marca 67,0 contra 68,1 do Opus 5 e 67,2 do Fable 5. Um modelo que empata com a antecessora no composto não é um salto geracional de capacidade geral, diga o que disser o anúncio. Pela metodologia v4.2 atual da Artificial Analysis, consultada em 5 de setembro de 2026, o formato do ranking não muda: Fable 5.1 em 56,8, Astra em 54,7, Opus 5 em 54,1.
"Satura" está carregando muito peso. Os 99,9% no ARC-AGI-3 são reais, e a nota 1 da OpenAI diz que o teste rodou com um harness da API Responses "que altera duas configurações para corresponder melhor ao desempenho no mundo real". Uma chamada de API comum e sem estado não é esse harness. Trate 99,9% como um teto sob configuração ajustada, não como o comportamento da sua integração.
FrontierMath não é um árbitro neutro. A Epoch AI, que o opera, revelou que a OpenAI financiou seu desenvolvimento e detém acesso exclusivo a uma parte dele. Os 97,6% são impressionantes; independentes não são.
Os 100% do ExploitBench também têm nota. A própria observação da OpenAI sobre a versão atualizada de junho a agosto de 2026 diz que algumas das vulnerabilidades incluídas podem não permitir execução arbitrária de código sob as restrições da avaliação — uma frase que complica em silêncio o que uma pontuação perfeita no original significa.
Toda pontuação de manchete é o melhor caso. A OpenAI afirma claramente que as pontuações de avaliação são o máximo em qualquer nível de esforço. No esforço max, a Artificial Analysis mede tempo até o primeiro token de 463,7 segundos — quase oito minutos antes da primeira palavra — contra uma mediana de 3,86 segundos entre modelos de raciocínio da mesma faixa de preço. Depois, a saída corre a 87,5 tokens por segundo, acima dessa mediana. Os números de manchete e um aplicativo responsivo não são a mesma configuração.
Pelas tarifas publicadas em 5 de setembro, o Astra custava 2,5 vezes mais por token. A página do modelo GPT-5.6 Sol listava US$ 4,00 por milhão de tokens de entrada e US$ 20,00 de saída; o Astra listava US$ 10,00 e US$ 50,00. A tarifa do Sol era promocional, indicada como válida pelo menos até 21 de novembro de 2026. Preço por token não é custo por tarefa: a Artificial Analysis mediu US$ 2,57 para executar seu Intelligence Index completo com o Astra, contra US$ 6,12 com o Fable 5.1 e US$ 4,21 com o Opus 5. Antes de decidir uma compra, essas tarifas e custos de benchmark datados devem ser conferidos com os preços atuais.
E ele é mais transparente em alguns aspectos e menos em outros. O system card reporta que o Astra comete substancialmente menos erros factuais que o Sol, que nunca tentou contornar uma negativa do Auto-Review do Codex em testes internos e que ultrapassou o alvo autorizado em 0% dos casos numa avaliação de extrapolação de escopo, onde o Sol sem salvaguardas fazia isso em 48%. O mesmo documento reporta que o raciocínio escrito do Astra é mais difícil de monitorar que o do Sol, o que a OpenAI atribui a cadeias de pensamento mais curtas e diz levar a sério. Ambos pertencem ao mesmo parágrafo.
Como ler alegações sem um resultado público comparável
Várias alegações na cobertura não têm um resultado publicado do Astra que os leitores possam comparar diretamente.
Algumas publicações secundárias afirmam que o Astra regrediu em GDPval, no uso de ferramentas bancárias, no raciocínio com documentos longos ou na qualidade de apresentações em testes de agentes de longo prazo. O anúncio da OpenAI não inclui um resultado de GDPval, e aqui não é citado nenhum número publicado do Astra nem uma execução independente concluída. Assim, o resultado não está disponível para comparação; a ausência de uma pontuação não comprova uma regressão. O GDPval foi criado para avaliar trabalho de valor econômico em várias ocupações.
A OpenAI afirma que o Astra descobriu duas vulnerabilidades zero-day até então desconhecidas durante uma avaliação interna e que está comunicando o caso aos responsáveis pela manutenção. O anúncio não identifica as vulnerabilidades nem apresenta confirmação independente.
Em 5 de setembro de 2026, a OpenAI mencionava o "GPT-6 Astra Pro" para os planos Pro, Business e Enterprise, mas ainda não havia publicado preços, benchmarks ou um model card separado. Portanto, naquela data, não era possível comparar suas especificações de forma independente.
O benchmark interno de alucinação registra 4,2% para o Astra e 12,2% para o Sol. A OpenAI diz que ele usa conversas desidentificadas do ChatGPT sinalizadas por usuários por conterem erros factuais e que as taxas absolutas são infladas por desenho; esses números não devem ser interpretados como taxas de alucinação em produção nem transferidos para outras cargas de trabalho.
O modelo de fronteira continua sem ouvir
Para equipes cujo trabalho começa com fala, uma especificação define o que o Astra pode fazer diretamente.
As modalidades de entrada do GPT-6 Astra são texto e imagem. A modalidade de saída é texto. O modelo mais capaz que a OpenAI já entregou — janela de um milhão de tokens, 47% mais rápido dirigindo um desktop, 96,3% de recuperação no topo do contexto — não tem ouvidos.
Não é um descuido, é arquitetura. Modelos de raciocínio de fronteira e modelos de fala são linhas de produto separadas, e o trabalho com áudio ainda passa por uma etapa de transcrição antes que um modelo de raciocínio veja qualquer coisa. Ou seja, a qualidade de tudo o que o Astra pode fazer com uma conversa tem teto a montante, definido por aquilo que transformou essa conversa em tokens. Se a transcrição fundiu dois falantes, ou perdeu o trecho em tailandês de uma reunião bilíngue, ou deixou cair noventa segundos quando a conexão oscilou, então uma janela de contexto de um milhão de tokens é um recipiente enorme para uma entrada defeituosa.
É a camada que os lançamentos de modelo nunca consertam e que recebe menos atenção a cada nova carro-chefe. A camada de raciocínio segue melhorando num ritmo que dá para desenhar. A camada de captura — gravar uma hora sem perder nada, manter falantes separados, aguentar uma reunião que troca de idioma no meio da frase — melhora numa curva completamente diferente e muito mais lenta, e nenhuma quantidade de inteligência de fronteira a jusante compensa uma transcrição ruim a montante.
Conclusão: a fronteira ganhou um braço, não uma cabeça
O GPT-6 Astra é um lançamento de braço longo. Ele alcança muito mais longe em certos tipos de trabalho — operar um terminal, dirigir um desktop, recuperar na ponta de um milhão de tokens, fazer engenharia reversa de um binário — enquanto aquilo que costumamos chamar de inteligência ficou quase parado em todas as medidas neutras disponíveis, inclusive na que a própria OpenAI imprimiu.
Isso não é uma decepção. É até um formato mais útil do que a alternativa, porque capacidade estreita chega à produção muito mais rápido do que capacidade geral. Mas significa que a pergunta de compra mudou. "Ficou mais inteligente?" agora tem uma resposta quase sem sentido. "Ficou melhor no loop específico que eu rodo quarenta vezes por dia, e quanto tempo esse loop leva agora?" tem uma resposta ótima.
Olhe o benchmark que se pareça com o seu trabalho. Ignore o composto. E olhe o relógio, não só a pontuação.
Onde a Telli.sh entra: a lacuna que este lançamento torna visível — raciocínio brilhante apoiado sobre aquilo que a camada de captura entregou — é exatamente a lacuna em que construímos. A Telli.sh grava a reunião, mantém os falantes separados, traduz ao vivo em 15 idiomas e deixa notas que ainda serão pesquisáveis no próximo trimestre. Ela roteia transcrição, tradução e resumo por uma camada de motores intercambiáveis, de modo que um lançamento como o Astra chega na forma de notas melhores, e não de um projeto de migração. Nenhum anúncio de modelo de fronteira muda a parte em que alguém precisa capturar aquela hora, para começo de conversa.
Começar uma nota traduzida ao vivo
Fontes
- OpenAI, "GPT-6 Astra: A new generation of intelligence", 3 de setembro de 2026 — todas as tabelas de benchmark (Computer Use, Professional, Coding, Academic, Science and Health, Cybersecurity, Alignment, Long Context, Abstract reasoning), a simulação de latência do OSWorld, o número de 1,9× no Mind2Web, as notas 1, 3, 4, 8, 9, 10, 11 e 12, a disponibilidade e os resultados sobre lacunas entre primos; consultado em 5 de setembro de 2026
- Documentação para desenvolvedores da OpenAI, página do modelo
gpt-6-astra— janela de contexto, saída máxima, corte de conhecimento, modalidades, níveis dereasoning.efforte preços padrão, de cache e de escrita em cache; consultado em 5 de setembro de 2026 - Documentação para desenvolvedores da OpenAI, guia de migração e prompting "Using GPT-6 Astra" — exigência da API Responses para chamadas de ferramentas, parâmetros de amostragem removidos e ressalvas do modo Fast; consultado em 5 de setembro de 2026
- System card do GPT-6 Astra, OpenAI Deployment Safety Hub — limiar Critical em cibersegurança no Preparedness Framework, nível High em biologia e química, abaixo de High em autoaprimoramento de IA, robustez a jailbreaks, a avaliação de factualidade e seus limites declarados, e a queda de monitorabilidade das cadeias de pensamento; consultado em 5 de setembro de 2026
- Artificial Analysis, análise de inteligência, desempenho e preço do GPT-6 Astra — pontuações do Intelligence Index v4.2, custo por tarefa do Intelligence Index, velocidade de saída de 87,5 tokens por segundo e tempo até o primeiro token de 463,7 segundos; consultado em 5 de setembro de 2026
- Vellum, "GPT-6 Astra Benchmarks Explained" — checagem cruzada das tabelas de uso do computador, acadêmicas e de contexto longo, e o asterisco do Humanity's Last Exam
- Emergent, "GPT-6 Astra Benchmarks: What the Numbers Actually Show" — a ressalva sobre o harness do ARC-AGI-3 e a comparação no Intelligence Index
- MindStudio, "GPT-6 Astra Benchmarks: Is It Really Better Than Fable 5.1?" — a origem das regressões reportadas em GDPval, uso de ferramentas bancárias, contexto longo e qualidade de apresentações, que não conseguimos verificar em fonte primária
- Al Jazeera, "OpenAI unveils GPT-6 Astra amid rising scrutiny and safety concerns", 4 de setembro de 2026 — data do lançamento e implantação em fases
- 9to5Mac, "OpenAI releasing major upgrade to ChatGPT and Codex with GPT-6 Astra", 4 de setembro de 2026 — a ordem de liberação por plano depois do dia do lançamento
- Nosso comentário sobre o lançamento furtivo do GLM-5.3-Flash — a outra ponta da mesma curva, em que a capacidade chega barata em vez de cara