40 minutes au lieu de 75 : ce que GPT-6 Astra sait vraiment faire
OpenAI a publié GPT-6 Astra le 3 septembre 2026 en le qualifiant de modèle le plus intelligent au monde. Ses propres tableaux de benchmarks racontent une histoire plus tranchée : des bonds énormes sur des tâches étroites — Terminal-Bench Science de 22,4 % à 64,6 %, SRE-Bench de 55,9 % à 88,0 %, OSWorld avec 47 % de temps en moins par tâche — posés sur un indice général neutre qui a bougé de trois dixièmes. Où les gains sont réels, où sont les astérisques, et ce qu'un modèle texte à un million de tokens ne sait toujours pas faire.
Le 3 septembre 2026, OpenAI a publié GPT-6 Astra en le qualifiant de « modèle le plus intelligent et le mieux aligné au monde ».
Quatre lignes plus bas dans son propre tableau de benchmarks figure l'Artificial Analysis Intelligence Index v4.1.1 : Astra 61,2, GPT-5.6 Sol 60,9, Claude Fable 5.1 65,7. OpenAI a donc publié elle-même le chiffre où son nouveau vaisseau amiral gagne trois dixièmes de point sur son propre prédécesseur et en perd 4,5 face à un concurrent.
Les deux faits sont vrais, et la tension entre eux constitue toute l'histoire. Ce n'est pas un modèle devenu globalement plus intelligent. C'est un modèle devenu spectaculairement meilleur sur une liste précise de choses, et cette liste mérite d'être connue avec exactitude, car elle ne correspond au résumé marketing dans aucun des deux sens.
L'essentiel :
- Les gains spécialisés sont énormes et vérifiables en source primaire. Terminal-Bench Science de 22,4 % à 64,6 %, SRE-Bench au premier essai de 55,9 % à 88,0 %, ScreenSpot-Pro de 76,9 % à 92,7 %, récupération MRCR 8-needle sur la plage 512K–1M de 73,8 % à 96,3 % — le tout face à GPT-5.6 Sol, le tout issu des tableaux publiés par OpenAI.
- Le gain de vitesse compte peut-être plus que n'importe quel score. Sur OSWorld 2.0, Astra obtient 72,6 % en environ 40 minutes par tâche, contre 65,7 % en environ 75 pour Sol — soit près de 47 % de temps en moins.
- L'agrégat général n'a quasiment pas bougé. Sur le seul indice inter-fournisseurs qu'OpenAI a elle-même imprimé, Astra est à +0,3 sur Sol et à −4,5 sur Claude Fable 5.1. Et il perd la seule ligne académique qu'il rapporte face aux trois Claude : Humanity's Last Exam avec outils, 57,2 % contre 65,0 %.
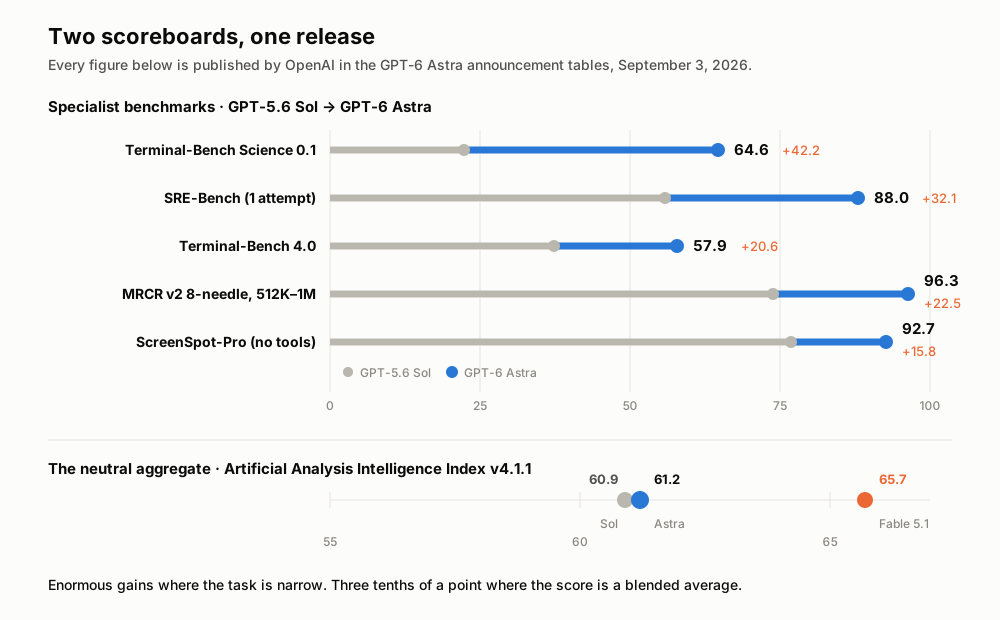
Tous les chiffres proviennent des tableaux d'annonce d'OpenAI. Sources en fin d'article.
La fiche technique, sans les adjectifs
Avant l'argument, les faits vérifiables. Ils viennent de la page développeur du modèle gpt-6-astra, consultée le 5 septembre 2026.
| GPT-6 Astra | |
|---|---|
| Identifiant du modèle API | gpt-6-astra |
| Publication | 3 septembre 2026 |
| Fenêtre de contexte | 1 050 000 tokens |
| Sortie maximale | 128 000 tokens |
| Date de coupure des connaissances | 30 avril 2026 |
| Modalités d'entrée | Texte, image |
| Modalités de sortie | Texte |
| Niveaux de raisonnement | low, medium, high, xhigh, max |
| Prix par million de tokens en entrée | 10,00 $ |
| Prix par million de tokens en entrée mis en cache | 1,00 $ |
| Prix par million de tokens en sortie | 50,00 $ |
| Disponibilité | ChatGPT Plus, Pro, Business, Enterprise ; API OpenAI ; Microsoft Azure ; AWS Bedrock |
Trois détails de ce tableau sont sautés par la plupart des articles et ne devraient pas l'être.
Les requêtes dépassant 272 000 tokens en entrée sont facturées au double du tarif d'entrée et de cache et à 1,5 fois le tarif de sortie, pour la requête entière. La fenêtre d'un million de tokens comporte donc une falaise en son milieu, et non un tarif uniforme. Les traitements Batch et Flex sont à 50 % du tarif standard ; le mode Fast coûte le double pour jusqu'à deux fois la vitesse, sans SLA de latence.
L'appel d'outils exige l'API Responses. Chat Completions fonctionne encore pour la génération simple, mais temperature, top_p et top_logprobs ont totalement disparu. Si vous migrez une chaîne qui ajuste l'échantillonnage, cet ajustement n'existe plus.
Et Astra reçoit du texte et des images, et produit du texte. Il n'entend pas. Nous y reviendrons.
Le vrai titre, c'est l'usage de l'ordinateur, et le vrai chiffre, c'est l'horloge
Le cadrage d'OpenAI est qu'Astra « établit une nouvelle frontière dans l'usage de l'ordinateur et du navigateur ». Sur ce point, les preuves soutiennent l'adjectif.
Sur OSWorld 2.0 — des tâches de bureau comme naviguer dans des applications, déplacer des fichiers, remplir des formulaires — Astra obtient 72,6 % contre 65,7 % pour Sol. Ce sont 6,9 points respectables. Le chiffre intéressant est juste à côté : dans la simulation de latence d'OpenAI, Astra a terminé la tâche moyenne en environ 40 minutes là où Sol en prenait environ 75, soit une réduction d'environ 47 %.
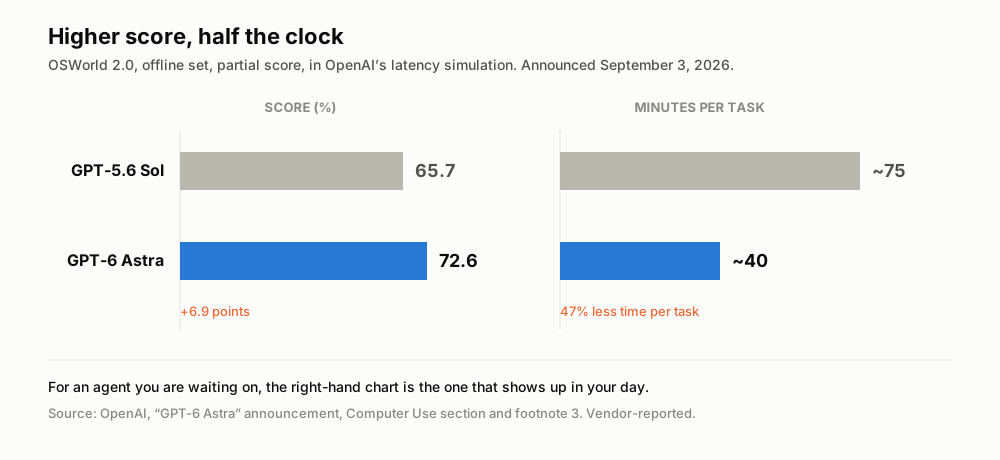
Le score à gauche, l'horloge à droite. Source : annonce GPT-6 Astra d'OpenAI, section Computer Use.
Voilà le point : pour un modèle à qui l'on délègue du travail et que l'on attend ensuite, le temps par tâche est la métrique qui apparaît dans votre journée et sur votre facture. Sept points de précision en plus, c'est un résultat d'évaluation. Diviser l'attente par deux, c'est un autre produit.
Le reste du bloc est cohérent. ScreenSpot-Pro, qui teste si un modèle sait trouver et cliquer le bon pixel dans une interface dense, passe de 76,9 % à 92,7 % sans outils. Agents' Last Exam — des tâches professionnelles complexes dans de vrais logiciels, de la modélisation financière à la production média — atteint 59,3 %, contre 55,5 % pour Claude Opus 5 et 53,6 % pour Sol, et OpenAI note qu'Astra a utilisé pour cela environ 65 % de tokens de sortie en moins qu'Opus 5. Sur le benchmark navigateur Mind2Web, avec un harnais Codex mis à jour, OpenAI rapporte une exécution 1,9 fois plus rapide que la configuration Sol actuelle.
Lu avec attention, ce dernier chiffre est une affirmation sur le système, pas sur le modèle : harnais plus modèle. C'est tout de même le chiffre que vit l'utilisateur, ce qui justifie de le citer et d'y accoler une étiquette.
Ce que les démos montrent réellement
OpenAI a publié des captures d'écran vidéo plutôt que des images fixes, et ce sont les preuves les plus claires de cette annonce sur ce que signifie désormais « usage de l'ordinateur ». Nous ne les avons pas réhébergées ; elles se lisent sur la page d'annonce d'OpenAI. La note de bas de page 4 d'OpenAI précise que les clips affichés sont des extraits montés, avec les durées relevées lors des démonstrations correspondantes — la réserve à emporter avec soi en les regardant.
Les quatre qui valent votre temps :
- Routage de circuit imprimé dans KiCad — une lecture condensée de 15 secondes où Astra transforme un schéma électronique en carte fabricable, en plaçant les composants et en routant les pistes de cuivre. Le routage est normalement manuel et constitue un goulot classique de la conception électronique.
- De Blender à Unreal Engine 5 — modéliser une maison, puis la convertir en scène parcourable, un passage de relais qui coûte d'ordinaire une journée de designer.
- Un jeu de diapositives bâti sur un modèle — quelques diapositives du gabarit de présentation d'OpenAI, et la consigne de produire un deck sur un modèle fictif en respectant le ton et la mise en page. La démo la plus pertinente pour le travail de bureau, et la moins spectaculaire.
- Navigation dans un logiciel de génomique — inspecter la qualité de séquençage et visualiser la variation génétique au sein d'outils scientifiques spécialisés.
OpenAI a également publié une comparaison fixe illustrant un changement de comportement plutôt qu'un score : quand les consignes laissent place à l'interprétation, Astra pose une question ciblée au lieu de deviner.
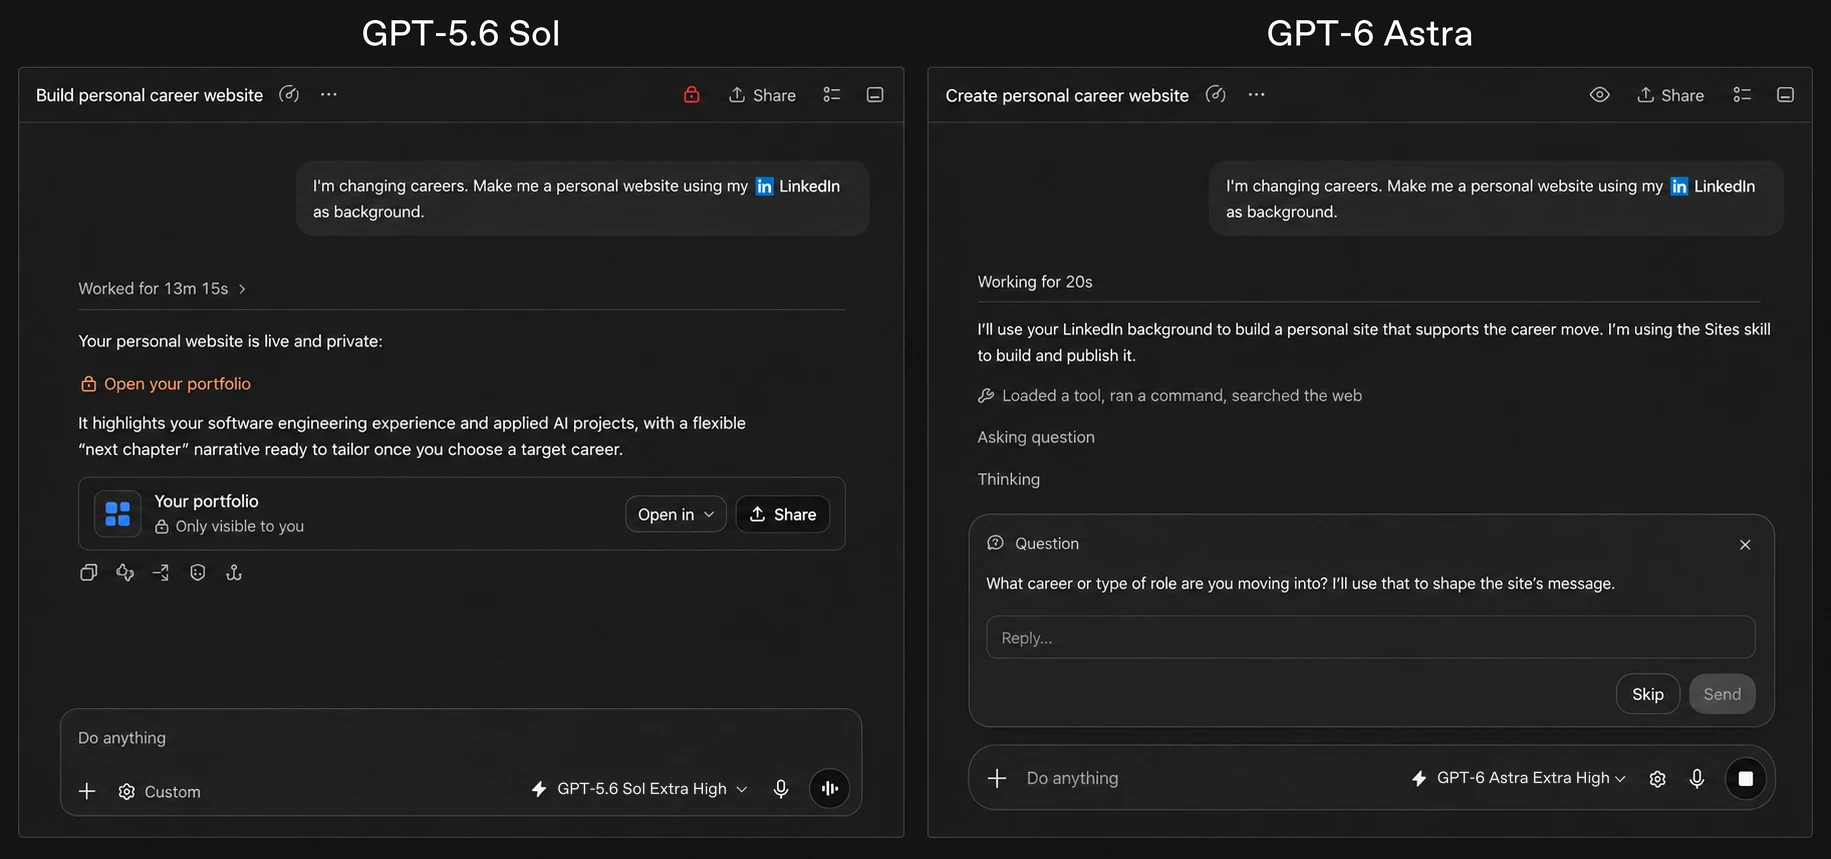
Crédit image : OpenAI, « GPT-6 Astra: A new generation of intelligence », 3 septembre 2026. Le comportement démontré — demander quand la réponse changerait le résultat, avancer sinon — est une démonstration du fournisseur, non une mesure de benchmark indépendante.
L'extrémité de la fenêtre de contexte a cessé de s'effondrer
C'est le résultat le moins commenté de cette sortie et, pour quiconque travaille sur de longs documents, probablement le plus lourd de conséquences.
Le marketing du contexte long est peu fiable depuis trois ans, parce que la fenêtre annoncée et la fenêtre utilisable étaient deux chiffres différents. Les modèles acceptaient un million de tokens puis récupéraient mal au-delà de quelques centaines de milliers. Or Astra n'a pas élargi la fenêtre du tout — le contexte de GPT-5.6 Sol est lui aussi de 1 050 000 tokens. Ce qui a changé, c'est ce qui se passe à son extrémité.
Sur le test MRCR v2 8-needle d'OpenAI, Astra obtient 100,0 % sur la plage 256K–512K contre 91,5 % pour Sol, et tient 96,3 % sur la plage 512K–1M là où Sol tombe à 73,8 %. Un écart de 22,5 points en haut de la fenêtre, c'est la différence entre une spécification et une fonctionnalité.
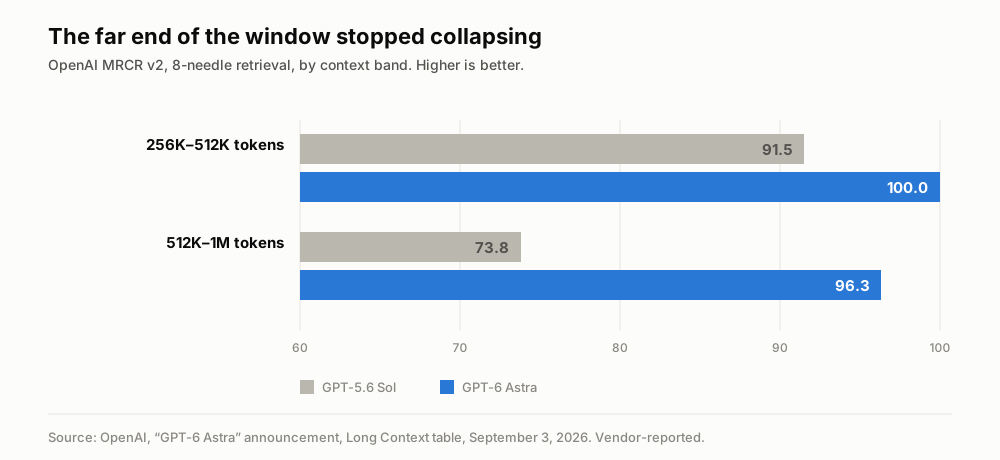
Chiffres déclarés par le fournisseur, issus du tableau Long Context d'OpenAI. La réserve : MRCR est un benchmark maison d'OpenAI.
En parallèle, Codex gagne un mécanisme expérimental où Astra conserve des notes d'une fenêtre de contexte à l'autre au lieu de compresser une longue session en un résumé lacunaire, les fenêtres antérieures restant consultables. OpenAI annonce que ce sera le comportement par défaut d'Astra d'ici quelques semaines. La perte à la compaction — oublier pourquoi un correctif a échoué trois heures plus tôt — est le mode de défaillance le plus courant des longues sessions d'agent : c'est donc un correctif ciblé sur un problème réel.
Les plus grands écarts de cette sortie viennent du terminal et du travail scientifique
Si l'on classe toutes les comparaisons publiées face à GPT-5.6 Sol par amplitude du bond, le haut du classement n'est ni les mathématiques ni la programmation en général. Ce sont les agents qui pilotent un terminal.
| Benchmark | GPT-5.6 Sol | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|---|
| Terminal-Bench Science 0.1 | 22,4 % | 64,6 % | 52,6 % |
| SRE-Bench (1 essai) | 55,9 % | 88,0 % | – |
| Terminal-Bench 4.0 | 37,3 % | 57,9 % | 55,8 % |
| AutomationBench | 18,1 % | 41,4 % | 31,4 % |
| Tâches internes de migration de base de données | 42,7 % | 63,9 % | 57,8 % |
| FrontierMath Tier 4 (v2) | 83,0 % | 97,6 % | 87,8 % |
| GPQA Diamond | 94,6 % | 96,0 % | 93,7 % |
| Humanity's Last Exam (avec outils) | – | 57,2 % | 65,0 % |
Terminal-Bench Science a presque triplé. SRE-Bench — la rétro-ingénierie de binaires compilés sans accès au code source — est passé de 55,9 % à 88,0 % au premier essai, et à 99,2 % en quatre essais. AutomationBench a plus que doublé. Ce ne sont pas des améliorations de l'ordre de l'arrondi, et elles se regroupent étroitement autour d'une même description : un agent qui manipule des outils sur de nombreuses étapes sans perdre le fil.
En mathématiques, OpenAI rapporte deux résultats inédits sur les écarts entre nombres premiers, preuves publiées en PDF. Astra a contribué à établir qu'il existe une infinité de paires de nombres premiers séparées d'au plus 186, améliorant une borne de 240 récemment posée par Julia Stadlmann, elle-même une amélioration du 246 en vigueur depuis plus d'une décennie. Un second résultat a amélioré un terme dans une borne sur les grands écarts entre nombres premiers, inchangé depuis plus de 80 ans. Ce sont des artefacts vérifiables plutôt que des lignes de tableau, ce qui en fait les affirmations les plus durables de toute l'annonce.
Là où le marketing distance les preuves
Passons maintenant de la mesure au jugement. Notre lecture : c'est une sortie majeure décrite avec le mauvais vocabulaire, et OpenAI a fourni elle-même les preuves qui contredisent son propre cadrage.
L'agrégat neutre est plat. Artificial Analysis Intelligence Index v4.1.1, imprimé dans le tableau Professional d'OpenAI : Astra 61,2, Sol 60,9, Fable 5.1 65,7, Opus 5 63,1. Sur le Coding Agent Index v1.4, également dans le tableau d'OpenAI, Astra obtient 67,0 contre 68,1 pour Opus 5 et 67,2 pour Fable 5. Un modèle qui égale son prédécesseur sur le composite n'est pas un saut générationnel de capacité générale, quoi qu'en dise l'article. Selon la méthodologie v4.2 actuelle d'Artificial Analysis, consultée le 5 septembre 2026, la forme du classement est inchangée : Fable 5.1 à 56,8, Astra à 54,7, Opus 5 à 54,1.
Le verbe « saturer » porte une lourde charge. Les 99,9 % sur ARC-AGI-3 sont réels, et la note 1 d'OpenAI précise que le test a été mené avec un harnais API Responses « qui modifie deux réglages pour mieux correspondre aux performances réelles ». Un simple appel d'API sans état n'est pas ce harnais. Traitez 99,9 % comme un plafond dans une configuration optimisée, pas comme le comportement de votre intégration.
FrontierMath n'est pas un arbitre neutre. Epoch AI, qui l'exploite, a divulgué qu'OpenAI en a financé le développement et détient un accès exclusif à une partie du benchmark. Les 97,6 % sont impressionnants ; ils ne sont pas indépendants.
Les 100 % d'ExploitBench ont aussi une note. La remarque d'OpenAI sur le portage rafraîchi de juin-août 2026 indique que certaines vulnérabilités incluses pourraient ne pas permettre l'exécution de code arbitraire dans les contraintes de l'évaluation — une phrase qui complique discrètement ce que signifie un score parfait sur la version d'origine.
Chaque score mis en avant correspond au meilleur cas de figure. OpenAI indique clairement que les scores d'évaluation sont le maximum sur tous les niveaux d'effort. À l'effort max, Artificial Analysis mesure un délai jusqu'au premier token de 463,7 secondes — près de huit minutes avant le premier mot — contre une médiane de 3,86 secondes pour les modèles de raisonnement de la même gamme de prix. La sortie tourne ensuite à 87,5 tokens par seconde, au-dessus de cette médiane. Les chiffres mis en avant et une application réactive ne correspondent pas à la même configuration.
Le prix est multiplié par 2,5. La page modèle de GPT-5.6 Sol affiche 4,00 $ par million de tokens en entrée et 20,00 $ en sortie ; Astra affiche 10,00 $ et 50,00 $. C'est exactement 2,5 fois des deux côtés — et le tarif de Sol est lui-même promotionnel, publié comme valable au moins jusqu'au 21 novembre 2026. Le contrepoids honnête est l'efficacité en tokens : Artificial Analysis mesure le coût d'un passage complet de son Intelligence Index à 2,57 $ pour Astra, contre 6,12 $ pour Fable 5.1 et 4,21 $ pour Opus 5. Astra coûte plus cher au token et moins cher à la tâche terminée que les Claude — une distinction à poser avant que quiconque ne cite le prix affiché comme un verdict.
Et il est plus transparent à certains égards, moins à d'autres. La system card rapporte qu'Astra commet nettement moins d'erreurs factuelles que Sol, qu'il n'a jamais tenté de contourner un refus de l'Auto-Review de Codex lors des tests internes, et qu'il a dépassé la cible autorisée dans 0 % des cas d'une évaluation de dépassement de périmètre là où Sol, sans garde-fous, le faisait dans 48 % des cas. Le même document rapporte que le raisonnement écrit d'Astra est plus difficile à surveiller que celui de Sol, ce qu'OpenAI attribue à des chaînes de pensée plus courtes et dit prendre au sérieux. Les deux appartiennent au même paragraphe.
Quatre choses que nous n'avons pas pu vérifier, signalées comme telles
La couverture de cette sortie devance les preuves sur des points précis.
Des articles secondaires ont affirmé qu'Astra régressait sur GDPval, sur l'usage d'outils bancaires, sur le raisonnement sur documents longs et sur la qualité des présentations dans des tests d'agent au long cours. Nous avons vérifié : GDPval n'apparaît nulle part dans l'annonce d'OpenAI, et nous n'avons trouvé ni chiffre GDPval publié par OpenAI pour Astra ni exécution indépendante achevée permettant de confronter l'affirmation. L'absence elle-même est notable — GDPval est le benchmark construit autour du travail à valeur économique dans de nombreux métiers. Mais « manquant » et « en régression » sont deux constats différents, et seul le premier est établi.
L'affirmation selon laquelle Astra aurait découvert deux vulnérabilités zero-day inconnues lors d'évaluations internes figure dans l'annonce d'OpenAI, avec une divulgation promise aux mainteneurs. Elle n'est pas confirmée de manière indépendante et les vulnérabilités ne sont pas identifiées.
« GPT-6 Astra Pro » est évoqué pour les offres Pro, Business et Enterprise, sans tarif distinct, benchmark ni fiche modèle publiés au 5 septembre 2026. Hors d'OpenAI, personne ne sait ce que c'est.
Le benchmark interne d'hallucination affichant 4,2 % pour Astra contre 12,2 % pour Sol est un benchmark interne. OpenAI en décrit la construction — des conversations ChatGPT anonymisées que des utilisateurs avaient signalées comme contenant des erreurs factuelles — et affirme explicitement que les taux absolus sont gonflés par construction et ne doivent pas être lus comme des taux d'hallucination en production. La direction est crédible ; le chiffre n'est pas transposable.
Le modèle de frontière n'entend toujours pas
Voici le détail qui recadre cette sortie pour quiconque reçoit son travail sous forme de parole plutôt que de texte.
Les modalités d'entrée de GPT-6 Astra sont le texte et l'image. Sa modalité de sortie est le texte. Le modèle le plus capable qu'OpenAI ait jamais livré — une fenêtre d'un million de tokens, 47 % plus rapide pour piloter un bureau, 96,3 % de récupération en haut de son contexte — n'a pas d'oreilles.
Ce n'est pas un oubli, c'est de l'architecture. Les modèles de raisonnement de frontière et les modèles de parole sont des gammes séparées, et le travail audio passe toujours par une étape de transcription avant qu'un modèle de raisonnement ne voie quoi que ce soit. Ce qui signifie que la qualité de tout ce qu'Astra peut faire d'une conversation est plafonnée en amont, par ce qui a transformé cette conversation en tokens. Si la transcription a fusionné deux locuteurs, perdu le passage en thaï d'une réunion bilingue ou laissé tomber quatre-vingt-dix secondes pendant une coupure, alors une fenêtre de contexte d'un million de tokens n'est qu'un très grand récipient pour une entrée défectueuse.
C'est la couche que les sorties de modèles ne réparent jamais et qui reçoit moins d'attention à chaque nouveau vaisseau amiral. La couche de raisonnement continue de s'améliorer à un rythme que l'on peut tracer. La couche de captation — enregistrer une heure sans rien perdre, séparer les locuteurs, encaisser une réunion qui change de langue en milieu de phrase — progresse sur une courbe complètement différente et bien plus lente, et aucune intelligence de frontière en aval ne compense une mauvaise transcription en amont.
En résumé : la frontière s'est allongé un bras, pas une tête
GPT-6 Astra est une sortie à long bras. Elle atteint bien plus loin dans certains types de travail — piloter un terminal, conduire un bureau, récupérer à l'extrémité d'un million de tokens, rétro-concevoir un binaire — pendant que ce que l'on appelle d'ordinaire l'intelligence est resté quasi immobile sur toutes les mesures neutres disponibles, y compris celle qu'OpenAI a imprimée elle-même.
Ce n'est pas une déception. C'est même une forme plus utile que l'inverse, car une capacité étroite arrive en production bien plus vite qu'une capacité générale. Mais cela veut dire que la question d'achat a changé. « Est-il plus intelligent ? » n'a désormais qu'une réponse presque dénuée de sens. « Est-il meilleur sur la boucle précise que je fais quarante fois par jour, et combien de temps prend cette boucle maintenant ? » en a une excellente.
Regardez le benchmark qui ressemble à votre travail. Ignorez le composite. Et regardez l'horloge, pas seulement le score.
Là où Telli.sh intervient : l'écart que cette sortie rend visible — un raisonnement brillant posé sur ce que la couche de captation lui a transmis — est précisément l'écart où nous construisons. Telli.sh enregistre la réunion, sépare les locuteurs, traduit en direct dans 15 langues et en fait des notes encore consultables le trimestre prochain. La transcription, la traduction et la synthèse passent par une couche de moteurs interchangeables, de sorte qu'une sortie comme Astra arrive sous forme de meilleures notes plutôt que de projet de migration. Aucune annonce de modèle de frontière ne change la partie où quelqu'un doit d'abord capter cette heure-là.
Démarrer une note traduite en direct
Sources
- OpenAI, « GPT-6 Astra: A new generation of intelligence », 3 septembre 2026 — l'ensemble des tableaux de benchmarks (Computer Use, Professional, Coding, Academic, Science and Health, Cybersecurity, Alignment, Long Context, Abstract reasoning), la simulation de latence OSWorld, le chiffre Mind2Web de 1,9×, les notes 1, 3, 4, 8, 9, 10, 11 et 12, la disponibilité et les résultats sur les écarts entre nombres premiers ; consulté le 5 septembre 2026
- Documentation développeur OpenAI, page du modèle
gpt-6-astra— fenêtre de contexte, sortie maximale, coupure des connaissances, modalités, niveaux dereasoning.effortet tarifs standard, cache et écriture de cache ; consulté le 5 septembre 2026 - Documentation développeur OpenAI, guide de migration et de prompting « Using GPT-6 Astra » — exigence de l'API Responses pour l'appel d'outils, paramètres d'échantillonnage supprimés, réserves sur le mode Fast ; consulté le 5 septembre 2026
- System card GPT-6 Astra, OpenAI Deployment Safety Hub — seuil Critical en cybersécurité dans le Preparedness Framework, niveau High en biologie et chimie, en dessous de High pour l'auto-amélioration de l'IA, robustesse aux jailbreaks, l'évaluation de factualité et ses limites déclarées, et la baisse de surveillabilité des chaînes de pensée ; consulté le 5 septembre 2026
- Artificial Analysis, analyse d'intelligence, de performance et de prix de GPT-6 Astra — scores de l'Intelligence Index v4.2, coût par tâche de l'Intelligence Index, vitesse de sortie de 87,5 tokens par seconde et délai jusqu'au premier token de 463,7 secondes ; consulté le 5 septembre 2026
- Vellum, « GPT-6 Astra Benchmarks Explained » — recoupement des tableaux d'usage de l'ordinateur, académiques et de contexte long, et l'astérisque sur Humanity's Last Exam
- Emergent, « GPT-6 Astra Benchmarks: What the Numbers Actually Show » — la réserve sur le harnais ARC-AGI-3 et la comparaison sur l'Intelligence Index
- MindStudio, « GPT-6 Astra Benchmarks: Is It Really Better Than Fable 5.1? » — l'origine des régressions rapportées sur GDPval, l'usage d'outils bancaires, le contexte long et la qualité des présentations, que nous n'avons pas pu vérifier en source primaire
- Al Jazeera, « OpenAI unveils GPT-6 Astra amid rising scrutiny and safety concerns », 4 septembre 2026 — calendrier de sortie et déploiement par étapes
- 9to5Mac, « OpenAI releasing major upgrade to ChatGPT and Codex with GPT-6 Astra », 4 septembre 2026 — l'ordre de déploiement par formule après le jour du lancement
- Notre commentaire sur la sortie furtive de GLM-5.3-Flash — l'autre extrémité de la même courbe, là où la capacité arrive à bas prix plutôt qu'à prix fort