GPT-6.1 Terra kosztuje 1 USD za milion tokenów wejściowych. Ile kosztuje ukończone zadanie?
GPT-6.1 Terra od OpenAI obniża standardowe ceny analizy obrazu i obsługi komputera. Praktyczny przewodnik po ocenie ukończonej pracy, ponownych próbach, weryfikacji i integracji modelu.
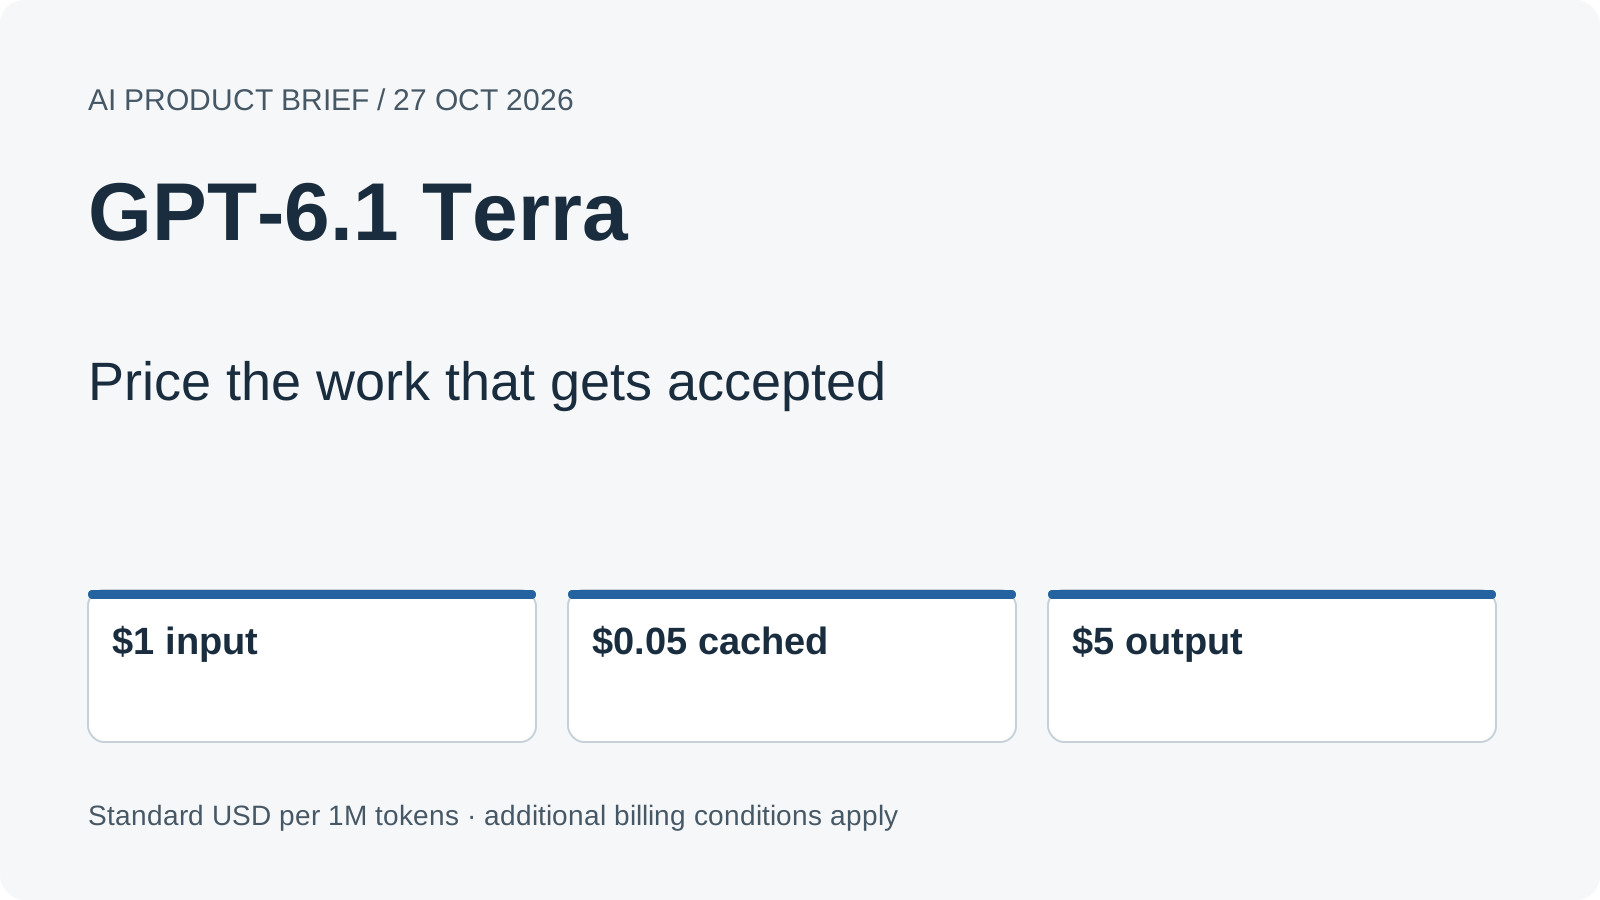
Autorski diagram redakcyjny Ken Jo, oparty na źródłach wymienionych poniżej.
Po jednej stronie ekranu widać fakturę, po drugiej formularz księgowy. Odczytanie kwoty to jedno zadanie. Wybranie właściwego dostawcy, wpisanie odpowiedniej waluty i rozpoznanie, że zapisany rekord rzeczywiście istnieje, to zadanie znacznie szersze. Różnica ma szczególne znaczenie, gdy to model AI klika przyciski.
OpenAI zaprezentowało GPT-6.1 Terra 26 października 2026 r. ze standardowymi cenami API wynoszącymi 1 USD za milion tokenów wejściowych, 0,05 USD za milion tokenów wejściowych z pamięci podręcznej i 5 USD za milion tokenów wyjściowych. Firma pozycjonuje model do analizy wizualnej, obsługi komputera i pisania oraz podaje, że te standardowe stawki są o 50% niższe niż w GPT-5.6 Terra i GPT-6.1 Sol. Oficjalna zapowiedź, datowana karta systemowa.
Niższe ceny pozwalają przeprowadzać więcej eksperymentów. Ustalenie, które z nich warto zamienić w proces pracy, wymaga innej miary: kosztu wyniku, który można zaakceptować. Ten przewodnik omawia trzy praktyczne zastosowania, przedstawia przejrzysty przykład kosztowy i pokazuje, jak ocenić model bez mylenia udanego wywołania narzędzia z ukończeniem pracy.
Model wybiera działanie w systemie, który je wykonuje
Terra to model dostarczany przez OpenAI, firmę stojącą za ChatGPT i Codex. Jego wybór daje aplikacji określone możliwości językowe i wizualne. Otaczająca aplikacja nadal decyduje, jaki ekran model może obserwować, jakie narzędzia wywoływać i do jakich kont mają dostęp te narzędzia.
Potraktujmy przykład faktury jako hipotetyczny proces. Model obserwuje formularz, proponuje działanie i otrzymuje zaktualizowany widok po wykonaniu go przez narzędzie. Nowy widok ma znaczenie, ponieważ pozornie poprawne kliknięcie może otworzyć inny panel, ujawnić błąd walidacji albo pozostawić niedokończone zapisywanie. Proces musi rozpoznać stan wynikowy przed dalszym działaniem.
Obsługa komputera jest więc pętlą, a nie pojedynczą odpowiedzią. Przydatna integracja łączy obserwacje, działania i kontrolę ich skutków. Określa też, kiedy zadanie powinno się zatrzymać, poprosić człowieka o pomoc lub zgłosić brak niezbędnych danych. Te decyzje należą do projektu aplikacji, nawet jeśli model dobrze interpretuje ekrany.
Dokumentacja obsługi komputera OpenAI, sprawdzona 27 października, rozróżnia zdarzenia aktywności przeglądarki i końcowy status całej tury. Udostępnia też ustawienia włączania zrzutów ekranu do wyjścia strumieniowego. Programista może pokazywać postęp na podstawie tych zdarzeń, a osobno sprawdzać, czy żądany wynik istnieje.
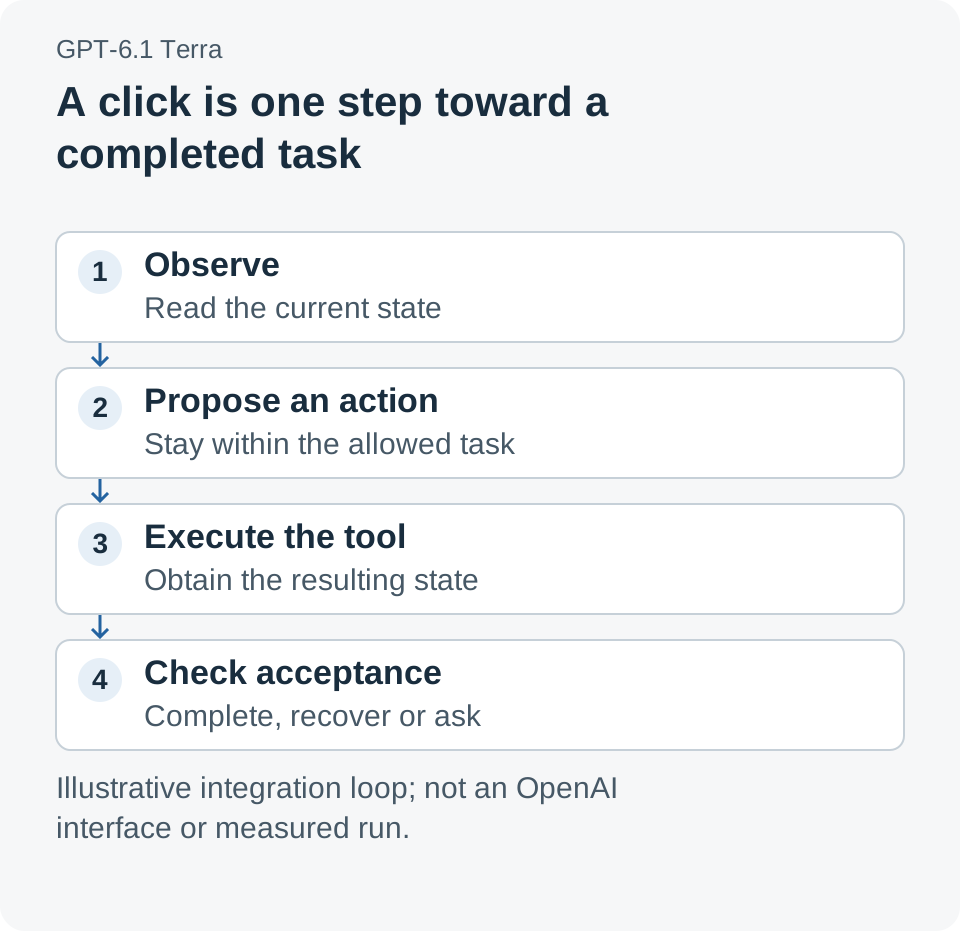
Przykładowa pętla obsługi komputera. Aplikacja zapewnia narzędzia i uprawnienia; kontrola akceptacji ustala, czy żądana praca jest ukończona. To autorskie objaśnienie, a nie zrzut interfejsu OpenAI.
Cennik jest punktem wyjścia do budżetu zadania
Standardowe stawki z zapowiedzi z 26 października łatwo porównać, jeśli obowiązują te same warunki rozliczenia. Wejście i wyjście mają różne ceny, a wejście z pamięci podręcznej stanowi osobną kategorię. Długa odpowiedź lub powtarzana pętla obserwacji może więc zmienić rachunek, nawet gdy liczba zapytań użytkowników pozostaje stała.
| Kategoria tokenów | Standardowa cena za 1 mln tokenów | Co mierzyć w próbie |
|---|---|---|
| Wejście | 1,00 USD | Rozliczane wejście ze wszystkich prób |
| Wejście z pamięci podręcznej | 0,05 USD | Rzeczywiste trafienia w cache, a nie zakładane ponowne użycie |
| Wyjście | 5,00 USD | Całe rozliczane wyjście wykonania |
Karta modelu, sprawdzona 27 października, wymienia dodatkowe warunki. Zapis do pamięci podręcznej ma oddzielne stawki, prompty przekraczające 272 000 tokenów wejściowych podlegają korektom dla długiego kontekstu, a tryby usługi mogą zmieniać cenę. Stosuj stawkę odpowiednią dla rzeczywistego żądania, zamiast traktować najniższą pozycję cennika jako uniwersalną.
W poniższym przykładzie zakładamy standardowe przetwarzanie, brak cache i żądania poniżej progu długiego kontekstu. Każda próba zużywa 10 000 rozliczanych tokenów wejściowych i 1000 wyjściowych. Koszt wynosi zatem 0,01 USD + 0,005 USD = 0,015 USD za próbę. Liczby tokenów zostały wybrane na potrzeby obliczeń; nie są pomiarem Terra ani procesu obsługi faktur.
To rozróżnienie jest podstawą użytecznego budżetu. Najpierw ustal rachunek za jedną próbę przy jawnych założeniach. Następnie zapytaj, ilu prób potrzebuje proces, z jakich innych usług korzysta i ile kontroli wymaga, zanim ktoś zaakceptuje wynik.
Powtórzenia i kontrola zmieniają koszt zaakceptowanej pracy
Załóżmy, że hipotetyczna partia zawiera 100 zleconych zadań. W jednym scenariuszu system wykonuje 100 prób i zaakceptowanych zostaje 90 zadań. W drugim działania naprawcze zwiększają liczbę prób do 150, a zaakceptowanych zadań do 95. Dodatkowy sukces jest przydatny, ale porównanie kosztów się zmienia.
Tabela dodaje trzeci scenariusz, w którym 30 elementów podlega kontroli człowieka po 20 sekund, przy założonej stawce pracy 30 USD za godzinę. To 600 sekund, czyli 10 minut, o koszcie 5 USD. Wszystkie liczby zadań, akceptacji i założenia dotyczące pracy są ilustracyjne; żadna z nich nie opisuje zmierzonego wyniku produktu.
| Przykładowa partia | Wydatki na tokeny | Wydatki na kontrolę | Zaakceptowane zadania | Wydatek na zaakceptowane zadanie |
|---|---|---|---|---|
| 100 prób | 1,50 USD | 0,00 USD | 90 | 0,0167 USD |
| 150 prób | 2,25 USD | 0,00 USD | 95 | 0,0237 USD |
| 150 prób i opisana kontrola | 2,25 USD | 5,00 USD | 95 | 0,0763 USD |
Mianownikiem są zaakceptowane zadania, a nie wygenerowane odpowiedzi. Elegancki komunikat o ukończeniu nie zwiększa tego mianownika, jeśli rekord zapisano niepoprawnie. Z kolei proces proszący o krótkie doprecyzowanie może dostarczyć przydatniejszy wynik niż taki, który pewnie działa dalej mimo brakujących informacji.
Nazwijmy dodatkową pracę rachunkiem za ukończenie: zasobami potrzebnymi do zamiany próby działania w zaakceptowany wynik. Cena tokenów jest jedną pozycją na tym rachunku. Opłaty za narzędzia, środowisko wykonawcze, odzyskiwanie poprawnego stanu i kontrola człowieka mogą dodać kolejne. Tabela pomija te dodatkowe usługi, aby zachować przejrzystość arytmetyki; oszacowanie produkcyjne powinno obejmować te, z których faktycznie korzysta integracja.
Nasza ocena: najcenniejszym skutkiem niższej ceny modelu jest większa przestrzeń na poprawę kończenia zadań. Zespół może pozwolić sobie na porównanie instrukcji, analizę nieudanych przypadków i sprawdzenie ścieżki naprawczej. Obniżenie ceny niesprawdzonej odpowiedzi jest mniej użyteczne niż przeznaczenie oszczędności na pracę wymagającą mniej poprawek.
Zacznij od szkicu faktury z jasnym kryterium ukończenia
Pierwszy scenariusz praktyczny to asystent zobowiązań przygotowujący szkic rekordu z dostarczonej faktury. Użyj konta testowego i ograniczonego zestawu dokumentów. Zdefiniuj wymagane pola dostawcy, waluty, kwoty i numeru referencyjnego, zanim poprosisz model o obsługę formularza.
Zaakceptowanym wynikiem jest zapisany szkic, którego pola zgadzają się ze źródłem i którego identyfikator można pobrać. Kliknięcie „Zapisz” to zdarzenie pośrednie. Proces powinien sprawdzić powstały rekord lub stan potwierdzenia oraz zgłosić nierozstrzygnięte pole, zamiast wypełniać je wiarygodnie brzmiącym domysłem.
Próba powinna zawierać zwykłe dokumenty i celowo trudne przykłady: niejasną walutę, brak identyfikatora dostawcy lub istniejący już numer faktury. Przypadki te ujawniają różne rodzaje błędów. Poprawne odczytanie tekstu, wybranie właściwego konta i uniknięcie duplikatu to osobne części zadania.
Pierwsza próba powinna być na tyle krótka, aby przejrzeć każdy wynik. Gdy wystąpi błąd, zidentyfikuj najwcześniejszą niepoprawną obserwację lub czynność, zamiast od razu przepisywać całą instrukcję. Węższa diagnoza pozwala ustalić, czy problem dotyczy interpretacji dokumentu, nawigacji, danych konta czy kontroli akceptacji.
Scenariusz ilustruje projekt aplikacji; nie oznacza, że Terra zawiera konektor księgowy lub że na potrzeby artykułu przetestowano konkretny produkt księgowy. Model jest jednym z elementów procesu, któremu trzeba zapewnić narzędzia i reguły biznesowe.
Dopasowanie katalogowe sprawdza ocenę wizualną przed działaniem
Drugi scenariusz to dopasowanie zdjęcia produktu do istniejącej pozycji katalogu. Karta modelu OpenAI sprawdzona 27 października wymienia dopasowywanie zdjęć produktów wśród planowanych zastosowań Terra. Dla sprzedawcy użytecznym wynikiem może być propozycja dopasowania z informacjami pozwalającymi odróżnić podobny wygląd od właściwego artykułu.
Zbuduj mały zestaw oceny obejmujący łatwe dopasowania, podobne opakowania i zdjęcia z brakującymi szczegółami. Oczekiwane identyfikatory katalogowe przechowuj poza instrukcjami dla modelu. Poproś o proponowany identyfikator i widoczne cechy uzasadniające wybór, z wyraźną opcją „nierozstrzygnięte”, gdy obraz nie wystarcza.
Brak rozstrzygnięcia może być wynikiem poprawnym. Jeśli dwa opakowania różnią się tylko niewidoczną informacją, proces potrzebuje innego zdjęcia lub identyfikatora niewizualnego. Płynny opis opakowania nie tworzy dowodów, których nie było w danych wejściowych.
Zacznij od propozycji dopasowań, zanim dopuścisz edycję katalogu. Ułatwia to kontrolę reguły akceptacji i daje zespołowi zbiór zrozumiałych pomyłek. Jeśli aplikacja później doda etap pisania, oceń, czy szkic opisu zachowuje zweryfikowane fakty katalogowe, zamiast dopisywać niepotwierdzone szczegóły wynikające z podobieństwa wizualnego.
Starszy portal czyni obsługę problemów częścią zadania
Trzeci scenariusz to przygotowanie szkicu aktualizacji w wewnętrznym portalu z interfejsem przeglądarkowym. Zadanie może polegać na znalezieniu rekordu, zmianie opisu na podany tekst i pozostawieniu go do zatwierdzenia przez człowieka. Korzyść wynika z połączenia zrozumiałego polecenia biznesowego z sekwencją działań w interfejsie.
Trudne przypadki często dotyczą stanu. Sesja może wygasnąć, wymagane pole może pojawić się po wcześniejszym wyborze, a aktualizacja strony trwać dłużej niż oczekiwano. Przydatna ocena zapisuje reakcje procesu na te warunki, zamiast liczyć wyłącznie najłatwiejszą ścieżkę nawigacji.
Przed próbą ustal budżet odzyskiwania poprawnego stanu. Aplikacja mogłaby na przykład dopuścić jedną ponowną obserwację po niepewnym zapisie, a potem zatrzymać się do kontroli, jeśli wynik nadal jest niejasny. To przykładowa polityka, nie ograniczenie Terra. Daje zespołowi ograniczone zachowanie do sprawdzenia i sposób zapobiegania marnowaniu zasobów w bezproduktywnej pętli.
Rozróżniaj też błąd integracji od błędu modelu. Narzędzie, które nie dociera do właściwej strony, konto bez prawa edycji i model wybierający niewłaściwą kontrolkę wymagają innych napraw. Widoczne rozdzielenie tych kategorii zwiększa wartość szacunków kosztowych i działań poprawiających jakość.
Dostępność wskazuje punkt startu, a nie uprawnienia każdego konta
Premiera z 26 października zapowiada Terra w ChatGPT Work i Codex dla Plus, Pro, Enterprise oraz Edu, a także identyfikator API gpt-6.1-terra. To ścieżki dostępu do modelu. Narzędzia i uprawnienia konkretnego procesu nadal zależą od produktu, konta i używanej integracji.
Dla programistów karta modelu sprawdzona 27 października określa Responses API do wywoływania narzędzi oraz domyślny poziom rozumowania medium. Zapisuj wybrany model i konfigurację rozumowania podczas oceny, aby sensownie porównywać dwa przebiegi. Jednoczesna zmiana modelu, instrukcji i środowiska narzędzi utrudnia interpretację różnic.
Zespół używający Work lub Codex powinien zacząć od już obsługiwanego procesu i sprawdzić jego rzeczywiste ustawienia. W aplikacji własnej skonfiguruj środowisko wykonawcze i dozwolone działania według aktualnej dokumentacji integracji. Sam identyfikator modelu nie tworzy uwierzytelnionego połączenia z aplikacjami firmy.
Porównuj konfiguracje na tych samych akceptowanych zadaniach
Przydatna pierwsza próba jest mała na tyle, by ją sprawdzić, i zróżnicowana na tyle, by obejmować warunki rzeczywistej pracy. Wybierz regułę akceptacji przed obejrzeniem wyników. Poniższa procedura jest propozycją metody oceny, nie wynikiem benchmarku.
- Wybierz jedno ograniczone zadanie. Określ wymagany wynik i osobę decydującą o jego akceptacji. W pierwszej próbie preferuj szkic lub działanie w środowisku testowym.
- Przygotuj stały zestaw przypadków. Uwzględnij zwykłe dane, brak informacji i istotne przerwania interfejsu. Trzymaj oczekiwane wyniki poza instrukcjami modelu.
- Zapisz konfigurację. Zachowaj identyfikator modelu, ustawienie rozumowania, instrukcje, wersję narzędzia i odpowiednie uprawnienia konta.
- Zdefiniuj zasady zatrzymania i naprawy. Określ, kiedy wolno ponowić obserwację, kiedy powtórzenie jest przydatne i kiedy niepewność musi rozstrzygnąć człowiek.
- Rejestruj obserwowalne rezultaty. Zapisuj wyniki zaakceptowane, błędne i nierozstrzygnięte, próby, czas oraz rozliczane zużycie. Status operacji narzędzia to tylko część tego zapisu.
- Dodaj rzeczywiste koszty działania. Uwzględnij odpowiednie opłaty za narzędzia i środowisko oraz zmierzony czas kontroli. Dziel przez zaakceptowane zadania, zachowując spójne definicje.
- Zmień jedną istotną zmienną. Porównaj poprawioną instrukcję lub ustawienie rozumowania na tych samych przypadkach, a przed rozszerzeniem próby sprawdź, które błędy się zmieniły.
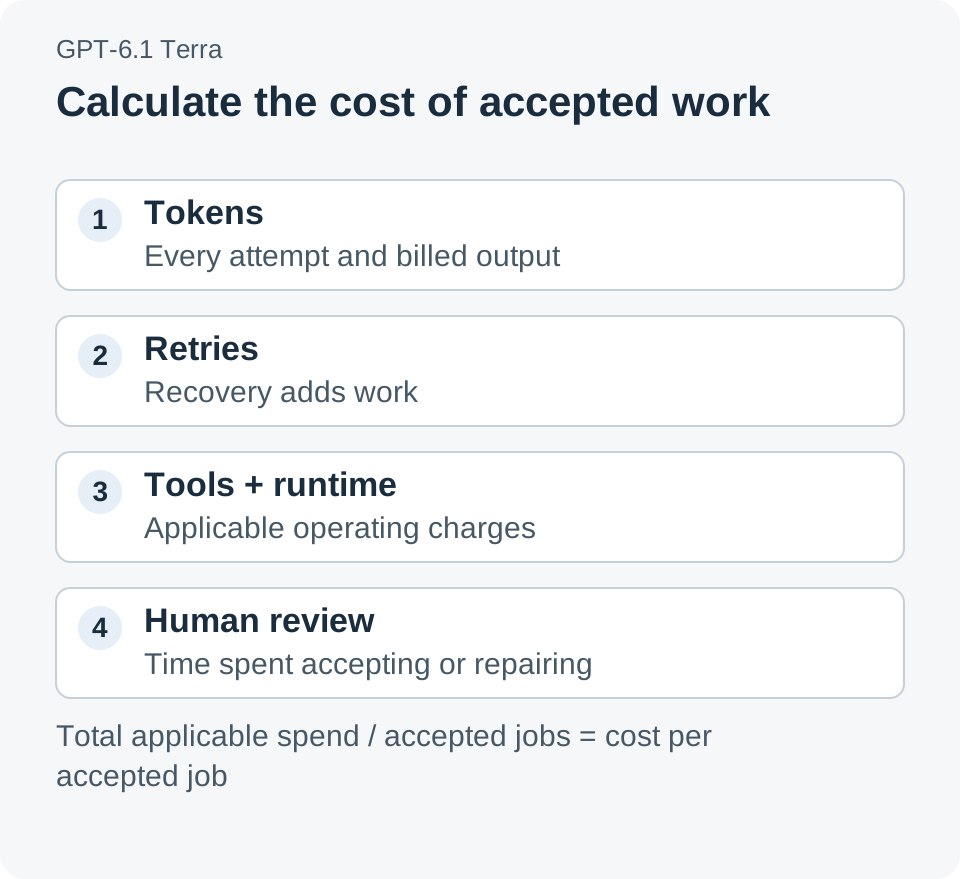
Proponowany model kosztów: zsumuj zasoby rzeczywiście zużywane przez proces, a następnie podziel je przez zaakceptowane zadania. To rama oceny, a nie opublikowane pomiary działania Terra.
Powstały zapis jest użyteczny nawet wtedy, gdy pierwsza próba rozczarowuje. Pokazuje, czy poprawy wymagają interpretacja wizualna, projekt procesu, niezawodność narzędzi czy ilość napraw wykonywanych przez człowieka. To znacznie lepsza podstawa wyboru kolejnej automatyzacji niż sam średni koszt żądania.
Tańsza obsługa komputera ma znaczenie, gdy łatwiej sfinansować ukończenie
Niższe standardowe ceny tokenów Terra stwarzają okazję do dokładniejszych testów i wykonania większej ilości pracy w danym budżecie. Pytanie biznesowe brzmi, czy konkretna integracja potrafi zamienić tę okazję w zaakceptowane wyniki przy możliwym do opanowania nakładzie kontroli i napraw.
Model, który czyta ekran i wybiera kliknięcie, jest przydatny. Proces, który pokazuje, co się zmieniło, rozpoznaje zakończenie i rozlicza wysiłek potrzebny do jego osiągnięcia, daje zespołowi coś, co można oceniać i doskonalić.
Źródła
- Introducing GPT-6.1 Terra, OpenAI, 26 października 2026 r.: pozycjonowanie, standardowe ceny premierowe i ścieżki dostępu.
- Karta systemowa GPT-6.1 Terra, OpenAI, 26 października 2026 r.: datowane wydanie i kontekst oceny.
- Karta modelu GPT-6.1 Terra, sprawdzona 27 października 2026 r.: identyfikator, punkt API dla narzędzi, ustawienie rozumowania i warunki rozliczenia.
- Dokumentacja integracji obsługi komputera, sprawdzona 27 października 2026 r.: aktywność przeglądarki, zrzuty ekranu i mechanika integracji.
Trzy scenariusze, dane kosztowe i procedura oceny są ilustracyjne. Obliczenia w dolarach opierają się na wskazanych standardowych stawkach i jawnie wybranych założeniach; nie są pomiarami opóźnienia, trafności ani kosztów eksploatacji.
Rekomendacja Telli.sh: Zachowuj notatki z prób, materiały źródłowe i uzasadnienia zmian procesu tak, aby łatwo do nich wracać. Utwórz konto Telli.sh i uporządkuj notatki z oceny.