GPT-6.1 Terra costa 1 dollaro per milione di token in ingresso. Quanto costa un compito finito?
GPT-6.1 Terra riduce i prezzi standard per ragionamento visivo e uso del computer. Come valutare lavoro accettato, tentativi ripetuti, revisione umana e integrazione intorno al modello.
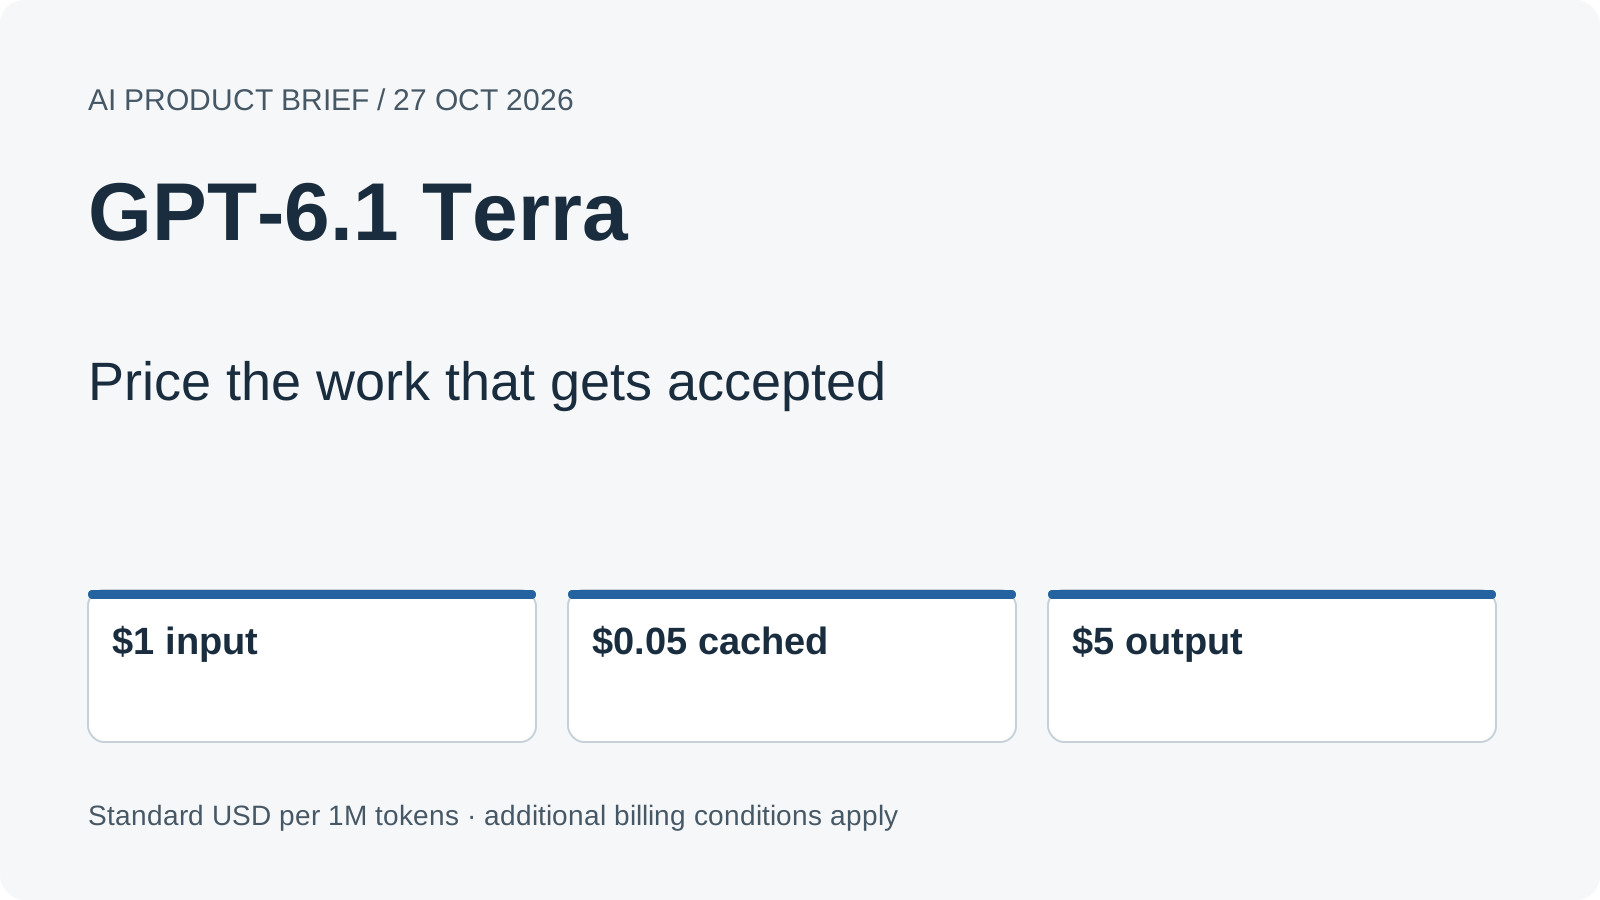
Diagramma editoriale originale di Ken Jo, basato sulle fonti elencate di seguito.
Una fattura occupa un lato dello schermo, un modulo contabile l’altro. Leggere l’importo è un compito. Scegliere il fornitore corretto, inserire la valuta giusta e riconoscere che il record salvato esiste è un compito più ampio. La differenza conta soprattutto quando a fare clic è un modello IA.
OpenAI ha presentato GPT-6.1 Terra il 26 ottobre 2026, con tariffe API standard di 1 dollaro per milione di token in ingresso, 0,05 dollari per milione di token d’ingresso in cache e 5 dollari per milione di token in uscita. L’azienda lo propone per ragionamento visivo, uso del computer e scrittura, dichiarando prezzi standard inferiori del 50% a GPT-5.6 Terra e GPT-6.1 Sol. Annuncio ufficiale, scheda di sistema datata.
Prezzi minori rendono accessibili più esperimenti. Decidere quali trasformare in processi richiede un’altra misura: il costo di un risultato accettabile. La guida segue tre usi, svolge un esempio trasparente e propone una valutazione che distingue chiamata riuscita e lavoro completato.
Il modello sceglie un’azione nel sistema che la esegue
Terra è un modello di OpenAI, l’azienda dietro ChatGPT e Codex. Selezionarlo dà all’applicazione determinate capacità linguistiche e visive. L’applicazione continua a stabilire quale schermo osserva, quali strumenti chiama e a quali account accedono gli strumenti.
Consideriamo la fattura come flusso illustrativo. Il modello osserva il modulo, propone un’azione e riceve una vista aggiornata dopo l’esecuzione. Questa vista conta: un clic apparentemente corretto può aprire un altro pannello, mostrare un errore di validazione o lasciare incompleto il salvataggio. Il processo deve riconoscere lo stato risultante prima di proseguire.
L’uso del computer è quindi un ciclo, non una sola risposta. Un’integrazione utile collega osservazione, azione e controllo dello stato. Definisce anche quando fermarsi, chiedere a una persona o segnalare dati mancanti. Sono decisioni applicative anche se il modello interpreta bene gli schermi.
La documentazione sull’uso del computer, consultata il 27 ottobre, distingue eventi di attività del browser e stato finale di un intero turno. Offre anche controlli per includere screenshot negli output trasmessi. Si può rendere visibile l’avanzamento verificando separatamente l’esistenza del risultato richiesto.
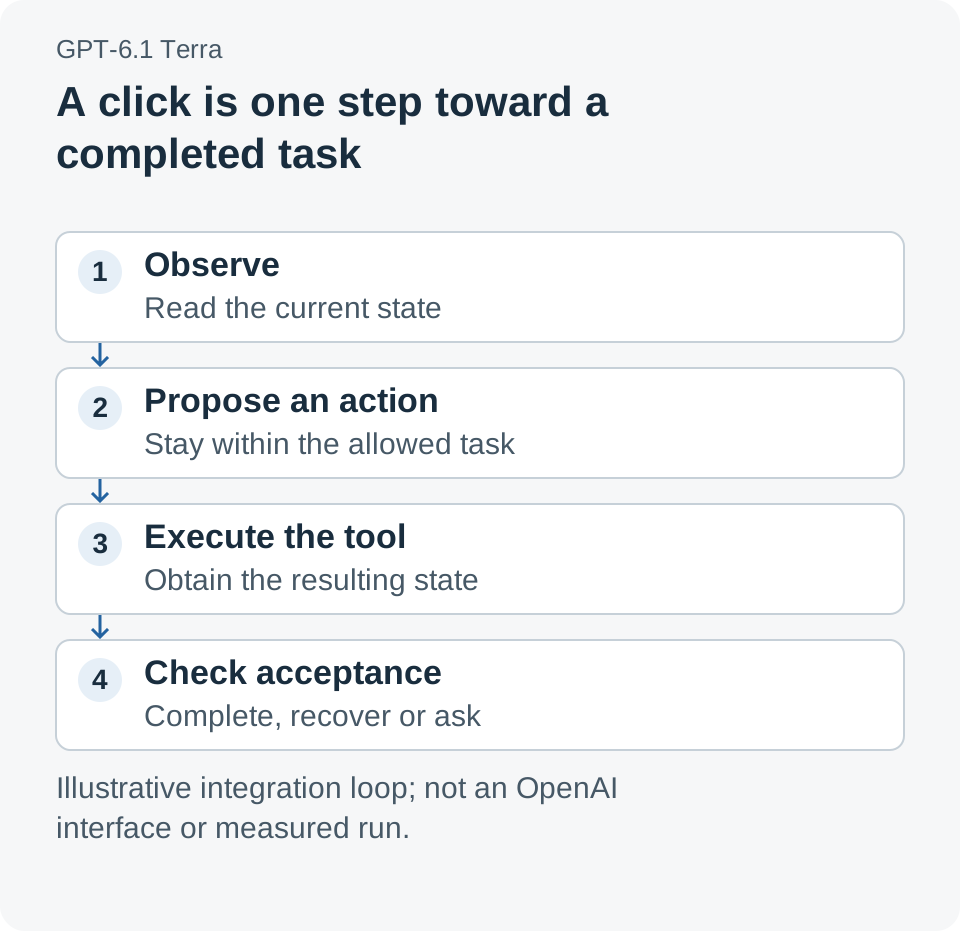
Ciclo illustrativo di uso del computer. L’applicazione fornisce strumenti e permessi; il controllo di accettazione stabilisce se il lavoro è finito. Spiegazione originale, non schermata OpenAI.
Il listino è l’inizio del budget di un carico di lavoro
Le tariffe standard del 26 ottobre sono facili da confrontare a parità di condizioni. Input e output hanno prezzi diversi, e l’input in cache è una categoria separata. Una risposta lunga o osservazioni ripetute possono cambiare il conto anche con lo stesso numero di richieste.
| Categoria di token | Prezzo standard per milione | Cosa misurare nella prova |
|---|---|---|
| Input | $1.00 | Input fatturato in tutti i tentativi |
| Input in cache | $0.05 | Effettivi riscontri in cache, non riuso supposto |
| Output | $5.00 | Output completo fatturato dell’esecuzione |
La scheda del modello, consultata il 27 ottobre, indica condizioni ulteriori. Le scritture in cache hanno tariffe distinte, prompt oltre 272.000 token in ingresso attivano modifiche per contesto lungo e le modalità di servizio possono cambiare il prezzo. Usate la tariffa della richiesta reale, senza considerare universale il valore più basso.
Per l’esempio supponiamo elaborazione standard, nessuna cache e richieste sotto la soglia di contesto lungo. Ogni tentativo usa 10.000 token di input fatturabili e 1.000 di output. Il costo è $0.01 + $0.005 = $0.015 per tentativo. Sono quantità scelte per l’aritmetica, non misure di Terra o di un processo contabile.
La distinzione fonda un budget utile. Calcolate prima il conto di un tentativo con ipotesi esplicite. Poi chiedete quanti tentativi servono, quali altri servizi vengono usati e quanta revisione precede l’accettazione.
Tentativi e revisione cambiano il costo del lavoro accettato
Supponiamo un lotto ipotetico di 100 lavori richiesti. In uno scenario si effettuano 100 tentativi e 90 lavori vengono accettati. In un altro, il recupero porta a 150 tentativi e 95 accettazioni. Il successo aggiuntivo è utile, ma il confronto economico cambia.
Un terzo scenario aggiunge revisione umana su 30 elementi, 20 secondi ciascuno, a un costo ipotizzato di 30 dollari l’ora. Sono 600 secondi, dieci minuti, per 5 dollari. Quantità, accettazioni e costo del lavoro sono tutti illustrativi, non risultati misurati del prodotto.
| Lotto illustrativo | Token | Revisione | Lavori accettati | Costo per lavoro accettato |
|---|---|---|---|---|
| 100 tentativi | $1.50 | $0.00 | 90 | $0.0167 |
| 150 tentativi | $2.25 | $0.00 | 95 | $0.0237 |
| 150 tentativi con revisione indicata | $2.25 | $5.00 | 95 | $0.0763 |
Il denominatore sono i lavori accettati, non le risposte generate. Un messaggio finale curato non lo aumenta se il record è stato salvato male. Al contrario, una breve richiesta di chiarimento può produrre un risultato migliore del proseguire sicuri con informazioni mancanti.
Chiamiamo il lavoro aggiuntivo conto del completamento: risorse necessarie a trasformare un’azione tentata in un risultato accettato. I token sono una voce; strumenti, ambiente, recupero e revisione umana possono aggiungerne altre. La tabella omette servizi ulteriori per rendere chiaro il calcolo. Una stima produttiva deve includere quelli effettivamente usati.
La nostra lettura: l’effetto più prezioso di un modello economico è il margine per migliorare il completamento. Il team può confrontare istruzioni, esaminare errori e provare il recupero. Ridurre il prezzo di una risposta non verificata conta meno che usare il risparmio per ottenere lavoro con meno riparazioni.
Iniziare da una bozza di fattura con un traguardo chiaro
Il primo scenario è un assistente di contabilità fornitori che prepara una bozza da una fattura. Usate un account di test e pochi documenti. Definite fornitore, valuta, importo e riferimenti prima di chiedere al modello di agire sul modulo.
Il risultato accettato è una bozza salvata con campi corrispondenti alla fonte e identificatore recuperabile. Fare clic su Salva è un evento intermedio. Il processo deve ispezionare il record o la conferma e segnalare i campi irrisolti, senza inventare valori plausibili.
Includete documenti comuni e difficoltà intenzionali: valuta poco chiara, identificatore fornitore mancante o numero fattura già presente. Espongono errori diversi. Leggere il testo, scegliere l’account e prevenire duplicati sono parti separate del lavoro.
Mantenete la prova piccola per esaminare ogni risultato. Se fallisce, individuate la prima osservazione o azione scorretta invece di riscrivere subito tutte le istruzioni. Una diagnosi mirata distingue interpretazione, navigazione, dati dell’account e controllo di accettazione.
È un esempio di progettazione applicativa. Non afferma che Terra includa un connettore contabile o che qui sia stato provato un prodotto specifico. Il modello è una componente di un processo a cui vanno forniti strumenti e regole aziendali.
L’abbinamento a catalogo prova il giudizio visivo prima dell’azione
Il secondo scenario associa una foto prodotto a una voce esistente. La scheda OpenAI consultata il 27 ottobre cita esplicitamente questo uso. Per un rivenditore, il risultato utile è un abbinamento proposto con informazioni sufficienti a distinguere somiglianza e articolo corretto.
Create un piccolo insieme con abbinamenti facili, confezioni simili e foto incomplete. Tenete gli identificatori attesi fuori dalle istruzioni. Chiedete identificatore proposto e caratteristiche visibili a sostegno, con un’opzione esplicita di caso irrisolto se la foto non basta.
Un risultato irrisolto può essere corretto. Se due confezioni differiscono solo in dettagli invisibili, serve un’altra foto o un identificatore non visivo. Una descrizione fluida non crea prove assenti dall’input.
Partite da proposte prima di consentire modifiche al catalogo. La regola di accettazione è più facile da ispezionare e gli errori diventano comprensibili. Se si aggiunge scrittura, verificate che la descrizione mantenga fatti confermati, senza importare dettagli non verificati dalla somiglianza.
Un portale preesistente rende il recupero parte del compito
Il terzo scenario prepara una modifica in bozza in un portale interno con interfaccia browser. Potrebbe richiedere di trovare un record, cambiare una descrizione fornita e lasciarlo pronto per approvazione umana. Il vantaggio è collegare una richiesta aziendale comprensibile a una sequenza di azioni.
Le difficoltà riguardano spesso lo stato. Una sessione scade, un campo obbligatorio compare dopo una selezione o la pagina si aggiorna lentamente. La valutazione deve registrare la risposta a queste condizioni, non soltanto il percorso più facile.
Definite prima un budget di recupero. Per esempio, consentite una nuova osservazione dopo un salvataggio incerto, poi fermatevi per revisione se il risultato resta ambiguo. È una politica illustrativa, non un limite Terra. Offre un comportamento circoscritto da provare e impedisce cicli improduttivi che consumano risorse.
Distinguete anche guasto d’integrazione ed errore del modello. Uno strumento che non raggiunge la pagina, un account senza permessi e un controllo selezionato male richiedono correzioni differenti. Tenere visibili le categorie migliora stime e interventi qualitativi.
La disponibilità indica da dove iniziare, non i poteri di ogni account
Il lancio del 26 ottobre presenta Terra in ChatGPT Work e Codex per Plus, Pro, Enterprise ed Edu, oltre all’identificatore API gpt-6.1-terra. Sono accessi al modello. Strumenti e permessi di un flusso dipendono ancora da prodotto, account e integrazione.
Per gli sviluppatori, la scheda consultata il 27 ottobre indica Responses API per le chiamate agli strumenti e ragionamento predefinito medium. Registrate modello e configurazione per confrontare le prove. Cambiare insieme modello, istruzioni e ambiente rende difficile interpretare risultati diversi.
In Work o Codex iniziate da un processo già supportato e dai suoi controlli effettivi. Per un’applicazione personalizzata, usate la documentazione corrente per configurare ambiente e azioni consentite. L’identificatore da solo non crea una connessione autenticata alle applicazioni aziendali.
Confrontare configurazioni sugli stessi compiti accettati
Una buona prima prova è abbastanza piccola da esaminare e varia da coprire le condizioni reali. Stabilite l’accettazione prima di vedere i risultati. La procedura seguente è un metodo proposto, non un risultato di benchmark.
- Scegliete un lavoro circoscritto. Definite output e persona che lo accetta. Preferite all’inizio una bozza o un ambiente di test.
- Preparate casi fissi. Includete input normali, dati mancanti e interruzioni pertinenti. Tenete i risultati attesi fuori dalle istruzioni.
- Registrate la configurazione. Salvate identificatore, ragionamento, istruzioni, versione strumenti e permessi rilevanti.
- Definite arresto e recupero. Stabilite quando osservare ancora, riprovare o chiedere a una persona di risolvere l’incertezza.
- Acquisite risultati osservabili. Registrate accettazioni, errori, casi irrisolti, tentativi, tempo e consumo fatturato. Lo stato dell’operazione è solo una parte.
- Aggiungete i costi operativi reali. Includete strumenti, ambiente e revisione misurata. Dividete per lavori accettati con definizioni coerenti.
- Cambiate una variabile significativa. Confrontate nuove istruzioni o ragionamento sugli stessi casi, poi esaminate quali errori sono cambiati prima di ampliare.
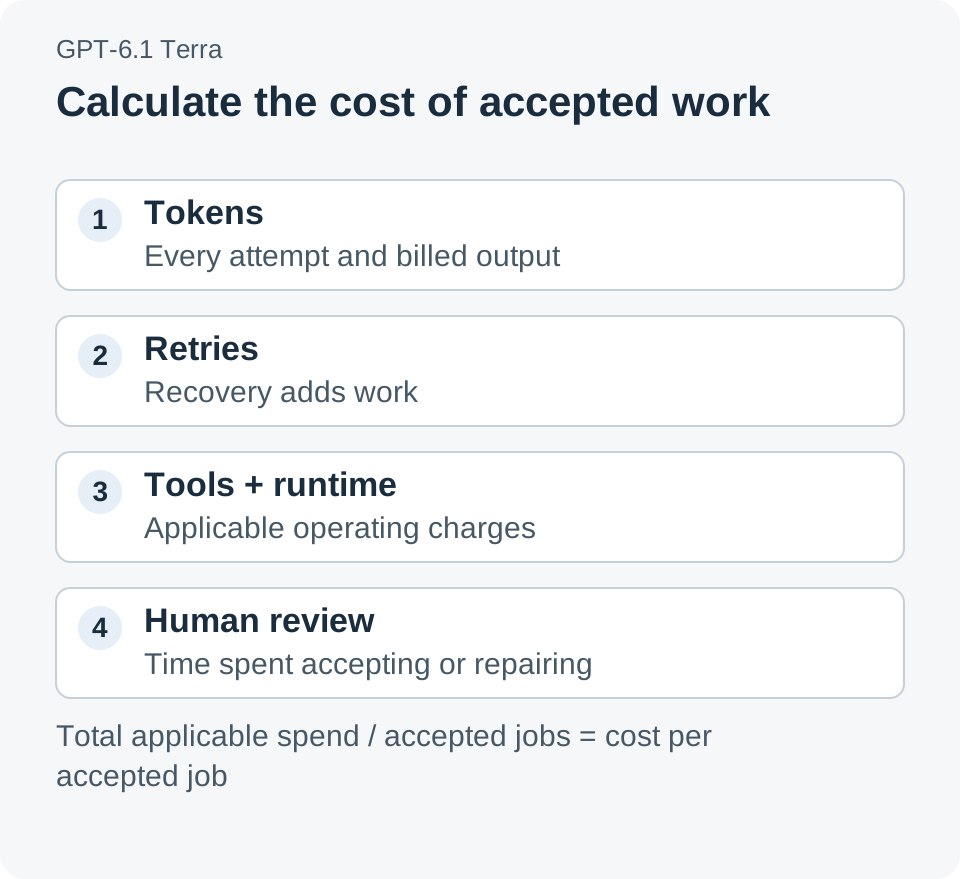
Modello di costo proposto: sommare risorse effettive e dividere per lavori accettati. È un quadro di valutazione, non misure operative pubblicate di Terra.
Il registro aiuta anche quando la prima prova delude. Indica se migliorare interpretazione visiva, progetto del flusso, affidabilità degli strumenti o riparazioni umane. È una base migliore per scegliere la prossima automazione rispetto al solo costo medio di una richiesta.
Il computer più economico conta se completare diventa sostenibile
I prezzi standard inferiori di Terra permettono prove più attente e più lavoro entro un budget. La domanda aziendale è se un’integrazione concreta trasformi l’opportunità in risultati accettati, con revisione e recupero gestibili.
Un modello che legge uno schermo e sceglie un clic è utile. Un processo che mostra cosa è cambiato, riconosce la fine e contabilizza lo sforzo necessario è qualcosa che un team può valutare e migliorare.
Fonti
- Presentazione di GPT-6.1 Terra, OpenAI, 26 ottobre 2026: posizionamento, tariffe standard e accesso.
- Scheda di sistema GPT-6.1 Terra, OpenAI, 26 ottobre 2026: contesto datato di uscita e valutazione.
- Scheda del modello GPT-6.1 Terra, consultata il 27 ottobre 2026: identificatore, endpoint strumenti, ragionamento e fatturazione.
- Documentazione d’integrazione dell’uso del computer, consultata il 27 ottobre 2026: attività browser, screenshot e meccanismi.
I tre scenari, i dati economici e la procedura sono illustrativi. I calcoli in dollari usano le tariffe indicate e ipotesi esplicite; non sono misurazioni di latenza, accuratezza o costi operativi.
Consiglio di Telli.sh: Mantenete facilmente reperibili appunti delle prove, riferimenti e decisioni dietro una revisione del processo. Create un account Telli.sh per organizzare le note di valutazione.