GPT-6.1 Terra coûte 1 dollar par million de tokens en entrée. Combien coûte une tâche terminée ?
GPT-6.1 Terra réduit les tarifs standard du raisonnement visuel et de l’usage de l’ordinateur. Comment évaluer travail accepté, nouvelles tentatives, revue humaine et intégration autour du modèle.
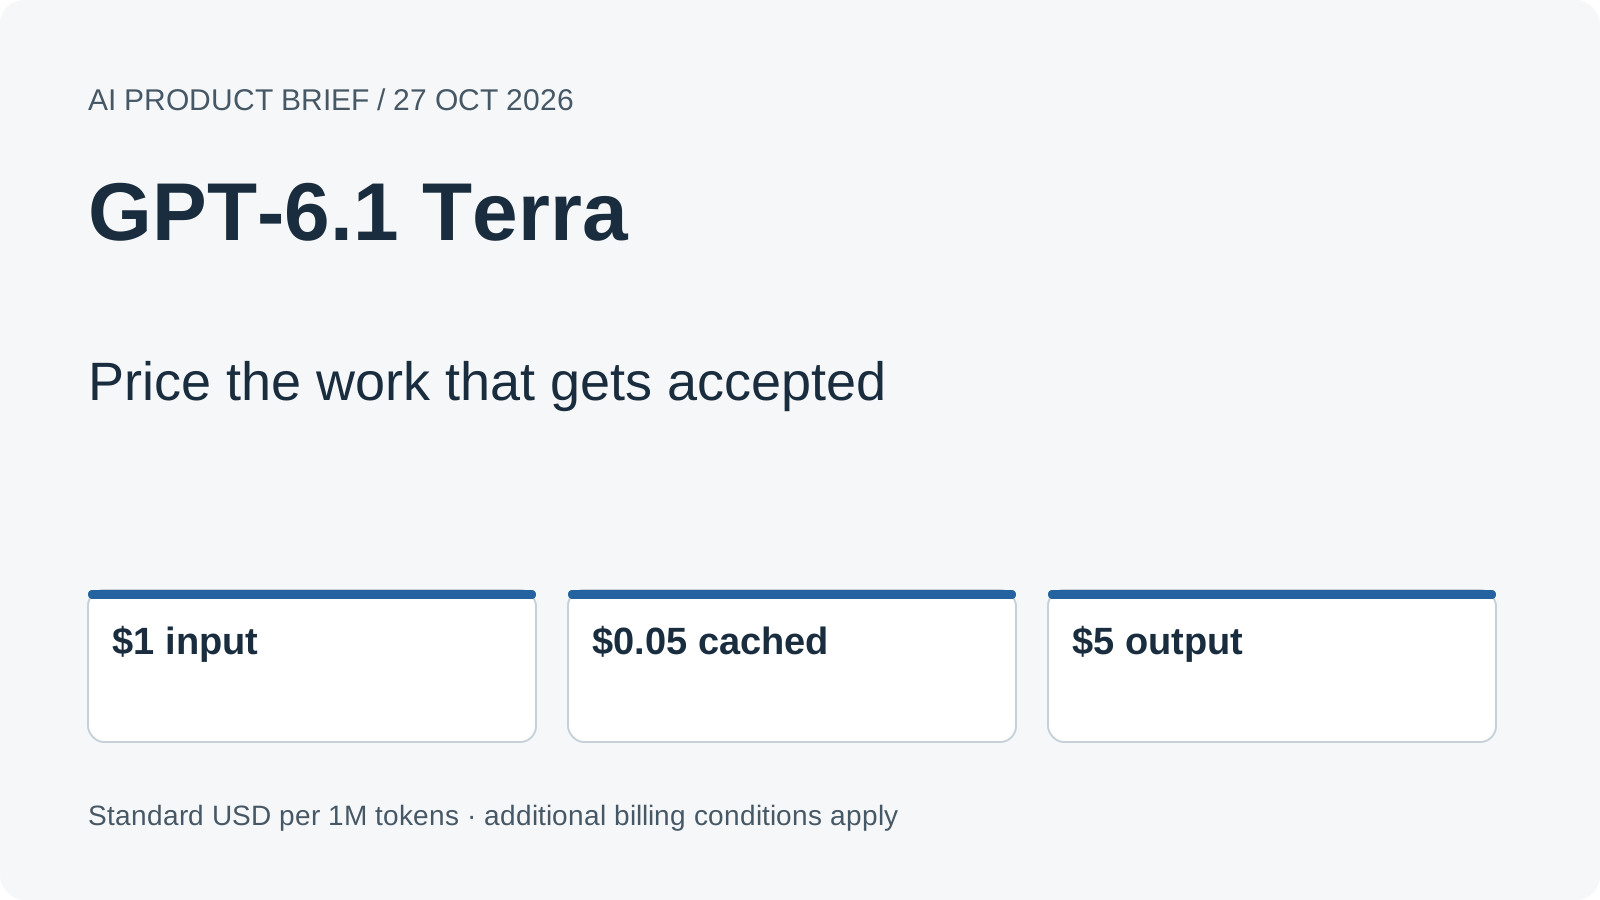
Schéma éditorial original de Ken Jo, fondé sur les sources présentées ci-dessous.
Une facture apparaît d’un côté de l’écran, un formulaire comptable de l’autre. Lire le montant est une tâche. Choisir le bon fournisseur, saisir la bonne devise et reconnaître que l’enregistrement existe réellement en est une plus large. Cette différence compte particulièrement lorsque c’est un modèle d’IA qui clique.
OpenAI a présenté GPT-6.1 Terra le 26 octobre 2026, aux tarifs API standard de 1 dollar par million de tokens en entrée, 0,05 dollar par million de tokens d’entrée en cache et 5 dollars par million de tokens en sortie. L’entreprise le positionne pour le raisonnement visuel, l’usage de l’ordinateur et l’écriture, et annonce des tarifs 50 % inférieurs à GPT-5.6 Terra et GPT-6.1 Sol. Annonce officielle, fiche système datée.
Des prix plus bas rendent davantage d’essais abordables. Pour décider lesquels méritent de devenir un processus, il faut une autre mesure : le coût d’un résultat acceptable. Ce guide examine trois usages, déroule un calcul transparent et propose une évaluation qui distingue appel d’outil réussi et travail terminé.
Le modèle choisit une action dans un système qui l’exécute
Terra est un modèle d’OpenAI, l’entreprise derrière ChatGPT et Codex. Le sélectionner donne à une application certaines capacités linguistiques et visuelles. L’application détermine toujours quel écran il observe, quels outils il appelle et quels comptes ces outils peuvent utiliser.
Prenons la facture comme exemple illustratif. Le modèle observe le formulaire, propose une action et reçoit une vue actualisée après exécution. Cette nouvelle vue compte : un clic apparemment correct peut ouvrir un autre panneau, révéler une erreur de validation ou laisser la sauvegarde inachevée. Le processus doit reconnaître l’état obtenu avant de continuer.
L’usage de l’ordinateur forme donc une boucle plutôt qu’une réponse unique. Une bonne intégration relie observations, actions et contrôles de l’état. Elle définit également quand s’arrêter, demander à une personne ou signaler une entrée manquante. Ces choix appartiennent à la conception, même si le modèle interprète bien les écrans.
La documentation d’usage de l’ordinateur, consultée le 27 octobre, distingue les événements d’activité du navigateur du statut final d’un tour complet. Elle propose aussi des contrôles d’inclusion des captures dans les sorties diffusées. Le développeur peut montrer la progression tout en vérifiant séparément l’existence du résultat demandé.
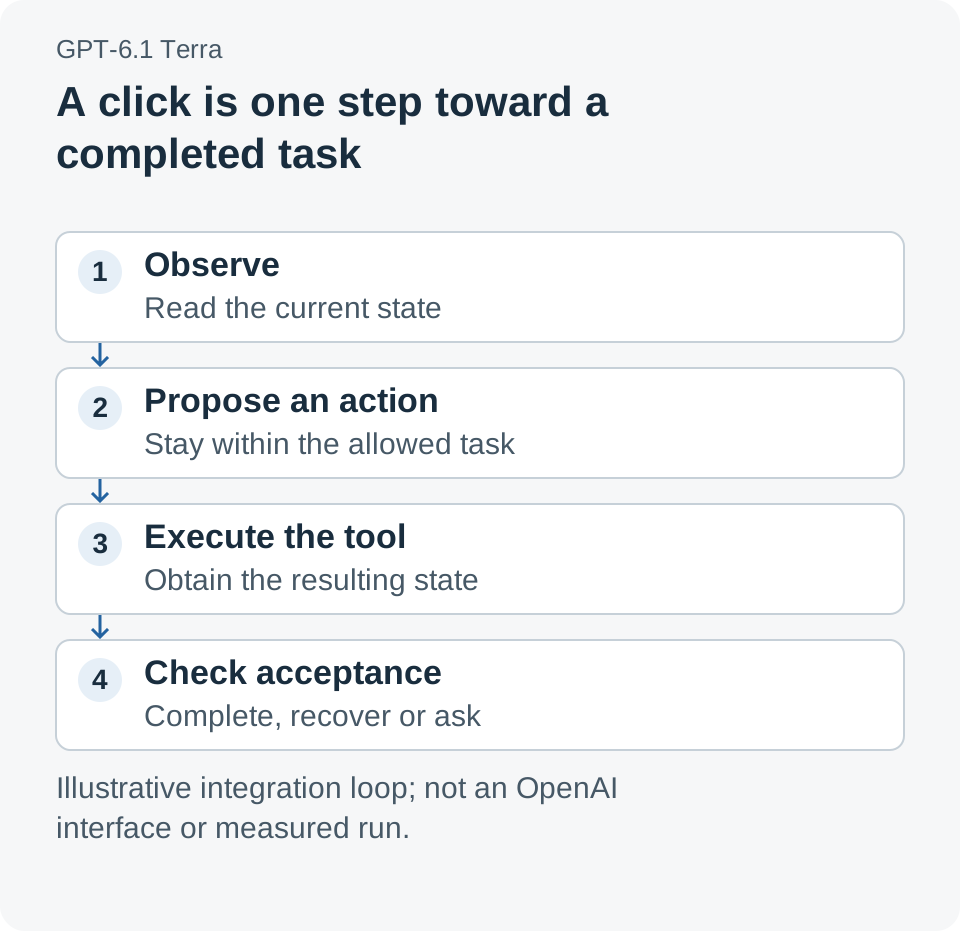
Boucle illustrative d’usage de l’ordinateur. L’application fournit outils et droits ; le contrôle d’acceptation établit si le travail est terminé. Illustration originale, pas une capture d’interface OpenAI.
La grille tarifaire amorce le budget d’une charge de travail
Les tarifs standard du 26 octobre sont simples à comparer si les conditions de facturation restent identiques. Entrée et sortie ont des prix différents, et l’entrée en cache constitue une catégorie distincte. Une réponse longue ou une boucle d’observation répétée peut modifier la facture sans changer le nombre de requêtes utilisateur.
| Catégorie de tokens | Tarif standard par million | Mesure utile pendant l’essai |
|---|---|---|
| Entrée | $1.00 | Entrée facturée sur toutes les tentatives |
| Entrée en cache | $0.05 | Occurrences réelles de cache, pas réutilisation supposée |
| Sortie | $5.00 | Total de sortie facturé pour l’exécution |
La fiche du modèle, consultée le 27 octobre, détaille d’autres conditions. L’écriture en cache a ses propres tarifs, les prompts dépassant 272 000 tokens d’entrée déclenchent des ajustements de contexte long, et les modes de service peuvent changer le prix. Utilisez le tarif de la requête réelle, sans traiter le minimum affiché comme universel.
Pour le calcul ci-dessous, supposons un traitement standard, aucun cache et des requêtes sous le seuil de contexte long. Chaque tentative consomme 10 000 tokens d’entrée facturables et 1 000 de sortie. Son coût est donc $0.01 + $0.005 = $0.015 par tentative. Ces volumes sont choisis pour le calcul, pas mesurés sur Terra ou sur une tâche comptable.
Cette distinction fonde un budget utile. Déterminez d’abord la facture d’une tentative avec des hypothèses explicites. Demandez ensuite combien de tentatives sont nécessaires, quels autres services interviennent et quelle revue précède l’acceptation.
Les reprises et la revue changent le coût du travail accepté
Supposons un lot fictif de 100 travaux demandés. Dans un scénario, 100 tentatives produisent 90 travaux acceptés. Dans un autre, les reprises portent le nombre à 150 tentatives et 95 travaux acceptés. Le succès supplémentaire est utile, mais la comparaison des coûts change.
Un troisième scénario ajoute la revue de 30 éléments pendant 20 secondes chacun, avec un coût horaire supposé de 30 dollars. Cela représente 600 secondes, soit dix minutes et 5 dollars. Tous les volumes, nombres d’acceptations et coûts de travail sont illustratifs, sans mesure de performance produit.
| Lot illustratif | Coût des tokens | Coût de revue | Travaux acceptés | Coût par travail accepté |
|---|---|---|---|---|
| 100 tentatives | $1.50 | $0.00 | 90 | $0.0167 |
| 150 tentatives | $2.25 | $0.00 | 95 | $0.0237 |
| 150 tentatives avec la revue indiquée | $2.25 | $5.00 | 95 | $0.0763 |
Le dénominateur correspond aux travaux acceptés, pas aux réponses générées. Un message de fin soigné ne l’augmente pas si le dossier a été mal enregistré. Inversement, une brève demande de précision peut produire un résultat plus utile qu’une poursuite confiante malgré des informations manquantes.
Appelons ce travail supplémentaire la facture d’achèvement : les ressources nécessaires pour transformer une action tentée en résultat accepté. Les tokens en sont un poste ; outils, environnement d’exécution, reprise et revue humaine peuvent s’y ajouter. Le tableau omet les autres services pour rendre le calcul lisible. Une estimation de production doit intégrer ceux réellement utilisés.
Notre avis : le principal intérêt d’un modèle moins cher est de donner plus de marge pour améliorer l’achèvement. L’équipe peut comparer des instructions, examiner les échecs et tester une reprise. Réduire le prix d’une réponse non vérifiée vaut moins qu’utiliser l’économie pour produire un travail demandant moins de correction.
Commencer par un brouillon de facture avec une fin bien définie
Premier scénario : un assistant de comptabilité fournisseurs prépare un brouillon depuis une facture fournie. Utilisez un compte de test et un ensemble limité de documents. Définissez fournisseur, devise, montant et référence avant de demander au modèle d’interagir avec le formulaire.
Le résultat accepté est un brouillon enregistré dont les champs correspondent à la source et dont l’identifiant peut être récupéré. Cliquer sur Enregistrer est intermédiaire. Le processus doit inspecter le dossier ou l’état de confirmation et signaler les champs non résolus plutôt que les remplir par supposition plausible.
Incluez des documents ordinaires et des difficultés délibérées : devise incertaine, identifiant fournisseur absent, numéro déjà existant. Ces cas exposent des échecs différents. Lire correctement, choisir le bon compte et éviter un doublon sont des composantes distinctes.
Gardez l’essai assez court pour revoir chaque résultat. En cas d’échec, trouvez la première observation ou action incorrecte au lieu de réécrire toutes les instructions. Un diagnostic ciblé distingue interprétation documentaire, navigation, données du compte et contrôle d’acceptation.
Ce scénario illustre une conception applicative. Il n’affirme ni que Terra fournit un connecteur comptable, ni qu’un logiciel précis a été testé ici. Le modèle est une composante d’un processus dont il faut fournir les outils et les règles métier.
Le rapprochement de catalogue teste le jugement visuel avant l’action
Deuxième scénario : associer une photo produit à une fiche existante. La fiche OpenAI consultée le 27 octobre cite explicitement cet usage. Pour un commerçant, le résultat utile est une correspondance proposée avec assez d’informations pour distinguer une simple ressemblance du bon article.
Préparez un petit ensemble de correspondances faciles, d’emballages proches et de photos incomplètes. Gardez les identifiants attendus hors des instructions. Demandez un identifiant proposé et les caractéristiques visibles qui le justifient, avec une option explicite de non-résolution si l’image ne suffit pas.
Un résultat non résolu peut être correct. Si deux emballages ne diffèrent que par une information invisible, il faut une autre photo ou un identifiant non visuel. Une description fluide ne crée pas une preuve absente.
Commencez par des propositions avant d’autoriser des modifications du catalogue. La règle d’acceptation devient plus simple à inspecter et les erreurs plus compréhensibles. Si une étape d’écriture est ajoutée, vérifiez que la description conserve les faits validés plutôt que des détails déduits d’une ressemblance.
Un ancien portail fait de la reprise une partie de la tâche
Troisième scénario : préparer une mise à jour en brouillon dans un portail interne doté d’une interface navigateur. Il peut s’agir de retrouver un dossier, modifier une description fournie et laisser le résultat prêt à être approuvé. L’intérêt est de relier une demande métier compréhensible à une séquence d’actions.
Les cas difficiles concernent souvent l’état. Une session expire, un champ obligatoire apparaît après une sélection, ou la page se met à jour plus lentement. Une évaluation utile enregistre la réaction à ces conditions, au lieu de compter seulement le chemin facile.
Définissez un budget de reprise avant l’essai. Par exemple, autorisez une nouvelle observation après une sauvegarde incertaine, puis arrêtez pour revue si le résultat reste ambigu. C’est un choix de politique illustratif, pas une limite de Terra. Il fournit un comportement borné à tester et évite une boucle coûteuse sans progrès.
Distinguez aussi panne d’intégration et erreur du modèle. Un outil qui n’atteint pas la page, un compte sans droit d’écriture et un mauvais contrôle sélectionné demandent des corrections différentes. Ces catégories rendent les estimations et les améliorations plus pertinentes.
La disponibilité indique où commencer, pas les droits de chaque compte
L’annonce du 26 octobre présente Terra dans ChatGPT Work et Codex pour Plus, Pro, Enterprise et Edu, ainsi que l’identifiant API gpt-6.1-terra. Ce sont des voies d’accès au modèle. Les outils et permissions d’un processus dépendent toujours du produit, du compte et de l’intégration.
Pour les développeurs, la fiche consultée le 27 octobre indique la Responses API pour les appels d’outils et un effort de raisonnement par défaut de medium. Enregistrez modèle et configuration pour comparer les essais. Changer simultanément modèle, instructions et environnement rend les différences plus difficiles à interpréter.
Dans Work ou Codex, partez d’un processus déjà pris en charge et examinez ses commandes réelles. Pour une application personnalisée, utilisez la documentation actuelle afin de configurer l’exécution et les actions autorisées. L’identifiant du modèle ne crée pas à lui seul une connexion authentifiée aux applications de l’entreprise.
Comparer les configurations sur les mêmes tâches acceptées
Un premier essai utile reste inspectable tout en couvrant les conditions réelles. Choisissez la règle d’acceptation avant de voir les sorties. La procédure suivante est une méthode proposée, pas un résultat de benchmark.
- Choisissez un travail limité. Nommez la sortie requise et la personne qui l’accepte. Préférez d’abord un brouillon ou un environnement de test.
- Préparez des cas fixes. Incluez entrées normales, informations manquantes et interruptions pertinentes. Gardez les résultats attendus hors des instructions.
- Enregistrez la configuration. Sauvegardez identifiant du modèle, raisonnement, instructions, version des outils et permissions utiles.
- Définissez arrêt et reprise. Précisez quand réobserver, quand réessayer et quand une personne doit lever l’incertitude.
- Capturez les résultats observables. Notez acceptations, erreurs, cas non résolus, tentatives, durée et consommation facturée. Le statut d’un outil n’est qu’une partie du dossier.
- Ajoutez les coûts réels d’exploitation. Incluez outils, environnement et temps de revue mesuré. Divisez par les travaux acceptés avec des définitions constantes.
- Changez une variable significative. Comparez une instruction ou un réglage de raisonnement sur les mêmes cas, puis examinez les échecs modifiés avant d’élargir.
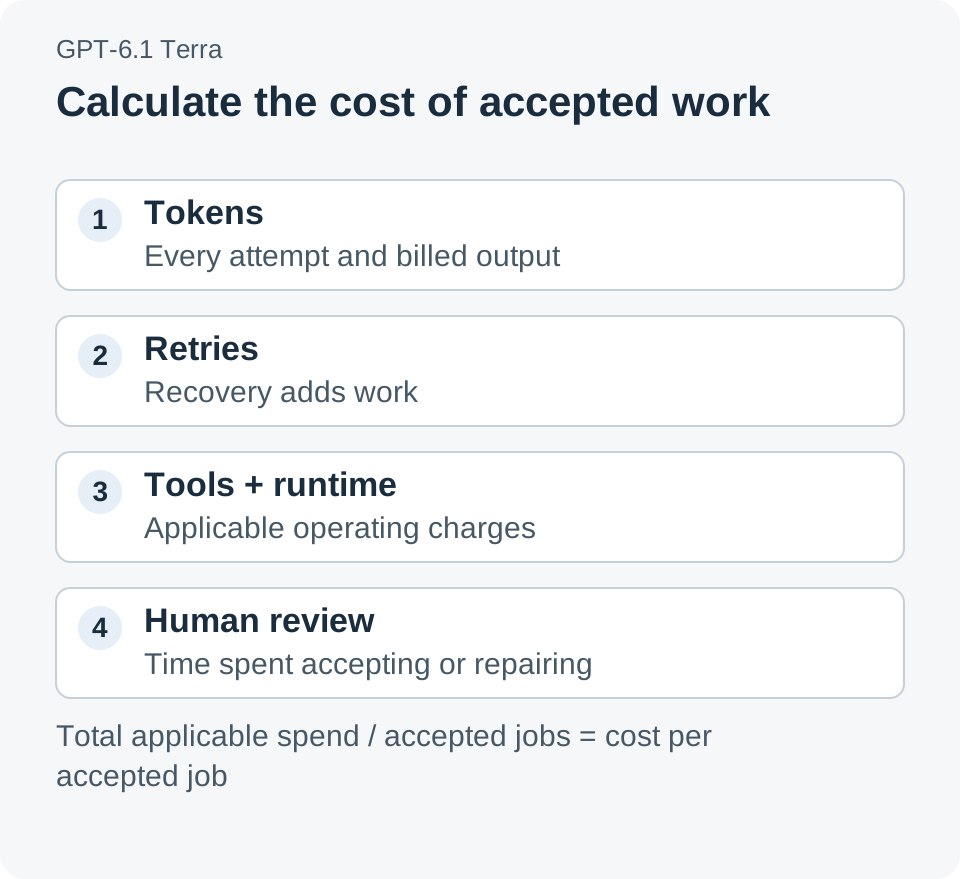
Modèle de coût proposé : additionner les ressources réellement consommées, puis diviser par les travaux acceptés. C’est un cadre d’évaluation, pas des mesures d’exploitation publiées de Terra.
Le relevé sert même lorsque le premier essai déçoit. Il montre s’il faut améliorer l’interprétation visuelle, le processus, la fiabilité des outils ou les corrections humaines. C’est une meilleure base pour choisir la prochaine automatisation que le seul coût moyen d’une requête.
L’ordinateur moins cher compte si achever le travail devient abordable
Les tarifs standard réduits de Terra permettent d’essayer plus soigneusement et de soutenir davantage de travail dans un budget. La question métier est de savoir si une intégration transforme cette possibilité en résultats acceptés avec une revue et des reprises maîtrisables.
Un modèle qui lit un écran et choisit un clic est utile. Un processus qui montre ce qui a changé, reconnaît sa fin et comptabilise l’effort nécessaire est quelque chose qu’une équipe peut évaluer et améliorer.
Sources
- Présentation de GPT-6.1 Terra, OpenAI, 26 octobre 2026 : positionnement, tarifs standard et accès.
- Fiche système GPT-6.1 Terra, OpenAI, 26 octobre 2026 : contexte daté de sortie et d’évaluation.
- Fiche du modèle GPT-6.1 Terra, consultée le 27 octobre 2026 : identifiant, point d’appel des outils, raisonnement et facturation.
- Documentation d’intégration de l’usage de l’ordinateur, consultée le 27 octobre 2026 : activité navigateur, captures et mécanismes.
Les trois scénarios, données de coût et étapes d’évaluation sont illustratifs. Les calculs en dollars utilisent les tarifs indiqués et des hypothèses explicites ; ils ne mesurent ni latence, ni précision, ni coût opérationnel.
Recommandation de Telli.sh : Gardez accessibles notes d’essai, références et décisions derrière une révision du processus. Créez un compte Telli.sh pour organiser vos notes d’évaluation.