GPT-6.1 Terra cuesta 1 dólar por millón de tokens de entrada. ¿Cuánto cuesta una tarea terminada?
GPT-6.1 Terra reduce los precios estándar de razonamiento visual y uso del ordenador. Cómo evaluar trabajo aceptado, reintentos, revisión humana y la integración que rodea al modelo.
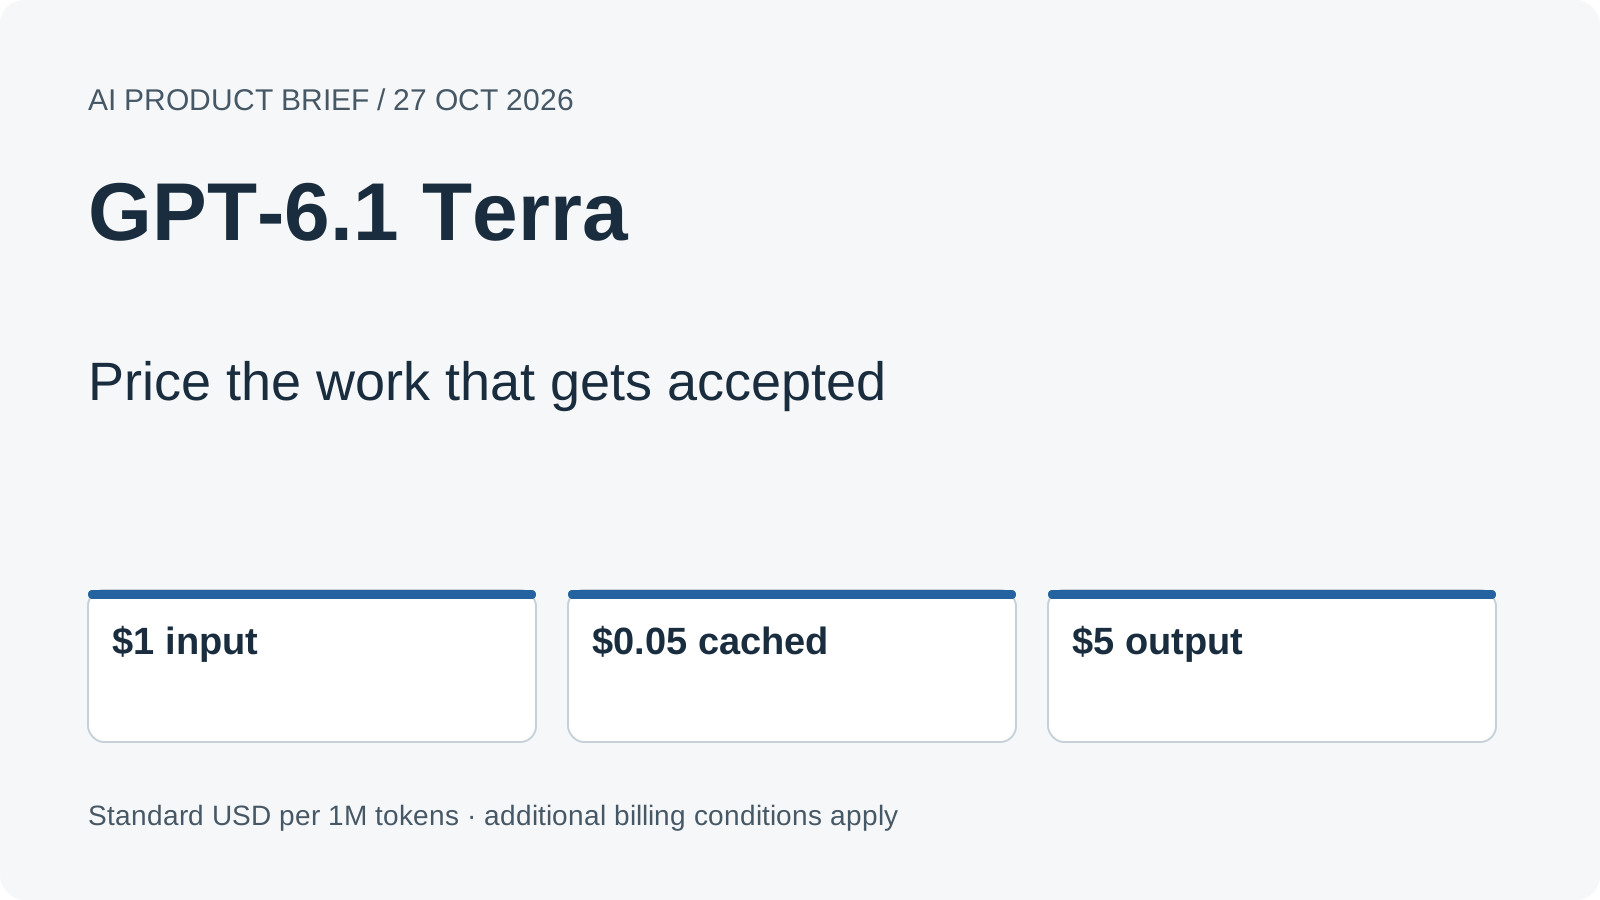
Diagrama editorial original de Ken Jo, basado en las fuentes indicadas al final.
Hay una factura en un lado de la pantalla y un formulario contable en el otro. Leer el importe es una tarea. Elegir el proveedor correcto, introducir la moneda adecuada y reconocer que el registro guardado existe es una tarea mayor. La diferencia importa especialmente cuando quien hace clic es un modelo de IA.
OpenAI presentó GPT-6.1 Terra el 26 de octubre de 2026, con tarifas API estándar de 1 dólar por millón de tokens de entrada, 0,05 dólares por millón de tokens de entrada en caché y 5 dólares por millón de tokens de salida. Lo posiciona para razonamiento visual, uso del ordenador y escritura, y afirma que esos precios son un 50 % inferiores a GPT-5.6 Terra y GPT-6.1 Sol. Anuncio oficial, ficha de sistema fechada.
Precios menores permiten más experimentos. Decidir cuáles deben convertirse en un flujo exige otra medida: el coste de un resultado aceptable. Esta guía sigue tres usos, desarrolla un ejemplo transparente y propone evaluar sin confundir una llamada exitosa con trabajo terminado.
El modelo elige una acción dentro de un sistema que la ejecuta
Terra es un modelo de OpenAI, la empresa detrás de ChatGPT y Codex. Seleccionarlo aporta ciertas capacidades lingüísticas y visuales. La aplicación sigue determinando qué pantalla observa, qué herramientas invoca y a qué cuentas acceden esas herramientas.
Considere la factura como un flujo ilustrativo. El modelo observa el formulario, propone una acción y recibe una vista actualizada después de ejecutarla. Esa vista importa: un clic aparentemente correcto puede abrir otro panel, mostrar un error de validación o dejar el guardado incompleto. El flujo debe reconocer el estado resultante antes de continuar.
Usar el ordenador es, por tanto, un bucle y no una sola respuesta. Una integración útil conecta observación, acción y comprobación del estado. También establece cuándo detenerse, preguntar a una persona o informar de datos ausentes. Son decisiones de diseño, incluso si el modelo interpreta bien las pantallas.
La documentación de uso del ordenador, consultada el 27 de octubre, distingue eventos de actividad del navegador y estado final de un turno completo. También ofrece controles para incluir capturas en las salidas transmitidas. El desarrollador puede mostrar progreso y verificar por separado que el resultado pedido exista.
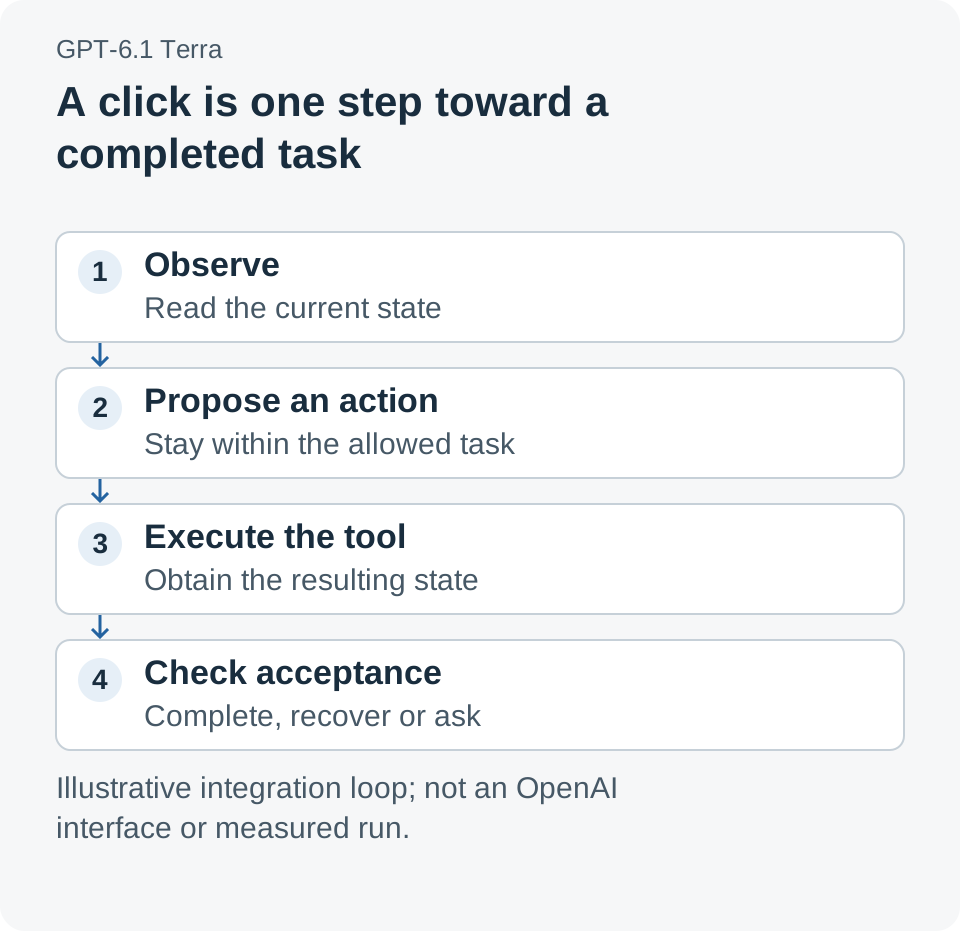
Bucle ilustrativo de uso del ordenador. La aplicación aporta herramientas y permisos; la aceptación comprueba si el trabajo terminó. Es una explicación original, no una captura de OpenAI.
La tarifa es el comienzo del presupuesto de una carga de trabajo
Las tarifas estándar del 26 de octubre son comparables si se usan las mismas condiciones de facturación. Entrada y salida tienen precios distintos, y la entrada en caché es otra categoría. Una respuesta larga o un bucle de observación repetido cambia la factura aunque las solicitudes de usuarios sean las mismas.
| Categoría | Precio estándar por millón de tokens | Qué medir en la prueba |
|---|---|---|
| Entrada | $1.00 | Entrada facturada entre todos los intentos |
| Entrada en caché | $0.05 | Aciertos reales de caché, no reutilización supuesta |
| Salida | $5.00 | Salida completa facturada de la ejecución |
La ficha del modelo, consultada el 27 de octubre, recoge condiciones adicionales. Escribir en caché tiene otras tarifas, los prompts superiores a 272.000 tokens de entrada activan ajustes de contexto largo y los modos de servicio pueden cambiar precios. Use la tarifa de la solicitud real, sin convertir el mínimo de una tabla en precio universal.
Para el ejemplo, suponga procesamiento estándar, sin caché y solicitudes bajo el umbral de contexto largo. Cada intento consume 10.000 tokens de entrada facturables y 1.000 de salida. El coste es $0.01 + $0.005 = $0.015 por intento. Son cantidades elegidas para el cálculo, no mediciones de Terra ni de un proceso contable.
La distinción funda un presupuesto útil. Primero determine la factura de un intento bajo supuestos explícitos. Después pregunte cuántos intentos hacen falta, qué otros servicios intervienen y cuánta revisión precede a la aceptación.
Reintentos y revisión cambian el coste del trabajo aceptado
Suponga un lote hipotético de 100 trabajos. En un escenario, se hacen 100 intentos y se aceptan 90. En otro, la recuperación eleva los intentos a 150 y se aceptan 95. El éxito adicional sirve, pero cambia la comparación de costes.
Un tercer escenario añade revisión de 30 elementos durante 20 segundos cada uno, con un coste laboral supuesto de 30 dólares por hora. Son 600 segundos, diez minutos, y 5 dólares. Todos los volúmenes, aceptaciones y supuestos laborales son ilustrativos; ninguno representa un resultado medido del producto.
| Lote ilustrativo | Tokens | Revisión | Trabajos aceptados | Coste por trabajo aceptado |
|---|---|---|---|---|
| 100 intentos | $1.50 | $0.00 | 90 | $0.0167 |
| 150 intentos | $2.25 | $0.00 | 95 | $0.0237 |
| 150 intentos con la revisión indicada | $2.25 | $5.00 | 95 | $0.0763 |
El denominador son trabajos aceptados, no respuestas generadas. Un mensaje de finalización pulido no lo aumenta si el registro se guardó mal. A la inversa, pedir una aclaración breve puede ser más útil que continuar con seguridad pese a datos ausentes.
Llamemos al esfuerzo adicional la factura de finalización: recursos para convertir una acción intentada en un resultado aceptado. Los tokens son una partida; herramientas, entorno de ejecución, recuperación y revisión humana añaden otras. La tabla omite servicios adicionales para mostrar la aritmética. Una estimación de producción debe incluir los realmente utilizados.
Nuestra opinión: el principal efecto de un modelo más barato es dar margen para mejorar la finalización. El equipo puede comparar instrucciones, inspeccionar fallos y probar recuperación. Abaratar una respuesta no comprobada vale menos que usar el ahorro para producir trabajo con menos reparación.
Empiece por un borrador de factura con una meta clara
El primer escenario es un asistente de cuentas por pagar que prepara un borrador desde una factura. Use una cuenta de prueba y documentos limitados. Defina proveedor, moneda, importe y referencia antes de pedir al modelo que interactúe con el formulario.
El resultado aceptado es un borrador guardado cuyos campos coinciden con la fuente y cuyo identificador puede recuperarse. Hacer clic en Guardar es un evento intermedio. El flujo debe inspeccionar el registro o confirmación e informar de campos pendientes, sin rellenarlos con conjeturas plausibles.
Incluya documentos normales y dificultades deliberadas: moneda confusa, identificador de proveedor ausente o número de factura duplicado. Revelan fallos distintos. Leer correctamente, elegir la cuenta y evitar duplicados son partes separadas del trabajo.
Mantenga la prueba lo bastante pequeña para revisar cada resultado. Ante un fallo, encuentre la primera observación o acción incorrecta en lugar de reescribir todas las instrucciones. Un diagnóstico acotado distingue interpretación documental, navegación, datos de cuenta y aceptación.
Es un ejemplo de diseño de aplicación. No afirma que Terra incluya un conector contable ni que aquí se probara un producto concreto. El modelo es un componente de un flujo al que hay que aportar herramientas y reglas de negocio.
La correspondencia de catálogo prueba el juicio visual antes de actuar
El segundo escenario asocia una foto de producto con una ficha existente. La ficha de OpenAI consultada el 27 de octubre cita expresamente ese uso. Para un comercio, lo útil sería una coincidencia propuesta con información suficiente para distinguir parecido visual y artículo correcto.
Prepare un conjunto pequeño con coincidencias fáciles, envases similares y fotos con detalles ausentes. Mantenga los identificadores esperados fuera de las instrucciones. Pida un identificador propuesto y los rasgos visibles que lo apoyan, con opción explícita de no resolver si la imagen no basta.
No resolver puede ser la respuesta correcta. Si dos envases solo difieren en información invisible, hace falta otra foto o un identificador no visual. Una descripción fluida no crea evidencia que faltaba en la entrada.
Empiece por propuestas antes de permitir editar el catálogo. Así la aceptación es más fácil de inspeccionar y los errores se entienden mejor. Si después se añade redacción, compruebe que la descripción conserva hechos verificados sin importar detalles no confirmados de una similitud visual.
Un portal antiguo convierte la recuperación en parte de la tarea
El tercer escenario prepara una actualización en borrador dentro de un portal interno con interfaz web. Puede consistir en localizar un registro, cambiar una descripción suministrada y dejarlo listo para aprobación humana. El beneficio es conectar una petición de negocio comprensible con acciones de interfaz.
Los casos difíciles suelen depender del estado. Una sesión caduca, aparece un campo obligatorio tras una selección o la página tarda más en actualizarse. Una evaluación útil registra cómo responde el flujo, sin contar solo el camino fácil.
Defina un presupuesto de recuperación antes de probar. Por ejemplo, permita observar una vez más tras un guardado incierto y deténgase para revisión si sigue sin quedar claro. Es una política ilustrativa, no un límite de Terra. Establece un comportamiento acotado y evita que un bucle improductivo consuma recursos.
Distinga también fallo de integración y fallo del modelo. Una herramienta sin acceso a la página, una cuenta sin permiso de edición y un modelo que elige mal requieren soluciones diferentes. Separarlos hace más útiles las estimaciones y mejoras.
La disponibilidad indica por dónde empezar, no qué puede operar cada cuenta
El anuncio del 26 de octubre presenta Terra en ChatGPT Work y Codex para Plus, Pro, Enterprise y Edu, además del identificador API gpt-6.1-terra. Son vías de acceso al modelo. Herramientas y permisos del flujo siguen dependiendo de producto, cuenta e integración.
Para desarrolladores, la ficha consultada el 27 de octubre especifica Responses API para llamadas a herramientas y esfuerzo de razonamiento predeterminado medium. Registre modelo y configuración para comparar pruebas. Cambiar a la vez modelo, instrucciones y entorno dificulta interpretar diferencias.
En Work o Codex, empiece con un flujo ya admitido y examine sus controles reales. En una aplicación propia, use la documentación actual para configurar ejecución y acciones permitidas. El identificador no crea por sí solo una conexión autenticada con aplicaciones de la empresa.
Compare configuraciones sobre las mismas tareas aceptadas
Una primera prueba útil es pequeña para inspeccionarla y variada para cubrir condiciones reales. Elija la regla de aceptación antes de ver resultados. El siguiente procedimiento es una propuesta de evaluación, no un benchmark.
- Elija un trabajo limitado. Nombre la salida y quién decide aceptarla. Prefiera al principio un borrador o entorno de prueba.
- Prepare casos fijos. Incluya entradas normales, datos ausentes e interrupciones pertinentes. Deje las respuestas esperadas fuera de las instrucciones.
- Registre la configuración. Guarde modelo, razonamiento, instrucciones, versión de herramientas y permisos relevantes.
- Defina parada y recuperación. Especifique cuándo observar de nuevo, reintentar o pedir que una persona resuelva la incertidumbre.
- Capture resultados observables. Registre aceptaciones, errores, casos sin resolver, intentos, duración y uso facturado. El estado de la herramienta es solo una parte.
- Añada costes reales de operación. Incluya cargos de herramientas y entorno, y tiempo de revisión medido. Divida por trabajos aceptados con definiciones consistentes.
- Cambie una variable significativa. Compare otra instrucción o razonamiento con los mismos casos e inspeccione qué fallos cambiaron antes de ampliar.
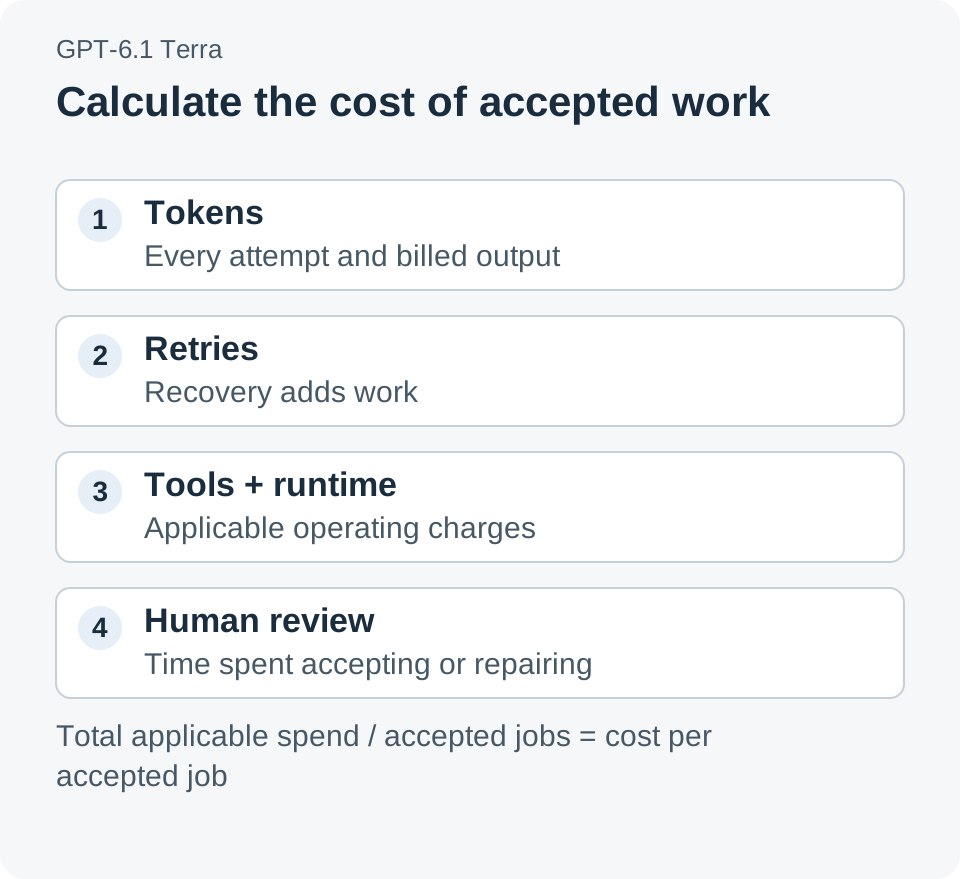
Modelo de coste propuesto: sumar recursos realmente consumidos y dividir entre trabajos aceptados. Es un marco de evaluación, no mediciones operativas publicadas de Terra.
El registro sirve incluso si la primera prueba decepciona. Indica si mejorar interpretación visual, diseño del flujo, fiabilidad de herramientas o reparación humana. Es una base mejor para elegir la siguiente automatización que el coste medio por solicitud.
Un ordenador más barato importa cuando terminar resulta asequible
Los menores precios estándar de Terra permiten probar con más cuidado y cubrir más trabajo dentro del presupuesto. La pregunta empresarial es si una integración puede convertir esa oportunidad en resultados aceptados con revisión y recuperación manejables.
Un modelo que lee una pantalla y elige un clic es útil. Un flujo que muestra lo cambiado, reconoce cuándo termina y contabiliza el esfuerzo necesario es algo que el equipo puede evaluar y mejorar.
Fuentes
- Presentación de GPT-6.1 Terra, OpenAI, 26 de octubre de 2026: posicionamiento, tarifas estándar y acceso.
- Ficha de sistema GPT-6.1 Terra, OpenAI, 26 de octubre de 2026: contexto fechado de lanzamiento y evaluación.
- Ficha del modelo GPT-6.1 Terra, consultada el 27 de octubre de 2026: identificador, endpoint de herramientas, razonamiento y facturación.
- Documentación de integración de uso del ordenador, consultada el 27 de octubre de 2026: actividad del navegador, capturas y mecanismos.
Los tres escenarios, los datos de costes y el procedimiento son ilustrativos. Los cálculos en dólares usan tarifas indicadas y supuestos explícitos; no son mediciones de latencia, precisión ni costes operativos.
Recomendación de Telli.sh: Mantenga accesibles notas de pruebas, referencias y decisiones detrás de cada revisión del flujo. Cree una cuenta de Telli.sh para organizar sus notas de evaluación.