GPT arrive sur Google Cloud : le canal d'achat entre dans le choix du modèle
La préversion privée des modèles OpenAI sur Google Cloud relie choix du modèle, achats et gouvernance. Voici ce qui change, ce qui reste annoncé et comment évaluer cette nouvelle voie sans confondre accès et maturité.
Marque officielle Google Cloud issue des ressources Press Corner, redimensionnée proportionnellement avec un fond neutre à des fins d'identification éditoriale. Google Cloud est une marque de Google LLC. Cet article indépendant n'est ni soutenu par Google ni affilié à l'entreprise. L'image identifie la plateforme ; ce n'est pas une capture de la préversion.
Un développeur peut préférer un modèle bien avant que son entreprise puisse l'acheter ou l'exploiter. Le travail manquant concerne souvent un contrat approuvé, un responsable budgétaire, une décision sur les données et un circuit de support. Une meilleure réponse à un prompt de test ne franchit pas automatiquement ces portes.
Le 21 octobre 2026, Google Cloud a annoncé des modèles OpenAI dans son catalogue de modèles, avec un déploiement en préversion privée auprès de certains clients d'entreprise. Les modèles cités sont GPT-6 Astra, GPT-6.1 Sol et GPT-6 Luna. Google décrit des achats via Marketplace, une facture cloud unique et la possibilité de consommer des engagements cloud existants. Annonce Google Cloud.
Notre point de vue : ce lancement modifie le trajet entre un modèle et une application d'entreprise opérationnelle. Il offre une option d'achat à évaluer en plus de la qualité du modèle. La question utile est de savoir si ce trajet facilite l'achat, la gouvernance et l'amélioration d'une tâche précise, sans perdre de vue les limites de la préversion.
Model Garden propose un catalogue et plusieurs modes d'exploitation
Google Cloud fournit l'infrastructure et les services gérés utilisés pour construire et exploiter des applications. Model Garden permet de découvrir les modèles et leurs voies de déploiement. La documentation distingue les services gérés des modèles déployés par le client. Un catalogue commun ne signifie donc pas une infrastructure, des contrats ou des responsabilités identiques pour chaque entrée. Présentation de Model Garden, consultée le 23 octobre.
Ce contexte aide les lecteurs peu familiers des plateformes IA d'entreprise. Le modèle est le système qui produit la réponse ; la plateforme participe à son acquisition, à son contrôle et à son exploitation. Changer de canal d'achat peut modifier la personne qui valide la dépense et le lieu où l'administrateur examine l'activité. Cela ne change pas en soi ce que sait le modèle ni la fiabilité de son travail.
L'annonce compte donc davantage que l'ajout d'un nom connu à un catalogue. Les organisations adoptent rarement un modèle isolément. Elles le relient à des documents, des outils, des personnes et des processus existants. Le parcours à travers ces connexions représente parfois une grande partie de l'effort nécessaire pour transformer un simple appel API en usage quotidien.
Le lancement distingue accès actuel et feuille de route
Le communiqué du 21 octobre décrit l'accès API et la connexion des processus locaux Codex CLI et Desktop pour l'inférence chez les participants. Les options Zero Data Retention et Confidential Compute sont annoncées pour plus tard, ainsi que les intégrations dans Gemini for business et Google Antigravity. La préversion privée est l'état actuel du déploiement ; les fonctions futures doivent être évaluées séparément. Disponibilité et feuille de route.
Pour un client potentiel, la prochaine étape consiste à manifester son intérêt via le formulaire de l'annonce et à confirmer son admissibilité avec son interlocuteur commercial. Un lancement public aide à planifier, mais une décision de production exige les conditions d'accès, fonctions, clauses et limites réellement proposées au compte. Ces informations doivent rester rattachées à l'évaluation après une démonstration réussie.
L'équipe peut se préparer utilement avant d'obtenir l'accès. Elle peut choisir une tâche, définir les réponses acceptables et déterminer les données autorisées pour le pilote. Cette préparation ne suppose pas qu'une future protection des données existe déjà. Elle donne aussi un objectif plus clair que tester tous les modèles et retenir la réponse la plus impressionnante.
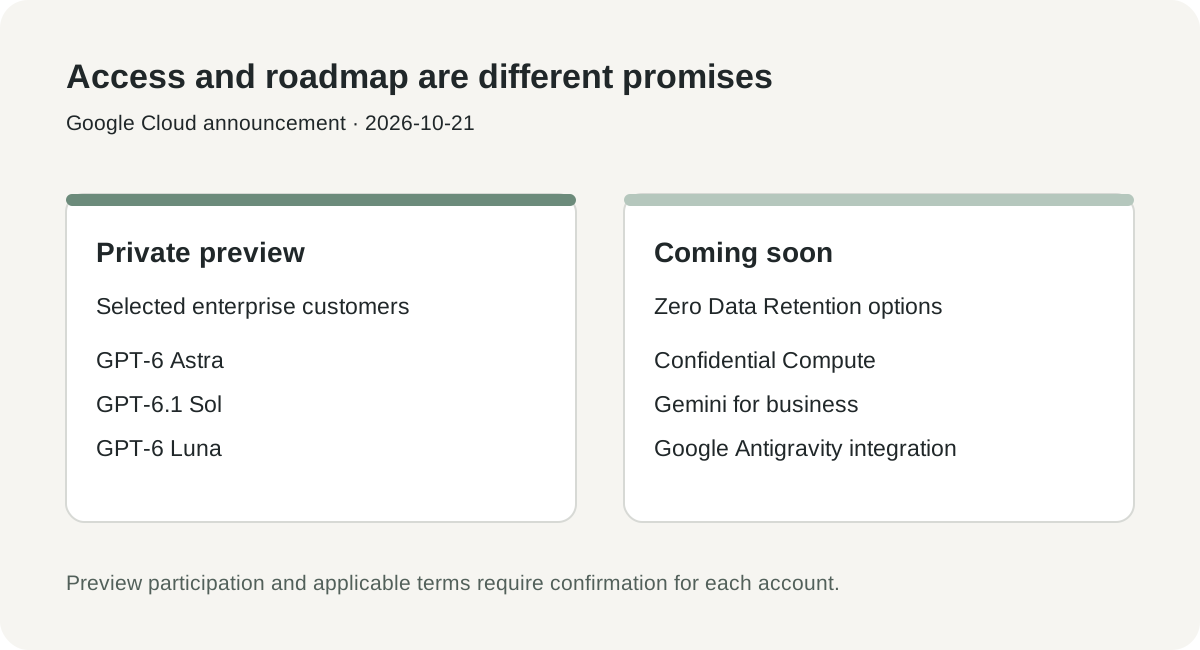
Infographie originale fondée sur l'annonce du 21 octobre. La participation et les clauses doivent être confirmées pour chaque compte ; aucune date de sortie n'est suggérée pour les éléments annoncés.
Une facture unique simplifie la gestion sans trancher le coût
La documentation de Google Cloud Marketplace explique que les frais produit apparaissent comme lignes distinctes dans les rapports et exports de facturation. Elle distingue également ces frais des ressources cloud utilisées. C'est un contexte utile pour un budget applicatif : regrouper une facture ne supprime pas le besoin d'en comprendre les composants. Documentation de facturation Marketplace, consultée le 23 octobre.
Une entreprise devrait comparer le coût complet de son processus. Les requêtes au modèle n'en sont qu'un poste. Recherche documentaire, stockage, nouvelles tentatives, outils et vérification humaine peuvent aussi compter. Un coût inférieur par génération perd son intérêt si davantage de résultats nécessitent une correction avant d'être utiles.
Les engagements cloud ajoutent un autre critère. Dépenser dans le cadre d'un accord existant peut mieux correspondre au budget qu'ouvrir une relation avec un fournisseur supplémentaire. C'est un véritable avantage opérationnel possible, même si l'économie au niveau de l'application ne change pas. La finance doit déterminer l'accord admissible ; l'ingénierie, le travail utile obtenu pour cette dépense.
Imaginons un assistant interne fictif traitant 1 000 requêtes pendant un pilote. Un modèle en termine davantage de façon satisfaisante dès la première tentative, tandis qu'un autre exige recherches répétées et retouches manuelles. La comparaison pertinente est le coût par tâche acceptée, avec les conséquences des échecs. Cet exemple définit une méthode de mesure, sans prédire le résultat d'un modèle cité.
Séparez capacité, achats et gouvernance
Une évaluation utile comporte trois colonnes. La première demande si le modèle accomplit le travail. La deuxième vérifie si l'organisation peut acheter et soutenir ce parcours. La troisième examine le traitement des données et les actions permises. Fusionner ces aspects en un seul score peut masquer pourquoi un pilote prometteur reste inadapté à la production.
| Décision | Question utile | Preuves à conserver |
|---|---|---|
| Capacité | Accomplit-il le travail avec une précision suffisante ? | Entrées représentatives, sorties acceptées et échecs |
| Achats | Le compte peut-il acheter et budgéter l'offre ? | Offre applicable, dépenses admissibles, quotas et support |
| Gouvernance | Les contrôles réels des données et actions conviennent-ils ? | Clauses du compte, configuration et comportement observé |
Ces colonnes aident aussi à se contredire utilement. Un développeur montre une meilleure réponse pendant que la sécurité identifie un contrôle manquant. La finance trouve un contrat pratique pendant que l'exploitation découvre un support insuffisant. Tous ces constats peuvent être vrais en même temps. L'objectif est une décision expliquant les compromis, plutôt qu'un débat sur l'équipe qui comprend le mieux l'IA.
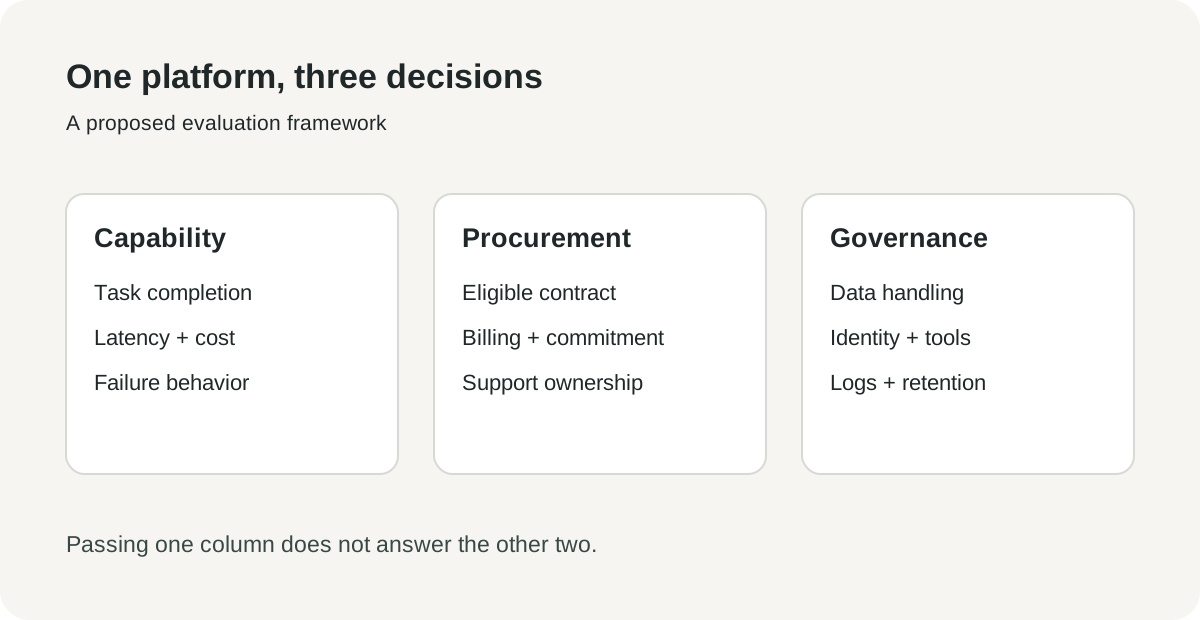
Cadre éditorial original. Ce sont des critères d'achat proposés, pas une affirmation qu'une plateforme fournit tous ces contrôles pour chaque modèle.
Un assistant documentaire interne offre une première comparaison utile
Prenons un assistant fictif répondant à partir de la documentation produit approuvée d'une entreprise. La tâche paraît simple jusqu'à ce que les documents divergent, qu'une réponse dépende d'une date ou que l'utilisateur n'ait pas accès à une source. La comparaison doit inclure ces cas difficiles. La meilleure réponse sur un document propre n'est qu'une partie du travail.
L'équipe peut constituer un petit jeu de questions vérifiées avec les passages justificatifs attendus. Elle évalue la bonne version, la citation pertinente et la reconnaissance d'informations absentes. Gardez la recherche documentaire constante pendant la comparaison pour mesurer une différence réelle entre modèles plutôt qu'un changement de documents fournis. Mesurez aussi la vérification nécessaire avant de remettre la réponse à un collègue.
La frontière d'accès exige son propre contrôle. Un assistant ne devrait pas répondre depuis un document simplement parce que l'application peut le récupérer quelque part. L'utilisateur doit également avoir les droits. C'est une exigence applicative proposée, nécessaire quels que soient les noms du modèle ou de la facture. Un achat plus simple ne compense pas un système documentaire mal connecté.
Un pilote de programmation doit mesurer un changement terminé
Un deuxième usage est l'assistant de programmation interne. L'équipe dispose parfois déjà d'un environnement approuvé et d'un processus de revue des correctifs. Cela fournit des résultats observables : modification proposée, tests pertinents, décision du relecteur et corrections nécessaires. L'unité utile est le changement accepté, plutôt que la quantité de code généré.
Choisissez quelques tâches circonscrites proches de la maintenance réelle. Par exemple : corriger une validation d'entrée, adapter une petite intégration de dépendance et ajouter un test de non-régression manquant. Gardez l'état initial du dépôt et les instructions constants. Notez si l'assistant comprend le code, préserve les contrats et explique son résultat de manière vérifiable.
L'accès aux outils doit être volontaire. Lire les sources, exécuter un test et publier une version ont des conséquences très différentes. Un pilote peut démarrer dans un environnement jetable avec des actions limitées, puis s'élargir après compréhension du comportement. Le fournisseur d'inférence n'est qu'un composant ; l'outil de programmation et ses permissions déterminent ce que l'assistant peut réellement modifier.
Cette méthode évite aussi une comparaison trompeuse de vitesse. Générer du texte plus vite aide peu si le relecteur doit corriger longtemps une mauvaise approche. Un modèle plus lent par requête peut finir le travail plus tôt. Le pilote doit donc conserver le temps des appels et celui nécessaire pour obtenir un résultat accepté.
Le support répétitif révèle le coût des exceptions
Un troisième cas fictif est la rédaction de réponses de support à partir d'une base approuvée. La majorité des demandes est courante, mais certaines concernent remboursements, accès au compte ou incident non résolu. Rédiger correctement les réponses ordinaires est utile. Mal gérer une exception peut créer un travail disproportionné.
Séparez rédaction et action pendant le pilote. Le relecteur doit voir la source, la réponse proposée et les informations manquantes avant tout envoi ou modification de compte. Incluez des cas où transmettre à une personne est la bonne issue. L'évaluation vérifie alors si l'assistant reconnaît les limites des preuves sans le pénaliser simplement pour avoir remonté un cas difficile.
La valeur de la plateforme serait ici l'exploitation plus simple d'un processus circonscrit, plutôt qu'une promesse abstraite de support entièrement autonome. Un déploiement utile réduit les tâches répétitives et clarifie le traitement des exceptions. Ce résultat exige que conception applicative et comportement réel du modèle fonctionnent ensemble.
Entraînement, conservation et permissions répondent à des questions différentes
La documentation actuelle de Google distingue l'interdiction d'utiliser les données pour l'entraînement de la conservation liée à certains services et fonctions. Elle décrit les actions et conditions nécessaires à une conservation nulle. Certaines fonctions avancées peuvent empêcher cette configuration. Cette documentation générale fournit un vocabulaire utile, mais les clauses de la préversion doivent être confirmées pour le compte. Documentation de gouvernance des données, consultée le 23 octobre.
Trois questions doivent rester séparées lors de l'achat. Les données peuvent-elles servir à l'entraînement ? Peuvent-elles être conservées, pourquoi et combien de temps ? Quels outils connectés peuvent lire ou modifier d'autres systèmes ? Une bonne réponse à l'une ne répond pas aux autres. C'est particulièrement important lorsqu'une présentation mélange modèle, recherche, journalisation et actions d'agent.
Les journaux applicatifs méritent aussi l'attention. Un processus peut conserver des données sensibles dans ses propres systèmes de débogage ou de surveillance même lorsque l'inférence est restrictive. Examinez tout le trajet entre saisie et résultat stocké, y compris exports et vérification humaine. Un schéma de ce trajet est souvent plus utile qu'une assurance générale d'adoption de l'IA d'entreprise.
Davantage de modèles peut réduire une dépendance et en renforcer une autre
Un catalogue facilitant l'évaluation de plusieurs fournisseurs peut améliorer les possibilités techniques et de négociation. Il devient plus facile de demander quel modèle convient au travail plutôt que considérer la première intégration comme permanente. C'est une direction utile pour qui veut réévaluer qualité, latence et coût au fil des évolutions.
La portabilité demande toujours une conception explicite. Prompts, descriptions d'outils, structures de sortie et hypothèses d'exploitation peuvent dépendre de la pile applicative. Un modèle choisi sur une plateforme commune peut se comporter différemment après changement du point d'accès ou des services environnants. Le véritable test est une migration reproductible préservant le jeu d'évaluation et les comportements attendus.
Il existe aussi un compromis de concentration. Regrouper dépenses et contrôles IA dans un cloud simplifie l'administration quotidienne. Cela peut augmenter les conséquences d'un problème de quota, de politique ou de disponibilité de plateforme. L'équipe doit décider des dépendances acceptées, des alternatives conservées et de la détection d'un résultat sensiblement différent après bascule.
Une préversion est plus utile avec des critères de sortie définis avant
La documentation d'évaluation de Google décrit l'évaluation des sorties génératives par métriques et grilles. Un outil organise le travail, mais l'organisation doit encore décider ce qu'est une réponse utile. Une grille claire rend les résultats plus discutables qu'un ensemble informel de réponses impressionnantes. Présentation du service d'évaluation, consultée le 23 octobre.
Les étapes d'un pilote peuvent rester concrètes :
- Confirmez l'accès à la préversion, les identifiants de modèles, fonctions, régions, quotas et clauses commerciales avec votre interlocuteur.
- Choisissez une tâche et un jeu de données autorisé. Définissez acceptation, escalade et actions interdites avant de connecter des systèmes réels.
- Établissez une référence avec le processus actuel. Conservez réussites et échecs représentatifs, pas uniquement les exemples difficiles.
- Comparez les candidats avec les mêmes entrées et permissions. Mesurez résultats acceptés, vérification, latence totale et coût complet.
- Examinez journalisation, traitement des données et comportement en échec. Documentez tout contrôle dépendant d'une fonction future au lieu de le considérer comme acquis.
- Décidez d'étendre, réviser ou arrêter le pilote. Gardez les preuves pour comparer ultérieurement un modèle ou une offre commerciale sur la même tâche.
L'unité utile du choix est une tâche qui fonctionne
L'arrivée des modèles OpenAI sur Google Cloud rend le choix d'entreprise plus concret. Elle relie une option technique à un lieu où l'organisation achète et exploite déjà éventuellement des logiciels. Cette connexion peut réduire les frictions si l'acheteur distingue accès en préversion, contrôles présents et ajouts promis.
Le meilleur résultat serait une équipe capable de changer de modèle sans perdre sa compréhension du processus. L'avantage durable est de pouvoir expliquer pourquoi une tâche est assez précise, abordable et contrôlée pour être exécutée. Un catalogue plus large vaut quelque chose lorsqu'il aide à produire cette réponse.
Sources
- Google Cloud apporte les modèles OpenAI à ses clients, 21 octobre 2026.
- Model Garden, facturation Marketplace, gouvernance des données et évaluation Gen AI, consultés le 23 octobre 2026.
- Ressources Google Cloud Press Corner et règles de marque pour les livres et médias, consultées le 23 octobre 2026.
Gardez l'évaluation et la décision ensemble
Pour les lecteurs qui souhaitent un espace distinct pour leurs sources, résultats de pilote et décisions vérifiées, Telli.sh est une possibilité. Ouvrir votre espace de notes.