Czy można zatrzymać notebook z GPU i wrócić do tego samego eksperymentu?
Samodzielnie hostowane GKE Workspaces łączy trwałe pliki, wznawianie sesji na akceleratorach i środowisko programistyczne w przeglądarce. Każda warstwa wiąże się z innym kosztem.
Jest 18.00. Notebook wreszcie wczytał model i wygenerował wyniki warte sprawdzenia. Jeśli zatrzymasz sesję, jutro możesz spędzić część dnia na odtworzeniu środowiska i ponownym wczytaniu modelu. Jeśli zostawisz ją uruchomioną, trudno dostępny akcelerator może przez noc stać bezczynnie.
4 listopada Google zapowiedziało GKE Workspaces. To otwarte środowisko programistyczne działa w klastrze Google Kubernetes Engine zespołu. Z panelu w przeglądarce można uruchomić JupyterLab lub VS Code z określonymi zasobami. Projekt opiera się na Kubeflow Workspaces i opisuje wstrzymywanie oraz wznawianie obsługiwanych sesji. Zespół musi ustalić, jakiego stanu będzie potrzebować jutro i co trzeba pozostawić przydzielone, aby go zachować.
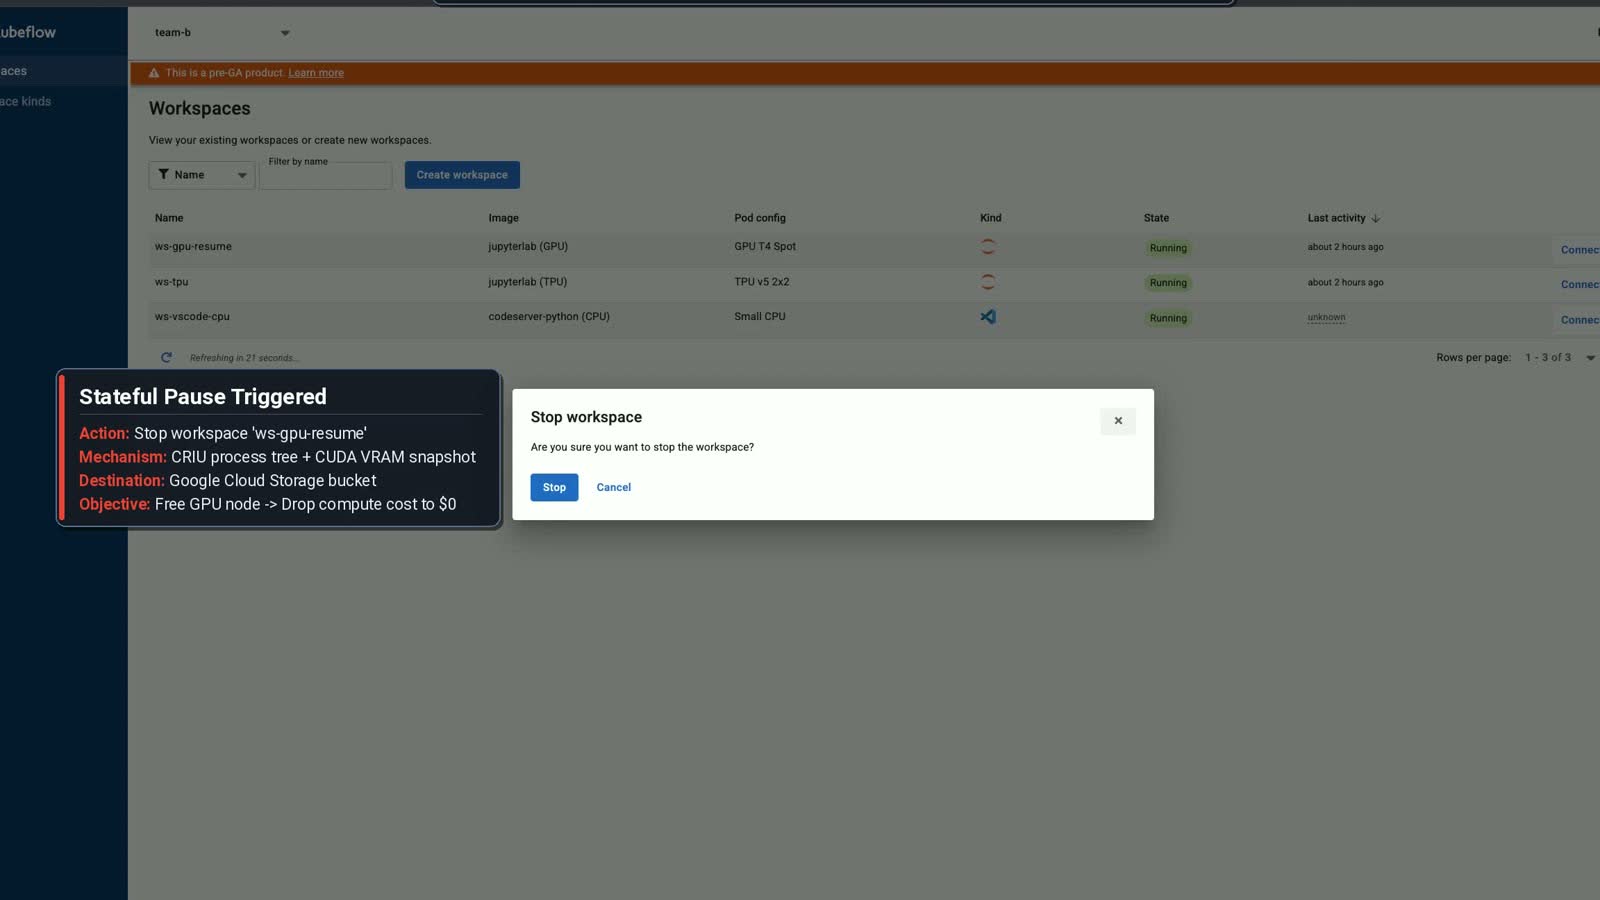
Wykadrowana klatka z demonstracji wznawiania notebooka GKE Workspaces, Apache 2.0. Źródło obrazu · Licencja.
Plik notebooka i uruchomiona sesja zachowują inne rzeczy
Wstrzymywanie notebooka z GPU. Autorska ilustracja Telli.sh.
Zapis notebooka zachowuje zapisane komórki i wyniki. Dysk może udostępnić zbiory danych i punkty kontrolne nowemu procesowi. Żaden z tych mechanizmów nie zachowuje automatycznie wszystkiego, co należy do działającej sesji. Eksperyment może mieć zainicjowane zmienne, model w pamięci akceleratora i stan pośredni, którego odtworzenie zajmie czas.
Google opisuje użycie GKE Pod Snapshots do zachowania obsługiwanego stanu działającego obszaru roboczego przy zwalnianiu zasobów obliczeniowych. Pliki obszaru pozostają w trwałej pamięci masowej. Przy wznowieniu potrzebne są zgodne zasoby i dostępna migawka. Wstrzymanie przypomina więc kontynuowanie eksperymentu, a nie samo otwarcie pliku. W praktyce zależy to od konfiguracji środowiska.
| Warstwa | Przykład | Pytanie do planu |
|---|---|---|
| Trwałe pliki | Notebook, wagi w pamięci podręcznej, wyniki i zależności | Czy pliki przetrwają czysty restart? |
| Punkt kontrolny aplikacji | Punkt kontrolny treningu lub zapisany stan zadania | Czy zadanie wznowi się bez starego procesu? |
| Migawka obszaru roboczego | Działający proces lub obsługiwany stan akceleratora | Czy sprzęt i środowisko pozwalają go odtworzyć? |
| Pojemność klastra | Węzeł, limit akceleratorów lub rezerwacja | Czy zasoby zostaną zwolnione i będą dostępne później? |
Odtwarzalność i wygoda pomagają w różnych częściach procesu. Migawka przydaje się osobie, która chce niedługo wrócić do sesji. Odtwarzalny notebook i punkt kontrolny aplikacji ułatwiają komuś innemu powtórzenie pracy lub przeniesienie jej do innego środowiska. Przy ważnym eksperymencie zachowaj oba sposoby.
Zespół badawczy może wstrzymać sesję GPU na czas spotkań, a jednocześnie zatwierdzić kod w repozytorium i zapisać artefakty modelu w trwałej lokalizacji. Gdy przywrócenie migawki się nie uda, istnieje konkretne rozwiązanie. Długi trening może podobnie zapisywać punkty kontrolne według harmonogramu, nawet jeśli obszar, z którego go uruchomiono, obsługuje wstrzymanie.
Zatrzymany obszar roboczy nadal kosztuje
Rzeczywisty rachunek. Autorska ilustracja Telli.sh.
Bezpośrednia korzyść polega na tym, że zasoby obliczeniowe nie muszą być zajęte, gdy nikt nie pracuje. Rachunek zależy od zachowania klastra po zatrzymaniu sesji. Węzeł może nadal działać, ponieważ korzystają z niego inne pody. Rezerwacja nadal może oznaczać opłatę lub zobowiązanie. Dyski trwałe i przechowywane migawki również pozostają częścią systemu.
Weźmy przykład hipotetyczny. Jeżeli po pracy badacz pozostawia przydzielony, bezczynny akcelerator na 12 godzin, wstrzymanie daje platformie szansę odzyskać te 12 godzin dostępności akceleratora. To możliwość odzyskania zasobów. Wynik finansowy zależy od sposobu przydzielania i rozliczania węzła oraz akceleratora. Jeśli węzeł musi działać dla innego zadania, większa korzyść może dotyczyć planowania pracy niż bieżącej faktury.
Uczciwe porównanie obejmuje też czas. Zapis migawki zużywa zasoby, odtwarzanie dużego stanu trwa, a właściwy akcelerator może nie być dostępny od razu. W obciążonym klastrze możliwość przekazania urządzenia innej osobie ma znaczenie także wtedy, gdy zespół już zarezerwował pulę zasobów.
Zapisz koniec aktywnej pracy, czas zatrzymania obszaru i moment, gdy węzeł ponownie staje się dostępny. Potem zmierz, kiedy użytkownik wznawiający pracę może wykonać następną komórkę. Te punkty pokażą zespołowi platformowemu, czy zasady wstrzymania oddają przydatne zasoby i czy rozpoczęcie kolejnego dnia nie oznacza kolejki.
Zespół platformowy nadal odpowiada za zasady pracy
Samoobsługa zmienia osobę klikającą przycisk. Administratorzy nadal określają, które obrazy można uruchamiać, o jakie akceleratory wolno wnioskować i jak klaster zarządza limitami i izolacją. Repozytorium GKE Workspaces udostępnia kod na licencji Apache 2.0 i informuje, że nie jest to oficjalnie wspierany produkt Google. Oceniając rozwiązanie dla zespołu, uwzględnij odpowiedzialność inżynierską za jego instalację i utrzymanie.
Inżynier ML może potrzebować znanego IDE, wystarczającej pamięci i dostępu do zbioru danych. Właściciel platformy bierze pod uwagę także domyślne tożsamości, uprawnienia do pamięci masowej, zatrzymywanie zadań i aktualizowanie obrazów. Da się pogodzić te potrzeby, jeśli typy obszarów roboczych ujawniają warunki ich użycia. Mały notebook na CPU i sesja eksperymentalna na GPU mogą mieć różne ustawienia domyślne.
Ogłoszenie opisuje też wybór akceleratorów oraz połączenia dla lokalnych narzędzi i agentów. Przed uznaniem tych opcji za zamienne sprawdź instrukcję dla swojego klastra i zadania. Przywracanie związane z konkretnym sprzętem, dostęp między klastrami i połączenie z lokalnym środowiskiem programistycznym mają osobne wymagania. Zacznij od prostego przypadku, w którym członek zespołu może obejrzeć obszar i potwierdzić, który klaster go obsługuje.
Wykonaj jedną próbę wstrzymania i odzyskania
- Przeczytaj instrukcję wdrożenia projektu i bieżące wymagania środowiska GKE dotyczące migawek i akceleratorów. Utwórz testowy obszar z uprawnieniami i limitami odpowiadającymi planowanemu procesowi.
- Uruchom odtwarzalny notebook. Zapisz dane wejściowe, pośredni punkt kontrolny aplikacji i mały plik wynikowy. Przed wstrzymaniem zapisz czas oraz przydział zasobów.
- Wstrzymaj obszar i sprawdź stan zasobów klastra. Ustal, czy pod się zatrzymał, czy można zaplanować nowe zadanie na akceleratorze i co nadal znajduje się w pamięci masowej.
- Wznów obszar. Sprawdź oczekiwane pliki i stan działającej sesji, a potem uruchom jedną komórkę korzystającą z załadowanego modelu. Zmierz czas od żądania wznowienia do chwili, gdy da się pracować.
- Powtórz odzyskiwanie z zapisanych plików i punktu kontrolnego aplikacji. To rozwiązanie zastępcze i punkt porównania, jeśli przywracanie migawki jest wolne lub niedostępne.
- Omów z zespołem ustawienia bezczynności. Zdecyduj, co liczy się jako brak aktywności i czy długie zadania wymagają osobnego typu obszaru lub wyraźnej obsługi.
Przetestuj przywracanie także przy limicie zasobów albo zajętym klastrze. Pokaz na pustym klastrze może nie ujawnić trudności ze zdobyciem zasobów, gdy kilku użytkowników wraca jednocześnie. Próba ma pokazać zachowanie systemu wtedy, gdy dostępność jest ograniczona.
Policz, dokąd trafiają godziny GPU
Wyobraź sobie pojedynczą stację roboczą używaną przez 40 godzin tygodniowo. Maszyna przydzielona przez cały tydzień pozostaje zajęta przez 168 godzin. Jeśli platforma zwalnia węzeł GPU po zakończeniu pracy i uruchamia go tylko na te 40 godzin, daje to 128 godzin mniej przydziału, przed uwzględnieniem zapisu i odtwarzania migawek. To przykład, bez założeń dotyczących ceny chmury ani wykorzystania zasobów. Dla takiego trybu przydziału wyznacza górną granicę, bo współdzielony węzeł może w tym czasie wykonywać inną pracę.
Zespół może urealnić porównanie danymi z własnej puli GPU. W każdym okresie testowym zapisuj czas pracy węzła, zajęcie go przez inne zadania oraz ilość przechowywanych danych. Zanotuj też czas od żądania wznowienia do uruchomienia następnej komórki. Jeśli węzeł zostaje przez inne obciążenie, wstrzymany notebook może zwolnić dla niego miejsce bez obniżenia rachunku. To odrębna, nadal przydatna korzyść.
Czas tworzenia migawki należy do rachunku. Jeżeli wstrzymywanie trwa długo, gdy stary pod nadal zajmuje zasoby, krótki próg bezczynności może zwiększyć liczbę przerw bez znacznych oszczędności. Jeśli wznowienie zajmuje kilka minut, zanim mechanizm skalowania pozyska zgodne GPU, osoba wracająca po krótkiej przerwie może czekać dłużej, niż zyskuje. Zmierz kilka okresów bezczynności, zanim ustalisz próg.
Wybierz dane do zachowania przed włączeniem wstrzymania
Repozytorium GKE Workspaces opisuje bezstanową pracę w VS Code oraz osobny przykład stanowej sesji JupyterLab. Ten drugi pokazuje odtworzenie notebooka z GPU, między innymi dla modelu Qwen2.5 z 3 mld parametrów na jednej karcie T4. Migawki podów Kubernetes oraz przykład mają określone ograniczenia zgodności. Dokumentacja GKE wyjaśnia rolę GKE Sandbox i zgodnej konfiguracji węzła oraz obrazu. Dla wariantu GPU sprawdź, czy nowy węzeł ma ten sam obsługiwany model GPU i zgodne środowisko.
Ustal oczekiwania użytkowników wobec przycisku wstrzymania. Jedni chcą zachować pliki, wyniki i stan edytora. Inni oczekują, że kolejna komórka Pythona zobaczy obiekt w RAM albo model w VRAM. Współdzielony zbiór danych może znajdować się w zewnętrznej pamięci obiektowej poza migawką. Zapisz, które stany można odtworzyć, gdzie pozostają zwykłe pliki i co zrobić, jeśli przywracanie się nie powiedzie.
Druga przydatna próba to awaria przed wznowieniem. W testowej przestrzeni nazw tymczasowo ogranicz dostęp do zgodnych zasobów i sprawdź, czy obszar pokazuje czytelny stan bez uruchamiania konkurujących prób przywrócenia. Zobacz, czy właściciel może odzyskać pracę z plików lub zapisanych wyników, gdy procesu z pamięci nie da się wznowić. Potem usuń testową migawkę i sprawdź zachowanie pamięci masowej oraz zasad retencji.
Pokaż zespołowi pełny obraz kosztów
Badacz chce wznowić pracę. Zespół platformowy chce odzyskać trudno dostępne GPU dla wspólnej puli. Osoby odpowiedzialne za rachunki chcą wiedzieć, czy przydział faktycznie zniknął. Jedna próba może odpowiedzieć na wszystkie trzy pytania, jeśli oddzielnie rejestruje bezczynność, przydział węzłów, wielkość migawek, udane wznowienia i czas odzyskiwania. Przygotuj wskazówki na wypadek błędu i pokaż użytkownikom, czy obszar jest wstrzymany, czeka na zasoby, czy jest gotowy.
Na tej podstawie wybierz zasady bezczynności według rodzaju pracy. Długa sesja z modelem, który ładuje się powoli, może skorzystać z zachowania pamięci między zmianami. Krótki eksperyment uruchamiany ze skryptu może potrzebować tylko trwałych plików i czystego startu. Oba typy mogą korzystać ze wspólnej puli przy różnych czasach odzyskiwania.
Dodaj test wznowienia do listy kontroli wydania
Aktualizacja platformy może zmienić obraz uruchamiający obszar roboczy lub pulę węzłów udostępniających GPU. Przed wprowadzeniem zmiany utwórz notebook testowy na starej konfiguracji i zobacz, co dzieje się na nowej. Test powinien odróżnić udane odtworzenie od nowej sesji z otwartym tym samym plikiem. Odczytaj wartość istniejącą wyłącznie w działającym procesie testowym i potwierdź, że pliki używane przez proces nadal są dostępne.
Jeśli aktualizacja unieważnia stare migawki, daj użytkownikom czas na zapisanie ważnych wyników i wyjaśnij sposób odzyskania pracy. Osobno sprawdź czyszczenie wygasłych migawek. Test odtwarzania dowodzi, że konkretny obszar może wrócić. Test czyszczenia pokazuje, ile nieużywanych danych pozostaje, gdy ludzie kończą pracę.
Zachowaj to, co najtrudniej odtworzyć
Obszar roboczy staje się użyteczniejszy, gdy pozwala przestać myśleć o cyklu życia maszyny, a zarazem odzyskać pracę. Wymaga to rozdzielenia plików, punktów kontrolnych, migawek i zasobów. Wybierz najmniejszy zestaw stanu potrzebny do wygodnego wznowienia i upewnij się, że projekt da się nadal odtworzyć bez pierwotnej sesji.
Jeżeli zespół potrafi powiedzieć, co zostaje na dysku, co trzeba odtworzyć i kiedy zasoby wracają do puli, może ustalić zasady bezczynności, z których ludzie faktycznie będą korzystać.
Źródła
Jeśli chcesz przechowywać rozmowy i decyzje związane z pracą w formie, którą można przeszukiwać, załóż konto Telli.sh.