Puoi mettere in pausa un notebook con GPU e riprendere lo stesso esperimento?
GKE Workspaces, da installare nel proprio cluster, combina file persistenti, sessioni su acceleratore ripristinabili e un IDE nel browser. Ogni livello ha un costo diverso.
Sono le 18. Un notebook ha finalmente caricato il modello e prodotto risultati che vale la pena esaminare. Se arresti la sessione, domani potresti perdere tempo a ricostruire l’ambiente e ricaricare il modello. Se la lasci in esecuzione, un acceleratore scarso potrebbe restare inutilizzato tutta la notte.
Google ha annunciato GKE Workspaces il 4 novembre. L’ambiente di sviluppo open source gira nel cluster Google Kubernetes Engine del team, dove una dashboard nel browser può avviare JupyterLab o VS Code con risorse preconfigurate. Il progetto si basa su Kubeflow Workspaces e documenta come sospendere e riprendere le sessioni supportate. Al team spetta decidere quale stato gli servirà domani e che cosa deve restare allocato per conservarlo.
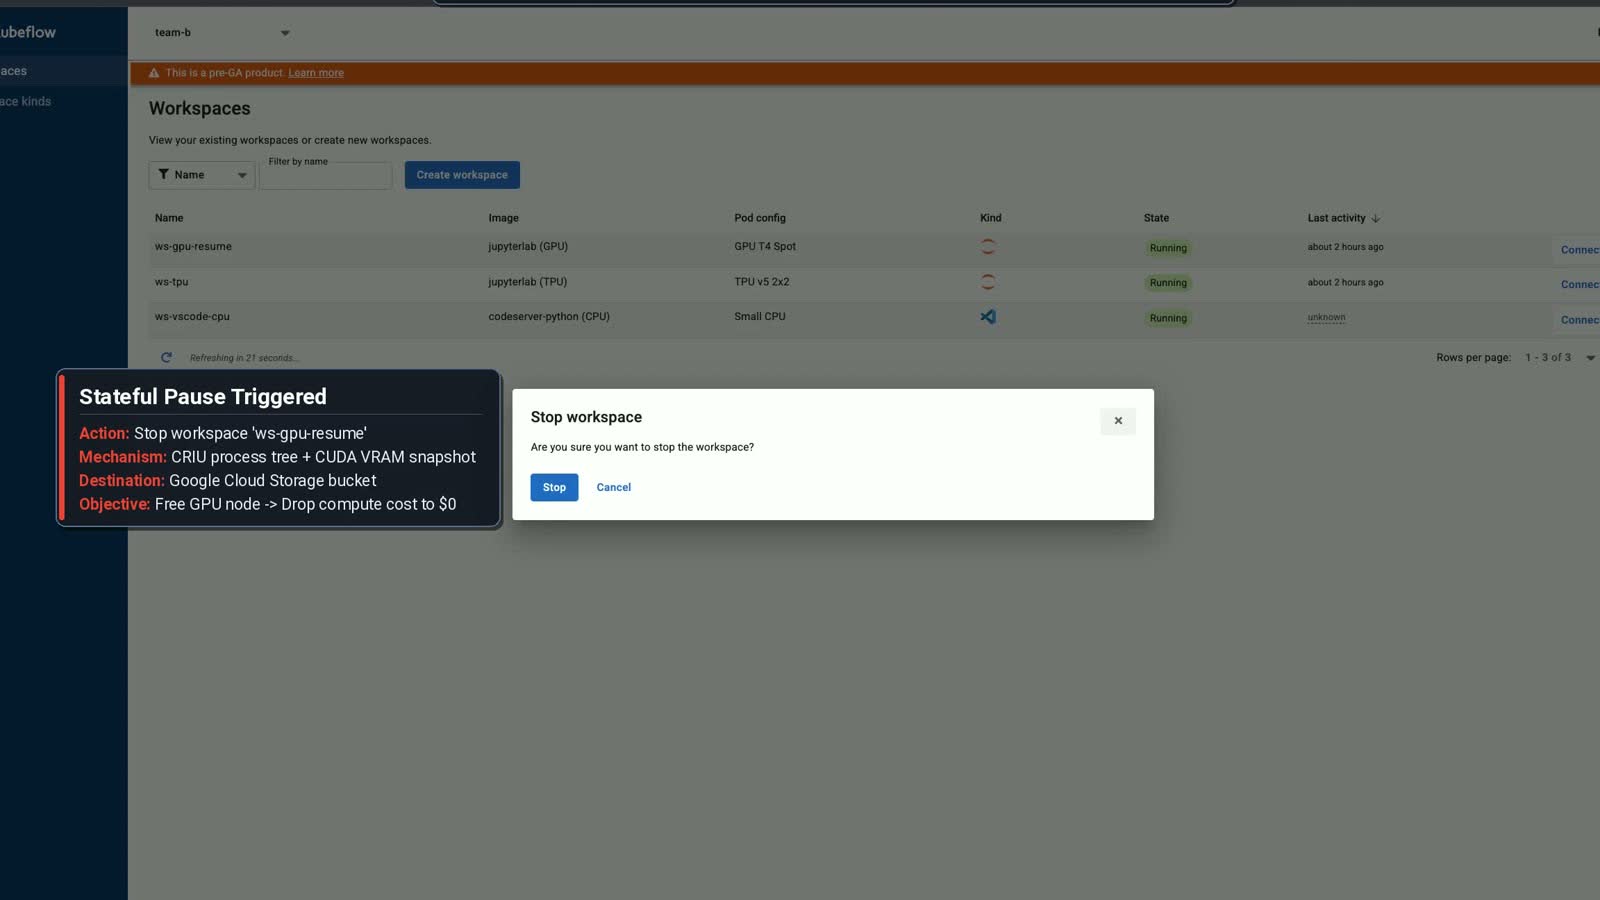
Fotogramma ritagliato dalla demo dei notebook ripristinabili di GKE Workspaces, Apache 2.0. Fonte dell’immagine · Licenza.
Un file di notebook e una sessione attiva conservano cose diverse
Sospensione di un notebook con GPU. Illustrazione originale di Telli.sh.
Salvare un notebook conserva le celle scritte e gli output che sono stati salvati. Su disco, dataset e checkpoint possono restare disponibili per un nuovo processo. Nessuno dei due meccanismi cattura automaticamente tutto ciò che esiste in una sessione attiva. Un esperimento può avere variabili inizializzate, un modello su un acceleratore e uno stato intermedio che richiederebbe tempo per essere ricreato.
Google descrive l’uso di GKE Pod Snapshots per preservare lo stato di esecuzione supportato mentre si rilasciano le risorse di calcolo. I file dell’ambiente rimangono sulla memoria persistente. Alla ripresa, devono essere disponibili sia lo snapshot sia una capacità compatibile. La sospensione si avvicina quindi alla ripresa di un esperimento, con i vincoli pratici dell’ambiente sottostante.
| Livello | Esempio | Domanda da porsi |
|---|---|---|
| File persistenti | Notebook, pesi nella cache, risultati e dipendenze | Questi file sopravvivono a un riavvio da zero? |
| Checkpoint applicativo | Un checkpoint di addestramento o lo stato salvato di un’esecuzione | Il lavoro può riprendere indipendentemente dal vecchio processo? |
| Snapshot dell’ambiente | Processo attivo o stato dell’acceleratore supportato | L’hardware e l’ambiente supportano il ripristino? |
| Capacità del cluster | Nodo, quota dell’acceleratore o prenotazione | Le risorse saranno davvero rilasciate e torneranno disponibili? |
Riproducibilità e praticità migliorano aspetti diversi del lavoro. Uno snapshot aiuta chi vuole riprendere presto una sessione. Un notebook riproducibile e un checkpoint applicativo facilitano la riesecuzione o lo spostamento in un altro ambiente da parte di altri. Conserva entrambi quando l’esperimento è importante.
Un gruppo di ricerca può sospendere una sessione GPU fra due riunioni, fare comunque il commit del codice e salvare gli artefatti del modello in una destinazione durevole. Se lo snapshot non si ripristina, il gruppo ha un’alternativa chiara. Analogamente, un lungo addestramento può salvare checkpoint a intervalli regolari anche se l’ambiente da cui è partito supporta la sospensione.
Anche un ambiente fermo ha un costo
Calcolo del costo effettivo. Illustrazione originale di Telli.sh.
Il vantaggio economico immediato è evitare l’uso di risorse di calcolo quando nessuno lavora. La fattura effettiva dipende da quello che fa il cluster quando si ferma la sessione. Un nodo può restare in esecuzione perché lo usano altri pod. Una prenotazione può continuare a comportare un costo o un impegno. Dischi persistenti e snapshot archiviati fanno ancora parte del sistema.
Parti da un esempio ipotetico. Se una ricercatrice lascia allocato per 12 ore dopo il lavoro un acceleratore altrimenti inattivo, la sospensione offre alla piattaforma la possibilità di liberare quelle 12 ore di acceleratore. È un’opportunità di capacità. Il risultato finanziario dipende da come il nodo e l’acceleratore sono assegnati e fatturati. Se il nodo deve restare online per un altro lavoro, il vantaggio può riguardare più la pianificazione che la fattura.
Un confronto equo considera anche il tempo. Salvare uno snapshot richiede risorse, ripristinare uno stato voluminoso richiede tempo e l’acceleratore desiderato potrebbe non essere disponibile subito. In un cluster molto usato, poter riassegnare il dispositivo conta anche quando il team si è già impegnato a pagare un insieme di risorse.
Registra la fine del lavoro attivo, l’ora di arresto dell’ambiente e il momento in cui il nodo torna disponibile. Poi misura quando l’utente che riprende può eseguire la cella successiva. Questi momenti indicano al team della piattaforma se la sospensione restituisce capacità significativa senza trasformare l’inizio della giornata successiva in un’attesa.
Il team della piattaforma rimane responsabile dell’ambiente
Il self-service cambia chi fa clic. Gli amministratori decidono ancora quali immagini possono essere avviate, quali acceleratori si possono richiedere e come il cluster gestisce quote e isolamento. Il repository di GKE Workspaces indica che il codice è distribuito con licenza Apache 2.0 e che il progetto non è un prodotto supportato ufficialmente da Google. Valuta l’installazione e il funzionamento come una responsabilità tecnica del team.
Chi si occupa di machine learning può avere bisogno di un IDE familiare, memoria sufficiente e accesso al dataset di un esperimento. Il responsabile della piattaforma deve pensare anche alle identità predefinite, ai permessi per lo storage, all’arresto dei carichi e alle immagini che possono ricevere aggiornamenti. Queste esigenze sono compatibili se i tipi di ambiente rendono visibili i compromessi. Un piccolo notebook CPU e una sessione sperimentale GPU possono partire da impostazioni diverse.
L’annuncio descrive anche opzioni per gli acceleratori e collegamenti per strumenti locali o agenti. Leggi le istruzioni per il tuo cluster e il tuo caso d’uso prima di trattare queste opzioni come equivalenti. Il ripristino su hardware specifico, l’accesso fra cluster e il collegamento con lo sviluppo locale hanno ciascuno dei prerequisiti. Parti dal caso più semplice, in cui una persona può esaminare l’ambiente e verificare su quale cluster gira.
Prova una sospensione e il relativo recupero
- Leggi la guida di distribuzione del progetto e i requisiti attuali del tuo ambiente GKE per snapshot e acceleratori. Crea un ambiente di prova con permessi e limiti di risorse coerenti con il flusso proposto.
- Avvia un notebook riproducibile. Salva gli input, un checkpoint applicativo intermedio e un piccolo file di risultati. Annota l’ora e l’allocazione delle risorse prima della sospensione.
- Sospendi l’ambiente ed esamina lo stato delle risorse del cluster. Verifica se il pod si è fermato, se l’acceleratore può essere assegnato e quale storage rimane.
- Riprendi l’ambiente. Controlla i file e lo stato attivo attesi, poi esegui una cella che usa il modello caricato. Misura il tempo fra la richiesta di ripresa e il momento in cui il notebook è utilizzabile.
- Prova a ottenere lo stesso recupero dai file salvati e dal checkpoint applicativo. Avrai un’alternativa e un confronto utile se il ripristino da snapshot è lento o indisponibile.
- Rivedi le impostazioni di inattività con il team. Decidi che cosa conta come inattività e se i carichi lunghi richiedono un tipo di ambiente separato o una gestione esplicita.
Prova anche il ripristino con un limite di quota o un cluster occupato. Una dimostrazione senza intoppi in un cluster vuoto può nascondere la difficoltà di trovare capacità quando più utenti tornano insieme. La prova serve a capire come si comporta il sistema quando le risorse scarseggiano.
Calcola dove vanno le ore di GPU
Immagina una postazione di sviluppo usata per 40 ore in una settimana. Una macchina lasciata allocata per tutta la settimana conta 168 ore. Se la piattaforma può rilasciare il nodo GPU ogni volta che il lavoro si ferma e ripristinarlo solo durante quelle 40 ore, sono 128 ore in meno di nodo allocato, prima di contare snapshot e ripristino. È un esempio che non presuppone prezzi cloud o profili di utilizzo. Rappresenta un limite superiore per questo schema di allocazione, perché un nodo condiviso può continuare a svolgere lavoro utile nello stesso intervallo.
Il team può rendere il confronto più realistico con un riferimento tratto dal proprio pool di GPU. Per ogni intervallo di prova, annota le ore del nodo, l’eventuale presenza di un altro carico e la quantità di dati archiviati. Annota anche il tempo fra la richiesta di ripresa e la possibilità di eseguire la cella successiva. Se il nodo resta acceso per un altro lavoro, la sospensione può liberare capacità per quel lavoro senza ridurre la fattura. È un risultato diverso e comunque utile.
Anche il tempo dello snapshot entra nel calcolo. Se la sospensione è lunga mentre il vecchio pod resta allocato, una soglia di inattività aggressiva può provocare più interruzioni con poco risparmio di calcolo. Se per riprendere servono diversi minuti mentre il sistema di scalabilità acquisisce una GPU compatibile, chi torna dopo una breve pausa può aspettare più di quanto risparmi la politica. Misura diverse durate di inattività prima di presumere che ogni sospensione convenga.
Scegli che cosa conservare prima di abilitare la sospensione
Il repository di GKE Workspaces descrive un flusso VS Code senza stato e un esempio separato di JupyterLab con stato. Quest’ultimo mostra come ripristinare un notebook con GPU, anche con un modello Qwen2.5 da 3 miliardi di parametri su una T4. Gli snapshot dei pod Kubernetes e l’esempio hanno vincoli di compatibilità specifici. La documentazione GKE di Google spiega il ruolo di GKE Sandbox e della configurazione compatibile di nodo e immagine. Per l’esempio GPU, verifica che il nuovo nodo abbia lo stesso modello di GPU supportato e un ambiente compatibile prima di fare affidamento sul ripristino.
Decidi che cosa si aspettano gli utenti quando vedono il pulsante di sospensione. Alcuni vogliono ritrovare file, output e stato dell’editor. Altri si aspettano che la prossima cella Python veda un oggetto già in RAM o il modello in VRAM. Un dataset condiviso può risiedere in uno storage a oggetti esterno e restare fuori dallo snapshot. Scrivi quali stati può recuperare l’ambiente scelto, dove persistono i file ordinari e che cosa fare se il ripristino non riesce.
Una seconda prova utile riguarda un errore prima della ripresa. In un namespace di test, rendi temporaneamente indisponibile la capacità compatibile e controlla che l’ambiente mostri uno stato chiaro senza generare ripristini concorrenti. Verifica che il titolare possa recuperare il lavoro da file o output salvati quando il processo in memoria non può riprendere. Poi rimuovi lo snapshot di prova e controlla che lo storage e le regole di conservazione si comportino come previsto.
Riporta al team il quadro dei costi
Chi fa ricerca vuole riprendere il lavoro. Il team della piattaforma vuole riportare al pool la capacità GPU scarsa. Chi gestisce la fatturazione vuole sapere se l’allocazione sparisce davvero. Una sola prova può rispondere a tutte e tre le domande se registra separatamente inattività, collocazione sui nodi, dimensione degli snapshot, riprese riuscite e tempo di recupero. Aggiungi una nota di supporto per i casi che falliscono e dai agli utenti un modo per sapere se l’ambiente è sospeso, in attesa di capacità o pronto.
Con questi dati, scegli una politica di inattività per classe di carico. Una sessione lunga con un modello lento da caricare può beneficiare del mantenimento della memoria tra un turno e l’altro. Un esperimento breve che parte da uno script salvato può richiedere solo file persistenti e un riavvio da zero. Possono condividere lo stesso pool senza promettere lo stesso tempo di recupero.
Aggiungi una prova di ripresa alla lista per i rilasci
Un aggiornamento della piattaforma può cambiare l’immagine di avvio o il pool di nodi che fornisce le GPU. Prima di abilitare il cambiamento per il team, crea un notebook di prova con la vecchia configurazione e verifica che cosa gli succede nella nuova. La prova dovrebbe distinguere un ripristino riuscito da una nuova sessione con lo stesso file aperto. Leggi un valore che esiste solo nel processo di prova attivo e verifica poi che i file usati dal processo siano ancora presenti.
Se l’aggiornamento invalida gli snapshot precedenti, dai agli utenti il tempo di salvare i risultati critici e spiega l’alternativa. Verifica a parte la pulizia degli snapshot scaduti. Una prova di ripristino dimostra solo che un particolare ambiente può tornare operativo. Una prova di pulizia mostra quanto stato obsoleto rimane quando le persone smettono di usarlo.
Conserva il lavoro più difficile da ricreare
Un ambiente diventa più utile quando consente alle persone di dimenticare il ciclo di vita della macchina e ritrovare comunque il lavoro. Per farlo occorre trattare come questioni distinte file, checkpoint, snapshot e capacità. Scegli il minimo stato che ti serve per riprendere senza attrito e assicurati che il progetto sia riproducibile anche senza la sessione originale.
Se il tuo team sa che cosa rimane su disco, che cosa va ripristinato e quando si restituiscono le risorse di calcolo, può definire una politica di inattività che le persone useranno davvero.
Fonti
-
Esempio del notebook ripristinabile nella revisione della demo
-
Annuncio del 4 novembre sul blog open source di Google e video dimostrativo
-
Codice di GKE Workspaces, stato del supporto e documentazione d’installazione
Per conservare e ritrovare le conversazioni e le decisioni che accompagnano il tuo lavoro, crea un account Telli.sh.