Trudniejsza obietnica Gemini 4 Carbon: użyteczna praca po pierwszym dniu
Nowy model Google stawia na długotrwałą inżynierię i cyberobronę. Poznaj etapowy dostęp, wyniki benchmarków i praktyczne granice wielodniowego zadania agenta.
Trudny błąd oprogramowania rzadko przypomina schludne ćwiczenie programistyczne. Pojawia się jako zgłoszenie, sporadyczna awaria lub objaw kilka warstw od przyczyny. Użyteczna praca może wymagać czytania historii, testowania konkurencyjnych wyjaśnień i odrzucenia poprawki, która godzinę wcześniej wyglądała obiecująco.
Google ogłosiło Gemini 4 Carbon 28 października 2026 r., podkreślając inżynierię o długim horyzoncie i obronę cyberbezpieczeństwa. Google DeepMind twierdzi, że zespoły wewnętrzne obserwowały wielodniową wytrwałość modelu przy złożonej pracy, w tym subtelnych błędach dużych baz kodu. To obserwacja wewnętrzna, nie obietnica udanej wielodniowej realizacji każdego zadania klienta. Ogłoszenie Google wyjaśnia też granicę dostępu: początkowo wybrani obrońcy cyberbezpieczeństwa, następnie kolejni zaufani partnerzy przez Fairwind, a szersza dostępność jest planowana.
Praktyczne pytanie brzmi, co długo pracujący model powinien po sobie zostawić. Ten przewodnik wyjaśnia pozycję modelu, sposób czytania opublikowanych porównań i przygotowanie zadania, które pozostaje możliwe do oceny po wielu godzinach.
 Przykładowa tablica Scrumban z 2013 r., ilustrująca widoczne stany pracy w ciągłym projekcie. To nie interfejs Gemini ani wynik modelu. Obraz: Dr ian mitchell, CC BY-SA 3.0; zmniejszony z dodanymi marginesami. Źródło obrazu · Licencja i informacje o obrazie. Oficjalna informacja o produkcie.

Czas pomaga tylko wtedy, gdy zadanie zachowuje znaczenie
Agent programistyczny może być zajęty bez wyjaśniania problemu. Może przeszukiwać więcej plików, próbować poprawek i uruchamiać polecenia, oddalając się od pierwotnej awarii. Dłuższe wykonanie daje więcej szans na postęp i na nagromadzenie błędnych założeń. Wyzwanie produktu polega na zachowaniu celu przez całą tę aktywność.
Naszym zdaniem długie zadanie potrzebuje trwałego kontraktu. Określa on problem, dowody potwierdzające naprawę, dozwolony zakres i działania nadal wymagające człowieka. Powinien przetrwać zmiany hipotez i implementacji. Inaczej model może dojść do przekonującego finału, rozwiązując łatwiejszy problem niż zlecony.
Rozważmy przykładowy błąd synchronizacji. Zgłoszenie mówi, że element pozornie się zapisuje, ale znika po odświeżeniu. Przydatne zadanie obejmuje odtworzenie zachowania, znalezienie błędu odpowiedzialności lub zapisu, wąską naprawę i weryfikację tej samej ścieżki użytkownika. Mniej przydatna jest wielka refaktoryzacja z przechodzącym testem, który nigdy nie sprawdził odświeżenia.
Z czasem różnica rośnie. Po kilku godzinach recenzenci potrzebują zapisu najmocniejszych dowodów i niepewności, nie każdego polecenia. Zapis powinien wskazać współpracownikowi, gdzie kontynuować po zatrzymaniu i co uzasadnia przyjęcie wyniku.
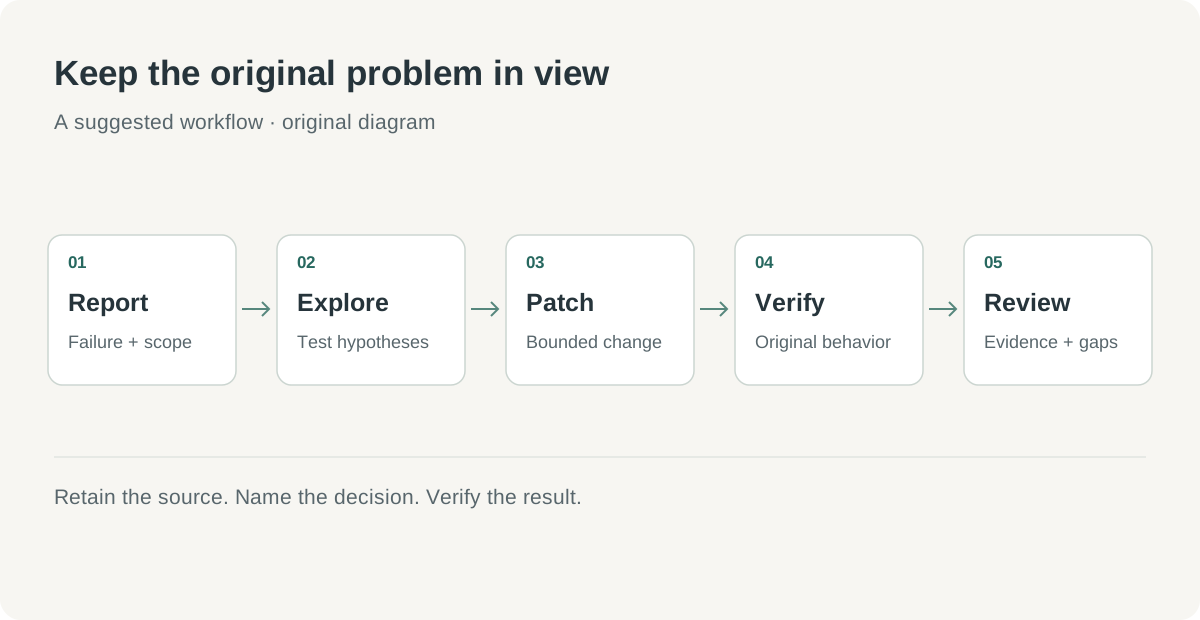 Autorski schemat: długotrwała praca powinna tworzyć naprawę o odtwarzalnym uzasadnieniu, zachowując pierwotne kryterium odbioru podczas poszukiwań.
Porównania Carbon opisują kilka różnych rodzajów pracy
Strona porównania modeli Google DeepMind, sprawdzona 2 listopada, zestawia Carbon i Argon w wielu ocenach. Podaje na przykład 65,2% wobec 57,1% w Terminal-Bench 4.0 i 61,2% wobec 55,0% w FrontierSWE 2. To opublikowane wyniki różnych nazwanych benchmarków z własnymi warunkami; nie należy dodawać ich do jednego wskaźnika sukcesu produktu.
Zespół powinien zacząć od zadania przypominającego własną pracę. Terminal, naprawa repozytorium i praca przeglądarkowa stawiają różne wymagania. Model dobry w jednej ocenie nadal może potrzebować innej konfiguracji narzędzi lub więcej kontekstu człowieka w produkcyjnym repozytorium. Benchmark pomaga wybrać eksperyment; zachowanie repozytorium rozstrzyga jego sukces.
| Pytanie oceny | Dowody w pilotażu zespołu | Czego sam wynik benchmarku nie rozstrzyga |
|---|---|---|
| Czy agent znajdzie przyczynę? | Odtworzenie i poparte dowodami wyjaśnienie przyczynowe | Czy błąd zespołu jest reprezentowany w benchmarku |
| Czy naprawi zachowanie? | Wąska zmiana i kontrola regresji | Czy ukryte kontrakty integracji pozostaną nienaruszone |
| Czy odpowiedzialnie użyje narzędzi? | Jasne uprawnienia i sprawdzalne działania | Czy konfiguracja produkcyjna odpowiada testowej |
| Czy inżynier oceni wynik? | Zwięzłe różnice, wyniki i nierozwiązane luki | Ile kontroli wymagają standardy zespołu |
| Czy pracę można zatrzymać i wznowić? | Zachowany stan i przekazanie pozwalające działać | Czy system agenta utrwala potrzebne materiały |
Tabela jest ramą oceny, nie opisem metodologii Google. Przekłada szeroką obietnicę na pytania, na które zespół odpowie. Dobry lokalny wynik powinien obejmować awarie i zablokowane kroki, aby było wiadomo, gdzie pomaga model, a gdzie proces wymaga pracy.
Porównanie potrzebuje stabilnego punktu odniesienia. Zachowaj tę samą rewizję, uprawnienia, treść zadania i środowisko testowe. Jeśli jedna próba dostaje reprodukcję, a druga musi ją odkryć, różnica czasu nie izoluje wpływu modelu. Zapisz warunki przed interpretacją.
Cyberobrona potrzebuje łańcucha od ustalenia do sprawdzonej naprawy
Ogłoszenie Google z 28 października podaje dla Carbon 88,2% w SEC-bench Pro, 54,8% w ExploitGym i 71,0% w CWE-bench, zaznaczając, że te oceny na zewnętrznych benchmarkach wykonano bez mechanizmów ochronnych. Liczby dotyczą różnych zadań wyszukiwania, walidacji i naprawiania podatności. Źródłem wyników publikowanych przez dostawcę jest ogłoszenie Google.
Dla obrońcy sekwencja zaczyna się od uprawnionego celu i ustalenia, które można obejrzeć. Walidacja powinna wykazać istotne ryzyko w uzgodnionym środowisku. Naprawa musi usunąć przyczynę i zachować prawidłowe zachowanie. Etapy mają różne wymagania dowodowe, nawet jeśli jeden agent pomaga we wszystkich.
Przykładowy przegląd biblioteki wewnętrznej pokazuje różnicę. Zespół daje agentowi izolowaną kopię i określoną obawę dotyczącą wejścia. Oczekuje konkretnego ustalenia, ograniczonej reprodukcji w teście i poprawki z kontrolą regresji. Agent nie powinien rozszerzać zadania na obce systemy tylko dlatego, że w materiałach znajdzie linki lub poświadczenia.
Drugim scenariuszem jest selekcja istniejącego raportu. Agent może powiązać go ze ścieżkami kodu i wskazać testy odróżniające realny problem od błędnego założenia. Wniosek „naprawa niepotrzebna” również wymaga dowodów. Zamknięcie zgłoszenia pewnym wyjaśnieniem jest słabsze niż pokazanie, dlaczego wskazana ścieżka nie dotyczy ocenianej rewizji.
Ostatecznym właścicielem pozostaje zespół inżynierski lub bezpieczeństwa odpowiedzialny za system. Poprawka wymaga oceny rzeczywistej granicy usługi, procesu wdrożenia i zgodności. Udane testy izolowane są częścią decyzji; produkcyjne wdrożenie i monitorowanie pozostają osobnymi etapami.
Wynik bezpieczeństwa modelu nie określa jego uprawnień wdrożeniowych
Google opisuje lepszą zgodność z intencją, odporność na wstrzykiwanie instrukcji i mniej niepopartych twierdzeń. To ważne dla modelu pracującego mimo niejednoznaczności. Operacyjnie należy ocenić je w zamierzonym procesie, zamiast uznać wynik bezpieczeństwa za zgodę na podłączenie wszystkich narzędzi.
Długiej pracy służą stopniowane uprawnienia. Czytanie repozytorium, edycja izolowanego katalogu i wdrożenie usługi to różne działania. Agent może zbierać dowody i przygotować zmianę do oceny przy osobnej zgodzie na publikację lub skutki produkcyjne. Granicę powinno egzekwować środowisko, nie tylko opis zadania.
Niezaufane materiały tworzą kolejne ryzyko. Plik źródłowy, opis problemu lub pobrana strona mogą zawierać instrukcje sprzeczne z zadaniem. Dobry system powinien oddzielać uprawnienia zadania od czytanej treści. Dowody oceny powinny ujawniać nieoczekiwane zmiany zakresu, zwłaszcza podczas pracy tak długiej, że nikt nie obserwuje każdego kroku.
To samo dotyczy poświadczeń. Daj tylko potrzebny dostęp i wybierz środowisko ograniczające skutki pomyłki. Pilotaż może sprawdzić, czy model prosi o brakujący kontekst i uczciwie pozostawia blokadę. To równie ważne jak liczba zmienionych plików przed zatrzymaniem.
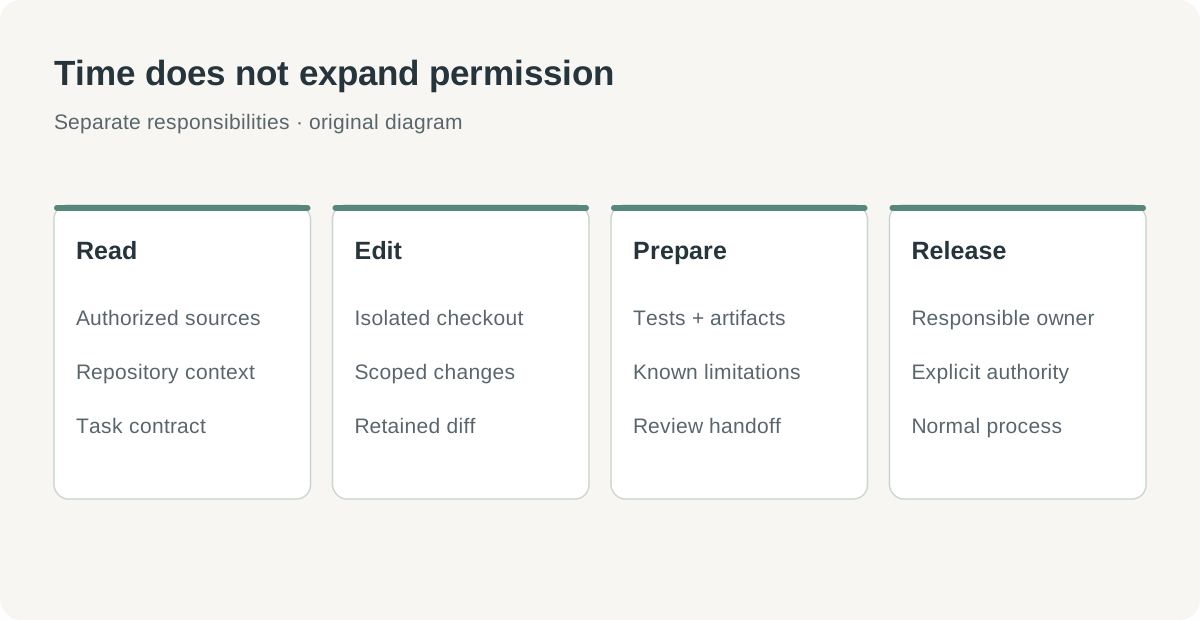 Autorski schemat uprawnień: dłuższe wykonanie nie poszerza automatycznie pozwolenia. Każdy etap ma innego właściciela i własny warunek ukończenia.
Etapowy dostęp oznacza dla większości zespołów najpierw przygotowanie
Publiczna premiera opisuje dostęp wybranych obrońców, potem kolejnych zaufanych partnerów Fairwind, podczas gdy ogólne interfejsy dla programistów, firm i konsumentów dopiero nadejdą. Ogłoszenie modelu i szeroka dostępność to osobne zdarzenia. Przed uzależnieniem dostawy od Carbon sprawdź bieżącą drogę dostępu w oficjalnych kanałach Google. Ogłoszenie z 28 października, sprawdzone 2 listopada 2026 r.
Zespoły bez dostępu mogą przygotować użyteczną pracę. Wybierz trudne, ale ograniczone zadanie, zachowaj rewizję i zbierz dowody wyjaśniające trudność. Określ testy i oczekiwania recenzenta. Przygotowanie przyda się po uzyskaniu dostępu, a już dziś umożliwi lepsze porównania dostępnych narzędzi.
Nie traktuj przygotowania jako obietnicy bezobsługowego ukończenia. Dobre zadanie może ujawnić brak testów, niejasną odpowiedzialność lub zawodną reprodukcję jeszcze przed uruchomieniem modelu. Naprawienie tych warunków poprawia inżynierię niezależnie od przyszłego narzędzia.
Trzecim przykładowym zastosowaniem jest błąd aplikacji między warstwami. Stan interfejsu wygląda poprawnie, ale serwer zapisuje inną wartość. Zadanie może wymagać śledzenia żądania, zapisu i odświeżonego interfejsu oraz wąskiej naprawy. Wartością długiego rozumowania jest łączenie warstw podczas badania, nie więcej kodu w każdej.
Koszt długiego zadania obejmuje ocenę i odzyskiwanie
Opublikowane ceny tokenów to tylko część długiej pracy. Narzędzia, powtarzany kontekst, infrastruktura testowa i przegląd inżyniera współtworzą koszt. Czytelna, dobrze uzasadniona poprawka może być cenniejsza niż tańsza próba pozostawiająca godziny niepewności.
W pierwszym pilotażu określ w systemie agenta granicę czasu i wydatków, jeśli to możliwe. Zdecyduj, jakie dowody powinny poprzedzić przedłużenie. Zatrzymane zadanie powinno zostawić użyteczny punkt kontrolny: ostatni potwierdzony fakt, najmocniejszą pozostałą hipotezę i następny test. Wznowienie opiera się wtedy na postępie, nie nadziei, że więcej czasu pomoże.
Nakład przeglądu również jest mierzalny. Sprawdź, czy współpracownik rozumie przyczynę, różnice i potrafi powtórzyć kontrole bez odtwarzania sesji. Jeśli nie, popraw format rezultatu przed rozszerzeniem uprawnień. Długie zadanie powinno zmniejszać niepewność zespołu, nie przenosić jej do dłuższego dokumentu.
Zacznij od naprawy z jasną linią mety
- Potwierdź dostępną ścieżkę i dokładny oferowany model. Oddziel zapowiedziane wdrożenie Carbon od dostępu do innego Gemini.
- Wybierz dozwolone, izolowane zadanie ze stabilną rewizją i odtwarzalnym błędem. Nie uzależniaj pierwszej oceny od niekontrolowanego stanu produkcji.
- Zapisz kryterium odbioru językiem zachowania systemu lub użytkownika. Uwzględnij nienaruszalne kontrakty i zewnętrzne działania wymagające zgody.
- Zapewnij potrzebne narzędzia i minimalne uprawnienia. Zachowaj zmiany, logi i wyniki testów tam, gdzie inżynier może je sprawdzić.
- Wymagaj punktów kontrolnych odróżniających dowody, hipotezy i blokady. Oceniaj je przed rozszerzeniem zakresu lub budżetu.
- Oceń naprawę względem pierwotnego błędu i właściwych testów regresji. Sprawdź różnice pod kątem obcych zmian i ukrytych migracji kontraktów.
- Niech odpowiedzialny recenzent zdecyduje o gotowości do zwykłego procesu wydania. Jawnie zapisz nieukończone kontrole i wymaganą weryfikację zewnętrzną.
Pilotaż powinien zawierać celowo niewygodny warunek, np. niezwiązany nieudany test lub niedostępną opcjonalną usługę. Sprawdź, czy wynik oddziela ograniczenie od dowodów naprawy. Model uczciwie zgłaszający lukę weryfikacji łatwiej zintegrować niż model zamieniający niepewność w ukończenie.
Wielodniowy agent powinien skracać drogę do decyzji
Ogłoszenie Carbon wskazuje inne oczekiwanie wobec AI programistycznej: pracę trwającą mimo ślepych uliczek i tworzącą poprawkę wartą przeglądu. Otaczający system musi nadać wytrwałości wartość. Jasny zakres, zachowane dowody i ograniczone uprawnienia dają zadanie, które da się sensownie ukończyć.
Oczekujemy, że najlepsze oceny skupią się na jakości przekazania. Czy model zachował pierwotne pytanie? Czy ustalił, co faktycznie zawiodło? Czy inżynier zweryfikuje wynik i zdecyduje o dalszym kroku? Tak łączy się długie wykonanie z praktycznym rezultatem.
Obietnicą długo działającej AI jest krótsza droga od trudnego zgłoszenia do uzasadnionej decyzji. Czas pracy zyskuje wartość, gdy kolejna osoba może zaufać temu, co zostało.
Źródła
- Google: przedstawiamy Gemini 4 Carbon, 28 października 2026 r.; sprawdzono 2 listopada 2026 r. Obserwacje wewnętrzne i benchmarki przypisano Google.
- Google DeepMind: porównanie modeli Gemini, sprawdzono 2 listopada 2026 r. Wersje i warunki benchmarków muszą pozostać przy wynikach.
Zachowaj powiązanie decyzji inżynierskiej ze źródłem
Telli.sh to jedna z możliwości przechowywania materiałów źródłowych, do których masz uprawnienia, i notatek stojących za decyzją inżynierską. Utwórz przestrzeń na notatki.