La promessa più difficile di Gemini 4 Carbon: lavoro utile dopo il primo giorno
Il nuovo modello di frontiera di Google punta su ingegneria e difesa informatica di lunga durata. Accesso graduale, affermazioni sui benchmark e confini pratici di un compito affidato a un agente per più giorni.
Un errore software difficile arriva raramente come un esercizio di programmazione ordinato. Appare come una segnalazione, un guasto intermittente o un sintomo distante diversi livelli dalla causa. Il lavoro utile può richiedere di leggere la cronologia, provare spiegazioni concorrenti e scartare una correzione che un'ora prima sembrava promettente.
Google ha annunciato Gemini 4 Carbon il 28 ottobre 2026, sottolineando ingegneria su orizzonti lunghi e difesa informatica. Google DeepMind afferma che i team interni hanno osservato il modello perseverare per giorni su lavori complessi, compresi errori sottili in grandi basi di codice. È un'osservazione interna, non una promessa che ogni compito dei clienti venga eseguito con successo per giorni. L'annuncio di Google chiarisce anche il confine dell'accesso: disponibilità iniziale a difensori informatici selezionati, poi altri partner fidati tramite Fairwind e disponibilità più ampia pianificata.
La domanda pratica è che cosa debba lasciare un modello che lavora più a lungo. Questa guida spiega il posizionamento del nuovo modello, come leggere i confronti pubblicati e come un team ingegneristico possa preparare un compito che rimanga esaminabile dopo molte ore di lavoro.
 Esempio di bacheca Scrumban del 2013, che illustra stati di lavoro visibili in un progetto continuativo. Non è un'interfaccia Gemini né un risultato del modello. Immagine: Dr ian mitchell, CC BY-SA 3.0; ridimensionata con margini. Fonte dell'immagine · Licenza e note sull'immagine. Riferimento ufficiale del prodotto.

La durata è utile soltanto se il compito conserva il proprio significato
Un agente di programmazione può restare occupato senza chiarire il problema. Può cercare in più file, provare più correzioni ed eseguire più comandi allontanandosi dal guasto originale. Un'esecuzione più lunga aumenta sia le opportunità di progresso sia quelle di accumulare ipotesi sbagliate. La sfida del prodotto è preservare lo scopo del compito attraverso tale attività.
La nostra lettura è che un compito lungo richieda un contratto duraturo. Il contratto definisce problema, prove che dimostrerebbero la correzione, ambito consentito e azioni che richiedono ancora una persona. Dovrebbe sopravvivere ai cambiamenti di ipotesi e implementazione. Altrimenti un modello può arrivare a una conclusione convincente risolvendo un problema più facile di quello assegnato dall'utente.
Considera un errore illustrativo di sincronizzazione. Una segnalazione dice che un elemento sembra salvarsi ma scompare dopo l'aggiornamento. Un compito utile consiste nel riprodurre il comportamento, individuare il problema di responsabilità o persistenza, proporre una correzione circoscritta e verificare lo stesso percorso visibile all'utente. Un risultato meno utile è una grande ristrutturazione accompagnata da un test riuscito che non ha mai esercitato l'aggiornamento.
La distinzione diventa più importante col tempo. Dopo diverse ore, i revisori hanno bisogno di una registrazione delle prove più solide e delle incertezze residue, non della trascrizione di ogni comando. Dovrebbe dire a un collega da dove ripartire se l'esecuzione si ferma e che cosa giustificherebbe l'accettazione del risultato.
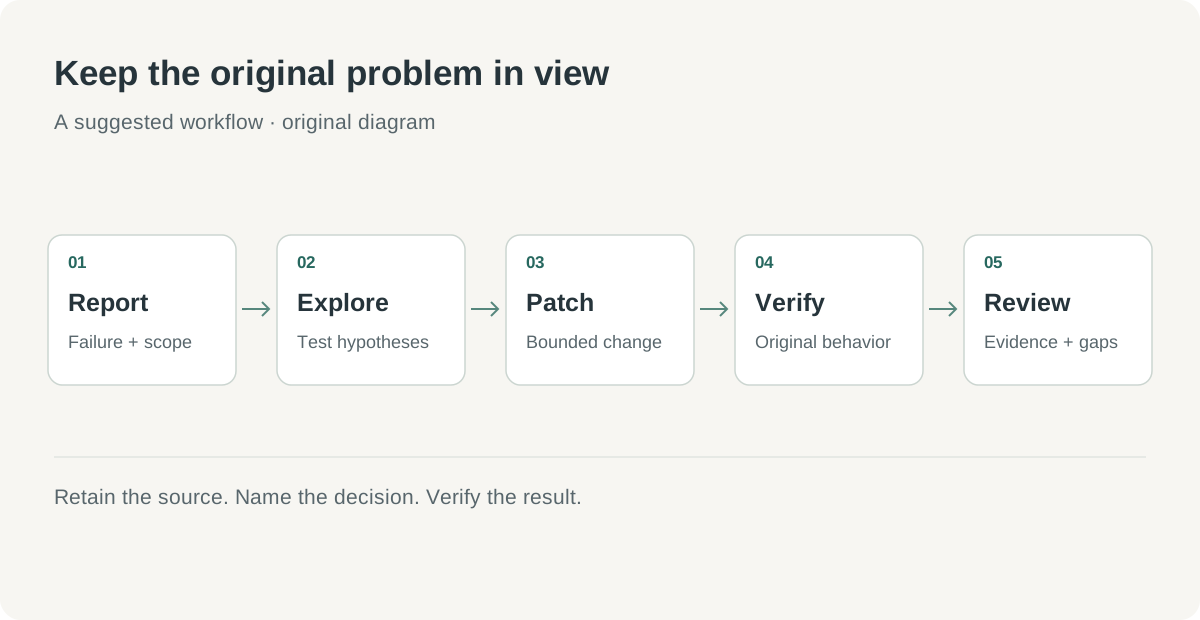 Diagramma originale del compito: un lavoro prolungato dovrebbe produrre una correzione tracciabile, conservando il criterio originale di accettazione durante l'esplorazione.
I confronti di Carbon descrivono tipi di lavoro diversi
La pagina di confronto dei modelli di Google DeepMind, consultata il 2 novembre, elenca Carbon e Argon su più valutazioni. Per esempio, riporta 65,2% contro 57,1% su Terminal-Bench 4.0 e 61,2% contro 55,0% su FrontierSWE 2. Sono risultati pubblicati con nomi e condizioni distinti; non vanno sommati in un unico tasso di successo del prodotto.
Un team di sviluppo dovrebbe partire dal compito che somiglia al proprio flusso. Interazione con terminali, correzione di repository e lavoro tramite browser impongono esigenze diverse a un agente. Un modello efficace in una valutazione può comunque richiedere una diversa configurazione degli strumenti o più contesto umano in un repository di produzione. Il benchmark aiuta a scegliere un esperimento; il comportamento del repository stabilisce se riesce.
| Domanda di valutazione | Prove da cercare in una prova del team | Che cosa lascia aperto il solo punteggio |
|---|---|---|
| L'agente sa trovare una causa? | Riproduzione e spiegazione causale supportata | Se il guasto del team sia rappresentato nel benchmark |
| Sa correggere il comportamento? | Modifica mirata e controllo di regressione | Se i contratti d'integrazione nascosti restino intatti |
| Sa usare responsabilmente gli strumenti? | Autorizzazioni chiare e azioni esaminabili | Se la configurazione produttiva coincida con la valutazione |
| Un altro ingegnere può esaminarlo? | Differenze concise, risultati e lacune irrisolte | Quanto lavoro di revisione richiedano gli standard del team |
| Il lavoro può fermarsi e riprendere? | Stato conservato e passaggio operativo utilizzabile | Se il sistema dell'agente conservi gli artefatti necessari |
Questa tabella è uno schema di valutazione, non una riformulazione del metodo di test di Google. Trasforma un'affermazione ampia sulle capacità in domande a cui il team può rispondere. Un risultato locale solido dovrebbe includere errori e passaggi bloccati, così che il team capisca dove il modello aiuta e dove il flusso circostante richieda ancora lavoro.
Il confronto necessita anche di una base stabile. Mantieni uguali revisione del repository, autorizzazioni degli strumenti, formulazione del compito e ambiente di test quando confronti configurazioni. Se un'esecuzione riceve una riproduzione e un'altra deve scoprirla da zero, la differenza nel tempo di completamento non isola il modello. Registra le condizioni prima di interpretare l'esito.
La difesa informatica richiede una catena dal rilievo alla correzione verificata
L'annuncio di Google del 28 ottobre riporta per Carbon 88,2% su SEC-bench Pro, 54,8% su ExploitGym e 71,0% su CWE-bench, precisando che queste valutazioni su benchmark esterni sono state eseguite senza protezioni. Le cifre riguardano compiti diversi nell'individuazione, convalida e correzione delle vulnerabilità. L'annuncio di Google è la fonte di questi risultati pubblicati dal fornitore.
Per un difensore, la sequenza utile parte da un obiettivo autorizzato e da un rilievo esaminabile. La convalida dovrebbe stabilire il rischio pertinente nell'ambiente concordato. Una correzione deve poi affrontare la causa e preservare il comportamento legittimo. Le fasi hanno requisiti probatori diversi, anche se un agente contribuisce a tutte.
Una revisione illustrativa di una libreria interna mostra la distinzione. Il team fornisce a un agente una copia isolata di una libreria e un dubbio definito sulla gestione degli input. Il risultato desiderato è un rilievo specifico, una riproduzione delimitata nell'ambiente di test e una correzione con copertura di regressione. L'agente non dovrebbe estendere il compito a sistemi estranei solo perché scopre collegamenti o credenziali nel materiale del progetto.
Un secondo scenario illustrativo è la valutazione di una segnalazione esistente. L'agente può aiutare a collegarla ai percorsi del codice e stabilire quali test distinguano un problema reale da un'ipotesi errata. Anche una conclusione utile «non serve correggere» richiede prove. Chiudere una segnalazione con una spiegazione sicura è meno solido che mostrare perché il percorso dichiarato non si applichi alla revisione valutata.
Il responsabile finale resta il team ingegneristico o di sicurezza del sistema. Una correzione proposta va esaminata rispetto a confine reale del servizio, processo di distribuzione e requisiti di compatibilità. Test isolati riusciti sono una parte della decisione; rilascio in produzione e monitoraggio restano passaggi separati.
Un risultato di sicurezza del modello non definisce i permessi di distribuzione
Google descrive miglioramenti nell'allineamento, nella resistenza all'iniezione di istruzioni e nella riduzione delle affermazioni non supportate. Sono aspetti pertinenti per un modello destinato a lavorare nell'ambiguità. L'implicazione operativa è valutarli nel flusso previsto, anziché considerare un risultato di sicurezza di sintesi come un permesso di collegare ogni strumento disponibile.
Il lavoro prolungato beneficia di autorità graduata. Leggere un repository, modificare una copia isolata e distribuire un servizio sono azioni diverse. Un team può lasciare che un agente raccolga prove e prepari una modifica esaminabile, mantenendo un'approvazione distinta per pubblicazione o effetti in produzione. Il confine dovrebbe essere imposto dall'ambiente oltre che descritto nel compito.
Il materiale non fidato crea un'altra questione pratica. Un file sorgente, una descrizione di problema o una pagina recuperata possono contenere istruzioni in conflitto con l'incarico. Un sistema ben progettato dovrebbe separare l'autorità del compito dal contenuto letto. Le prove di revisione dovrebbero rendere visibili ampliamenti inattesi dell'ambito, soprattutto quando l'esecuzione dura abbastanza da non essere osservata azione per azione.
Lo stesso vale per le credenziali. Dai al compito soltanto gli accessi necessari e preferisci un ambiente in cui un'azione accidentale abbia effetti limitati. Una prova utile può stabilire se il modello chieda il contesto mancante e lasci uno stato di blocco onesto. Questo comportamento conta quanto il numero di file che può modificare prima di fermarsi.
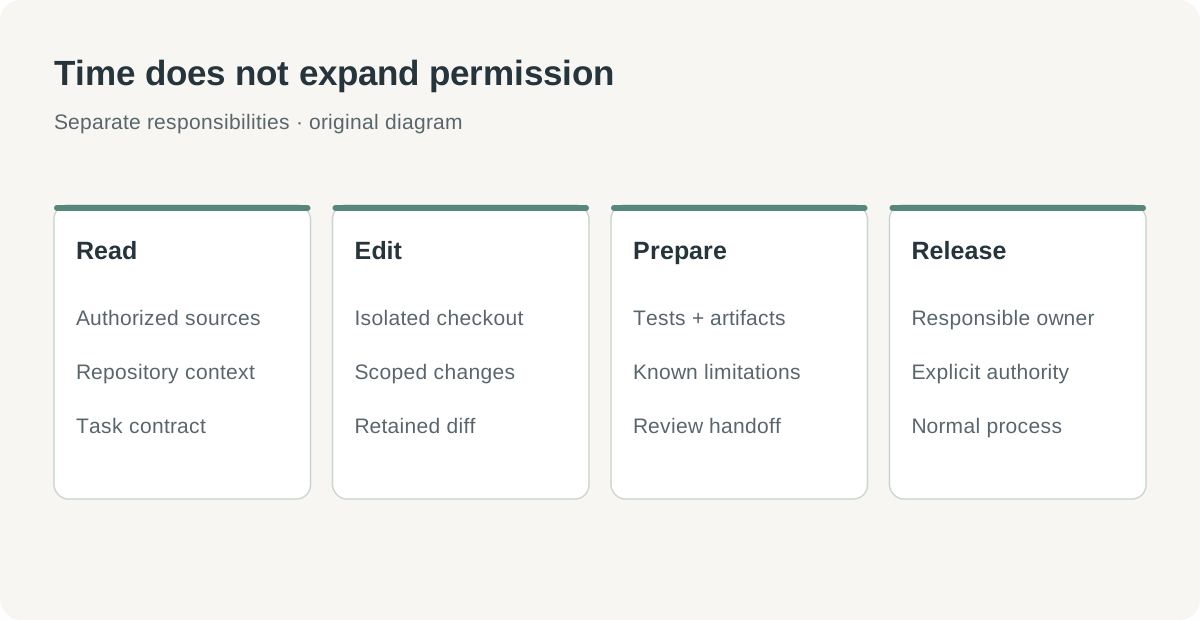 Diagramma originale dell'autorità: un'esecuzione più lunga non amplia automaticamente i permessi. Ogni fase ha un responsabile diverso e una distinta condizione di completamento.
L'accesso graduale assegna prima un compito preparatorio alla maggior parte dei team
Il lancio pubblico descrive accesso a difensori informatici selezionati, poi ad altri partner Fairwind fidati, mentre interfacce generali per sviluppatori, aziende e consumatori devono ancora arrivare. Annuncio di un modello e disponibilità ampia del prodotto sono eventi separati. Verifica il percorso di accesso attuale tramite i canali ufficiali Google prima di pianificare una consegna basata su Carbon. Annuncio del 28 ottobre, consultato il 2 novembre 2026.
I team senza accesso possono comunque preparare lavoro utile. Scegli un compito difficile ma delimitato, conserva la revisione pertinente del repository e raccogli le prove che oggi lo rendono difficile. Definisci test e aspettative del revisore. La preparazione è riutilizzabile quando arriverà l'accesso e rende più significativi già oggi i confronti con strumenti disponibili.
Evita di trattare la preparazione come una promessa di completamento senza supervisione. Un buon compito può rivelare infrastrutture di test mancanti, responsabilità poco chiare o una riproduzione inaffidabile prima ancora di eseguire un nuovo modello. Correggere queste condizioni può migliorare il processo ingegneristico indipendentemente dal modello che svolgerà l'esplorazione.
Un terzo uso illustrativo è un difetto applicativo che attraversa più livelli. Lo stato frontend sembra corretto mentre il server salva un valore diverso. Il compito può richiedere una traccia completa attraverso richiesta, persistenza e interfaccia aggiornata, seguita da una correzione mirata. Il valore del ragionamento prolungato è tenere collegati questi livelli durante l'indagine, anziché generare semplicemente più codice in ognuno.
Il costo di un compito lungo comprende revisione e recupero
I prezzi pubblicati per token sono soltanto una parte di un lavoro lungo. Esecuzione degli strumenti, contesto ripetuto, infrastruttura di test e revisione ingegneristica possono contribuire al costo reale. Un compito che termina con una correzione leggibile e ben supportata può valere più di un'esecuzione economica che lascia ore di incertezza al revisore.
Per la prima prova, definisci quando possibile nel sistema dell'agente un limite di spesa e tempo. Decidi quali prove produrre prima di estendere l'esecuzione. Un compito fermo dovrebbe lasciare un punto di ripresa utile: ultimo fatto confermato, ipotesi residua più forte e test successivo. La continuazione diventa così una decisione basata sui progressi anziché sulla speranza che altro tempo aiuti.
Anche il carico di revisione è misurabile. Registra se un collega riesce a capire la causa, esaminare le differenze e riprodurre i controlli pertinenti senza rigiocare l'intera sessione. Se no, migliora il formato della consegna prima di ampliare l'autorità dell'agente. Un compito lungo dovrebbe ridurre l'incertezza del team, non trasferirla in un documento di revisione più lungo.
Inizia con una correzione che abbia un traguardo chiaro
- Conferma il percorso di accesso disponibile e il modello esatto offerto. Mantieni distinto il lancio annunciato di Carbon dall'accesso a un altro modello Gemini.
- Seleziona un compito autorizzato e isolato, con revisione stabile del repository e guasto riproducibile. Evita che la prima valutazione dipenda da uno stato produttivo incontrollato.
- Scrivi il criterio di accettazione in termini visibili all'utente o di comportamento del sistema. Includi i contratti da preservare e nomina le azioni esterne che richiedono approvazione.
- Fornisci strumenti necessari e permessi minimi. Conserva modifiche, registri e artefatti di test dove un altro ingegnere possa esaminarli.
- Richiedi punti di controllo che distinguano prove confermate, ipotesi attuali e lavoro bloccato. Esaminali prima di estendere ambito o budget.
- Valuta la correzione rispetto al guasto originale e alla suite di regressione interessata. Esamina le differenze cercando modifiche estranee e migrazioni nascoste dei contratti.
- Fai decidere a un revisore responsabile se la correzione sia pronta per il normale processo di rilascio. Registra esplicitamente controlli incompleti e verifiche esterne necessarie.
La prova dovrebbe includere una condizione deliberatamente scomoda, come un test estraneo che fallisce o un servizio opzionale indisponibile. Osserva se la consegna separa quel limite dalle prove reali della correzione. Un modello che segnala onestamente una lacuna di verifica è più facile da integrare di uno che trasforma ogni stato incerto in una dichiarazione di completamento.
Un agente che lavora per giorni dovrebbe accorciare il percorso verso una decisione
L'annuncio di Carbon indica un'aspettativa diversa per l'IA di programmazione: lavoro che persevera fra vicoli ciechi e produce una correzione degna di revisione. Il sistema ingegneristico circostante deve rendere utile tale persistenza. Ambito chiaro, prove conservate e autorità limitata danno al modello un compito che può concludere in modo significativo.
Ci aspettiamo che le valutazioni più solide si concentrino sulla qualità del passaggio di lavoro. Il modello ha conservato la domanda originale? Ha identificato che cosa fosse realmente guasto? Un ingegnere può verificare il risultato e decidere il seguito? Queste domande collegano una lunga esecuzione a un risultato ingegneristico pratico.
La promessa dell'IA che lavora più a lungo è un percorso più breve da una segnalazione difficile a una decisione giustificata. Il tempo speso lavorando acquista valore quando la persona successiva può fidarsi di ciò che rimane.
Fonti
- Google: presentazione di Gemini 4 Carbon, 28 ottobre 2026; consultato il 2 novembre 2026. Osservazioni interne e risultati dei benchmark sono attribuiti a Google.
- Google DeepMind: confronto dei modelli Gemini, consultato il 2 novembre 2026. Versioni e condizioni dei benchmark devono restare associate ai punteggi.
Mantieni una decisione ingegneristica collegata alla fonte
Telli.sh è un'opzione per conservare il materiale di partenza autorizzato e gli appunti alla base di una decisione ingegneristica. Crea uno spazio per gli appunti.