La promesse plus exigeante de Gemini 4 Carbon : du travail utile après le premier jour
Le nouveau modèle de pointe de Google privilégie ingénierie de longue durée et cyberdéfense. Comprendre l’accès progressif, les benchmarks annoncés et les limites concrètes d’une tâche d’agent sur plusieurs jours.
Un bogue difficile se présente rarement comme un exercice de programmation bien rangé. Il arrive sous la forme d’un signalement, d’un échec intermittent ou d’un symptôme éloigné de sa cause de plusieurs couches. Le travail utile peut consister à lire l’historique, tester des explications concurrentes et abandonner une correction prometteuse une heure plus tôt.
Google a annoncé Gemini 4 Carbon le 28 octobre 2026, en mettant l’accent sur l’ingénierie de longue durée et la cyberdéfense. Google DeepMind indique que ses équipes internes ont vu le modèle persévérer pendant des jours sur des travaux complexes, notamment des bogues subtils dans de grandes bases de code. C’est une observation interne, pas la promesse que chaque tâche client s’exécutera avec succès pendant plusieurs jours. L’annonce de Google précise aussi l’accès : d’abord certains acteurs de la cyberdéfense, puis d’autres partenaires de confiance via Fairwind, avant une disponibilité élargie prévue.
La question pratique concerne ce qu’un modèle travaillant plus longtemps doit laisser derrière lui. Ce guide explique la place du nouveau modèle, la lecture des comparaisons publiées et la préparation d’une tâche qui reste vérifiable après de nombreuses heures de travail.
 Exemple de tableau Scrumban de 2013 illustrant des états de travail visibles dans un projet continu. Ce n’est ni une interface Gemini ni un résultat du modèle. Image : Dr ian mitchell, CC BY-SA 3.0 ; redimensionnée avec des marges. Source de l’image · Licence et précisions sur l’image. Référence officielle du produit.

La durée n’est utile que si la tâche conserve son sens
Un agent de programmation peut rester occupé sans éclaircir le problème. Il peut chercher dans davantage de fichiers, essayer plus de correctifs et exécuter plus de commandes tout en s’éloignant de l’échec original. Une exécution prolongée accroît les occasions de progrès comme celles d’accumuler de fausses hypothèses. Le défi produit est de préserver l’objectif de la tâche au fil de cette activité.
Notre avis est qu’une tâche longue nécessite un contrat durable. Celui-ci définit le problème, les preuves établissant la réparation, le périmètre autorisé et les actions exigeant encore une personne. Il doit survivre aux changements d’hypothèses et d’implémentation. Sinon, un modèle peut aboutir à une conclusion convaincante en résolvant un problème plus facile que celui confié par l’utilisateur.
Prenons un bogue de synchronisation illustratif. Le signalement indique qu’un élément semble enregistré mais disparaît après actualisation. Une tâche utile consiste à reproduire ce comportement, identifier le défaut de responsabilité ou de persistance, proposer une correction délimitée et vérifier le même parcours visible par l’utilisateur. Une vaste refonte accompagnée d’un test réussi qui n’exerce jamais l’actualisation est moins utile.
La distinction devient plus importante avec le temps. Après plusieurs heures, les réviseurs ont besoin des preuves les plus solides et des incertitudes restantes, plutôt que de la transcription de chaque commande. Ce dossier doit indiquer à un collègue où reprendre si l’exécution s’arrête et ce qui justifierait l’acceptation du résultat.
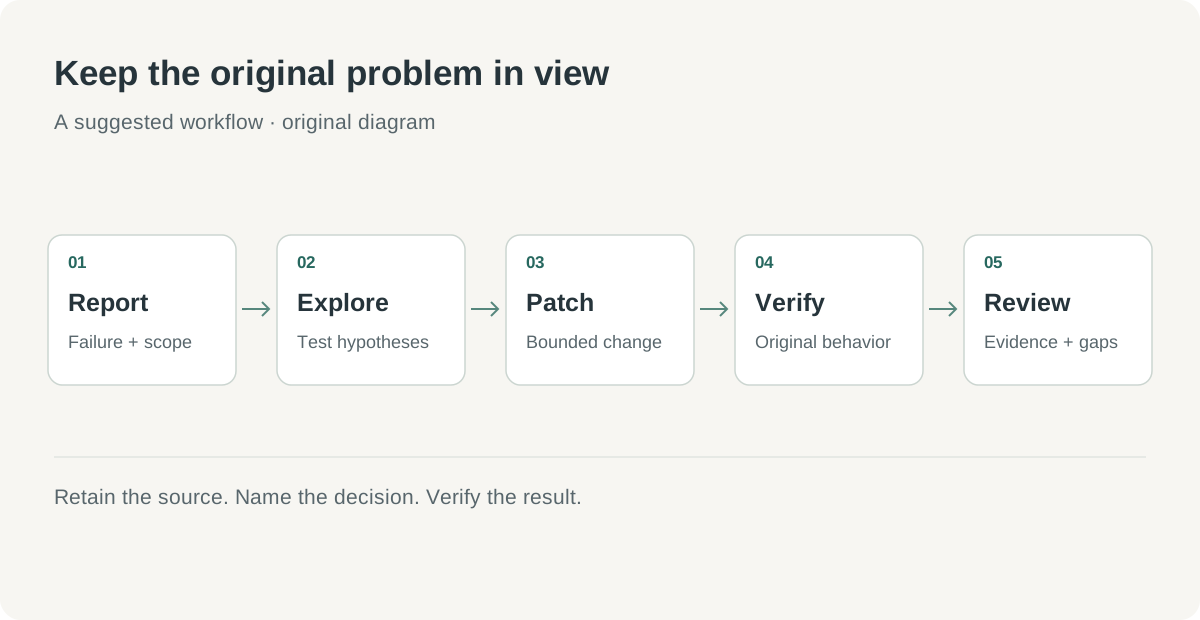 Schéma de tâche original : le travail soutenu doit produire une réparation traçable, avec le critère d’acceptation initial préservé pendant l’exploration.
Les comparaisons de Carbon décrivent plusieurs types de travail
La page de comparaison des modèles de Google DeepMind, consultée le 2 novembre, répertorie Carbon et Argon dans plusieurs évaluations. Elle rapporte, par exemple, 65.2% contre 57.1% sur Terminal-Bench 4.0 et 61.2% contre 55.0% sur FrontierSWE 2. Ces résultats publiés ont des noms et conditions de benchmark distincts ; il ne faut pas les additionner en un taux de réussite produit unique.
Une équipe de développement doit commencer par la tâche ressemblant à son propre processus. Interaction avec un terminal, réparation d’un dépôt et travail dans un navigateur imposent des exigences différentes. Un modèle performant dans une évaluation peut encore nécessiter une autre configuration d’outils ou davantage de contexte humain dans un dépôt de production. Le benchmark aide à choisir une expérience ; le comportement du dépôt détermine sa réussite.
| Question d’évaluation | Preuves à rechercher dans un pilote d’équipe | Ce qu’un score seul ne résout pas |
|---|---|---|
| L’agent trouve-t-il une cause ? | Reproduction et explication causale étayée | Présence de l’échec de l’équipe dans le benchmark |
| Répare-t-il le comportement ? | Modification ciblée et test de non-régression | Préservation des contrats d’intégration cachés |
| Utilise-t-il les outils avec responsabilité ? | Autorisations claires et actions inspectables | Correspondance entre outils de production et configuration évaluée |
| Un autre ingénieur peut-il le relire ? | Différences concises, résultats et lacunes non résolues | Effort de revue exigé par les normes de l’équipe |
| Le travail peut-il s’arrêter et reprendre ? | État conservé et transmission exploitable | Persistance des éléments nécessaires dans le système d’agent environnant |
Ce tableau est un cadre d’évaluation, pas une reformulation de la méthode de test de Google. Il transforme une capacité générale annoncée en questions auxquelles une équipe peut répondre. Un bon résultat local doit inclure les échecs et les étapes bloquées pour montrer où le modèle aide et où le processus environnant nécessite encore du travail.
La comparaison exige aussi une référence stable. Gardez identiques révision du dépôt, autorisations d’outils, énoncé de tâche et environnement de test lorsque vous comparez des configurations de modèles. Si une exécution reçoit une reproduction et qu’une autre doit la découvrir, la différence de durée n’isole pas le modèle. Consignez les conditions avant d’interpréter le résultat.
La cyberdéfense exige une chaîne allant du constat à la réparation vérifiée
L’annonce de Google du 28 octobre rapporte pour Carbon 88.2% sur SEC-bench Pro, 54.8% sur ExploitGym et 71.0% sur CWE-bench, en précisant que ces évaluations sur benchmarks externes ont été effectuées sans garde-fous. Les chiffres concernent des tâches différentes de découverte, de validation et de correction de vulnérabilités. L’annonce de Google est la source de ces résultats publiés par le fournisseur.
Pour un défenseur, la séquence utile commence par une cible autorisée et un constat inspectable. La validation doit établir le risque pertinent dans l’environnement convenu. La réparation doit ensuite traiter la cause et préserver le comportement légitime. Les exigences de preuve diffèrent entre ces étapes, même si le même agent contribue à toutes.
Une revue illustrative de bibliothèque interne montre cette distinction. L’équipe fournit une copie isolée d’une bibliothèque et une préoccupation définie concernant le traitement des entrées. Le résultat attendu est un constat précis, une reproduction délimitée dans l’environnement de test et un correctif couvert par des tests de non-régression. L’agent ne doit pas étendre sa mission à des systèmes sans rapport simplement parce qu’il découvre des liens ou des identifiants dans les documents du projet.
Un deuxième scénario illustratif est le tri d’un signalement existant. L’agent peut relier le rapport aux chemins de code et déterminer quels tests distinguent un vrai problème d’une mauvaise hypothèse. Une conclusion utile « aucune réparation nécessaire » exige aussi des preuves. Fermer un signalement avec une explication assurée est moins solide que montrer pourquoi le chemin allégué ne s’applique pas à la révision évaluée.
Le responsable final reste l’équipe d’ingénierie ou de sécurité du système. Un correctif proposé doit être examiné au regard des frontières réelles du service, du déploiement et des exigences de compatibilité. La réussite de tests isolés contribue à cette décision ; déploiement en production et surveillance restent des étapes séparées.
Le résultat de sécurité d’un modèle ne définit pas ses autorisations de déploiement
Google décrit des progrès d’alignement, de résistance à l’injection de consignes et de réduction des affirmations non étayées. Ce sont des domaines pertinents pour un modèle censé continuer à travailler dans l’ambiguïté. Il faut les évaluer dans le processus visé plutôt que prendre un résultat de sécurité mis en avant pour une autorisation de connecter tous les outils disponibles.
Le travail long bénéficie d’une autorité progressive. Lire un dépôt, modifier une copie isolée et déployer un service sont des actions distinctes. Une équipe peut laisser l’agent recueillir des preuves et préparer une modification vérifiable tout en conservant une approbation distincte pour la publication ou les effets en production. La frontière doit être imposée par l’environnement autant que décrite dans la tâche.
Les éléments non fiables créent une autre préoccupation pratique. Un fichier source, une description de ticket ou une page téléchargée peuvent contenir des instructions contraires au travail confié. Un système d’agent bien conçu sépare l’autorité de la tâche du contenu lu. Les preuves de revue doivent révéler les changements de périmètre inattendus, surtout lorsqu’une longue exécution n’est plus surveillée action par action.
Le principe s’applique aussi aux identifiants. Ne donnez que l’accès nécessaire et privilégiez un environnement où une action accidentelle a un effet limité. Un pilote utile peut établir si le modèle demande le contexte manquant et laisse un état bloqué honnête. Ce comportement compte autant que le nombre de fichiers modifiables avant l’arrêt.
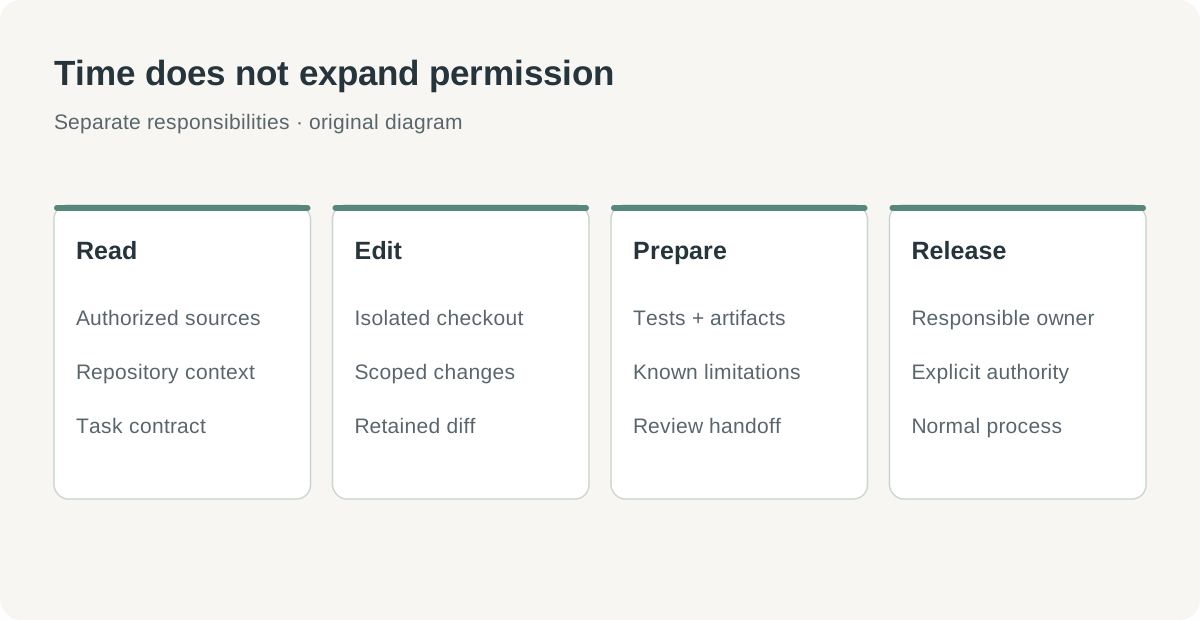 Schéma d’autorité original : une exécution plus longue n’étend pas automatiquement les permissions. Chaque étape possède un responsable et une condition d’achèvement distincts.
L’accès progressif donne d’abord une tâche de préparation à la plupart des équipes
Le lancement public décrit un accès pour certains acteurs de la cyberdéfense, puis d’autres partenaires Fairwind de confiance ; les interfaces générales pour développeurs, entreprises et particuliers restent à venir. Annonce d’un modèle et disponibilité produit élargie sont des événements distincts. Vérifiez le parcours actuel dans les canaux officiels de Google avant de faire dépendre une livraison de Carbon. Annonce du 28 octobre, consultée le 2 novembre 2026.
Une équipe sans accès peut néanmoins préparer du travail utile. Choisissez une tâche difficile mais délimitée, conservez la révision concernée et recueillez les preuves qui la rendent actuellement difficile. Définissez les tests et les attentes des réviseurs. Cette préparation sera réutilisable lorsque l’accès arrivera et rend déjà plus significatives les comparaisons avec les outils disponibles.
Ne traitez pas cette préparation comme une promesse d’achèvement sans surveillance. Une bonne tâche peut révéler une infrastructure de test manquante, des responsabilités floues ou une reproduction peu fiable avant l’exécution du nouveau modèle. Corriger ces conditions améliore l’ingénierie de l’équipe quel que soit le modèle qui mènera finalement l’exploration.
Un troisième usage illustratif est un défaut applicatif entre couches. L’état du frontend semble correct tandis que le serveur stocke une autre valeur. La tâche peut exiger une trace de bout en bout de la requête, de la persistance et de l’interface actualisée, puis une réparation ciblée. La valeur du raisonnement soutenu est de maintenir ces couches reliées pendant l’enquête, pas simplement de générer plus de code dans chacune.
Le coût d’une tâche longue inclut revue et récupération
Les tarifs publiés par token ne constituent qu’une partie du coût d’un travail long. Exécution d’outils, contexte répété, infrastructure de test et revue d’ingénieur y contribuent tous. Une tâche qui livre un correctif lisible et bien étayé peut valoir davantage qu’une exécution moins chère laissant des heures d’incertitude au réviseur.
Pour le premier pilote, définissez si possible une limite de dépenses et de temps dans le système d’agent. Décidez quelles preuves doivent être produites avant de prolonger l’exécution. Une tâche bloquée doit laisser un point de reprise utile : dernier fait confirmé, meilleure hypothèse restante et prochain test. La continuation devient ainsi une décision fondée sur les progrès, pas sur l’espoir qu’un délai supplémentaire aidera.
La charge de revue se mesure aussi. Vérifiez si un collègue comprend la cause, inspecte les différences et reproduit les contrôles pertinents sans rejouer toute la session. Sinon, améliorez la forme du livrable avant d’élargir l’autorité de l’agent. Une tâche longue doit réduire l’incertitude pour l’équipe, pas la transférer dans un compte rendu plus long.
Commencez par une réparation dont l’arrivée est clairement définie
- Confirmez le parcours d’accès disponible et le modèle exact proposé. Distinguez le déploiement annoncé de Carbon de l’accès à un autre modèle Gemini.
- Choisissez une tâche autorisée et isolée avec une révision stable et un échec reproductible. Ne faites pas dépendre la première évaluation d’un état de production incontrôlé.
- Rédigez le critère d’acceptation en termes de comportement visible ou système. Incluez les contrats à préserver et nommez les actions externes exigeant une approbation.
- Fournissez les outils requis et les autorisations minimales. Conservez modifications, journaux et résultats de tests dans un endroit inspectable par un autre ingénieur.
- Exigez des points d’étape distinguant preuves confirmées, hypothèses et travail bloqué. Examinez-les avant d’étendre périmètre ou budget.
- Évaluez la réparation proposée face à l’échec initial et à la suite de non-régression concernée. Inspectez les différences pour repérer changements sans rapport et migrations de contrat cachées.
- Faites décider par un réviseur responsable si le correctif est prêt pour la procédure normale de publication. Consignez explicitement les vérifications incomplètes et les contrôles externes requis.
Le pilote doit inclure une condition volontairement gênante, comme un test sans rapport en échec ou un service optionnel indisponible. Observez si le livrable sépare cette limite des preuves réelles de réparation. Un modèle qui rapporte honnêtement une lacune de vérification s’intègre plus facilement qu’un modèle transformant toute incertitude en déclaration d’achèvement.
Un agent travaillant plusieurs jours doit raccourcir le chemin vers la décision
L’annonce de Carbon ouvre une autre attente pour l’IA de développement : un travail qui persiste malgré les impasses et produit une réparation digne d’être relue. Le système d’ingénierie environnant doit rendre cette persistance utile. Un périmètre clair, des preuves conservées et une autorité délimitée donnent au modèle une tâche qu’il peut terminer de façon significative.
Nous pensons que les meilleures évaluations porteront sur la qualité de la transmission. Le modèle a-t-il préservé la question initiale ? A-t-il identifié ce qui a réellement échoué ? Un ingénieur peut-il vérifier le résultat et décider de la suite ? Ces questions relient une exécution longue à un résultat d’ingénierie concret.
La promesse d’une IA travaillant plus longtemps est un chemin plus court entre un signalement difficile et une décision justifiée. Le temps passé à travailler devient précieux lorsque la personne suivante peut se fier à ce qui reste.
Sources
- Google : présentation de Gemini 4 Carbon, 28 octobre 2026 ; consultée le 2 novembre 2026. Observations internes et résultats de benchmarks sont attribués à Google.
- Google DeepMind : comparaison des modèles Gemini, consultée le 2 novembre 2026. Versions et conditions des benchmarks doivent rester associées aux scores.
Garder une décision d’ingénierie reliée à sa source
Telli.sh est une option pour conserver des sources dont l’utilisation est autorisée et les notes qui fondent une décision d’ingénierie. Créer un espace de notes.