La promesa más difícil de Gemini 4 Carbon: trabajo útil después del primer día
El nuevo modelo de frontera de Google prioriza ingeniería y ciberdefensa prolongadas. Su acceso gradual, las comparaciones publicadas y los límites prácticos de una tarea de varios días.
Un fallo difícil rara vez llega como un ejercicio de programación bien definido. Aparece como un informe, un error intermitente o un síntoma situado a varias capas de su causa. El trabajo útil puede exigir leer el historial, probar explicaciones rivales y descartar un parche que parecía prometedor una hora antes.
Google anunció Gemini 4 Carbon el 28 de octubre de 2026, con énfasis en ingeniería de largo recorrido y defensa de ciberseguridad. Google DeepMind afirma que sus equipos internos lo han visto persistir durante días en trabajos complejos, incluidos errores sutiles en bases de código grandes. Es una observación interna, no una promesa de que toda tarea de un cliente funcionará durante días. El anuncio de Google también delimita el acceso: inicialmente para ciberdefensores seleccionados, con más socios de confianza mediante Fairwind y disponibilidad más amplia previstas.
La pregunta práctica es qué debería dejar un modelo que trabaja durante más tiempo. Esta guía explica la posición del nuevo modelo, cómo leer las comparaciones y cómo preparar una tarea revisable tras muchas horas de trabajo.
 Ejemplo de tablero Scrumban de 2013 que ilustra estados de trabajo visibles en un proyecto continuo. No es una interfaz de Gemini ni un resultado del modelo. Imagen: Dr ian mitchell, CC BY-SA 3.0; redimensionada con márgenes. Fuente de la imagen · Licencia y notas de la imagen. Referencia oficial del producto.

La duración solo sirve si la tarea conserva su sentido
Un agente puede seguir ocupado sin aclarar el problema. Puede buscar más archivos, probar más parches y ejecutar más comandos mientras se aleja del fallo original. Una ejecución larga aumenta la oportunidad de avanzar y de acumular supuestos incorrectos. El reto del producto es conservar el propósito a través de esa actividad.
Nuestra opinión es que una tarea prolongada necesita un contrato duradero. Debe declarar problema, evidencia que demostraría la reparación, alcance permitido y acciones que aún requieren una persona. Debe sobrevivir a cambios de hipótesis e implementación. De lo contrario, un modelo puede llegar a un final convincente resolviendo un problema más fácil que el encargado.
Considera un fallo ilustrativo de sincronización. Un elemento parece guardarse pero desaparece al actualizar. Una tarea útil reproduce el comportamiento, identifica el fallo de responsabilidad o persistencia, propone una reparación acotada y verifica el mismo recorrido visible. Un resultado peor es una gran refactorización con una prueba aprobada que nunca actualizó la página.
La distinción importa más con el tiempo. Tras horas de trabajo, los revisores necesitan un registro de la evidencia más sólida y de las incertidumbres, no todos los comandos. Ese registro debería indicar dónde continuar si se detiene la ejecución y qué justificaría aceptar el resultado.
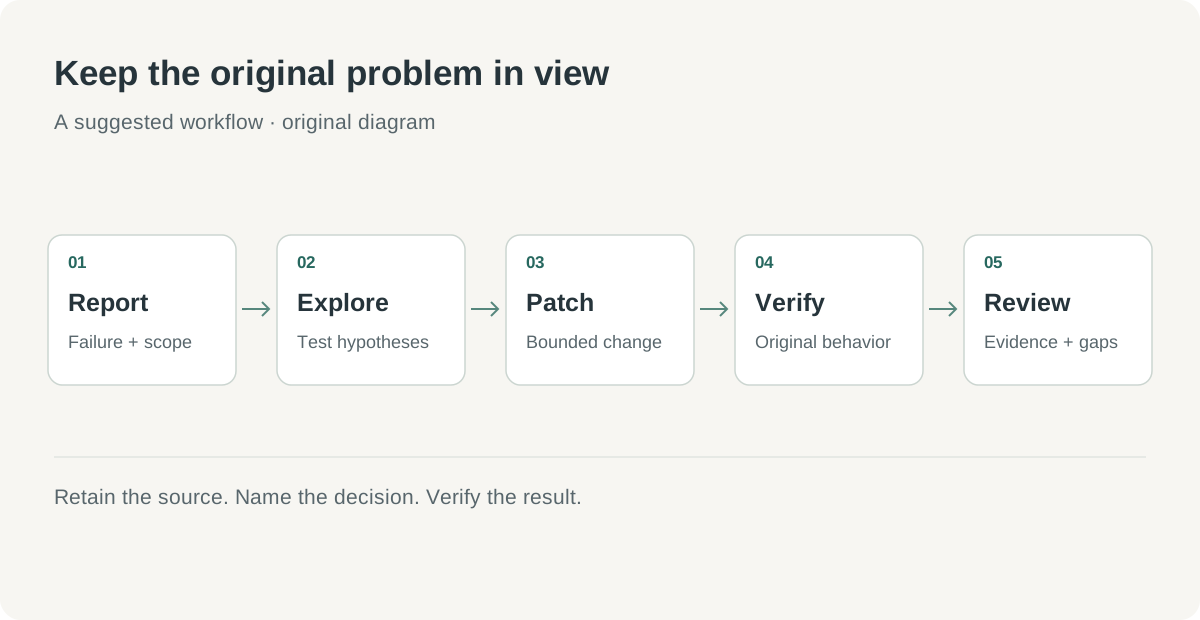 Diagrama original: el trabajo sostenido debe producir una reparación trazable, conservando el criterio de aceptación original durante la exploración.
Las comparaciones de Carbon describen trabajos de distinta naturaleza
La comparación de modelos de Google DeepMind, consultada el 2 de noviembre, muestra Carbon y Argon en varias evaluaciones. Por ejemplo, publica 65.2% frente a 57.1% en Terminal-Bench 4.0 y 61.2% frente a 55.0% en FrontierSWE 2. Son resultados con nombres y condiciones distintos; no deben sumarse en una tasa única de éxito del producto.
Un equipo debería empezar por la tarea que se parece a su trabajo. Interacción con terminal, reparación de repositorios y navegación web exigen cosas distintas. Un modelo que destaca en una evaluación puede necesitar otras herramientas o más contexto humano en producción. La comparación ayuda a elegir un experimento; el comportamiento del repositorio determina si funciona.
| Pregunta de evaluación | Evidencia que buscar en el piloto | Qué deja abierto una puntuación aislada |
|---|---|---|
| ¿Encuentra una causa? | Reproducción y explicación causal sustentada | Si el fallo del equipo está representado |
| ¿Repara el comportamiento? | Cambio centrado y comprobación de regresión | Si siguen intactos contratos de integración ocultos |
| ¿Usa responsablemente las herramientas? | Permisos claros y acciones inspeccionables | Si la configuración real coincide con la evaluada |
| ¿Puede revisarlo otro ingeniero? | Diferencias concisas, resultados y carencias | Cuánto esfuerzo exigen los estándares del equipo |
| ¿Puede detenerse y continuar? | Estado conservado y traspaso accionable | Si el sistema de agentes conserva lo necesario |
La tabla es un marco de evaluación, no una reproducción de la metodología de Google. Convierte una afirmación general en preguntas respondibles. Un resultado local sólido debe incluir fallos y bloqueos para entender dónde ayuda el modelo y dónde necesita trabajo el proceso que lo rodea.
Comparar exige también una referencia estable. Mantén iguales revisión del repositorio, permisos, enunciado y entorno al comparar configuraciones. Si una ejecución recibe la reproducción y otra debe descubrirla, la diferencia de tiempo no aísla al modelo. Registra condiciones antes de interpretar resultados.
La ciberdefensa necesita una cadena del hallazgo a la reparación verificada
El anuncio del 28 de octubre publica 88.2% en SEC-bench Pro, 54.8% en ExploitGym y 71.0% en CWE-bench, e indica que estas evaluaciones con pruebas externas se realizaron sin salvaguardas. Las cifras abordan tareas distintas de detección, validación y reparación de vulnerabilidades. El anuncio de Google es la fuente de esos resultados publicados por el proveedor.
Para un defensor, la secuencia útil empieza con un objetivo autorizado y un hallazgo inspeccionable. La validación debe establecer el riesgo relevante en el entorno acordado. La reparación debe abordar la causa conservando el comportamiento legítimo. Cada etapa exige evidencia diferente aunque un agente ayude en todas.
Una revisión ilustrativa de una biblioteca interna aclara la diferencia. El equipo entrega una copia aislada y una preocupación definida sobre tratamiento de entradas. Busca un hallazgo específico, una reproducción acotada en pruebas y un parche con cobertura de regresión. El agente no debe ampliar el encargo a sistemas ajenos por encontrar enlaces o credenciales en el proyecto.
Otro escenario ilustrativo es clasificar un informe existente. El agente ayuda a vincularlo con rutas de código y determinar qué pruebas distinguen un problema real de una suposición incorrecta. Concluir «no necesita reparación» también exige evidencia. Cerrar un informe con una explicación segura vale menos que demostrar por qué la ruta denunciada no se aplica a esa revisión.
El responsable final sigue siendo el equipo de ingeniería o seguridad del sistema. Un parche debe revisarse respecto al límite real del servicio, el despliegue y la compatibilidad. Las pruebas aisladas satisfactorias son una parte de la decisión; publicación y supervisión de producción siguen siendo pasos separados.
La seguridad del modelo no define sus permisos de despliegue
Google describe mejoras de alineamiento, resistencia a inyección de instrucciones y reducción de afirmaciones sin fundamento. Son aspectos relevantes para trabajar con ambigüedad. Operativamente, deben evaluarse en el proceso previsto, sin tratar un titular de seguridad como permiso para conectar todas las herramientas.
El trabajo largo se beneficia de autoridad gradual. Leer un repositorio, modificar una copia aislada y desplegar un servicio son acciones distintas. Puede permitirse reunir evidencia y preparar un cambio revisable manteniendo una aprobación separada para publicar o afectar a producción. El entorno debe imponer el límite además de describirlo en la tarea.
El material no fiable plantea otra cuestión. Un archivo, una incidencia o una página puede contener instrucciones contrarias al encargo. El sistema debería separar la autoridad de la tarea del contenido leído. La evidencia de revisión debe mostrar cambios inesperados de alcance, especialmente tras tanto tiempo que nadie observa cada acción.
Lo mismo vale para las credenciales. Da solo el acceso necesario y prefiere un entorno donde una acción accidental tenga efectos acotados. El piloto puede establecer si el modelo pide contexto ausente y deja un bloqueo honesto. Importa tanto como cuántos archivos modifica antes de parar.
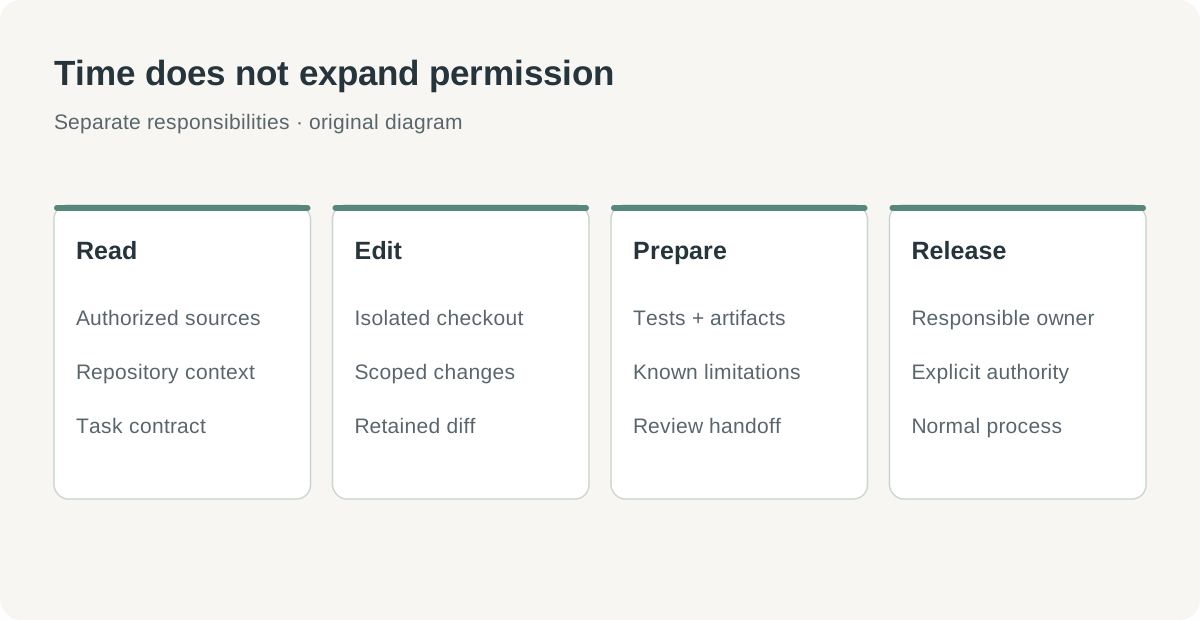 Diagrama original: ejecutar más tiempo no amplía automáticamente los permisos. Cada etapa tiene un responsable y una condición de finalización distintos.
El acceso gradual deja primero una tarea de preparación para muchos equipos
El lanzamiento describe acceso para ciberdefensores seleccionados, después más socios de confianza de Fairwind, y más adelante superficies generales para desarrolladores, empresas y consumidores. Anunciar un modelo y ofrecerlo ampliamente son hechos separados. Comprueba el acceso vigente por canales oficiales antes de comprometer una entrega basada en Carbon. Anuncio del 28 de octubre, consultado el 2 de noviembre de 2026.
Sin acceso también puede prepararse trabajo útil. Elige una tarea difícil pero acotada, conserva la revisión relevante y reúne la evidencia que hoy la complica. Define pruebas y expectativas del revisor. Será reutilizable cuando llegue el acceso y permite comparar mejor las herramientas actuales.
No conviertas la preparación en promesa de finalización desatendida. Una buena tarea puede revelar infraestructura de pruebas ausente, responsables poco claros o reproducción inestable antes de ejecutar ningún modelo nuevo. Arreglar eso mejora la ingeniería con independencia del modelo que explore después.
Un tercer uso ilustrativo es un defecto entre capas. El estado del frontend parece correcto mientras el servidor guarda otro valor. La tarea puede exigir seguir petición, persistencia e interfaz actualizada de extremo a extremo y aplicar una reparación pequeña. El valor del razonamiento sostenido es conectar esas capas al investigar, no solo generar más código en cada una.
El coste de una tarea larga incluye revisión y recuperación
Los precios publicados de tokens son solo parte del trabajo. Herramientas, contexto repetido, infraestructura de pruebas y revisión humana contribuyen al coste real. Un parche legible y bien fundamentado puede valer más que una ejecución barata que deje horas de incertidumbre al revisor.
En el primer piloto, fija límites de gasto y tiempo en el sistema cuando sea posible. Decide qué evidencia debe producirse antes de ampliarlos. Una tarea estancada debe dejar un punto útil: último hecho confirmado, hipótesis restante más sólida y siguiente prueba. Así continuar se decide por progreso, no por esperanza.
La carga de revisión también se mide. Comprueba si un compañero entiende la causa, inspecciona los cambios y reproduce las pruebas sin revivir toda la sesión. Si no, mejora el formato de entrega antes de ampliar autoridad. Una tarea larga debería reducir incertidumbre, no trasladarla a un documento más largo.
Empieza por una reparación con una meta clara
- Confirma la vía de acceso y el modelo exacto ofrecido. Distingue el despliegue anunciado de Carbon del acceso a otro Gemini.
- Selecciona una tarea autorizada y aislada con revisión estable y fallo reproducible. Evita depender de producción no controlada en la primera evaluación.
- Escribe el criterio en términos de comportamiento visible o del sistema. Incluye contratos que deben conservarse y acciones externas que requieren aprobación.
- Aporta herramientas y permisos mínimos. Conserva cambios, registros y pruebas donde otro ingeniero pueda inspeccionarlos.
- Exige puntos de control que distingan evidencia confirmada, hipótesis y bloqueos. Revísalos antes de ampliar alcance o presupuesto.
- Evalúa la reparación frente al fallo original y las pruebas de regresión afectadas. Busca cambios ajenos y migraciones ocultas de contratos.
- Deja que un revisor responsable decida si el parche está listo para el proceso normal de publicación. Registra explícitamente comprobaciones incompletas y verificación externa requerida.
Incluye una condición incómoda deliberada, como una prueba ajena fallida o un servicio opcional no disponible. Observa si la entrega separa esa limitación de la evidencia real de reparación. Un modelo que informa honestamente de una carencia se integra mejor que uno que convierte toda incertidumbre en finalización.
Un agente de varios días debería acortar el camino hacia una decisión
El anuncio de Carbon apunta a otra expectativa para la IA de programación: persistir a través de callejones sin salida y producir una reparación digna de revisión. La ingeniería que lo rodea debe hacer útil esa persistencia. Alcance claro, evidencia conservada y autoridad acotada dan una tarea que puede terminar con sentido.
Esperamos que las mejores evaluaciones se centren en la calidad del traspaso. ¿Conservó la pregunta original? ¿Identificó qué falló realmente? ¿Puede un ingeniero verificar el resultado y decidir el siguiente paso? Esas preguntas conectan una ejecución larga con un resultado práctico.
La promesa de una IA que trabaja más tiempo es un camino más corto desde un informe difícil hasta una decisión justificada. El tiempo invertido aporta valor cuando la siguiente persona puede confiar en lo que queda.
Fuentes
- Google: presentación de Gemini 4 Carbon, 28 de octubre de 2026; consultado el 2 de noviembre de 2026. Observaciones internas y resultados comparativos se atribuyen a Google.
- Google DeepMind: comparación de modelos Gemini, consultada el 2 de noviembre de 2026. Versiones y condiciones de las pruebas deben acompañar sus puntuaciones.
Mantén una decisión de ingeniería vinculada a su fuente
Telli.sh es una opción para conservar material autorizado y las notas que sustentan una decisión de ingeniería. Crea un espacio de notas.