Google migliora la traduzione in tempo reale, OpenAI apre la voce full-duplex: cosa resta dopo la conversazione?
GPT-Live-1 arriva nelle API a 0,05 dollari al minuto di voce, tre mesi dopo la traduzione vocale in tempo reale di Google in 70 lingue. Cosa misurano i prezzi e i benchmark pubblicati, cosa non misurano e perché verbali, idee condivise e fonti salvate contano di più man mano che conversare diventa più facile.
Un'illustrazione concettuale originale. Una conversazione più naturale e una registrazione utile di tale conversazione sono obiettivi di progettazione complementari, non fasi misurate del rilascio di un prodotto.
La possibilità più incoraggiante degli ultimi annunci sull’AI vocale è molto concreta: completare un pensiero nella propria lingua, precisarlo mentre si parla e sentirsi parte della conversazione. Meno attesa per la traduzione, meno frasi da provare mentalmente prima di intervenire. Rimane più attenzione per ciò che l’altra persona intende davvero.
Google ha introdotto Gemini 3.5 Live Translate il 9 giugno 2026. OpenAI ha introdotto i suoi modelli full-duplex GPT-Live in ChatGPT l'8 luglio, quindi ha rilasciato GPT-Live-1 nell'API il 10 settembre. Si tratta di prodotti diversi che servono scopi diversi, ma la sequenza punta verso qualcosa di più interazione parlata continua. L'ultimo annuncio OpenAI estende l'accesso agli sviluppatori; non è la prima apparizione di GPT-Live. Annuncio di giugno di Google, Introduzione di luglio di OpenAI, Versione API di settembre di OpenAI.
A mio avviso, questi progressi avvicinano un quotidiano con meno barriere linguistiche. Rendono però più importante un’altra domanda: quando conversare diventa più facile, come conserviamo ciò che ha dato valore al dialogo? Verbali, idee condivise e materiali di riferimento sono parte della risposta.
La voce full-duplex cambia l’attesa durante il dialogo
Full-duplex significa che un sistema può ascoltare e parlare allo stesso tempo. OpenAI descrive GPT-Live-1 in questo modo nella documentazione del modello attuale, insieme alla capacità di delegare il ragionamento e l'utilizzo dello strumento a un agente backend. Questa è una dichiarazione sull'interazione simultanea, non un certificato di traduzione perfetta. Documentazione del modello GPT-Live-1, verificata l'11 settembre 2026.
Immagina di correggere un assistente mentre spiega un piano: “In realtà il cliente è a Madrid, non a Città del Messico”. Un'interfaccia parlata utile deve notare tale correzione prima di proseguire con il presupposto sbagliato. Bisogna anche distinguere una correzione da un breve riconoscimento, o una pausa di riflessione da un invito a subentrare. La qualità dello scambio dipende da questi piccoli giudizi.
Le interfacce vocali più vecchie spesso rendevano evidente la struttura dei turni. Hai parlato, hai aspettato l'elaborazione, hai ascoltato e poi hai riprovato. Un'elaborazione più rapida aiuta, ma un'interazione può comunque sembrare imbarazzante quando il sistema sospetta che tu abbia finito troppo presto. Il design full-duplex affronta la sovrapposizione stessa, invece di trattare ogni momento del discorso come un messaggio ben chiuso.
Esiste già un segnale concreto, anche se limitato, del motivo per cui ciò è importante. OpenAI riferisce che la società di apprendimento linguistico Speak ha riscontrato quasi l'80% in meno di interruzioni durante le pause di pensiero degli studenti nelle prime valutazioni rispetto ai precedenti sistemi a turni. Si tratta di un risultato del partner riportato dal fornitore, non di un risultato indipendente per ogni lingua o impostazione. Misura il comportamento di interruzione, non un miglioramento dell'80% nella precisione della traduzione. Rapporto sul lancio dell'API di OpenAI, 10 settembre 2026.
Gli altri numeri di OpenAI vanno nella stessa direzione e hanno lo stesso limite. Secondo OpenAI, GPT-Live-1 ottiene 30 punti percentuali in più di GPT-Realtime-2.1 su Full Duplex Bench, un test su pause, alternanza dei turni, interruzioni e segnali di ascolto (backchannel). Abbinato a GPT-6 Astra con uno sforzo di ragionamento medio, si classifica primo su Tau3, che valuta con Pass@1 attività vocali di assistenza clienti e bancarie, tra cui 97 attività di conoscenza bancaria. Entrambe sono valutazioni interne di OpenAI sul comportamento conversazionale e sul completamento delle attività; nessuna delle due è un punteggio di accuratezza della traduzione. Sintesi delle valutazioni di OpenAI, 10 settembre 2026.
Per qualcuno che parla una seconda lingua, una pausa di riflessione può essere esattamente il momento in cui la partecipazione diventa difficile. Un assistente che aspetta opportunamente lascia spazio per trovare una parola. Un assistente che accetta una correzione rende meno costoso il tentativo. Questi sono motivi pratici per essere entusiasti dell'interazione vocale naturale al di là di quanto sia impressionante una dimostrazione.
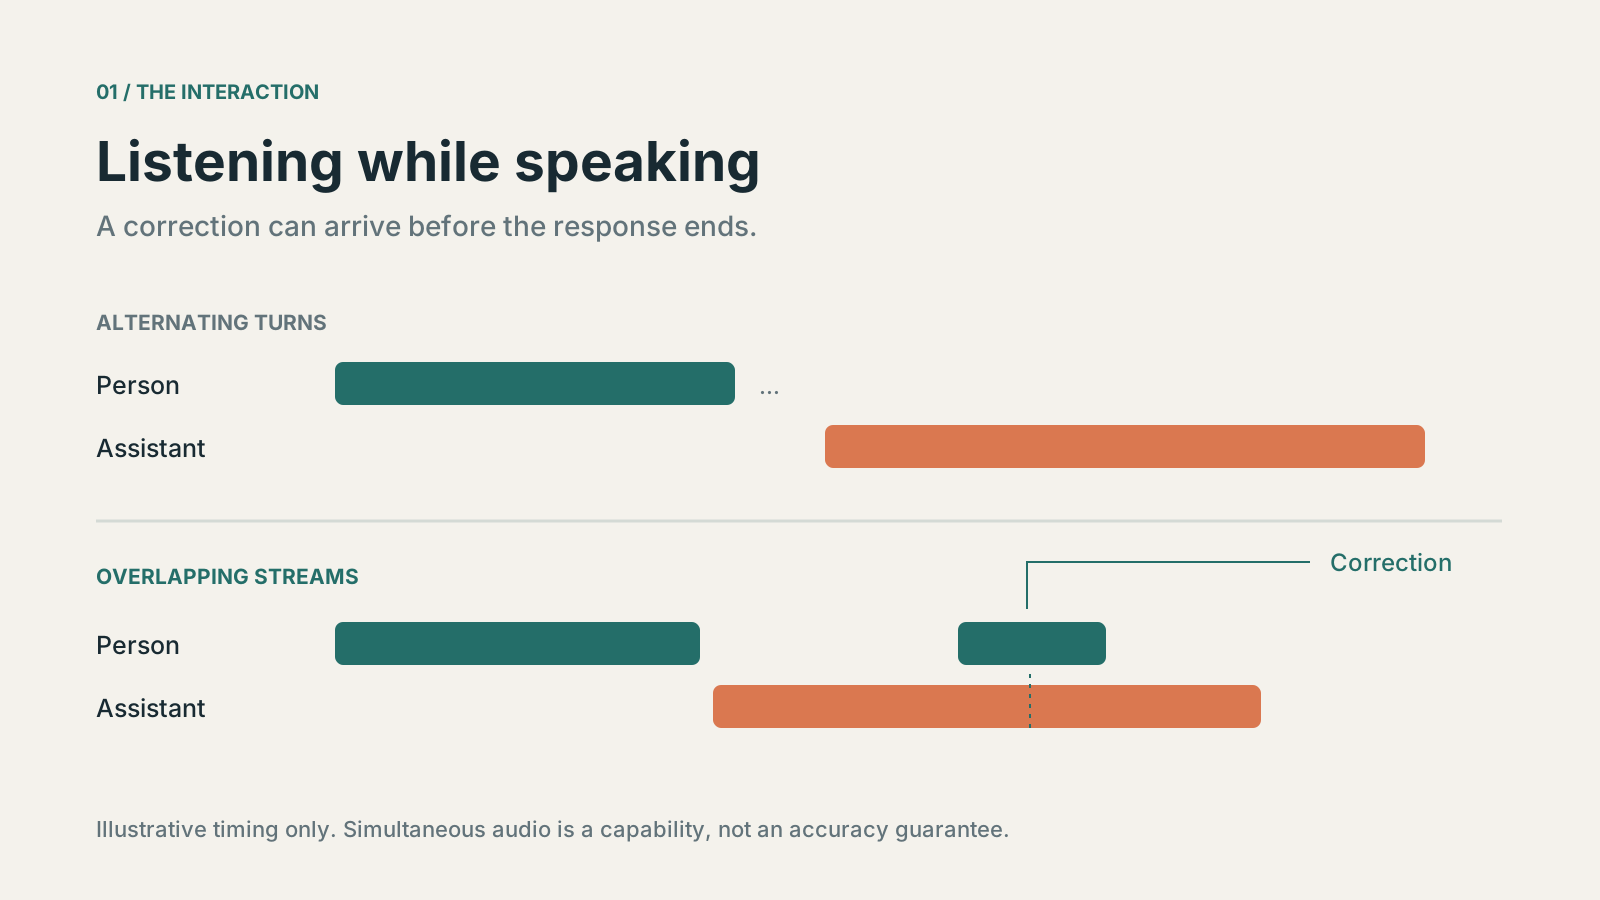
Solo tempistica concettuale; le barre non rappresentano la latenza misurata. Il full duplex descrive input e output simultanei, mentre la gestione utile delle interruzioni dipende ancora dal modello e dall'applicazione.
Tradurre in tempo reale e conversare sono compiti diversi
L'annuncio di giugno di Google descrive la traduzione vocale continua in più di 70 lingue. Il modello genera un discorso tradotto durante l'ascolto, bilanciando la necessità di più contesto con lo stare vicino a chi parla. Google afferma che rimane indietro di qualche secondo, il che è un'aspettativa più utile che immaginare un ritardo zero. La versione per sviluppatori era un'anteprima pubblica. Descrizione del lancio di Google, 9 giugno 2026.
I dati di scala contenuti in quell'annuncio sono precisi. La traduzione vocale di Google Meet passerà da cinque lingue supportate a oltre 70, e dalla sola traduzione da e verso l'inglese a oltre 2.000 combinazioni linguistiche in una stessa riunione. Parte come anteprima privata per alcuni clienti business di Workspace, con un'estensione più ampia nel corso del 2026. Grab sta testando il modello per l'incontro tra autisti e viaggiatori al momento del ritiro, un caso d'uso con oltre 10 milioni di chiamate vocali al mese. L'annuncio riporta gli elogi dei partner per qualità, accuratezza e bassa latenza, senza pubblicare un punteggio numerico. Dati del lancio di Google, 9 giugno 2026.
C'è una distinzione che vale la pena mantenere visibile. La guida alla traduzione dal vivo di Google descrive un interprete che elabora continuamente un flusso audio, con impostazioni specifiche della traduzione e nessun supporto per strumenti o istruzioni generali. GPT-Live-1 è un modello conversazionale che può funzionare con un agente separato. Uno aiuta a trasportare il significato di chi parla in un'altra lingua; l'altro partecipa allo scambio. Non dovrebbero essere presentati come servizi intercambiabili. Guida alla traduzione dal vivo di Google, Documentazione del modello di OpenAI, controllato l'11 settembre 2026.
| Pietra miliare | Cosa è stato annunciato | Cosa non stabilisce |
|---|---|---|
| Google, 9 giugno 2026 | Gemini 3.5 Live Translate; traduzione vocale continua; anteprima pubblica per gli sviluppatori | Uguale qualità per ogni coppia linguistica o accesso immediato in ogni prodotto Google |
| OpenAI, 8 luglio 2026 | GPT-Live implementato in ChatGPT, con ascolto e conversazione simultanei | Precisione universale a livello di interprete |
| OpenAI, 10 settembre 2026 | GPT-Live-1 Accesso API per la creazione di applicazioni vocali | Integrazione automatica in ogni servizio di riunione o presa di appunti |
L'ambito del rilascio deriva dai tre annunci collegati sopra. Questa è una sequenza temporale, non una classifica delle prestazioni.
Nel loro insieme, questi sviluppi rendono visibile una direzione convincente: la traduzione può diventare più continua e l'interazione con un assistente può diventare meno rigida. Collegare queste funzionalità a un'esperienza di riunione multilingue affidabile rimane un lavoro applicativo. Qualcuno deve ancora decidere quale audio viene interpretato, dove va il risultato, come vengono gestite le correzioni e cosa vedono i partecipanti.
I numeri pubblicati: 0,05 dollari al minuto e nessun punteggio di accuratezza
Un minuto di voce con GPT-Live-1 costa 0,05 dollari nell'API, con fatturazione al secondo e senza arrotondamento al minuto intero. Il prezzo copre solo il livello vocale di front-end; il modello di backend e gli strumenti a cui una sessione delega il lavoro sono fatturati a parte, alle tariffe normali. Documentazione del modello di OpenAI, verificata l'11 settembre 2026.
Il calcolo è facile da fare e facile da fraintendere. Una sessione di 30 minuti costa 1,50 dollari di livello vocale, un'ora 3,00 dollari e 100 ore al mese arrivano a 300 dollari, prima di qualsiasi ragionamento di backend. Un'applicazione che assegna una sessione separata a ogni partecipante della riunione moltiplica queste cifre per il numero di sessioni. L'annuncio di giugno di Google non indica alcun prezzo per Gemini 3.5 Live Translate, quindi questo articolo non confronta i due sul costo.
| Dato | Valore | Fonte e data | Cosa misura |
|---|---|---|---|
| Prezzo API di GPT-Live-1 | 0,05 dollari al minuto, fatturati al secondo | OpenAI, 10 settembre 2026 | Solo livello vocale; modello di backend e strumenti fatturati a parte |
| Full Duplex Bench | +30 punti percentuali rispetto a GPT-Realtime-2.1 | OpenAI, 10 settembre 2026 | Pause, alternanza dei turni e interruzioni, non la traduzione |
| Tau3 | Primo posto, con GPT-6 Astra (medio) | OpenAI, 10 settembre 2026 | Successo nelle attività vocali (Pass@1), incluse 97 attività bancarie |
| Prima valutazione di Speak | Quasi l'80% in meno di interruzioni nelle pause di riflessione | OpenAI (citazione di un partner), 10 settembre 2026 | Comportamento di interruzione rispetto ai precedenti sistemi a turni |
| Uso della voce in ChatGPT | Oltre 150 milioni di persone a settimana | OpenAI, 8 luglio 2026 | Uso di voce e dettatura, non qualità |
| Gemini 3.5 Live Translate | 70+ lingue, rilevate automaticamente | Google, 9 giugno 2026 | Copertura, non qualità per coppia linguistica |
| Traduzione vocale in Google Meet | 5 → 70+ lingue; oltre 2.000 combinazioni per riunione | Google, 9 giugno 2026 | Aggiornamento previsto, prima in anteprima privata |
| Ritardo della traduzione | “Solo pochi secondi dietro a chi parla” | Google, 9 giugno 2026 | Descrizione del fornitore, non un valore misurato |
Tutti i dati sono dichiarati dai fornitori e provengono dagli annunci e dalla documentazione collegati in questo articolo. Nessuno è un punteggio numerico di accuratezza della traduzione, come una valutazione umana o una metrica automatica per una coppia linguistica.
Questa lacuna conta soprattutto per chi sceglie uno strumento per riunioni multilingue. I benchmark di interazione dicono se un sistema sa aspettare, ascoltare e riprendersi bene; non dicono se “lunedì” è rimasto lunedì una volta arrivato in coreano. L'avvertenza di luglio di OpenAI sugli accenti non madrelingua in alcune lingue e l'assenza di punteggi per coppia linguistica da parte di Google portano alla stessa regola pratica: prova le coppie linguistiche che il tuo team usa davvero prima di affidarti all'uno o all'altro per prendere decisioni.
Ridurre la barriera linguistica aiuta a prendere la parola
Considera un ipotetico incontro di progetto di 30 minuti con quattro persone che si sentono più a loro agio in tre lingue diverse. Il vantaggio di una migliore traduzione parlata non è semplicemente che ogni persona sente più parole. Il punto è che il gruppo può porre domande di follow-up prima che un'incertezza diventi un malinteso. Un'idea provvisoria può essere espressa senza prima essere perfezionata in una seconda lingua.
Ciò cambia l’economia della partecipazione in un senso molto comune: contribuire richiede meno sforzo. La persona tranquilla con esperienza rilevante ha un altro modo per entrare nella discussione. Chi conduce l'incontro può dedicare meno tempo alla ricostruzione di una frase interrotta. Un chiarimento può avvenire quando è utile, mentre tutti ricordano ancora il punto in discussione.
Mi aspetto che questo sia importante nei team remoti, nelle discussioni in classe, nelle conversazioni con i clienti e negli scambi informali durante i viaggi. Queste sono aspettative su dove la tecnologia può aiutare, non affermazioni secondo cui la stessa esperienza è già disponibile per tutti. La combinazione linguistica, l'accento, il vocabolario, la qualità del microfono e il prodotto circostante rimangono tutti parte del risultato.
La naturalezza della voce va valutata separatamente dalla precisione del significato. Nella presentazione di luglio, OpenAI segnalava accenti non madrelingua o limiti di fluidità in alcune lingue. Occorre quindi provare quelle effettivamente usate, senza generalizzare da una dimostrazione ben riuscita in inglese. Era una precisazione relativa al lancio, non una valutazione aggiornata di tutti gli utilizzi di settembre. Introduzione e avvertenza sulla lingua di OpenAI GPT-Live, 8 luglio 2026
La giusta ambizione è una partecipazione più ampia con un modo semplice per chiarire. Una data, un importo, il nome di una persona o una promessa condizionale dovrebbero rimanere facili da controllare. Un sistema può sembrare sicuro mentre un partecipante deve ancora dire: “Per favore, mostrami quella frase”. Mostrare il testo e conservare l'originale, dove i partecipanti hanno accettato di registrarlo, dà a quella richiesta un posto dove andare.
Anche una riunione scorrevole deve lasciare traccia delle decisioni
Torniamo alla riunione ipotetica. Qualcuno propone di pubblicare venerdì, a condizione che la verifica di sicurezza sia conclusa. Un’altra persona preferisce lunedì per lasciare più tempo al team di assistenza. Il gruppo sceglie lunedì e nomina un responsabile, ma un prerequisito rimane irrisolto. Un riassunto che conserva soltanto il venerdì inizialmente proposto perde la decisione della riunione.
Nessun miglioramento nel ritmo della conversazione elimina la differenza tra un suggerimento, una condizione e una decisione. Le persone che lavorano nella stessa lingua devono già distinguerle. L'interazione multilingue rende più prezioso preservare il percorso dalla dichiarazione originale alla formulazione tradotta e all'azione finale concordata.
Per un resoconto pratico dell'incontro, vorrei che un lettore che ha perso la chiamata trovasse rapidamente tre cose: cosa ha deciso il gruppo, chi è responsabile del passaggio successivo e quali domande rimangono aperte. Una scadenza dovrebbe essere descritta come concordata solo quando è stata concordata. Se la fonte non è chiara, la documentazione dovrebbe portare avanti tale incertezza invece di ridurla a una falsa conclusione.
Ciò non richiede di trasformare ogni conversazione in un archivio esaustivo. Una breve nota decisionale può essere più utile di pagine di trascrizione indifferenziata. La relazione importante è tra il resoconto conciso e il materiale di supporto: la formulazione originale pertinente, la registrazione quando disponibile e autorizzata e il documento che il gruppo stava discutendo.
Questo collegamento facilita anche le correzioni. Un partecipante può indicare la frase originale, rettificare il riassunto e condividere la decisione corretta. Senza quel legame, la persona successiva potrebbe riassumere il riassunto e trasformare il malinteso iniziale in un fatto apparentemente certo. Un’interazione vocale migliore facilita il dialogo; buoni documenti permettono di verificarne l’esito in seguito.
Le idee condivise hanno bisogno delle loro fonti
Un'idea utile raramente inizia e finisce all'interno di una chiamata. Qualcuno trova un articolo, salva un passaggio, pone una domanda al riguardo e porta la domanda a una riunione. Un'altra persona aggiunge un controesempio tratto da un video o da un articolo di ricerca. Il passo successivo dipende dalla capacità di ricollegare questi pezzi una volta terminata la conversazione.
Ecco perché salvare fonti dal web resta utile anche con un’ottima AI vocale. L’URL consente di ritrovare l’originale, il brano selezionato indica la parte rilevante e una nota personale spiega perché è stata conservata. Sono informazioni con funzioni diverse. Insieme comunicano un’idea meglio di un paragrafo isolato generato dall’AI.
«Dovremmo cambiare l’accoglienza dei nuovi utenti» offre poco a chi riprende il lavoro. «Questo articolo ci ha fatto riflettere sui primi cinque minuti; ecco il passaggio, la nostra discussione e l’esperimento concordato» fornisce invece elementi da esaminare. L’esempio è ipotetico, ma la differenza è concreta: la sola conclusione chiede fiducia; il ragionamento e la fonte consentono di proseguire il confronto.
La stessa disciplina protegge la fonte dall'essere confusa nel commento. Una citazione dovrebbe rimanere identificabile come citazione. Una traduzione è un'interpretazione di quella fonte e un riepilogo della riunione è un'altra vista derivata. Mantenere visibili questi ruoli consente alle persone di dissentire in modo produttivo senza dover prima ricostruire ciò che qualcuno ha detto originariamente.
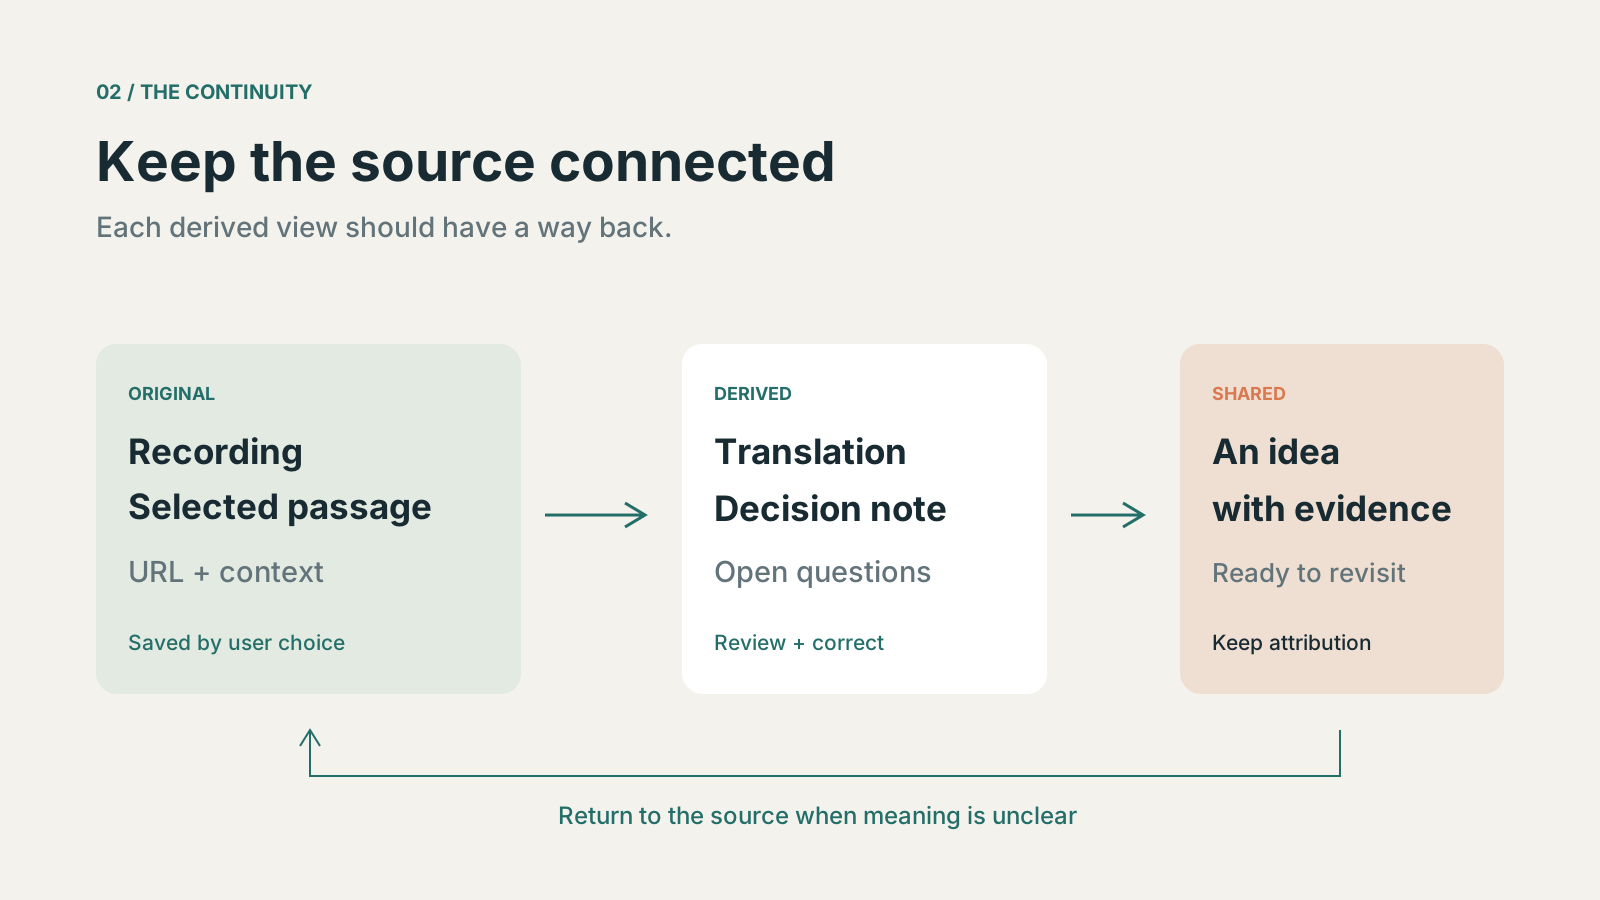
Un flusso di lavoro proposto originale. Conserva il materiale di origine autorizzato, rendi correggibile il testo derivato e mantieni visibile la connessione durante la condivisione. Il diagramma non afferma che oggi ogni collegamento sia una funzionalità automatizzata.
Il contesto deve restare disponibile dopo la chiamata
I sistemi vocali stanno inoltre iniziando a separare la conversazione dal lavoro che si svolge dietro di essa. La documentazione della delega di OpenAI spiega che il discorso dal vivo e il lavoro delegato possono continuare in modo indipendente; una risposta del backend completata non stabilisce che l'utente abbia ascoltato la risposta. Questo è un utile promemoria ingegneristico di un problema di prodotto più ampio: un'esperienza parlata e un risultato duraturo sono cose separate da verificare. Documentazione della delegazione di OpenAI, verificata l'11 settembre 2026.
Per gli utenti comuni la domanda è più semplice. Al termine di una chiamata, posso trovare la decisione domani? Un collega può capire perché l'abbiamo realizzato? Posso tornare all'articolo che ha messo in discussione la nostra ipotesi, senza cercare nella cronologia chat, in un browser e in una registrazione? Queste domande rimangono anche se ogni frase viene interpretata magnificamente.
C'è motivo di essere ottimisti riguardo al fatto che le barriere linguistiche diventeranno meno dominanti. Dovremmo accogliere con favore strumenti che consentano a più persone di contribuire comodamente. La mia aspettativa è che una conversazione più semplice aumenterà il valore di collegare ciò che diciamo a ciò che conserviamo, condividiamo e alla fine facciamo. L'incontro non deve vivere per sempre; il suo risultato utile dovrebbe sopravvivere alla chiamata.
La direzione che vogliamo dare a Telli.sh
Per Telli.sh, questa è la direzione: trasformare conversazioni e scoperte in conoscenze da ritrovare e usare. Oggi il prodotto raccoglie note, registrazioni, traduzioni e Clip in un unico spazio. Vogliamo rafforzare i collegamenti tra questi materiali, evitando che il verbale, l’idea e la sua fonte tornino a disperdersi.
Il percorso dovrebbe essere continuo: registrare una conversazione con il consenso necessario, verificarne i punti importanti, rendere comprensibili le decisioni e condividere un’idea insieme alle sue fonti. Quando la discussione nasce da una pagina web, Clip deve aiutare a conservare l’URL e il contesto scelto dall’utente. Quando una traduzione aiuta a capire, l’originale deve restare disponibile per il confronto e le correzioni.
È una direzione di prodotto: non stiamo annunciando che Telli.sh abbia già integrato GPT-Live-1 o Gemini 3.5 Live Translate. Le future funzioni vocali dovranno offrire utilità concreta tra lingue diverse, documentazione affidabile e controllo chiaro su ciò che viene salvato. I progressi dei modelli dovranno migliorare lo spazio di lavoro senza rendere la conoscenza personale dipendente da un solo modello.
Più diventa facile parlare tra lingue diverse, più vogliamo aiutare a conservare il valore di quelle conversazioni. Si può iniziare da una riunione da ricordare, un’idea da condividere o una fonte che servirà di nuovo.