Google fait avancer la traduction en direct, OpenAI ouvre la voix en duplex intégral : et après la conversation ?
GPT-Live-1 arrive dans l’API à 0,05 $ la minute de voix, trois mois après la traduction vocale en direct de Google dans 70 langues. Ce que mesurent les prix et benchmarks publiés, ce qu’ils ne mesurent pas, et pourquoi comptes rendus, idées partagées et sources conservées comptent davantage à mesure que la conversation devient plus facile.
Une illustration conceptuelle originale. Une conversation plus naturelle et un enregistrement utile de cette conversation sont des objectifs de conception complémentaires, et non des étapes mesurées d'une sortie de produit.
Ce qui me réjouit dans les dernières annonces sur l’IA vocale tient à une possibilité toute simple : aller au bout d’une pensée dans sa langue, la préciser en cours de route et participer naturellement à la conversation. Moins attendre la traduction. Moins répéter une phrase dans sa tête avant d’oser intervenir. Et davantage d’attention pour ce que l’autre veut vraiment dire.
Google a introduit Gemini 3.5 Live Translate le 9 juin 2026. OpenAI a présenté ses modèles GPT-Live en duplex intégral dans ChatGPT le 8 juillet, puis a publié GPT-Live-1 dans l'API le 10 septembre. Ce sont des produits différents servant des objectifs différents, mais la séquence pointe vers une interaction orale plus continue. La dernière annonce OpenAI étend l'accès aux développeurs ; ce n'est pas la première apparition du GPT-Live. Annonce de juin de Google, Introduction de juillet d’OpenAI, Version de l'API de septembre d’OpenAI.
J’y vois un pas vers un quotidien où les barrières linguistiques pèsent moins. Une autre question devient alors essentielle : une fois la conversation plus facile, comment en conserver ce qui lui donne sa valeur ? Les comptes rendus, le partage d’idées et la sauvegarde des sources font partie de la réponse.
Le duplex intégral change la manière d’attendre dans une conversation
Le duplex intégral signifie qu'un système peut écouter et parler en même temps. OpenAI décrit GPT-Live-1 de cette façon dans sa documentation de modèle actuelle, ainsi que la possibilité de déléguer le raisonnement et l'utilisation d'outils à un agent backend. Il s’agit là d’une déclaration sur l’interaction simultanée, et non d’un certificat de traduction parfaite. Documentation du modèle GPT-Live-1, vérifiée le 11 septembre 2026.
Imaginez corriger un assistant pendant qu'il explique un plan : "En fait, le client est à Madrid, pas à Mexico." Une interface vocale utile doit remarquer cette correction avant de continuer avec une mauvaise hypothèse. Il faut également distinguer une correction d’un bref accusé de réception, ou une pause pour réfléchir d’une invitation à prendre le relais. La qualité de l'échange dépend de ces petits jugements.
Les interfaces vocales plus anciennes faisaient souvent ressortir leur structure tour à tour. Vous avez parlé, attendu le traitement, écouté, puis réessayé. Un traitement plus rapide est utile, mais une interaction peut toujours sembler gênante lorsque le système devine que vous avez terminé trop tôt. La conception duplex intégral traite le chevauchement lui-même, plutôt que de traiter chaque instant de parole comme un message parfaitement clos.
Lors des premières évaluations rapportées par OpenAI, Speak, une entreprise d'apprentissage des langues, a constaté près de 80 % d'interruptions en moins pendant les pauses de réflexion des apprenants par rapport aux anciens systèmes au tour par tour. Ce résultat partenaire porte sur le comportement d'interruption, pas sur la précision de traduction, et peut ne pas se généraliser à toutes les langues ni à toutes les situations. Rapport de lancement de l'API d’OpenAI, 10 septembre 2026.
OpenAI rapporte que GPT-Live-1 obtient 30 points de pourcentage de plus que GPT-Realtime-2.1 sur Full Duplex Bench, qui évalue les pauses, les tours de parole, les interruptions et les signaux d’écoute (backchannels). Associé à GPT-6 Astra avec un effort de raisonnement moyen, GPT-Live-1 se classe premier sur Tau3 pour les tâches orales de service client et de banque, dont 97 tâches de connaissances bancaires. Ces évaluations du fournisseur mesurent le comportement conversationnel et la réalisation de tâches, pas la précision de traduction. Synthèse des évaluations d’OpenAI, 10 septembre 2026.
Pour quelqu'un qui parle une langue seconde, une pause de réflexion peut être exactement le moment où la participation devient difficile. Un assistant qui attend convenablement laisse la place pour trouver un mot. Un assistant qui accepte une correction rend la tentative moins coûteuse. Ce sont des raisons pratiques d’être enthousiasmé par l’interaction vocale naturelle, au-delà de l’impressionnante démonstration.
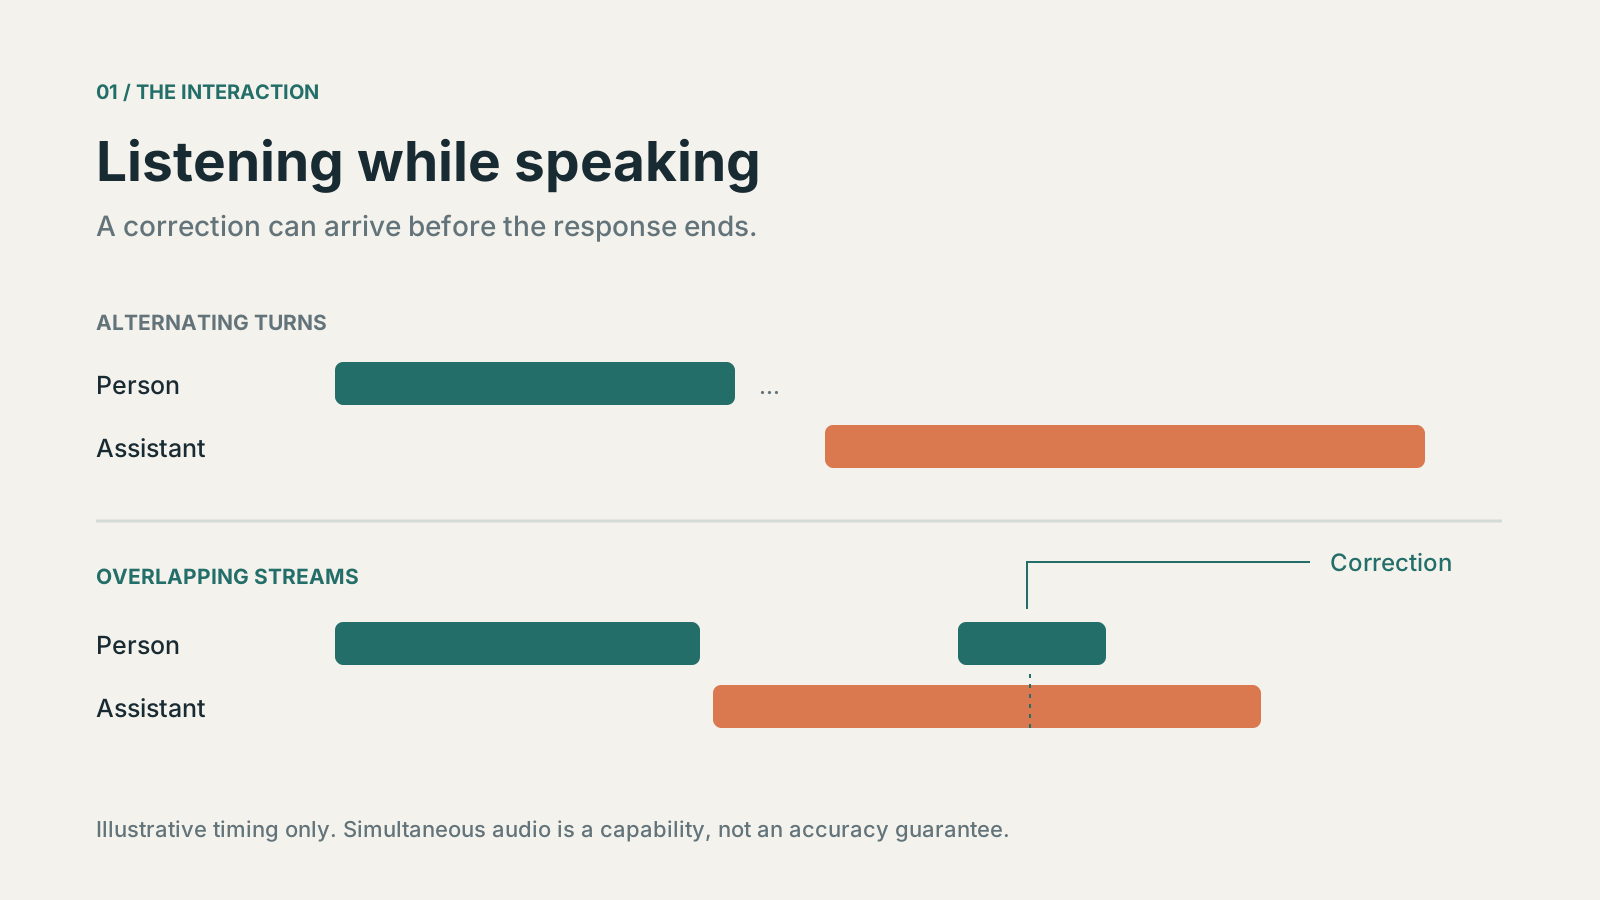
Calendrier conceptuel uniquement ; les barres ne représentent pas la latence mesurée. Le duplex intégral décrit une entrée et une sortie simultanées, tandis que la gestion utile des interruptions dépend toujours du modèle et de l'application.
Traduire en direct et participer à une conversation sont deux rôles différents
L'annonce de juin de Google décrit la traduction vocale continue dans plus de 70 langues. Le modèle génère une parole traduite pendant l'écoute, équilibrant le besoin de plus de contexte et le besoin de rester proche de l'orateur. Google indique qu'il reste quelques secondes en retard, ce qui est une attente plus utile que d'imaginer un retard nul. La version développeur était un aperçu public. Description de lancement de Google, 9 juin 2026.
Les chiffres d’échelle de cette annonce sont précis. La traduction vocale de Google Meet doit passer de cinq langues prises en charge à plus de 70, et d’une traduction limitée à l’anglais, dans un sens ou dans l’autre, à plus de 2 000 combinaisons de langues dans une même réunion. Elle démarre en aperçu privé pour certains clients professionnels de Workspace, avant un déploiement élargi dans le courant de 2026. Grab teste le modèle pour les prises en charge entre chauffeurs et voyageurs, un cas d’usage qui représente plus de 10 millions d’appels vocaux par mois. L’annonce cite des partenaires qui saluent la qualité, la précision et la faible latence, sans fournir de score chiffré pour ces mesures. Chiffres de lancement de Google, 9 juin 2026.
Il y a une distinction qui mérite de rester visible. Le guide Live Translation de Google décrit un interprète qui traite un flux audio en continu, avec des paramètres spécifiques à la traduction et aucune prise en charge d'outils ou d'instructions générales. GPT-Live-1 est un modèle conversationnel pouvant fonctionner avec un agent distinct. L'un aide à transmettre le sens d'un locuteur dans une autre langue ; l'autre participe à l'échange. Ils ne doivent pas être présentés comme des services interchangeables. Guide de traduction en direct de Google, documentation du modèle d’OpenAI, vérifié le 11 septembre 2026.
| Jalon | Ce qui a été annoncé | Disponibilité ou portée |
|---|---|---|
| Google, 9 juin 2026 | Gemini 3.5 Live Translate ; traduction continue de la parole | Aperçu public pour les développeurs lors de l'annonce ; la qualité peut varier selon la paire de langues |
| OpenAI, 8 juillet 2026 | Déploiement de GPT-Live dans ChatGPT, avec écoute et parole simultanées | Une voix conversationnelle n'est pas l'équivalent d'une traduction de niveau interprète |
| OpenAI, 10 septembre 2026 | Accès API GPT-Live-1 pour créer des applications vocales | Les développeurs doivent encore l'intégrer à leurs propres produits |
Les dates et la portée des lancements proviennent des trois annonces liées ; ces produits répondent à des usages différents et ne sont pas classés les uns par rapport aux autres.
Pris ensemble, ces développements montrent une direction convaincante : la traduction peut devenir plus continue et l'interaction avec un assistant peut devenir moins rigide. Connecter ces fonctionnalités dans une expérience de réunion multilingue fiable reste un travail d'application. Quelqu'un doit encore décider qui doit interpréter l'audio, où va le résultat, comment les corrections sont traitées et ce que voient les participants.
Les chiffres publiés : 0,05 $ la minute, et aucun score de précision
Une minute de voix avec GPT-Live-1 coûte 0,05 $ dans l’API, facturée à la seconde, sans arrondi à la minute supérieure. Ce prix ne couvre que la couche vocale frontale ; le modèle backend et les outils auxquels une session délègue des tâches sont facturés séparément, à leurs tarifs habituels. Documentation du modèle d’OpenAI, vérifiée le 11 septembre 2026.
À ce tarif, 30 minutes coûtent 1,50 $ pour la couche vocale, une heure 3,00 $ et 100 heures par mois 300 $, avant le raisonnement côté backend. Une application qui attribue une session distincte à chaque participant multiplie le total par le nombre de sessions. L'annonce de juin de Google ne donnait pas de prix pour Gemini 3.5 Live Translate ; ces montants ne constituent donc pas une comparaison des coûts.
| Indicateur | Valeur | Source et date | Ce qu’il mesure |
|---|---|---|---|
| Prix de l’API GPT-Live-1 | 0,05 $ par minute, facturé à la seconde | OpenAI, 10 septembre 2026 | Couche vocale uniquement ; modèle backend et outils facturés à part |
| Full Duplex Bench | +30 points de pourcentage par rapport à GPT-Realtime-2.1 | OpenAI, 10 septembre 2026 | Pauses, tours de parole et interruptions, pas la traduction |
| Tau3 | Premier du classement, avec GPT-6 Astra (moyen) | OpenAI, 10 septembre 2026 | Réussite de tâches orales (Pass@1), dont 97 tâches bancaires |
| Évaluation préliminaire de Speak | Près de 80 % d’interruptions en moins pendant les pauses de réflexion | OpenAI (citation d’un partenaire), 10 septembre 2026 | Comportement d’interruption par rapport aux anciens systèmes au tour par tour |
| Usage vocal de ChatGPT | Plus de 150 millions de personnes par semaine | OpenAI, 8 juillet 2026 | Usage de la voix et de la dictée, pas la qualité |
| Gemini 3.5 Live Translate | 70+ langues, détectées automatiquement | Google, 9 juin 2026 | Couverture, pas la qualité par paire de langues |
| Traduction vocale dans Google Meet | 5 → 70+ langues ; plus de 2 000 combinaisons par réunion | Google, 9 juin 2026 | Évolution prévue, d’abord en aperçu privé |
| Délai de traduction | « Juste quelques secondes derrière l’orateur » | Google, 9 juin 2026 | Description du fournisseur, pas une valeur mesurée |
Tous les chiffres sont communiqués par les fournisseurs et proviennent des annonces et de la documentation liées dans cet article. Aucun n’est un score chiffré de précision de traduction, comme une notation humaine ou une métrique automatique pour une paire de langues.
Cet écart compte surtout pour quiconque choisit un outil de réunion multilingue. Les benchmarks d’interaction indiquent si un système sait attendre, écouter et se reprendre ; ils ne disent pas si « lundi » est toujours lundi une fois arrivé en coréen. La mise en garde d’OpenAI en juillet sur les accents non natifs dans certaines langues et l’absence de scores par paire de langues chez Google mènent à la même règle pratique : testez les paires de langues que votre équipe utilise réellement avant de vous appuyer sur l’un ou l’autre pour prendre des décisions.
Réduire la barrière linguistique, c’est aussi faciliter la prise de parole
Imaginons une réunion de projet hypothétique de 30 minutes avec quatre personnes les plus à l'aise dans trois langues différentes. L’avantage d’une meilleure traduction orale ne réside pas seulement dans le fait que chaque personne entend plus de mots. Le but est que le groupe puisse poser des questions de suivi avant qu'une incertitude ne devienne un malentendu. Une idée provisoire peut être exprimée sans être au préalable transposée dans une seconde langue.
Cela change l'économie de la participation dans un sens très ordinaire : contribuer demande moins d'efforts. La personne calme ayant une expérience pertinente a une autre façon d’aborder la discussion. La personne qui dirige la réunion peut passer moins de temps à reconstituer une phrase interrompue. Une clarification peut intervenir quand elle est utile, alors que chacun se souvient encore du point discuté.
Les équipes à distance, les discussions en classe, les échanges avec des clients et les conversations informelles en voyage sont autant de situations où la traduction continue pourrait faciliter la participation. Le résultat dépend toujours de la paire de langues, de l'accent, du vocabulaire, de la qualité du microphone et du produit qui fournit la traduction.
Dans sa présentation de juillet, OpenAI signalait des difficultés liées aux accents non natifs ou à la fluidité dans certaines langues. Les équipes devraient évaluer les paires de langues et les accents qu'elles utilisent réellement, plutôt que de supposer qu'une démonstration réussie en anglais prédit leurs résultats. Présentation de GPT-Live par OpenAI, 8 juillet 2026
La bonne ambition est une participation plus large avec un moyen simple de clarification. Une date, un montant, le nom d'une personne ou une promesse conditionnelle doivent rester faciles à vérifier. Un système peut paraître confiant alors qu’un participant doit encore dire : « S’il vous plaît, montrez-moi cette phrase ». Montrer le texte et conserver l’original, là où les participants ont accepté de l’enregistrer, permet à cette demande d’aller quelque part.
Même une réunion fluide doit garder la trace de ses décisions
Revenons à la réunion fictive. Une personne propose de publier vendredi si la vérification de sécurité est terminée. Une autre préfère lundi pour laisser davantage de préparation à l’équipe d’assistance. Le groupe retient lundi et désigne un responsable, mais une condition préalable reste en suspens. Un résumé qui ne garde que le vendredi initialement proposé passe à côté de la décision.
Aucune amélioration du rythme de conversation ne supprime la différence entre une suggestion, une condition et une décision. Les personnes travaillant dans la même langue doivent déjà les distinguer. L’interaction multilingue rend plus utile la préservation du chemin allant de la déclaration originale à la formulation traduite et à l’action finale convenue.
Pour un compte rendu de réunion pratique, je voudrais qu'un lecteur qui a manqué l'appel trouve rapidement trois choses : ce que le groupe a décidé, qui est responsable de la prochaine étape et quelles questions restent ouvertes. Un délai ne doit être décrit comme convenu que lorsqu’il a été convenu. Si la source n’est pas claire, le dossier devrait faire remonter cette incertitude au lieu de la transformer en une fausse conclusion.
Cela ne nécessite pas de transformer chaque conversation en une archive exhaustive. Une courte note de décision peut être plus utile que des pages de transcription indifférenciée. La relation importante se situe entre le récit concis et les éléments justificatifs : la formulation originale pertinente, l'enregistrement lorsqu'il est disponible et autorisé, et le document dont le groupe a discuté.
Ce lien facilite aussi les corrections. Un participant peut montrer la formulation d’origine, rectifier le résumé et partager la décision corrigée. Sans ce lien, la personne suivante risque de résumer le résumé et de transformer un malentendu initial en fait apparemment établi. Une meilleure interaction vocale facilite l’échange ; des traces fiables permettent d’en vérifier le résultat plus tard.
Partager une idée suppose de conserver ses sources
Une idée utile commence et se termine rarement en un seul appel. Quelqu'un trouve un article, enregistre un passage, pose une question à ce sujet et pose la question lors d'une réunion. Une autre personne ajoute un contre-exemple tiré d’une vidéo ou d’un document de recherche. La prochaine étape dépend de la capacité à reconnecter ces éléments une fois la conversation terminée.
C’est pourquoi conserver des sources web reste utile, même avec une excellente IA vocale. L’URL permet de retrouver l’original, le passage sélectionné indique ce qui comptait et une note personnelle explique pourquoi on l’a conservé. Ces éléments jouent des rôles différents. Réunis, ils transmettent mieux une idée qu’un paragraphe isolé produit par l’IA.
Dire « Nous devrions revoir l’accueil des nouveaux utilisateurs » laisse peu de matière au collègue qui reprend le sujet. « Cet article nous a fait réfléchir aux cinq premières minutes ; voici le passage, notre discussion et l’expérience que nous avons décidé de tenter » fournit des éléments à examiner. Cet exemple est fictif, mais la différence est concrète : la conclusion seule demande de faire confiance ; le raisonnement et la source permettent de poursuivre la discussion.
La même discipline empêche la source de se transformer en commentaire. Une citation doit rester identifiable en tant que citation. Une traduction est une interprétation de cette source, et un résumé de réunion est une autre vue dérivée. Garder ces rôles visibles permet aux gens d’être en désaccord de manière productive sans avoir à reconstruire au préalable ce que quelqu’un a dit à l’origine.
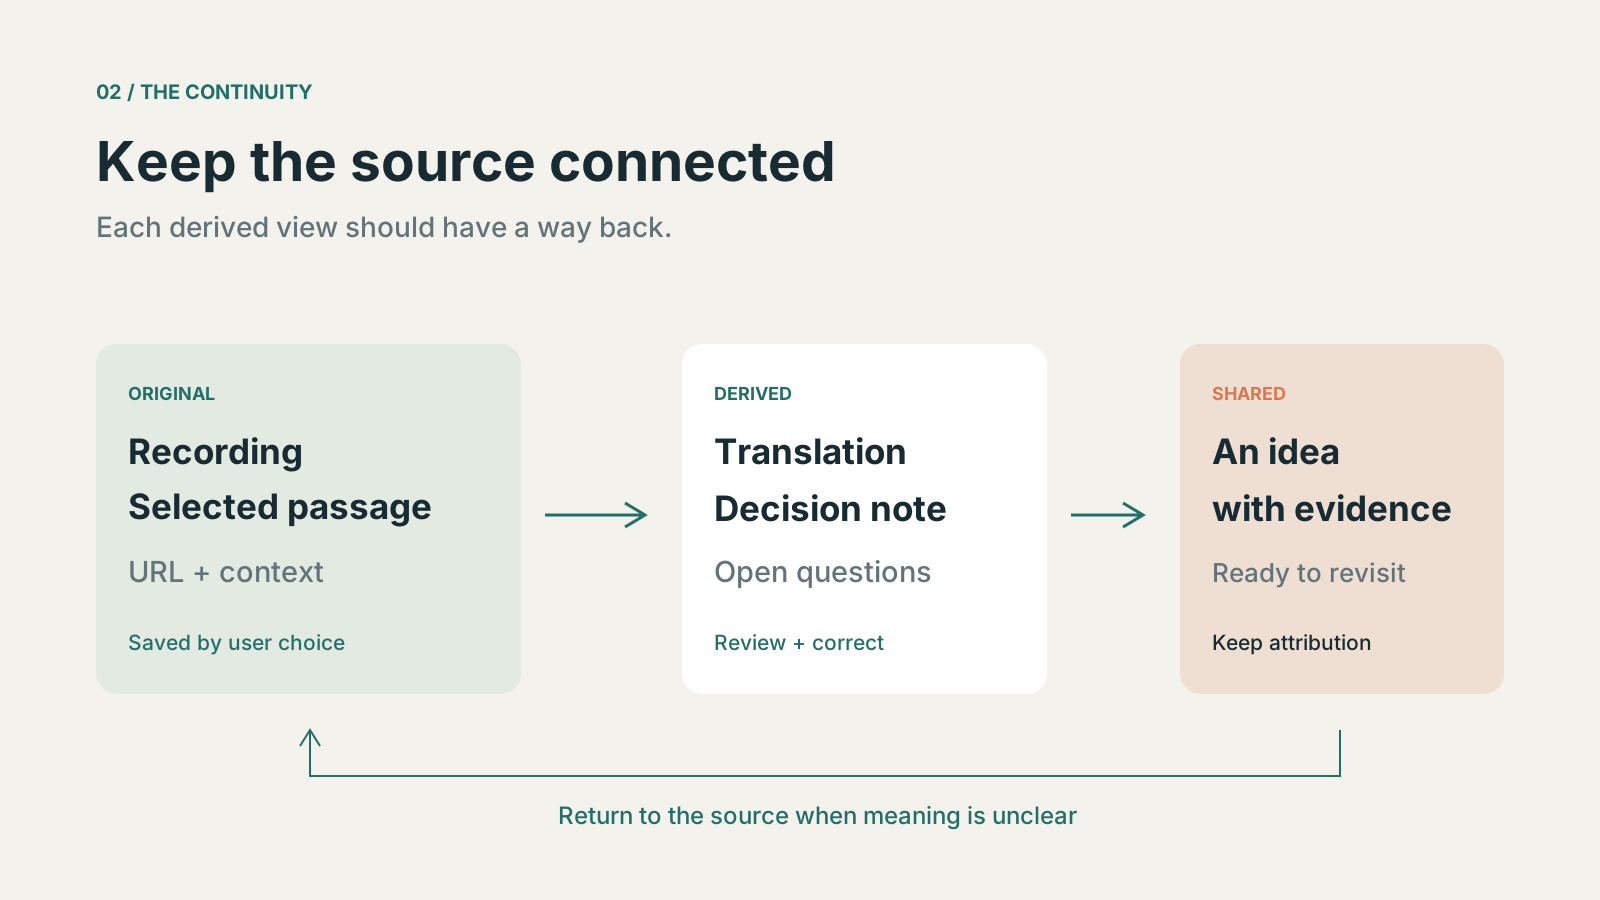
Un flux de travail proposé original. Préservez le matériel source autorisé, rendez le texte dérivé corrigible et gardez la connexion visible lors du partage. Le diagramme ne prétend pas que chaque lien est aujourd’hui une fonctionnalité automatisée.
Le contexte doit rester accessible après l’appel
Les systèmes vocaux commencent également à séparer la conversation du travail qui se déroule derrière. La documentation de délégation d’OpenAI explique que la parole en direct et le travail délégué peuvent se poursuivre indépendamment ; une réponse backend complète n'établit pas que l'utilisateur a entendu la réponse. Il s'agit d'un rappel technique utile d'un problème de produit plus large : une expérience orale et un résultat durable sont des éléments distincts à vérifier. Documentation de délégation d’OpenAI, vérifiée le 11 septembre 2026.
Pour les utilisateurs quotidiens, la question est plus simple. À la fin d’un appel, puis-je connaître la décision demain ? Un collègue peut-il comprendre pourquoi nous l’avons fait ? Puis-je revenir à l'article qui remettait en question notre hypothèse, sans chercher dans un historique de discussion, un navigateur et un enregistrement ? Ces questions demeurent même si chaque phrase est magnifiquement interprétée.
Il y a des raisons d'être optimiste quant à la diminution des barrières linguistiques. Nous devrions accueillir favorablement les outils qui permettent à davantage de personnes de contribuer confortablement. Je m'attends à ce qu'une conversation plus facile augmente la valeur du lien entre ce que nous disons et ce que nous gardons, partageons et faisons éventuellement. La réunion ne doit pas nécessairement durer éternellement ; son résultat utile devrait survivre à l’appel.
La direction que nous voulons donner à Telli.sh
Pour Telli.sh, la direction est claire : aider chacun à transformer conversations et découvertes en connaissances que l’on peut retrouver. Le produit réunit aujourd’hui notes, enregistrements, traductions et Clips dans un même espace. Nous voulons renforcer les liens entre ces éléments, pour que le compte rendu, l’idée et sa source ne se dispersent pas de nouveau.
Nous souhaitons un parcours continu : enregistrer une conversation avec l’autorisation nécessaire, en vérifier les points importants, rendre les décisions compréhensibles, puis partager une idée avec ses éléments de référence. Si une page web lance la discussion, Clip doit aider à conserver son URL et le contexte que l’utilisateur choisit de sauvegarder. Si une traduction facilite la compréhension, l’original doit rester disponible pour la comparer et la corriger.
Telli.sh n'a pas intégré GPT-Live-1 ni Gemini 3.5 Live Translate. Toute future intégration vocale devra apporter des résultats utiles dans plusieurs langues, des traces fiables et un contrôle clair sur ce qui est enregistré. L'objectif est d'améliorer cet espace à mesure que les modèles sous-jacents progressent, sans rendre les connaissances d'une personne dépendantes d'un seul modèle.
Plus il devient facile de parler au-delà des langues, plus nous voulons faire durer la valeur de ces échanges. Commencez par une réunion à retenir, une idée à partager ou une source que vous aurez besoin de retrouver.