Google impulsa la traducción en directo y OpenAI abre la voz full-duplex: ¿qué queda después de hablar?
GPT-Live-1 llega a la API a 0,05 $ por minuto de voz, tres meses después de la traducción de voz en directo de Google en 70 idiomas. Qué miden los precios y benchmarks publicados, qué no miden y por qué las actas, las ideas compartidas y las fuentes guardadas importan más a medida que conversar resulta más fácil.
Una ilustración conceptual original. Una conversación más natural y un registro útil de esa conversación son objetivos de diseño complementarios, no etapas medidas del lanzamiento de un producto.
Lo más alentador de los últimos anuncios de IA de voz es una posibilidad cotidiana: terminar una idea en tu propio idioma, aclararla sobre la marcha y participar con naturalidad. Menos tiempo esperando la traducción y menos ensayos mentales antes de intervenir. Así queda más atención para entender lo que la otra persona quiere decir.
Google presentó Gemini 3.5 Live Translate el 9 de junio de 2026. OpenAI presentó sus modelos GPT-Live full-duplex en ChatGPT el 8 de julio y luego lanzó GPT-Live-1 en la API el 10 de septiembre. Estos son productos diferentes que sirven diferentes propósitos, pero la secuencia apunta hacia una interacción hablada más continua. El último anuncio OpenAI amplía el acceso para desarrolladores; No es la primera aparición de GPT-Live. Anuncio de junio de Google, Introducción de julio de OpenAI, Lanzamiento de API de septiembre de OpenAI.
Creo que estos avances nos acercan a una vida cotidiana con menos barreras lingüísticas. También plantean otra pregunta: cuando conversar resulta más fácil, ¿cómo conservamos lo que hizo valiosa esa conversación? Las actas, las ideas compartidas y las fuentes guardadas forman parte de la respuesta.
La voz full-duplex cambia la espera durante una conversación
Full-duplex significa que un sistema puede escuchar y hablar al mismo tiempo. OpenAI describe GPT-Live-1 de esta manera en la documentación de su modelo actual, junto con la capacidad de delegar el razonamiento y el uso de herramientas a un agente backend. Ésta es una declaración sobre interacción simultánea, no un certificado de traducción perfecta. Documentación del modelo GPT-Live-1, consultada el 11 de septiembre de 2026.
Imagínate corregir a un asistente mientras te explica un plan: “En realidad, el cliente está en Madrid, no en Ciudad de México”. Una interfaz hablada útil necesita notar esa corrección antes de continuar con la suposición equivocada. También es necesario distinguir una corrección de un breve reconocimiento, o una pausa para pensar de una invitación a asumir el control. La calidad del intercambio depende de esos pequeños juicios.
Las interfaces de voz más antiguas a menudo hacían llamativa su estructura de turnos. Habló, esperó el procesamiento, escuchó y luego volvió a intentarlo. Un procesamiento más rápido ayuda, pero una interacción aún puede resultar incómoda cuando el sistema adivina que ha terminado demasiado pronto. El diseño full-duplex aborda la superposición en sí, en lugar de tratar cada momento del discurso como un mensaje cuidadosamente cerrado.
Ya existe una señal concreta, aunque limitada, de por qué eso es importante. OpenAI informa que la empresa de aprendizaje de idiomas Speak experimentó casi un 80% menos de interrupciones durante las pausas de pensamiento de los alumnos en las primeras evaluaciones en comparación con sistemas anteriores por turnos. Se trata de un resultado del socio informado por el proveedor, no de un hallazgo independiente para cada idioma o configuración. Mide el comportamiento de interrupción, no una mejora del 80% en la precisión de la traducción. Informe de lanzamiento de API de OpenAI, 10 de septiembre de 2026.
Las demás cifras de OpenAI apuntan en la misma dirección y tienen el mismo límite. Según OpenAI, GPT-Live-1 obtiene 30 puntos porcentuales más que GPT-Realtime-2.1 en Full Duplex Bench, una prueba de pausas, toma de turnos, interrupciones y señales de escucha (backchannels). Combinado con GPT-6 Astra con un esfuerzo de razonamiento medio, ocupa el primer puesto en Tau3, que puntúa por Pass@1 tareas habladas de atención al cliente y banca, entre ellas 97 tareas de conocimientos bancarios. Ambas son evaluaciones propias de OpenAI sobre el comportamiento conversacional y el cumplimiento de tareas; ninguna es una puntuación de precisión de la traducción. Resumen de evaluaciones de OpenAI, 10 de septiembre de 2026.
Para alguien que habla un segundo idioma, una pausa para pensar puede ser exactamente donde la participación se vuelve difícil. Un asistente que espera adecuadamente deja espacio para encontrar una palabra. Un asistente que acepta una corrección hace que sea menos costoso intentarlo. Éstas son razones prácticas para entusiasmarse con la interacción de voz natural más allá de lo impresionante que suene una demostración.
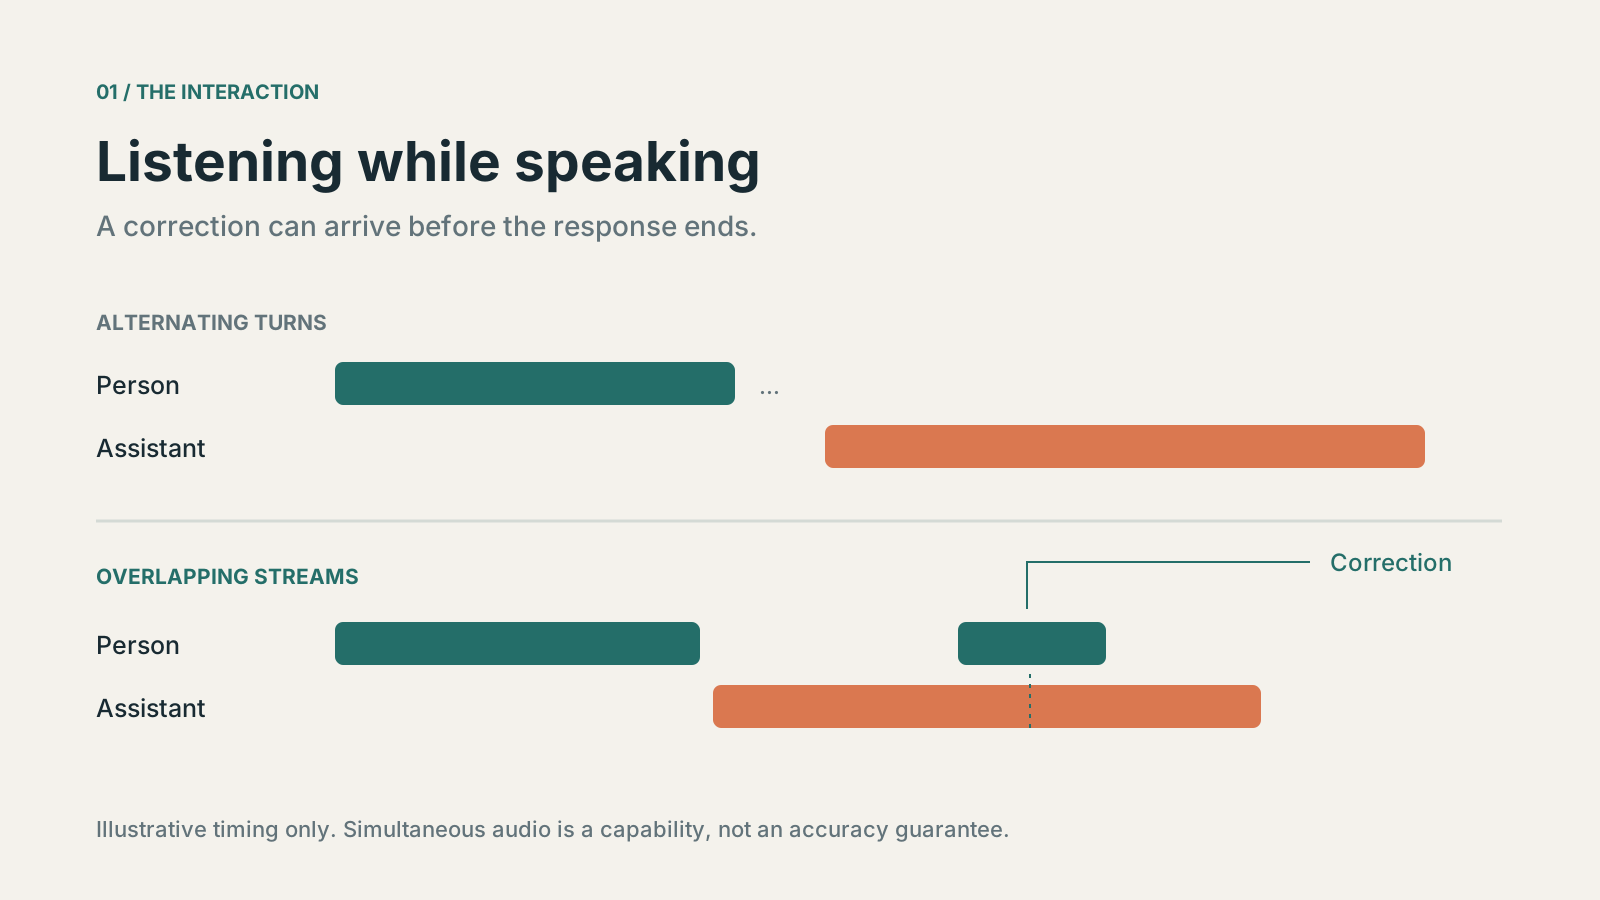
Sincronización conceptual únicamente; las barras no representan la latencia medida. Full-duplex describe entrada y salida simultáneas, mientras que el manejo útil de interrupciones aún depende del modelo y la aplicación.
La traducción en directo y un asistente de voz tienen funciones distintas
El anuncio de junio de Google describe la traducción continua de voz en más de 70 idiomas. El modelo genera voz traducida mientras se escucha, equilibrando la necesidad de más contexto con la de permanecer cerca del hablante. Google dice que se queda unos segundos atrás, lo cual es una expectativa más útil que imaginar un retraso cero. El lanzamiento del desarrollador fue una vista previa pública. Descripción del lanzamiento de Google, 9 de junio de 2026.
Las cifras de escala de ese anuncio son concretas. La traducción de voz de Google Meet pasará de cinco idiomas compatibles a más de 70, y de traducir solo desde y hacia el inglés a más de 2000 combinaciones de idiomas en una misma reunión. Empieza como vista previa privada para algunos clientes empresariales de Workspace, con un despliegue más amplio más adelante en 2026. Grab está probando el modelo para las recogidas entre conductores y viajeros, un caso de uso con más de 10 millones de llamadas de voz al mes. El anuncio recoge elogios de socios sobre la calidad, la precisión y la baja latencia, sin publicar ninguna puntuación numérica. Cifras de lanzamiento de Google, 9 de junio de 2026.
Hay una distinción que vale la pena mantener visible. La guía de traducción en vivo de Google describe un intérprete que procesa una transmisión de audio continuamente, con configuraciones específicas de traducción y sin soporte para herramientas o instrucciones generales. GPT-Live-1 es un modelo conversacional que puede funcionar con un agente independiente. Uno ayuda a llevar el significado del hablante a otro idioma; el otro participa en el intercambio. No deben presentarse como servicios intercambiables. Guía de traducción en vivo de Google, documentación del modelo de OpenAI, consultado el 11 de septiembre de 2026.
| Hito | Lo anunciado | Lo que no establece |
|---|---|---|
| Google, 9 de junio de 2026 | Gemini 3.5 Live Translate; traducción continua del habla; vista previa pública del desarrollador | Igual calidad para cada par de idiomas o acceso inmediato en cada producto Google |
| OpenAI, 8 de julio de 2026 | Implementación de GPT-Live en ChatGPT, con escucha y conversación simultáneas | Precisión a nivel de intérprete universal |
| OpenAI, 10 de septiembre de 2026 | Acceso API GPT-Live-1 para crear aplicaciones de voz | Integración automática en cada reunión o servicio de toma de notas. |
El alcance de la versión proviene de los tres anuncios vinculados anteriormente. Esta es una línea de tiempo, no una clasificación de desempeño.
En conjunto, estos desarrollos hacen visible una dirección convincente: la traducción puede volverse más continua y la interacción con un asistente puede volverse menos rígida. Conectar esas capacidades en una experiencia de reunión multilingüe confiable sigue siendo un trabajo de aplicación. Alguien todavía tiene que decidir de quién es el audio que se interpreta, adónde va el resultado, cómo se manejan las correcciones y qué ven los participantes.
Las cifras publicadas: 0,05 $ por minuto y ninguna puntuación de precisión
Un minuto de voz con GPT-Live-1 cuesta 0,05 $ en la API, facturado por segundos y sin redondear al minuto completo. Ese precio cubre solo la capa de voz frontal; el modelo de backend y las herramientas en las que una sesión delega se facturan aparte, a sus tarifas habituales. Documentación del modelo de OpenAI, consultada el 11 de septiembre de 2026.
Las cuentas son fáciles de hacer y fáciles de malinterpretar. Una sesión de 30 minutos cuesta 1,50 $ en tiempo de capa de voz, una hora cuesta 3,00 $ y 100 horas al mes suman 300 $, antes de cualquier razonamiento en el backend. Una aplicación que asigna una sesión independiente a cada participante de la reunión multiplica esas cifras por el número de sesiones. El anuncio de junio de Google no indica ningún precio para Gemini 3.5 Live Translate, así que este artículo no compara ambos en costes.
| Dato | Valor | Fuente y fecha | Qué mide |
|---|---|---|---|
| Precio de la API de GPT-Live-1 | 0,05 $ por minuto, facturado por segundos | OpenAI, 10 de septiembre de 2026 | Solo la capa de voz; el modelo de backend y las herramientas se facturan aparte |
| Full Duplex Bench | +30 puntos porcentuales frente a GPT-Realtime-2.1 | OpenAI, 10 de septiembre de 2026 | Pausas, toma de turnos e interrupciones, no traducción |
| Tau3 | Primer puesto, con GPT-6 Astra (medio) | OpenAI, 10 de septiembre de 2026 | Éxito en tareas habladas (Pass@1), incluidas 97 tareas bancarias |
| Evaluación inicial de Speak | Casi un 80% menos de interrupciones en las pausas para pensar | OpenAI (cita de un socio), 10 de septiembre de 2026 | Comportamiento de interrupción frente a sistemas anteriores por turnos |
| Uso de voz en ChatGPT | Más de 150 millones de personas a la semana | OpenAI, 8 de julio de 2026 | Uso de voz y dictado, no calidad |
| Gemini 3.5 Live Translate | 70+ idiomas, detectados automáticamente | Google, 9 de junio de 2026 | Cobertura, no calidad por par de idiomas |
| Traducción de voz en Google Meet | 5 → 70+ idiomas; más de 2000 combinaciones por reunión | Google, 9 de junio de 2026 | Mejora prevista, primero en vista previa privada |
| Retraso de la traducción | “Solo unos segundos por detrás del hablante” | Google, 9 de junio de 2026 | Descripción del proveedor, no una cifra medida |
Todas las cifras proceden de los propios proveedores, en los anuncios y la documentación enlazados en este artículo. Ninguna es una puntuación numérica de precisión de la traducción, como una valoración humana o una métrica automática para un par de idiomas.
Esa carencia importa sobre todo a quien elige una herramienta para reuniones multilingües. Los benchmarks de interacción indican si un sistema sabe esperar, escuchar y recuperarse; no dicen si “lunes” sigue siendo lunes después de pasar al coreano. La advertencia de OpenAI en julio sobre acentos no nativos en algunos idiomas y la ausencia de puntuaciones por par de idiomas en Google llevan a la misma regla práctica: prueba los pares de idiomas que tu equipo usa realmente antes de confiar en cualquiera de los dos para tomar decisiones.
Reducir la barrera del idioma empieza por animarse a hablar
Considere una reunión de proyecto hipotética de 30 minutos con cuatro personas que se sienten más cómodas en tres idiomas diferentes. El beneficio de una mejor traducción hablada no es simplemente que cada persona escuche más palabras. Es que el grupo puede hacer preguntas de seguimiento antes de que una incertidumbre se convierta en un malentendido. Una idea tentativa se puede expresar sin necesidad de pulirla primero a un segundo idioma.
Eso cambia la economía de la participación en un sentido muy común: contribuir requiere menos esfuerzo. La persona tranquila y con experiencia relevante tiene otra forma de entrar en la discusión. La persona que dirige la reunión puede dedicar menos tiempo a reconstruir una frase interrumpida. Una aclaración puede ocurrir cuando sea útil, mientras todos todavía recuerdan el punto que se está discutiendo.
Espero que eso importe en equipos remotos, debates en el aula, conversaciones con clientes e intercambios informales mientras viaja. Estas son expectativas sobre dónde puede ayudar la tecnología, no afirmaciones de que la misma experiencia ya esté disponible para todos. La combinación de idiomas, el acento, el vocabulario, la calidad del micrófono y el producto circundante siguen siendo parte del resultado.
Una voz natural debe evaluarse por separado de la exactitud del significado. En julio, OpenAI advirtió de acentos no nativos o limitaciones de fluidez en algunos idiomas. Por eso conviene evaluar los idiomas que se usarán realmente, sin extrapolar una buena demostración en inglés a todos los demás. Era una advertencia del lanzamiento, no una evaluación actual de todos los despliegues de septiembre. Introducción y advertencia sobre el idioma de GPT-Live de OpenAI, 8 de julio de 2026
La ambición correcta es una participación más amplia con una manera fácil de aclarar. Una fecha, una cantidad, el nombre de una persona o una promesa condicional deberían ser fáciles de comprobar. Un sistema puede parecer confiado mientras un participante todavía necesita decir: "Por favor, muéstrame esa frase". Mostrar el texto y conservar el original, donde los participantes aceptaron grabar, le da a esa solicitud un lugar al que acudir.
Una reunión fluida también necesita un registro de sus decisiones
Volvamos a la reunión hipotética. Alguien propone publicar el viernes si ha terminado la revisión de seguridad. Otra persona prefiere el lunes para dar más tiempo de preparación al equipo de soporte. El grupo elige el lunes y asigna un responsable, aunque queda un requisito previo pendiente. Un resumen que solo recoge el viernes propuesto al principio pierde la decisión de la reunión.
Ninguna mejora en el ritmo de la conversación elimina la diferencia entre una sugerencia, una condición y una decisión. Las personas que trabajan en el mismo idioma ya necesitan distinguirlos. La interacción multilingüe hace que sea más valioso preservar el camino desde la declaración original hasta la redacción traducida y la acción final acordada.
Para un registro de una reunión práctica, me gustaría que un lector que perdió la llamada encontrara tres cosas rápidamente: qué decidió el grupo, quién es responsable del siguiente paso y qué preguntas permanecen abiertas. Un plazo sólo debe considerarse acordado cuando así se acordó. Si la fuente no es clara, el registro debe reflejar esa incertidumbre en lugar de ordenarla en una conclusión falsa.
Esto no requiere convertir cada conversación en un archivo exhaustivo. Una breve nota de decisión puede ser más útil que páginas de transcripciones indiferenciadas. La relación importante es entre el relato conciso y el material de respaldo: la redacción original relevante, la grabación cuando esté disponible y autorizada, y el documento que el grupo estaba discutiendo.
Ese vínculo también facilita corregir errores. Un participante puede señalar la frase original, rectificar el resumen y compartir la decisión corregida. Sin él, la siguiente persona podría resumir el resumen y convertir el malentendido inicial en un hecho aparentemente confirmado. Una mejor interacción de voz facilita la conversación; los buenos registros permiten comprobar su resultado más adelante.
Las ideas compartidas necesitan sus fuentes
Una idea útil rara vez comienza y termina dentro de una llamada. Alguien encuentra un artículo, guarda un pasaje, hace una pregunta al respecto y lleva la pregunta a una reunión. Otra persona añade un contraejemplo de un vídeo o de un trabajo de investigación. El siguiente paso depende de poder volver a conectar esas piezas una vez finalizada la conversación.
Por eso guardar fuentes de la web sigue siendo útil, incluso con una excelente IA de voz. La URL permite volver al original, el fragmento seleccionado identifica lo relevante y una nota personal explica por qué se guardó. Cada elemento aporta algo distinto. Juntos ayudan a compartir una idea mejor que un párrafo aislado generado por IA.
«Deberíamos cambiar la bienvenida a los nuevos usuarios» ofrece poco contexto a quien retome el tema. «Este artículo nos hizo cuestionar los primeros cinco minutos; aquí están el fragmento, nuestra conversación y el experimento acordado» aporta elementos que revisar. Es un ejemplo hipotético, pero la diferencia es concreta: compartir solo la conclusión exige confianza; compartir el razonamiento y la fuente permite seguir conversando.
La misma disciplina protege a la fuente de ser confusa en comentario. Una cotización debe seguir siendo identificable como cotización. Una traducción es una interpretación de esa fuente y un resumen de una reunión es otra vista derivada. Mantener esos roles visibles permite a las personas estar en desacuerdo de manera productiva sin tener que reconstruir primero lo que alguien dijo originalmente.
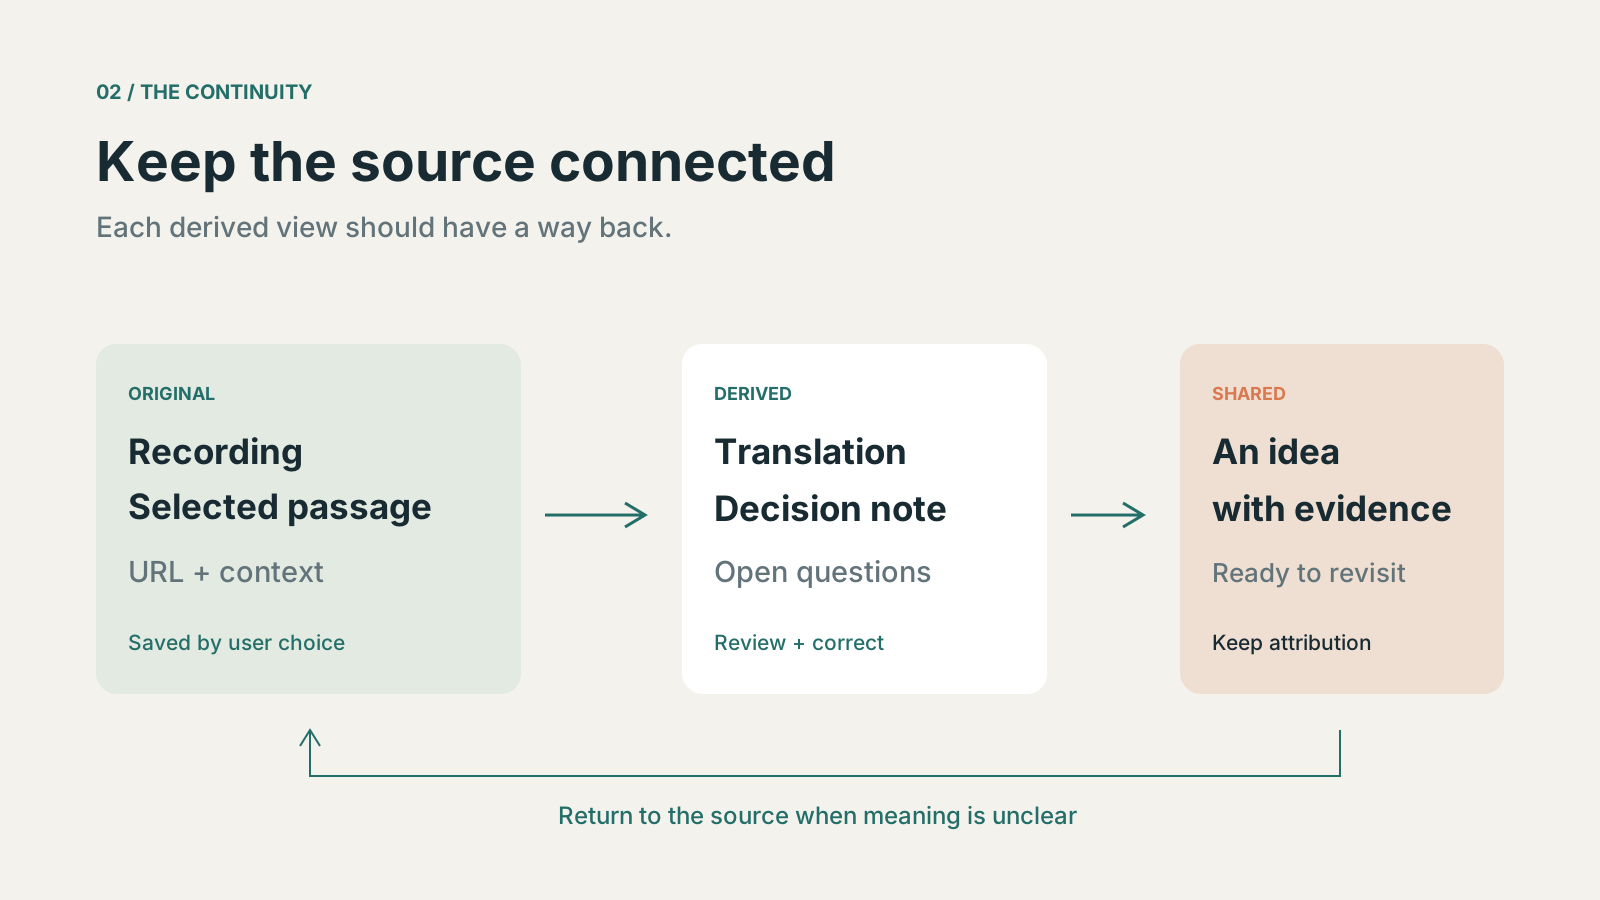
Un flujo de trabajo propuesto original. Conserve el material fuente autorizado, haga corregible el texto derivado y mantenga la conexión visible al compartir. El diagrama no afirma que cada enlace sea una función automatizada en la actualidad.
El contexto debe seguir disponible después de la llamada
Los sistemas de voz también están empezando a separar la conversación del trabajo que ocurre detrás de ella. La documentación de delegación de OpenAI explica que la conversación en vivo y el trabajo delegado pueden continuar de forma independiente; una respuesta de backend completa no establece que el usuario escuchó la respuesta. Este es un útil recordatorio de ingeniería de un problema más amplio del producto: una experiencia hablada y un resultado duradero son cosas separadas que deben verificarse. Documentación de delegación de OpenAI, consultada el 11 de septiembre de 2026.
Para los usuarios cotidianos, la pregunta es más sencilla. Cuando finaliza una llamada, ¿puedo conocer la decisión mañana? ¿Puede un colega entender por qué lo hicimos? ¿Puedo volver al artículo que cuestionó nuestra suposición, sin buscar en el historial de chat, un navegador y una grabación? Esas preguntas persisten incluso si cada frase se interpreta bellamente.
Hay motivos para ser optimistas acerca de que las barreras del idioma se vuelvan menos dominantes. Deberíamos acoger con agrado las herramientas que permitan a más personas contribuir cómodamente. Mi expectativa es que una conversación más sencilla aumentará el valor de conectar lo que decimos con lo que guardamos, compartimos y eventualmente hacemos. El encuentro no tiene por qué durar para siempre; su resultado útil debería sobrevivir a la llamada.
Hacia dónde queremos llevar Telli.sh
Para Telli.sh, esa es la dirección: ayudar a convertir conversaciones y descubrimientos en conocimiento que podamos recuperar. Hoy el producto reúne notas, grabaciones, traducciones y Clips en un mismo espacio. Queremos reforzar los vínculos entre esos materiales para que el acta, la idea y su fuente no vuelvan a quedar dispersas.
Buscamos un flujo continuo: registrar una conversación con la autorización correspondiente, revisar sus puntos importantes, dejar claras las decisiones y compartir una idea con sus referencias. Si una página web inicia el debate, Clip debe ayudar a conservar la URL y el contexto que el usuario elija guardar. Si una traducción facilita la comprensión, el original debe seguir disponible para compararlo y corregirla.
Esta es una dirección de producto, no el anuncio de que Telli.sh ya haya integrado GPT-Live-1 o Gemini 3.5 Live Translate. Las futuras funciones de voz deberán demostrar utilidad entre idiomas, registros fiables y un control claro de lo que se guarda. Queremos que los avances de los modelos mejoren el espacio de trabajo sin que el conocimiento de una persona dependa de un único modelo.
Cuanto más fácil sea hablar entre idiomas, más queremos ayudar a que el valor de esas conversaciones perdure. Empieza por una reunión que quieras recordar, una idea que compartir o una fuente que volverás a necesitar.